Mit CometAPI entwickelnEine API für mehrere Modelle erforderlich?Teste den Workflow im Playground und erstelle anschließend einen API-Schlüssel, sobald Modell und Kosten zu deinem Anwendungsfall passen.
Erfahren Sie, wie Sie Claude Fable 5.1 über die CometAPI aufrufen, den Aufwand konfigurieren, Tools verwenden, mit Breaking Changes umgehen und die Migration durchführen.
Kurzüberblick: Um die Claude Fable 5.1 API in CometAPI zu nutzen, bereiten Sie einen API-Schlüssel vor, setzen die Modell-ID auf claude-fable-5-1 und validieren zunächst eine kleine Anfrage, bevor Sie einen längeren Workflow aufbauen. Dieser Leitfaden behandelt Zugriff, Aufwand, Streaming, Tools, Caching, Migration und Produktions-Checks. Behandeln Sie die Bereitstellung als mehr als nur eine geänderte Modellzeichenfolge: Bestätigen Sie die Routenkompatibilität, validieren Sie Ausgaben und messen Sie Qualität akzeptierter Aufgaben, Latenz und Kosten, bevor Sie die Nutzung ausweiten.
Zentrale Erkenntnisse
Erste Anfrage zum Laufen bringen: Zugangsdaten, Modellzugriff, den gewählten Endpunkt und eine nutzbare Antwort mit nicht sensiblen Testdaten prüfen.
Aufwand bewusst wählen: mit High starten, dann andere Einstellungen an repräsentativen Aufgaben vergleichen, statt für jede Anfrage maximalen Aufwand zu nutzen. Claude Code hat standardmäßig High. Claude Cowork / Claude.ai hat standardmäßig Medium.
Weiterlernen
Diesen Artikel mit der nächsten Entscheidung verknüpfen.
Auf Klarheit, Quellenangabe und aktuelle API-Terminologie geprüft.
Migrationsverhalten prüfen: Erzwungene Tool-Auswahl wird abgelehnt; behalten Sie erforderliche Workflow-Schritte und die Validierung von Tool-Argumenten in der Applikationslogik bei.
Den gesamten Workflow messen: Cache-Nutzung, Tokenkosten, Latenz, Verweigerungen, Fallback-Verhalten sowie das Bestehen Ihrer Abnahmekriterien für das Endergebnis verfolgen.
Claude Fable 5.1 ist Anthropic's leistungsfähigstes allgemein verfügbares Modell für ambitioniertes Coding, mehrstufige Recherche, Computerbedienung und dokumentenintensive professionelle Workflows. Anthropic empfiehlt, die meisten Workloads mit Claude Opus 5 zu starten und auf Fable 5.1 zu eskalieren, wenn Bewertungen mit hohem Aufwand in Opus weiterhin nicht ausreichen.
Die Unterscheidung ist operativ: Fable 5.1 ist dafür ausgelegt, über abhängige Schritte hinweg weiterzuarbeiten, sich nach einem fehlgeschlagenen Tool-Aufruf zu erholen, Ergebnisse zu verifizieren und während langer Läufe Fortschritte zu melden. Das kann die Abschlussraten verbessern, macht aber Kosten, Latenz und Observierbarkeit zentral für die Bereitstellung.
Claude Fable 5.1 API-Spezifikationen
Offizielle Spezifikation
Claude Fable 5.1
Anbieter
Anthropic
Modell-ID
claude-fable-5-1
Veröffentlichungsdatum
September 1, 2026
Kontextfenster
1.000.000 Tokens
Maximale Ausgabe
128.000 Tokens
Eingabe und Ausgabe
Text und Bilder zu Text
Thinking
Adaptiv, immer aktiv
Standard-Aufwand
API ist High, Claude Code standardmäßig High, Claude Cowork / Claude.ai standardmäßig Medium
Aufwandstufen
low, medium, high, xhigh, max
Wissensstand
Juni 2026
Offizieller Preis
$10 Input / $50 Output pro Million Tokens
Cache-Lesezugriff
$0.25 pro Million Tokens
Die offizielle Übersicht bestätigt ein 1M-Kontextfenster und 128K maximale Ausgabe. Adaptives Thinking ist immer aktiv; die Reasoning-Tiefe wird über Aufwand gesteuert, nicht über ein klassisches Thinking-Token-Budget.
Claude Fable 5.1 API: Offizielle Benchmark-Leistung
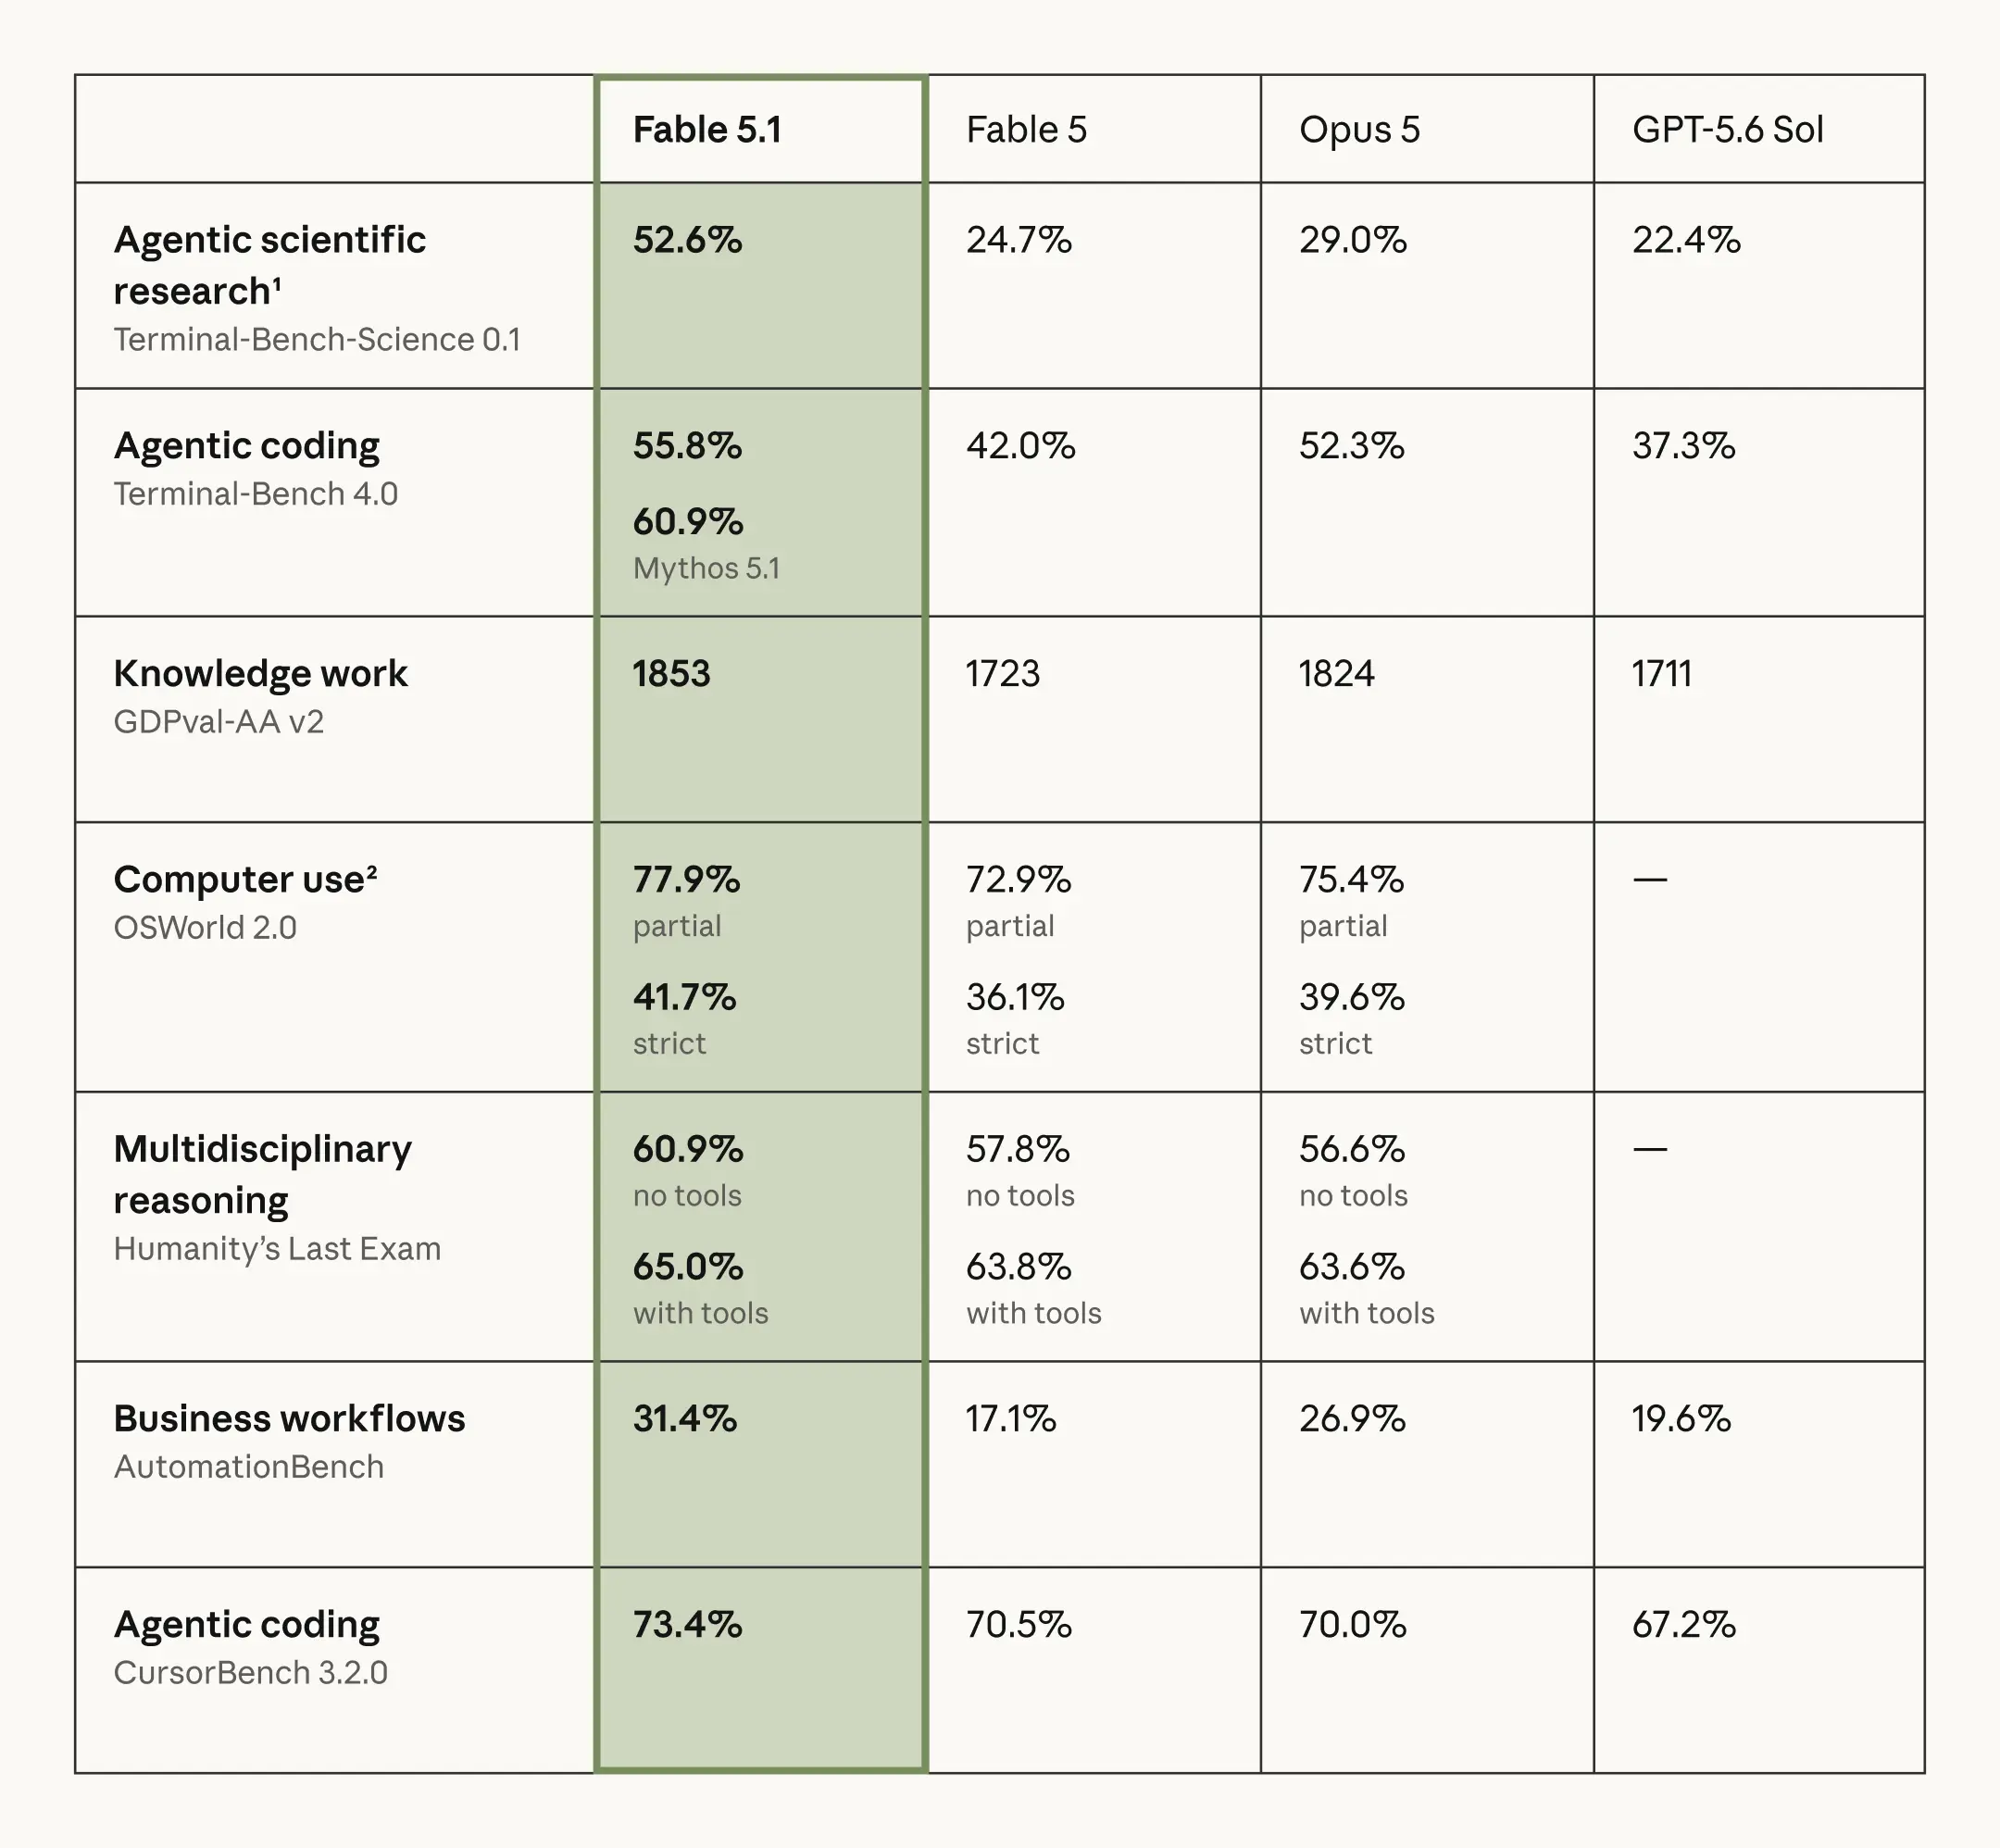
Die Benchmark-Zusammenfassung ist bewusst kompakt, da der Hauptzweck des Artikels die Implementierung ist. Die folgenden Ergebnisse zeigen, wo sich der API-Aufpreis am ehesten bemerkbar macht.
Der größte Generationssprung in diesem Set ist Terminal-Bench-Science: 52,6% gegenüber 24,7%. AutomationBench steigt von 17,1% auf 31,4%, während Terminal-Bench 4.0 auf 55,8% verbessert. Das ergibt ein starkes Argument, Fable 5.1 für Research Agents, langlaufendes Coding und Geschäftsautomatisierung zu testen – nicht, um jede kurze Anfrage auf das teuerste Modell zu routen.
Was hat sich gegenüber der Claude Fable 5 API geändert?
Dimension
Claude Fable 5.1
Claude Fable 5
Migrationsauswirkung
Kernrolle
Stärkere langlaufende Agents und Research
Ursprüngliches öffentliches Mythos-Klassenmodell
Härteste Workflows neu bewerten
Erzwungene Tool-Wahl
Gibt einen Fehler zurück
Früher unterstützt
Jegliches und benanntes Erzwingen entfernen
Thinking-Historie
Strengere Kompatibilitätsregeln
Früheres Verhalten
Historien append-only halten
Fortschritts-Updates
Lesbare Updates zwischen Tool-Aufrufen
In dieser Form nicht verfügbar
Langlauf-Status anzeigen
Aufwand pro Nachricht
In Beta verfügbar
In dieser Form nicht verfügbar
Tiefe innerhalb eines Gesprächs abstimmen
Cache-Lesepreis
$0.25 / MTok
$1.00 / MTok
Langkontext-Ökonomie neu berechnen
Input-/Output-Preis
$10 / $50 pro MTok
$10 / $50 pro MTok
Keine Änderung der Listenpreise
Drei Breaking Changes
Erzwungene Tool-Nutzung wird nicht mehr unterstützt
Claude Fable 5.1 lehnt tool_choice-Werte ab, die ein beliebiges Tool oder ein spezifisch benanntes Tool erzwingen, und gibt einen 400 invalid-request-Fehler zurück. Verwenden Sie automatische Auswahl, setzen Sie strikte Schemas oder strukturierte Ausgaben zur Validierung ein und erzwingen Sie obligatorische Workflow-Schritte in der Applikationsorchestrierung statt über einen erzwungenen Modell-Tool-Aufruf.
Frühere Modelle können Fable-5.1-Thinking-Blöcke nicht lesen
Die Thinking-Kompatibilität ist einseitig: Fable 5.1 kann Thinking-Blöcke verarbeiten, die von früheren kompatiblen Claude-Modellen erzeugt wurden, aber frühere Modelle können von Fable 5.1 erzeugte Blöcke nicht lesen. Ein Router oder Fallback, der auf ein früheres Modell wechselt, kann diese Blöcke vor der Inferenz verwerfen. Integrationen sollten daher Modellwechsel protokollieren und das Fallback-Verhalten explizit testen.
Das bewahrte Thinking ist kryptografisch an den vorhergehenden Gesprächszustand gebunden. Änderungen an früheren Systemprompts, Tool-Definitionen, Nachrichten oder referenzierten Dateibytes können spätere Thinking-Blöcke ungültig machen. Behandeln Sie das Gesprächspräfix als append-only, nutzen Sie Anweisungen in der laufenden Konversation statt die Historie umzuschreiben, und überwachen Sie während der Migration Transformationsereignisse durch Präfix-Mismatches.
Fünf additive API-Fähigkeiten
Aufwand pro Nachricht
Anwendungen können den Aufwand während einer Konversation ändern, ohne den Prompt-Cache zu invalidieren. Diese Beta-Fähigkeit erlaubt es, für Routine-Nachfragen den Aufwand zu senken und ihn für schwierige Planungs-, Debugging- oder Verifizierungs-Turns zu erhöhen.
Turn-skopierte Systemnachrichten
Eine Beta-Systemnachricht kann für einen Turn gelten und hört nach der nächsten Nutzernachricht auf zu rendern, während sie in der Historie unverändert bleibt. Das ist nützlich für temporäre Anweisungen in Tool-Schleifen, weil es sowohl die Prompt-Cache-Übereinstimmung als auch die Gültigkeit späterer Thinking-Blöcke erhält.
Lesbare Fortschritts-Updates zwischen Tool-Aufrufen
Mit der Beta-Option zur Fortschrittsanzeige können ausgewählte Thinking-Blöcke kurze Statusupdates tragen, die eine Anwendung Nutzenden anzeigen kann, während privates Reasoning verborgen bleibt. Langlaufende Agents sollten diese Updates als Betriebsstatus behandeln, nicht als finale Antworten.
Niedrigere Cache-Lese-Preise
Cache-Leses werden mit $0.25 pro Million Tokens berechnet, ein Viertel des Fable-5-Satzes, während die Basispreise für Input und Output unverändert bleiben. Das kann die Kosten langer Sitzungen spürbar senken, die wiederholt ein stabiles gecachtes Präfix nutzen.
Content-Provenienz
Generierter Text trägt Anthropics statistisches Wasserzeichen, während unterstützte Medien, die über die Files API abgerufen werden, signierte C2PA Content Credentials enthalten können. Diese Provenienzmechanismen fügen keine Prompt-Tokens hinzu und erfordern keine Änderungen am Anfrageformat.
Was brauchen Sie, bevor Sie die Claude Fable 5.1 API nutzen?
Ein Konto und einen API-Schlüssel: bei CometAPI anmelden und einen Schlüssel in der API-Key-Konsole generieren. Modellzugang prüfen und sicherstellen, dass Ihr Konto für nutzungsbasierte Abrechnung bereit ist, bevor Sie Testaufrufe senden.
Eine lokale Laufzeit: für das erste HTTP-Beispiel ein Terminal mit curl verwenden. Für die Python-Beispiele Python und pip in einer isolierten Umgebung vorbereiten und dann das SDK installieren, das Ihr gewähltes Beispiel nutzt.
Eine ausgewählte Route: die Claude Fable 5.1 API in CometAPI bietet Messages- und Chat-Completions-Formate. Verwenden Sie die passende Basis-URL und das passende Anforderungsformat; mischen Sie die Payloads nicht.
Sichere Konfiguration: COMETAPI_KEY außerhalb eingecheckter Quelltexte setzen, claude-fable-5-1 als Modell-ID verwenden und sicherstellen, dass Ihr Netzwerk https://api.cometapi.com. erreichen kann.
Einen sicheren Test und eine Abnahmeprüfung: mit einem kurzen, nicht sensiblen Prompt beginnen. Bestätigen, dass die Antwort nutzbare Inhalte enthält, Nutzung und Abschlussstatus prüfen und die Datenverarbeitungsanforderungen Ihrer Organisation prüfen, bevor Sie echte Dokumente oder Logs senden.
Wie greifen Sie über CometAPI auf Claude Fable 5.1 zu?
CometAPI stellt Claude Fable 5.1 über eine Anthropic-kompatible Messages-Route und eine OpenAI-kompatible Chat-Completions-Route bereit. Verwenden Sie Messages, wenn Sie native Aufwand-, Thinking-, Caching- und Claude-Tool-Semantik benötigen; verwenden Sie Chat Completions, wenn Ihre Anwendung bereits auf das OpenAI-SDK standardisiert ist.
Schritt 1: API-Schlüssel speichern
export COMETAPI_KEY="your-cometapi-key"
$env:COMETAPI_KEY="your-cometapi-key"
Schritt 2: Erste Messages-Anfrage senden
curl https://api.cometapi.com/v1/messages \
  --header "Authorization: Bearer $COMETAPI_KEY" \
  --header "content-type: application/json" \
  --data '{
    "model": "claude-fable-5-1",
    "max_tokens": 2048,
    "messages": [{
      "role": "user",
      "content": "Review this deployment architecture and list the three highest-risk failure modes."
    }]
  }'
Schritt 3: Anthropic Python SDK verwenden
pip install anthropic
import os
import anthropic

client = anthropic.Anthropic(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com",
)

response = client.messages.create(
    model="claude-fable-5-1",
    max_tokens=4096,
    messages=[{
        "role": "user",
        "content": "Find the root cause of this test failure and propose a verified patch.",
    }],
)

print(response.content[0].text)
Schritt 4: OpenAI Python SDK verwenden
pip install openai
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="claude-fable-5-1",
    messages=[{
        "role": "user",
        "content": "Design a migration plan for this service.",
    }],
)

print(response.choices[0].message.content)
Wie funktioniert das Reasoning der Claude Fable 5.1 API?
Frühere Modelle können Claude-Fable-5.1-Thinking-Blöcke nicht lesen
Thinking-Blöcke, die von Fable 5.1 erzeugt werden, sind nicht rückwärtskompatibel mit früheren Claude-Modellen. Wenn ein Workflow während einer Konversation das Modell wechselt, entfernen Sie inkompatible Thinking-Blöcke oder starten Sie einen neuen Zweig und behalten nur die für die nächste Anfrage benötigten nutzenden Sichtnachrichten und Tool-Ergebnisse.
Das Bearbeiten früherer Turns invalidiert bewahrtes Thinking
Ein bewahrter Thinking-Block ist kryptografisch an den vorherigen Gesprächszustand gebunden. Eine Änderung eines früheren Systemprompts, einer Tool-Definition, einer Nachricht der Nutzerseite, einer Assistenten-Antwort oder eines Tool-Ergebnisses kann diese Bindung brechen und einen Thinking-History-Fehler auslösen. Halten Sie das wiederholte Präfix Byte-für-Byte stabil und hängen Sie neue Turns an, statt alte umzuschreiben.
Bewahrtes Thinking über mehrere Turns
Wenn das Gesprächspräfix unverändert bleibt, kann bewahrtes Thinking nützlichen Reasoning-Zustand in spätere Turns tragen. Speichern Sie Thinking-Blöcke in ihrer ursprünglichen Nachrichtenreihenfolge, spielen Sie sie nur für ein kompatibles Modell wieder und behandeln Sie eine Historienänderung als neuen Gesprächszweig statt die vorhandene Niederschrift zu verändern.
Reasoning über Aufwand steuern
Starten Sie schwierige Produktionsarbeit mit hohem Aufwand, testen Sie dann niedrigere Einstellungen bei Routineturns und höhere Einstellungen nur dort, wo die Qualität akzeptierter Aufgaben genug steigt, um zusätzliche Latenz und Tokens zu rechtfertigen. Da der Aufwand zwischen Turns wechseln kann, braucht eine Konversation nicht mehr ein einziges Reasoning-Niveau durchgehend.
Fable 5.1 verwendet adaptives Thinking als einzigen Thinking-Modus. Beginnen Sie mit hohem Aufwand, messen Sie dann niedrigere Einstellungen für Routinearbeit und xhigh oder max nur dann, wenn zusätzliche Fähigkeiten Kosten und Latenz rechtfertigen.
Claude Fable 5.1 API: Lange Antworten streamen, Tools und Prompt-Caching nutzen
Konfigurieren Sie folgende Kontrollen gemeinsam: Reasoning-Aufwand, Streaming, Tool-Ausführung, Prompt-Caching und den Umgang mit Schutzmechanismen und aufbewahrten Daten. Jede beeinflusst, wie eine langlaufende Anfrage beobachtet, validiert und betrieben wird.
Lange Antworten streamen
Streaming ist die sicherere Voreinstellung für lange, aufwändige Aufgaben, da Anwendungen nicht auf die vollständige Fertigstellung einer großen Antwort warten müssen, bevor sie Ausgabe erhalten.
with client.messages.stream(
    model="claude-fable-5-1",
    max_tokens=8192,
    output_config={"effort": "high"},
    messages=[{
        "role": "user",
        "content": "Analyze these logs and produce a remediation plan.",
    }],
) as stream:
    for text in stream.text_stream:
        print(text, end="", flush=True)
Tools ohne erzwungene Tool-Wahl verwenden
Fable 5.1 lehnt erzwungene Tool-Auswahl ab, sowohl mit tool_choice-Typ any als auch einem benannten Tool. Verwenden Sie automatische Auswahl, strikte Schemas, validieren Sie Tool-Argumente im Anwendungscode und steuern Sie verpflichtende Workflow-Sequenzen außerhalb des Modells. Wenn ein Workflow zwingend ein bestimmtes Tool ausführen muss, verlassen Sie sich nicht auf tool_choice, um die Sequenz zu erzwingen. Lassen Sie die Anwendung dieses Tool aufrufen oder implementieren Sie den erforderlichen Schritt in der Orchestrierung.
Anthropic listet Cache-Leses mit $0.25 pro Million Tokens, ein Viertel des Fable-5-Satzes. Stellen Sie stabile Systemanweisungen, Tool-Schemas und große Referenzen vor dynamische Nutzerinhalte und prüfen Sie dann Cache-Treffer in der Nutzungsmetadaten.
messages = [{
    "role": "user",
    "content": [
        {
            "type": "text",
            "text": large_reference_document,
            "cache_control": {"type": "ephemeral"},
        },
        {
            "type": "text",
            "text": "Identify obligations that changed in this revision.",
        },
    ],
}]
Schutzmechanismen und Datenaufbewahrung handhaben
Anthropic gibt an, dass viele markierte Cybersecurity- und Biologieanfragen auf weniger fähige Modelle geroutet werden. Behandeln Sie eine Verweigerung oder ein Fallback als Applikationszustand: Stopgrund protokollieren, eine geeignete Nutzendenmitteilung anzeigen und, wo die Richtlinie es erlaubt, zu einer zugelassenen Alternative routen.
Fable erfordert zudem standardmäßig 30 Tage Datenaufbewahrung für Sicherheitsüberwachung. Prüfen Sie die organisatorische Eignung und Aufbewahrungseinstellungen, bevor Sie eine syntaktisch gültige Anfrage als reines API-Formatproblem debuggen.
Fable 5.1 vs Opus 5 vs Sonnet 5
Entscheidungsdimension
Claude Fable 5.1
Claude Opus 5
Claude Sonnet 5
Kontext / max. Ausgabe
1M / 128K
1M / 128K
1M / 128K
Offizieller Input/Output
$10 / $50
$5 / $25
$2 / $10
Relative Latenz
Langsamer
Moderat
Schnell
Standard-Aufwand
high
high
high
Hauptstärke
Maximale Langhorizont-Fähigkeit
Premium-Allgemein-Reasoning
Speed-/Kosten-Balance
Beste Produktionsrolle
Fähigkeitseskalation
Standard für komplexe Arbeit
Hochvolumen-Basis
Ergebnis der Auswahl: Routineverkehr auf Sonnet 5 starten, Opus 5 für komplexe Standardarbeit nutzen und nur die härtesten oder wiederholt scheiternden Aufgaben auf Fable 5.1 eskalieren. Das entspricht Anthropics Empfehlung und verhindert, dass Premium-Reasoning zum Standardkostenfaktor jeder Anfrage wird.
Preise über CometAPI
Route
Input / MTok
Output / MTok
Cache read / MTok
Anthropic Listenpreis
$10
$50
$0.25
CometAPI gelisteter Preis
$8
$40
Live-Route prüfen
Nominaler Input/Output-Unterschied
20% niedriger
20% niedriger
Variiert nach Route
Die Live-CometAPI-Modellseite ist die maßgebliche Quelle für aktuelle Routenverfügbarkeit und Preise. Für eine Anfrage mit 100.000 ungecachten Input-Tokens und 10.000 Output-Tokens liegt die einfache CometAPI-Schätzung bei $1.20; die tatsächlichen Kosten können sich durch Caching, Reasoning, Batch-Verhalten und Routing ändern. Preise können sich ändern; prüfen Sie die Live-Modellseite vor der Produktionsbudgetierung.
Migrations-Checkliste von Fable 5
Modell-ID von claude-fable-5 auf claude-fable-5-1 ändern.
tool_choice any und benannte Erzwingung entfernen; auto verwenden.
Alte Thinking-Budget-Annahmen durch output_config.effort ersetzen.
Die Bewertung mit hohem Aufwand beginnen, dann gegen reale Aufgaben abstimmen.
Historien append-only halten, wenn sie bewahrte Thinking-Blöcke enthalten.
max_tokens für lange Läufe mit hohem Aufwand erhöhen.
Cache-Treffer in Nutzungsmetadaten verifizieren.
Verweigerungen und Fallbacks als explizite Zustände behandeln.
Produktionstraces wiedergeben und Rate akzeptierter Aufgaben, Latenz und Kosten vergleichen.
Sicherste Migrationsstrategie: Historien append-only halten. Fable 5.1 kann Thinking-Blöcke über Turns hinweg bewahren, aber wiedergegebene Thinking-Blöcke sind an den vorhergehenden Gesprächszustand gebunden; Änderungen an früheren Systemprompts, Tools oder Nachrichten können diese Bindung invalidieren.
Häufige API-Fehler
400-Fehler nach Änderung von Tool-Aufrufen
Wahrscheinliche Ursache: erzwungene tool_choice mit any oder einem benannten Tool. auto verwenden und die erforderliche Sequenz in der Applikationslogik erzwingen.
claude-fable-5.1 funktioniert nicht
Die kanonische ID verwendet Bindestriche: claude-fable-5-1.
Ausgabe endet früher als erwartet
effort controls how much reasoning the model performs, while max_tokens limits the response token budget. Higher effort can require more output budget, so production applications should tune both independently. Raise max_tokens where justified and stream long responses.
Prompt-Cache trifft nie
Halten Sie das gecachte Präfix Byte-für-Byte stabil; Zeitstempel, umsortierte Tools und wechselnde Systemnachrichten verhindern Wiederverwendung.
HTTP-Erfolg, aber keine normale Antwort
Stopgrund (stop_reason) und Fallback-Metadaten prüfen, statt jede Verweigerung als Transportfehler zu behandeln.
Wiedergeben der Historie erzeugt einen Thinking-Fehler
Vor bewahrten Fable-5.1-Thinking-Blöcken keine früheren Turns bearbeiten. Append-only-Historie oder aktuelle Migrationskontrollen nutzen.
Wie sollten Sie die Claude Fable 5.1 API in Produktion nutzen?
Request-Routing, Modellausführung, Tool-Ausführung, Validierung und Evaluation trennen. Modell-ID, Aufwand, Latenz, Token-Nutzung, Cache-Nutzung, Stopgrund, Fallback-Verhalten und finalen Aufgabenerfolg protokollieren.
Fable 5.1 für Repository-weite Migrationen, schwieriges Debugging, langlaufende Agents, tiefe Recherche, große Dokumentsynthese und hochwertige Aufgaben nutzen, bei denen günstigere Modelle wiederholt scheitern. Es nicht als Standard für Zusammenfassungen, Klassifikation, Extraktion und kurze Customer-Service-Antworten verwenden.
Beispiel: Untersuchung eines Checkout-Incidents
Ein Team könnte bereinigte Checkout-Fehler, jüngste Deployment-Diffs und relevante Runbooks bereitstellen. Die Anwendung ruft passende Incident-Datensätze ab und bittet das Modell dann, mögliche Ursachen zu bewerten und jede Hypothese mit Belegen zu untermauern. Eine Ingenieurin/ein Ingenieur überprüft die vorgeschlagenen Diagnoseschritte und genehmigt einen Test in einer Sandbox mit synthetischen Transaktionen. Die Abnahmekriterien sind reproduzierbares Verhalten, nachvollziehbare Belege und bestandene Regressionstests; jede Produktionsbehebung erfordert separate menschliche Freigabe.
Beispiel: Analyse von Änderungen an Betriebsanforderungen
Ein Team könnte ein genehmigtes Betriebshandbuch, unterstützende Richtlinien und einen überarbeiteten Entwurf liefern. Halten Sie unverändertes Referenzmaterial als stabilen Kontext und bitten Sie das Modell dann, geänderte Verpflichtungen, verantwortliche Teams, Fristen und Ausnahmen zu vergleichen. Jeder vorgeschlagene Befund sollte die relevanten Passagen in beiden Versionen referenzieren und explizite Änderungen von unsicheren Interpretationen unterscheiden. Die Abnahmekriterien sind, dass eine Prüferin/ein Prüfer jede gemeldete Änderung anhand der zitierten Belege bestätigt, bevor Verfahren aktualisiert oder betroffene Teams benachrichtigt werden.
Fazit
Claude Fable 5.1 ist kein einfaches Update der Modellzeichenfolge. Sein erzwungenes Tool-Verhalten, die Regeln zur Thinking-Historie, Aufwandsteuerung, Cache-Ökonomie und Langlauf-Fortschrittsfunktionen erfordern eine durchdachte Migration.
Die effektivste Bereitstellung nutzt Claude Sonnet 5 für das Routinevolumen, Claude Opus 5 für komplexen Standardtraffic und Claude Fable 5.1 als wohlüberlegte Fähigkeitseskalation. Befördern Sie es nur, wenn sich die Abschlussquote akzeptierter Aufgaben ausreichend erhöht, um Gesamtkosten und Latenz zu rechtfertigen.