Technische Spezifikationen von GLM-5.2
| Element | GLM-5.2 |
|---|---|
| Anbieter | Zhipu AI |
| Veröffentlichungsdatum | June 13, 2026 |
| Modelltyp | Open-Weight Mixture-of-Experts (MoE) LLM |
| Gesamtparameter | ~744B |
| Aktive Parameter | ~40B pro Token |
| Kontextfenster | 1,000,000 tokens |
| Maximale Ausgabe | 131,072 tokens |
| Reasoning-Modi | High, Max |
| Lizenz | MIT |
| Primärer Schwerpunkt | Agentic coding, Software Engineering, Long-Horizon Reasoning |
| API-Verfügbarkeit | Z.ai platform and compatible providers |
| Offene Gewichte | Yes |
GLM-5.2 ist das neueste Flaggschiffmodell aus der GLM-Familie von Zhipu AI. Anders als allgemeine Spitzenmodelle ist GLM-5.2 in erster Linie als coding-first und agentenorientiertes Modell positioniert, das für Software-Engineering im Repository-Maßstab, autonome Workflows und extrem langkontextiges Reasoning entwickelt wurde. Sein Hauptmerkmal ist ein natives Kontextfenster mit 1 million Tokens, was es zu einem der größten öffentlich verfügbaren Kontextfenster unter Open-Weight-Modellen macht.
Hauptfunktionen von GLM-5.2
- 1M-Token-Kontextfenster für gesamte Repositories, umfangreiche Dokumentationssätze und Agent-Workflows über mehrere Sitzungen hinweg.
- Coding-first-Optimierung mit Fokus auf Refactoring, Debugging, Codegenerierung und Software-Engineering-Aufgaben.
- Unterstützung agentischer Workflows für Tools wie Claude Code, Cline, Roo Code, OpenCode und ähnliche Coding-Agents.
- Open-Weight-Veröffentlichung unter MIT-Lizenz, ermöglicht Self-Hosting und Fine-Tuning.
- Zwei Reasoning-Modi (High und Max), die Trade-offs zwischen Latenz und Reasoning-Tiefe erlauben.
- Große MoE-Architektur mit ungefähr 744B Gesamtparametern, wobei pro Token nur ~40B aktiviert werden, um Effizienz zu erreichen.
Benchmark-Leistung von GLM-5.2
Zhipu veröffentlichte zum Start keine umfassenden offiziellen Benchmark-Ergebnisse, was direkte Benchmarks unsicherer macht als bei Modellen wie GPT-5 oder Claude. Mehrere Branchenberichte vermerken das Fehlen unabhängig validierter Benchmark-Veröffentlichungen.
| Benchmark | Gemeldeter Score |
|---|---|
| Terminal-Bench 2.1 | 81.0 |
| SWE-Bench Pro | 62.1 |
| NL2Repo | 48.9 |
| AIME 2026 | 99.2 |
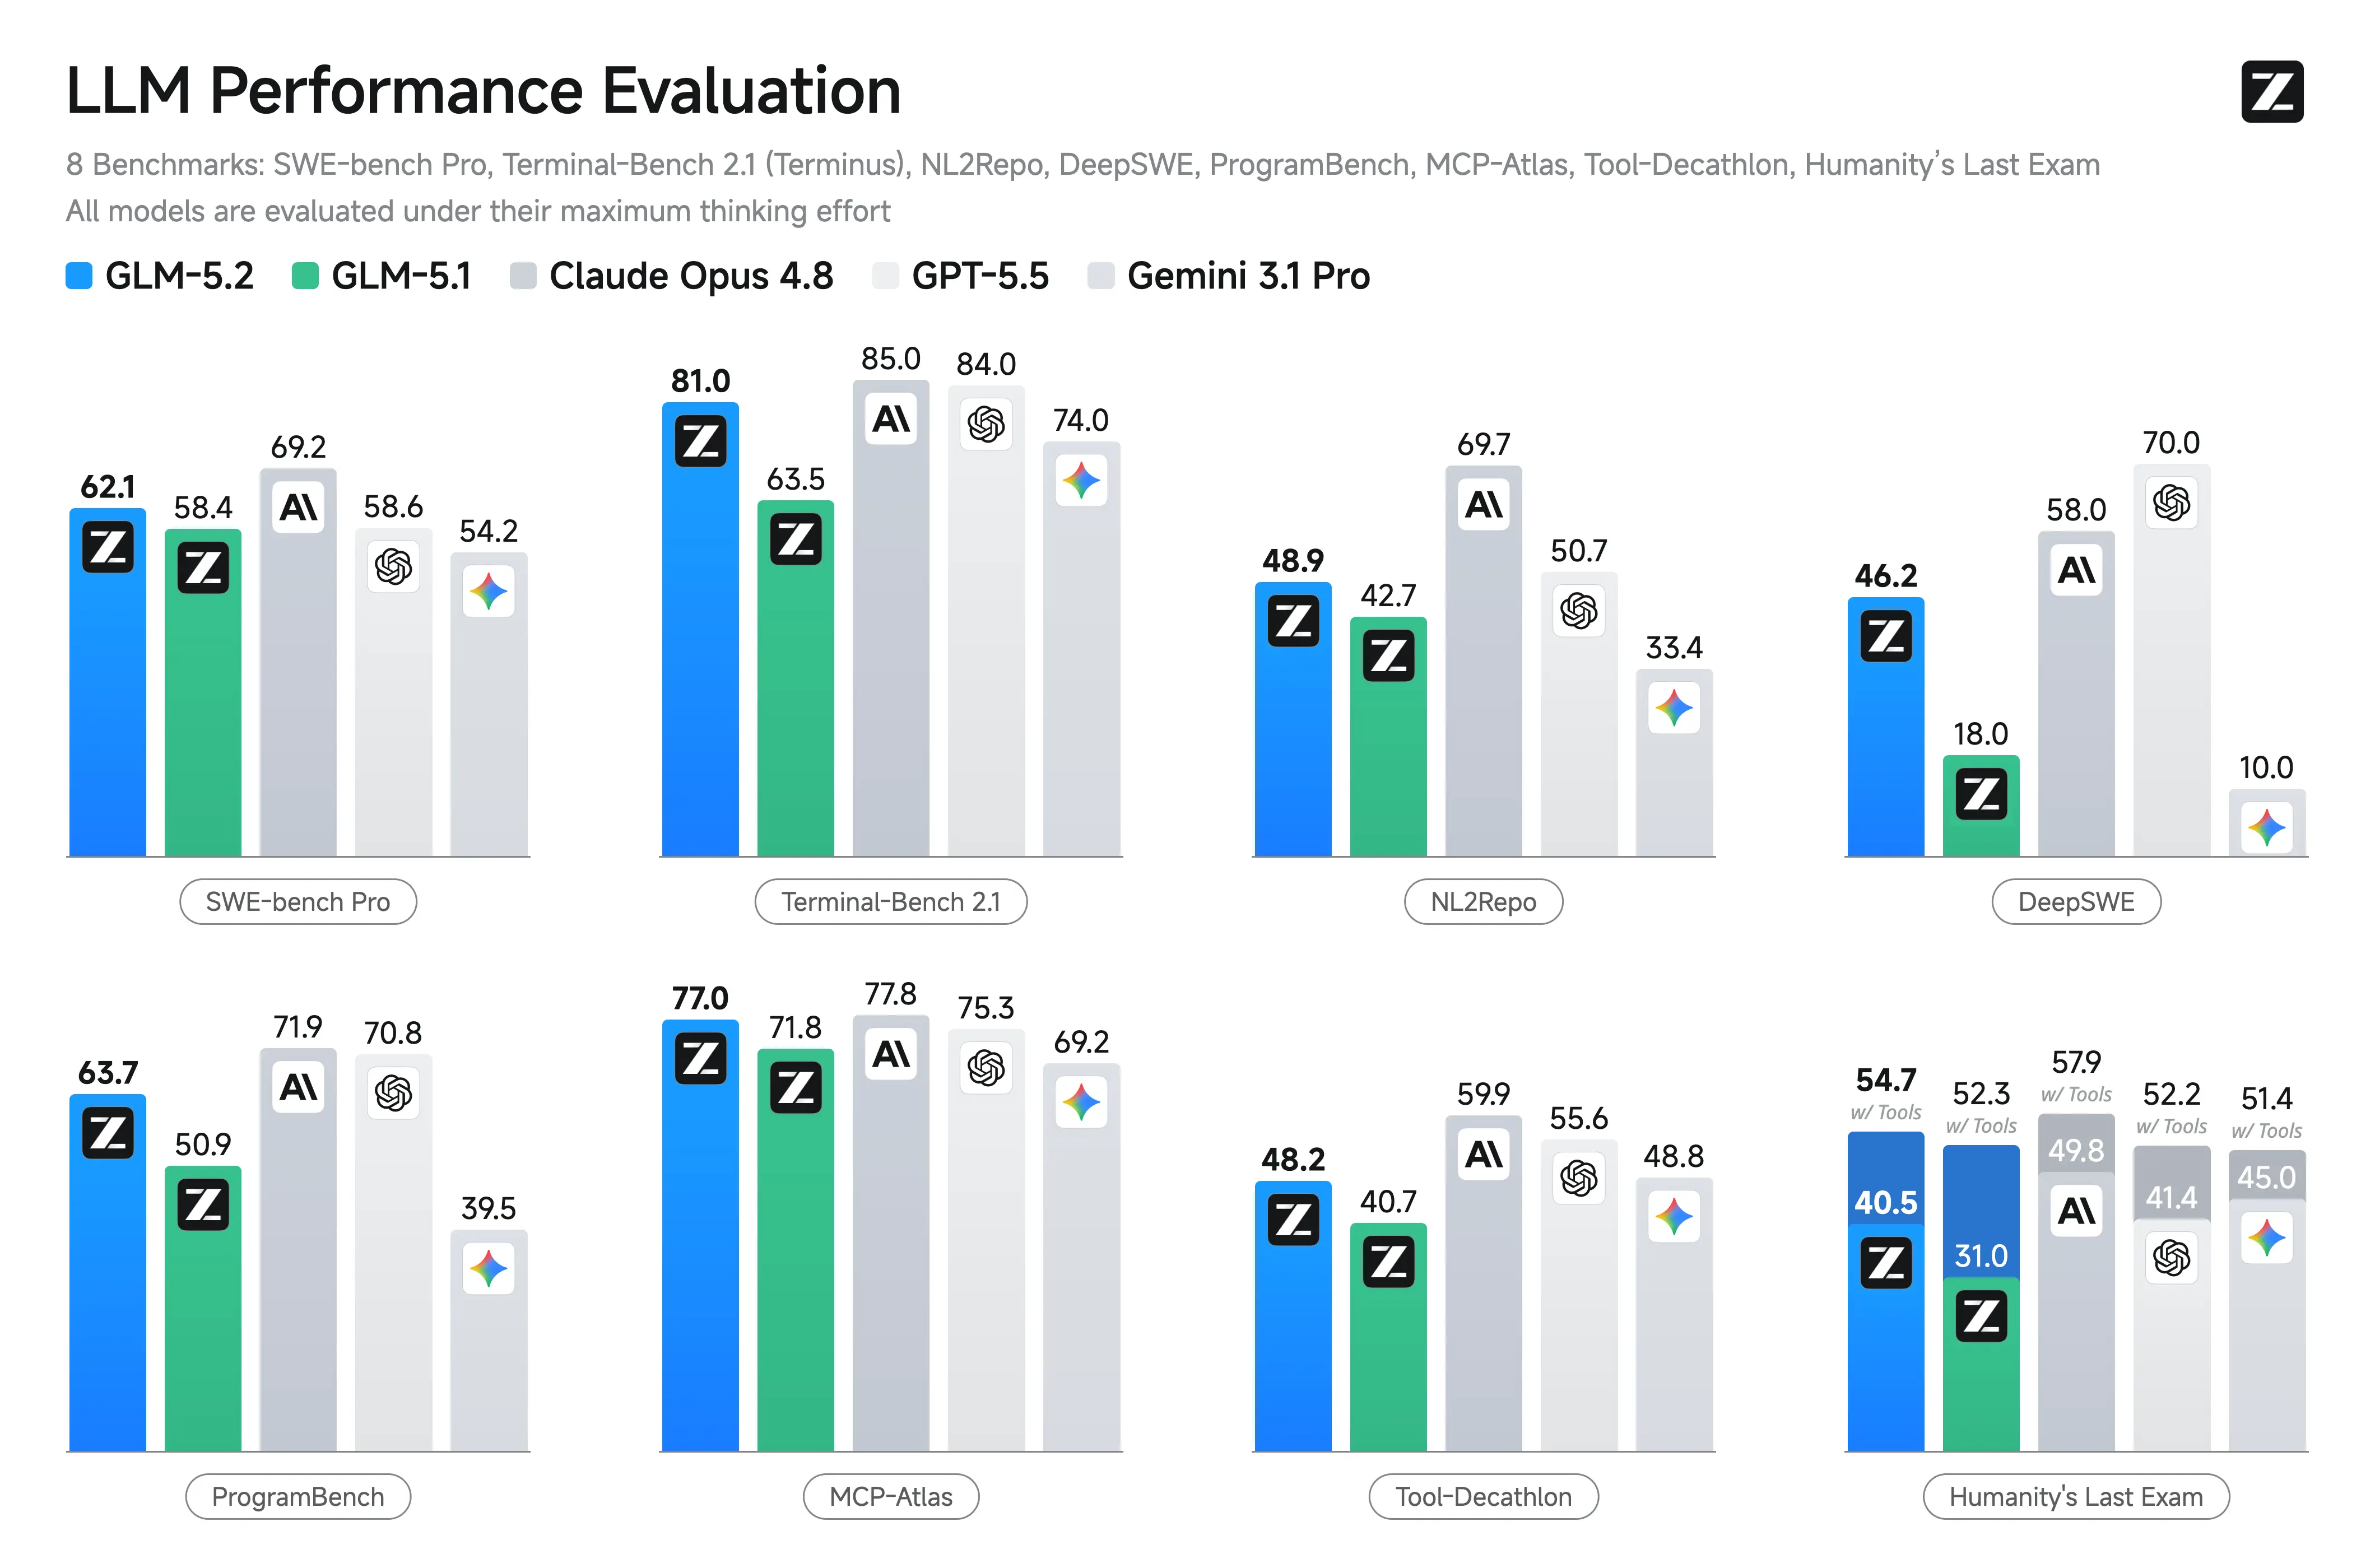
GLM-5.2 vs GLM-5.1 vs Claude Opus 4.8
| Spezifikation | GLM-5.2 | GLM-5.1 | Claude Opus 4.8 |
|---|---|---|---|
| Veröffentlichungsdatum | 2026-06-13 | 2026 | 2026 |
| Kontextfenster | 1,000,000 | ~200,000 | 1,000,000 |
| Offene Gewichte | Yes (MIT) | Yes | No |
| Reasoning-Modi | High, Max | Standard | Extended Thinking |
| Gesamtparameter | 744B | 744B | Not disclosed |
| Aktive Parameter | 40B | 40B | Not disclosed |
| Offizielle Benchmark-Daten | Not published | Published at launch | Published |
Die primär dokumentierte Verbesserung von GLM-5.2 gegenüber GLM-5.1 ist die Erweiterung auf ein 1M-Token-Kontextfenster und die Einführung der auswählbaren Reasoning-Modi High und Max. Zum Start veröffentlichte Z.ai keine offiziellen Ergebnisse für SWE-Bench, LiveCodeBench, HumanEval oder ähnliche Benchmarks, daher bleiben Leistungsvergleiche mit Claude Opus 4.8, GPT-5, DeepSeek oder Qwen-Modellen unbestätigt.
Im Vergleich zu anderen offenen Modellen ist GLM-5.2s wichtigstes Unterscheidungsmerkmal die Kombination aus sehr großem Kontextfenster, Spezialisierung auf Coding und MIT-Lizenzierung. Seine größte Attraktivität liegt beim Software-Engineering im Repository-Maßstab statt bei allgemeinen Chat-Anwendungen.
Warum GLM-5.2 über CometAPI nutzen?
CometAPI ermöglicht es Entwicklern, GLM-5.2 über dieselbe Schnittstelle zu integrieren, die für Dutzende führender KI-Modelle verwendet wird.
Vorteile umfassen:
- Einheitliche Authentifizierung über mehrere Anbieter hinweg
- OpenAI-kompatible API-Integration
- Vereinfachtes Abrechnungs- und Nutzungsmanagement
- Schnelle Experimente mit alternativen Modellen
- Einfaches Umschalten zwischen Coding-, Reasoning-, Bild-, Audio- und Videomodellen
- Geringere Anbieterbindung für produktive Systeme
Egal, ob Sie eine KI-IDE, einen internen Engineering-Assistenten oder eine Enterprise-Automatisierungsplattform aufbauen, CometAPI minimiert den Integrationsaufwand und erhält zugleich die Flexibilität.
So greifen Sie auf die GLM-5.2-API über CometAPI zu
Starten Sie mit unserem Produkt in nur wenigen einfachen Schritten...
Schritt 1: Melden Sie sich für Ihren GLM-5.2-API-Schlüssel an
Erstellen Sie ein Konto auf CometAPI und navigieren Sie zum API-Dashboard, um Ihren GLM-5.2-API-Schlüssel zu generieren. Dieser Schlüssel authentifiziert all Ihre Anfragen und gibt Ihnen unmittelbaren Zugriff auf die vollständigen Fähigkeiten der GLM-5.2-API, einschließlich des 1M-Token-Kontextfensters und 128k Ausgabetokens.
Schritt 2: Senden Sie Anfragen an die GLM-5.2-API
Verwenden Sie Ihren GLM-5.2-API-Schlüssel, um POST-Anfragen an den CometAPI-Endpunkt zu senden. Übergeben Sie Ihren Prompt, setzen Sie Modellparameter wie Aufwandsstufe und maximale Token, und die GLM-5.2-API verarbeitet Ihre Anfrage — von Codegenerierung über Dokumentenanalyse bis hin zur agentischen Tool-Nutzung.
Schritt 3: Ergebnisse abrufen und GLM-5.2-API integrieren
Die GLM-5.2-API liefert strukturierte Antworten, einschließlich Completion-Text, Anweisungen zum Tool-Calling und Metadaten zur Token-Nutzung. Sie unterstützt sowohl standardmäßige synchrone Antworten als auch Echtzeit-Streaming via Server-Sent Events (SSE), wenn stream: true konfiguriert ist. Der Endpunkt lässt sich leicht in Ihre bestehenden Workflows integrieren, indem Sie Anfragen über url(//api.cometapi.com/v1) mit Ihrem Bearer Token routen, unter Verwendung gängiger HTTP-Clients oder OpenAI-kompatibler SDKs.