
Antwort zuerst
GPT-6 Astra ist das neue Flaggschiffmodell von OpenAI für anspruchsvolle End-to-End-Arbeiten. OpenAI hat GPT-6 Astra veröffentlicht am 3. September 2026 und positioniert es für komplexes Reasoning, Computer-Nutzung, Coding, Forschung, wissenschaftliche Arbeit und professionelle Artefakterstellung. Das API-Modell verfügt über ein 1.05M-Token-Kontextfenster und 128K maximale Ausgabe, akzeptiert Text- und Bildeingaben und unterstützt den Reasoning-Aufwand von low bis max. Die Standard-API-Preise beginnen bei $10 Eingabe / $50 Ausgabe pro Million Tokens. Die wichtigste praktische Änderung ist kein einheitlicher Sprung auf jeder General-Intelligence-Benchmark: Astras größte Zugewinne zeigen sich bei agentischer Ausführung, Computer-Nutzung, Langkontext-Retrieval, Coding-Workflows, Wissenschaft und Cybersicherheit.
Das ist wichtig, weil der ältere CometAPI-Artikel GPT-6 Is Coming Soon — What Will It Look Like? zwangsläufig spekulativ war. Da Astra jetzt öffentlich ist, konzentriert sich dieser Leitfaden auf bestätigtes Modellverhalten, Benchmark-Trade-offs, API-Ökonomie und darauf, wo das Modell tatsächlich eine bessere Wahl ist als günstigere Alternativen an der Frontier.
Was ist GPT-6 Astra?
GPT-6 Astra ist der Nachfolger von OpenAIs Flaggschiff GPT-5.6 Sol. OpenAI beschreibt Astra als sein fähigstes Modell für die härteste End-to-End-Arbeit mit Schwerpunkt auf Workflows, die vom Modell verlangen zu schlussfolgern, Werkzeuge zu nutzen, mit Software zu interagieren, Zwischenstände zu überarbeiten und eine Aufgabe von der ersten Anfrage bis zum fertigen Ergebnis zu tragen. Diese Positionierung ist wichtig: Astra ist nicht einfach ein größeres Chat-Modell. Es ist als Reasoning-Engine innerhalb von Agenten konzipiert, die über Browser, Terminals, Dokumente, Tabellenkalkulationen, Entwicklungsumgebungen und Unternehmenssoftware arbeiten.
Der Launch-Post hebt State-of-the-Art-Ergebnisse bei Computer-Nutzung, Browsing, Software Engineering, Cybersicherheit, Wissenschaft und professioneller Arbeit hervor. Er berichtet 97.6% / 99.9% / 100% auf FrontierMath Tier 4, ARC-AGI-3 und ExploitBench. Diese Schlagzeilenergebnisse sind eindrucksvoll, sollten aber nicht als „Astra gewinnt jede Benchmark“ interpretiert werden. Auf dem Artificial Analysis Intelligence Index, der in OpenAIs eigener Vergleichstabelle verwendet wird, erzielt Astra 61.2, während Claude Fable 5.1 65.7 erreicht. Der Release ist daher eher als Quantensprung in Ausführung und agentischer Arbeit zu verstehen denn als sauberer Durchmarsch auf allen Intelligenzmaßen.
Was hat sich gegenüber GPT-5.6 Sol geändert?
Computer-Nutzung wurde zur zentralen Kernfähigkeit
Astras klarster Generationsgewinn ist die Computer-Nutzung. Auf OSWorld 2.0 meldet OpenAI 72.6% für Astra gegenüber 65.7% für GPT-5.6 Sol. In derselben Latenzsimulation erledigte Astra Aufgaben in etwa 40 Minuten gegenüber rund 75 Minuten bei Sol, eine Reduktion um ca. 47%. Zusammen mit einem aktualisierten Codex-Harness berichtet OpenAI eine 1,9× schnellere Fertigstellung auf Mind2Web. Der praktische Punkt ist nicht nur, dass Astra einen Bildschirm sehen kann; es kann eine mehrstufige Softwareaufgabe länger kohärent halten und dabei weniger kostspielige Umwege machen.
Professionelle Artefakterstellung ist zielgerichteter
OpenAI hat Astra explizit für professionelle Workflows trainiert, die in nutzbaren Artefakten statt in Rohprosa enden. Die Launch-Materialien beschreiben bessere Leistungen bei Dokumenten, Tabellenkalkulationen, Präsentationen, Datenanalyse, Designarbeit und der Einhaltung von Vorlagen. Zudem ist Astra besser darin, die Orientierung zu behalten, wenn sich Anforderungen mitten in der Aufgabe ändern, sodass eine Steuerungsnachricht das ursprüngliche Ziel seltener überschreibt. Das ist besonders nützlich bei langlaufenden Unternehmensagenten, bei denen neue Anweisungen oft eintreffen, nachdem der Workflow bereits gestartet wurde.
Lange Sitzungen behalten mehr nützlichen Arbeitskontext
Für lange Coding-Sitzungen führt Astra eine neue Methode ein, mit der Codex Notizen bewahren und abrufen kann, nachdem der aktive Kontext voll ist. Frühere Ansätze stützten sich stark auf Kompaktion, die weglassen kann, warum ein Versuch fehlgeschlagen ist oder welche Einschränkungen bereits getestet wurden. OpenAI sagt, Astra kann Notizen über Kontextfenster hinweg behalten, was die Kontinuität bei großen Refactorings und Debugging-Sitzungen verbessert.
Reasoning-Aufwand reicht jetzt bis max
Entwickler können low, medium, high, xhigh oder max als Reasoning-Aufwand wählen. Das schafft eine breitere Qualitäts-Kosten-Kurve als Astra als einzigen festen Betriebspunkt zu betrachten. Die offiziellen Modellrichtlinien empfehlen, den niedrigsten Aufwand zu wählen, der Ihr Eval-Ziel erfüllt, weil die beste Ökonomie des Modells oft aus Token-Effizienz statt aus ständigem Betrieb auf maximalem Reasoning resultiert.
Leistungswerte von GPT-6 Astra in Benchmarks
OpenAI veröffentlichte einen breiten Vergleich über Computer-Nutzung, professionelle Arbeit, Coding, akademisches Reasoning, Gesundheit, Cybersicherheit, langen Kontext und Alignment. Die nützlichste Art, die Tabelle zu lesen, ist, „generelle Intelligenz“ von „Fähigkeit zur Ausführung werkzeuggestützter Arbeit“ zu trennen. Astra liegt in OpenAIs Tabelle nur marginal über Sol auf dem Artificial Analysis Intelligence Index, ist jedoch auf mehreren agentischen und operativen Benchmarks deutlich voraus.
| Benchmark | GPT-6 Astra | GPT-5.6 Sol | Was die Differenz nahelegt |
|---|---|---|---|
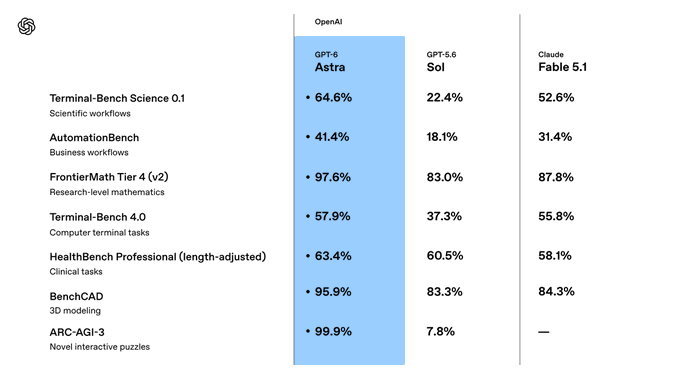
| AutomationBench | 41.4% | 18.1% | Großer Zuwachs bei End-to-End-Geschäftsabläufen |
| OSWorld 2.0 | 72.6% | 65.7% | Bessere Computer-Interaktion und Aufgabenfertigstellung |
| Terminal-Bench 4.0 | 57.9% | 37.3% | Großer Zuwachs beim terminalbasierten agentischen Coding |
| Terminal-Bench Science 0.1 | 64.6% | 22.4% | Großer Zuwachs bei wissenschaftlichen Workflows mit Code/Werkzeugen |
| FrontierMath Tier 4 v2 | 97.6% | 83.0% | Stärkeres mathematisches Reasoning auf Frontier-Niveau |
| ExploitBench | 100.0% | 78.5% | Cybersicherheitsfähigkeit der Klasse "Critical" |
| SRE-Bench, one attempt | 88.0% | 55.9% | Deutlich stärker bei Reverse Engineering / SRE-Arbeit |
| MRCR v2, 512K-1M | 96.3% | 73.8% | Verbesserte sehr-langkontextige Retrieval-Leistung |
| AA Intelligence Index v4.1.1 | 61.2 | 60.9 | Allgemeine Intelligenz ist gegenüber Sol im Wesentlichen unverändert |
Das Muster ist ungewöhnlich klar. Astras Vorteil ist am größten, wenn eine Benchmark eine nachhaltige Interaktion mit einem Werkzeug oder einer Umgebung erfordert. AutomationBench steigt von 18.1% auf 41.4%; Terminal-Bench Science erhöht sich von 22.4% auf 64.6%; und das Langkontext-MRCR verbessert sich von 73.8% auf 96.3% im 512K–1M-Band. Dagegen bewegt sich der Artificial Analysis Intelligence Index von 60.9 auf 61.2. Deshalb verfehlt die Beschreibung „2,5× teurer, aber nur geringfügig smarter“ den tatsächlichen Wert des Produkts.
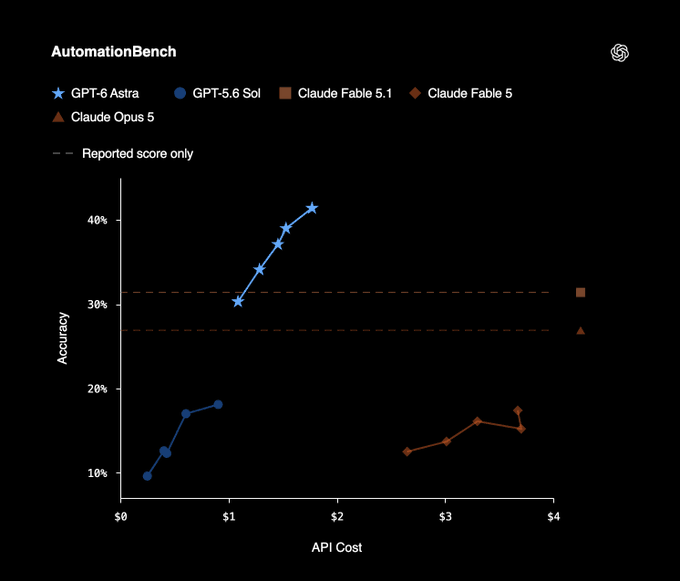
Quelle: OpenAI AutomationBench Diagramm (Originalbild, nicht neu gezeichnet)
Unabhängige Benchmarks: Ist GPT-6 Astra ein Generationssprung?
Unabhängige Tests bringen einen wichtigen Realitätscheck. Artificial Analysis berichtet einen Intelligence Index von 61, gleichauf mit GPT-5.6 Sol bei max Aufwand. Gleichzeitig verbessert sich Astra deutlich im Coding Agent Index und verbraucht erheblich weniger Tokens im agentischen Coding. Artificial Analysis maß eine etwa dreifache Reduktion des Tokenverbrauchs gegenüber GPT-5.6 Sol bei max Aufwand in seinem Codex-Harness, sodass Astra bei etwa gleichen Kosten pro Coding-Agent-Aufgabe höher punktet.
Die Ökonomie sieht bei allgemeiner Intelligenz weniger günstig aus. Astra verwendet rund 10% weniger Ausgabe-Tokens als Sol im Intelligence Index bei max Aufwand, aber der 2,5× höhere Preis pro Token dominiert diesen Effizienzgewinn; Artificial Analysis schätzt, dass Astra etwa 75% teurer pro Aufgabe bei max Aufwand ist. Es berichtet außerdem eine Reduktion der Halluzinationsrate von 92% auf 51% bei AA-Omniscience, während die Genauigkeit um vier Punkte stieg.
Die nützliche Schlussfolgerung ist workloadspezifisch: GPT-6 Astra wirkt am stärksten generationell dort, wo ein Agent handeln, iterieren, Werkzeuge nutzen und einen komplizierten Auftrag abschließen muss. Für gewöhnliches Reasoning oder hochvolumige Textgenerierung lässt sich die Preisdifferenz deutlich schwerer amortisieren.
GPT-6 Astra vs GPT-5.6 Sol vs Claude Fable 5.1 vs Gemini 3.8 Flash
Ein praxisnaher Modellvergleich sollte Fähigkeit, Multimodalität, Kontext, agentische Ausführung und Preis umfassen. Die folgenden Modelle sind nicht austauschbar: Astra optimiert auf harte End-to-End-Ausführung, Claude Fable 5.1 führt einige General-Intelligence-Messungen an, und Gemini 3.8 Flash bietet deutlich niedrigere Tokenpreise mit breiteren nativen Eingabemodalitäten.
| Metrik | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Gemini 3.8 Flash |
|---|---|---|---|---|
| Kontextfenster | 1.05M | 1.05M | 1M | 1.048M |
| Maximale Ausgabe | 128K | 128K | 128K | 65.5K |
| Eingabemodalitäten | Text, Bild | Text, Bild | Text, Bild/PDF | Text, Bild, Audio, Video, PDF |
| AA Intelligence Index | 61.2 | 60.9 | 65.7 | 58.7 |
| AutomationBench | 41.4% | 18.1% | 31.4% | — |
| Terminal-Bench 4.0 | 57.9% | 37.3% | 55.8% | 19.1% |
| DeepSWE 1.1 | 74.1% | 72.7% | 67.4% | 73.8% |
| FrontierMath Tier 4 v2 | 97.6% | 83.0% | 87.8% | — |
| HLE with tools | 57.2% | — | 65.0% | — |
| HealthBench Professional | 63.4% | 60.5% | 58.1% | 52.1% |
| Offizieller Standardpreis für Eingabe | $10/M | $4/M | $10/M | $0.75/M |
| Offizieller Standardpreis für Ausgabe | $50/M | $20/M | $50/M | $3.75/M |
Wann GPT-6 Astra die bessere Wahl ist
Wählen Sie Astra, wenn die Aufgabe teuer ist, weil Menschen fehlgeschlagene Agentenläufe retten müssen: lange Codeänderungen, Browser-/Desktop-Automatisierung, tiefgehende Forschung über Tools hinweg, Erstellung technischer Artefakte oder komplexe wissenschaftliche und operative Workflows. Sein Premium lässt sich am leichtesten rechtfertigen, wenn weniger Wiederholungen, weniger manuelle Korrekturen und geringerer Ausgabe-Tokenverbrauch wichtiger sind als der reine Preis pro Token.
Wann Claude Fable 5.1 die bessere Wahl ist
Claude Fable 5.1 bleibt ein ernsthafter Frontier-Konkurrent. In OpenAIs eigener Launch-Tabelle erzielt es 65.7 auf dem Artificial Analysis Intelligence Index gegenüber Astras 61.2 und 65.0 auf Humanity’s Last Exam mit Tools gegenüber Astras 57.2. Das bedeutet, Astra sollte nicht als universeller Intelligenzsieger vermarktet werden. Wenn Ihr Evaluationsset eher langformiges Reasoning als Computer-Nutzung widerspiegelt, kann Claude Fable 5.1 weiterhin die stärkere Wahl sein.
Wann Gemini 3.8 Flash die bessere Wahl ist
Gemini 3.8 Flash zielt auf einen anderen Punkt der Frontier. Es unterstützt Text-, Bild-, Audio-, Video- und PDF-Eingabe mit einem Kontextfenster von rund 1M Tokens, während die offiziellen Einführungspreise deutlich unter Astra liegen. Für hochvolumige multimodale Extraktion, Video-/Audioverstehen, Routine-Agenten oder Workloads, bei denen $10/$50 Token-Ökonomie schwer zu rechtfertigen ist, ist Gemini 3.8 Flash oft die wirtschaftlichere Produktionswahl.
Warum die Cybersicherheitsbewertung von GPT-6 Astra wichtig ist
Astra ist das erste breit eingesetzte OpenAI-Modell, das die Schwelle „Critical“ der Cybersicherheitsfähigkeit im Preparedness Framework des Unternehmens erreicht. OpenAI sagt, das Modell könne zuvor unbekannte Sicherheitslücken identifizieren und Ausnutzungsstrategien über gehärtete Systeme hinweg entwickeln, wenn es die richtigen Tools und Zugänge erhält. In den Launch-Evaluierungen erreichte Astra 100% auf ExploitBench, 42.4% auf ExploitGym und 88.0% auf SRE-Bench mit einem Versuch.
Diese Fähigkeit geht mit strengeren Einsatzkontrollen einher. OpenAI sagt, Produktionsschutzmaßnahmen können legitime Arbeit verlangsamen, pausieren oder stoppen, insbesondere in höher riskanten Cyber-Kontexten. ChatGPT oder Codex können einen Nutzer bitten, eine Aktion zu prüfen, bevor es weitergeht, während eine API-Aufgabe stoppen kann. Die Standardbereitstellung von Astra verweigert zudem fortgeschrittenere Exploit-Erstellungsanfragen; OpenAIs Daybreak-Programm bietet separaten, geprüften Zugang für einige defensive Workflows.
Die Systemkarte dokumentiert einen Trade-off bei der Überwachbarkeit: Astra ist insgesamt besser ausgerichtet als Sol, aber sein geschriebenes Reasoning kann unter adversarialen Evaluationsbedingungen schwieriger zu überwachen sein. OpenAI setzt daher breitere Missalignment-Überwachung rund um werkzeugnutzende Astra-Inferenz ein. Unternehmenseams sollten Agentenberechtigungen, Freigabegrenzen, Audit-Logs und Least-Privilege-Zugriff auf Tools als Teil der Modellarchitektur betrachten, nicht als optionale Add-ons.
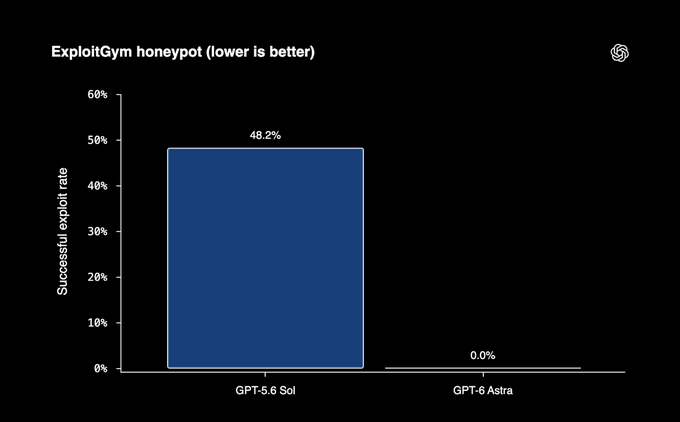
Quelle: OpenAI offizielles ExploitGym Honeypot-Sicherheitsdiagramm (Originalbild, nicht neu gezeichnet)
Preise für GPT-6 Astra
OpenAIs aktuelle API-Preisseite trennt Kurzkontext- und Langkontext-Anfragen. Für Standard-Verarbeitung liegen die Kurzkontext-Sätze bei $10 Eingabe, $1 zwischengespeicherte Eingabe, $12.50 Cache-Schreibvorgänge und $50 Ausgabe pro Million Tokens. Anfragen über 272K Eingabe-Tokens nutzen den Langkontext-Tarif: $20 Eingabe, $2 zwischengespeicherte Eingabe, $25 Cache-Schreibvorgänge und $75 Ausgabe pro Million Tokens.
| Verarbeitung / Kontext | Eingabe | Zwischengespeicherte Eingabe / Cache-Schreibvorgang | Ausgabe |
|---|---|---|---|
| Standard, kurzer Kontext | $10/M | $1/M / $12.50/M | $50/M |
| Standard, langer Kontext (>272K Eingabe) | $20/M | $2/M / $25/M | $75/M |
| Batch / Flex, kurzer Kontext | $5/M | $0.50/M / $6.25/M | $25/M |
| Batch / Flex, langer Kontext | $10/M | $1/M / $12.50/M | $37.50/M |
| Fast mode, kurzer Kontext | $20/M | $2/M / $25/M | $100/M |
| Fast mode, langer Kontext | $40/M | $4/M / $50/M | $150/M |
Verglichen mit GPT-5.6 Sol sind Astras Standard-Kurzkontext-Tokenpreise 2,5× höher ($10/$50 gegenüber $4/$20). Dieses Premium bedeutet nicht automatisch 2,5× höhere Kosten pro erledigter Aufgabe. Beim agentischen Coding berichten sowohl OpenAI als auch Artificial Analysis in manchen Konfigurationen einen geringeren Ausgabe-Tokenverbrauch für Astra. Die korrekte Maßeinheit für die Evaluation ist daher die Kosten pro erfolgreicher Aufgabe, nicht nur die Kosten pro Token.
Wie man auf GPT-6 Astra zugreift
OpenAI begann einen gestuften Rollout am 3. September 2026. Astra wird in den folgenden Tagen ChatGPT Plus, Pro, Business und Enterprise-Nutzer, die OpenAI API und AWS erreichen. Enterprise-Administratoren können Astra pro Workspace aktivieren; zum Launch ist der Zugriff standardmäßig deaktiviert.
GPT-6 Astra mit der OpenAI Responses API aufrufen
from openai import OpenAI
client = OpenAI()

response = client.responses.create(
    model="gpt-6-astra",
    reasoning={"effort": "high"},
    input=(
        "Review this repository architecture. Identify the highest-risk "
        "design issue, explain the evidence, and propose a migration plan."
    ),
)

print(response.output_text)
Die Modell-ID ist gpt-6-astra. Für toolintensive Workflows ist die Responses API der natürliche Ausgangspunkt, da Astra Funktionsaufrufe, strukturierte Ausgaben, Websuche, Dateisuche, Code-Interpreter, gehostete Shell, apply patch, Computer-Nutzung, MCP und Toolsuche unterstützt. Feinabstimmung ist derzeit nicht unterstützt.
Praxisnahe Anwendungsfälle für GPT-6 Astra
Spieleentwicklung und visuelle Software-Workflows
Playco testete Astra innerhalb von Playbot, einer KI-gestützten IDE, die direkt in Unity und Godot arbeitet. OpenAI berichtet 50% weniger manuelle Korrekturen als mit dem vorherigen Modell und drei thematische Prototypen, gebaut aus einer einzigen Grey-Box-Grundlage. Dieses Beispiel ist wichtig, weil die Aufgabe mehr als Quellcode-Generierung erfordert: Das Modell muss über räumliches Layout schlussfolgern, das Spiel spielen, Änderungen testen, Bugs identifizieren und in einer visuellen Umgebung iterieren.
Juristische und finanzielle Dokumentenprüfung
OpenAI positioniert Astra für mehrstufige professionelle Workflows, die polierte Dokumente, Tabellen und Analysen produzieren. In der juristischen und finanziellen Prüfung liegt sein praktischer Wert darin, den Task-State über viele Dateien hinweg zu halten, Belege gegenzuprüfen und ein fertiges Artefakt statt einer isolierten Antwort zurückzugeben. Expertenvalidierung, Freigabekontrollen und Least-Privilege-Datenzugriff bleiben notwendig.
Langfristige Engineering-Agenten
Die Kombination aus Terminal-Bench, DeepSWE, Datenbankmigration, Computer-Nutzung und Langkontext-Ergebnissen macht Astra besonders relevant für Engineering auf Repository-Ebene. Ein nützliches Einsatzmuster ist, Astra eine eingeschränkte Entwicklungsumgebung, ein Issue oder Migrationsziel, Tests und Toolzugang zu geben; anschließend bewertet man Erfolg anhand der Qualität der gemergten Aufgaben, der Zahl fehlgeschlagener Iterationen, der menschlichen Review-Zeit und der Gesamtkosten. Das ist eine bessere Produktionsmetrik als ein einzelner Coding-Benchmark-Score.
Einschränkungen von GPT-6 Astra
- Premium-Tokenpreis. Astra kostet 2,5× GPT-5.6 Sol pro Token bei Standard-Kurzkontextpreisen, daher sind Routine-Chat, Klassifikation, Extraktion und einfaches Schreiben oft unwirtschaftlich.
- Langer Kontext hat einen Aufschlag. Anfragen mit mehr als 272K Eingabe-Tokens wechseln für die gesamte Anfrage auf höhere Sätze, daher sollte „1.05M Kontext“ nicht als flache Preis-Memory interpretiert werden.
- Keine native Audio- oder Videoeingabe im Modell. Astra akzeptiert Text und Bilder und gibt Text aus; Gemini 3.8 Flash ist flexibler, wenn natives Audio-/Videoverstehen zentral ist.
- Keine Feinabstimmung. Die offizielle Modellseite listet Feinabstimmung derzeit als nicht unterstützt, daher stützen sich Anpassungen auf Prompting, Tools, Retrieval und Workflow-Design.
- Cyber-Schutzmaßnahmen können Workflows unterbrechen. OpenAI warnt ausdrücklich, dass zusätzliche Sicherheitschecks legitime Arbeit in höher riskanten Kontexten pausieren oder stoppen können.
- Kein universeller Benchmark-Gewinner. Claude Fable 5.1 führt Astra auf dem Artificial Analysis Intelligence Index und HLE-with-tools in OpenAIs eigener Launch-Vergleichstabelle.
FAQs
Ist GPT-6 Astra offiziell veröffentlicht?
Ja. OpenAI begann den Rollout am 3. September 2026. Die Verfügbarkeit ist gestaffelt über Organisationen, ChatGPT-Bezahlpläne, API-Zugriff und AWS statt für jedes Konto zur selben Zeit zu erscheinen.
Wie groß ist das Kontextfenster von GPT-6 Astra?
Die offizielle Modellseite listet ein Kontextfenster mit 1.05M Tokens und eine maximale Ausgabe von 128K Tokens. Anfragen über 272K Eingabe-Tokens nutzen den Langkontext-Preisplan.
Wie viel kostet GPT-6 Astra?
Standard-Kurzkontextpreise sind $10 Eingabe / $50 Ausgabe pro Million Tokens, mit $1 zwischengespeicherter Eingabe und $12.50 Cache-Schreibvorgängen. Langkontext-, Batch/Flex- und Fast-mode haben andere Sätze, daher sollten Produktionsschätzungen den Tarif verwenden, der der tatsächlichen Anfrage entspricht.
Ist GPT-6 Astra besser als Claude Fable 5.1?
Es hängt vom Workload ab. Astra führt auf mehreren Bewertungen zu Computer-Nutzung, Coding-Agenten, Wissenschaft, Cyber und professioneller Arbeit, während Claude Fable 5.1 Astra auf dem Artificial Analysis Intelligence Index und HLE with tools in OpenAIs veröffentlichter Vergleichstabelle übertrifft. Nutzen Sie Ihre eigenen Agent-/Task-Evals, statt anzunehmen, ein Modell dominiere jede Kategorie.
Ist GPT-6 Astra AGI?
OpenAIs offizielle Produktseiten beschreiben Astra als eine neue Generation von Intelligenz und als sein fähigstes breit eingesetztes Modell, definieren das Produkt selbst jedoch nicht als „AGI“. Benchmark-Sättigung bei einigen Aufgaben entspricht nicht einer festgelegten, universellen AGI-Definition.
Fazit
GPT-6 Astra lässt sich am besten als ausführungsfokussiertes Frontier-Modell verstehen. Sein stärkster Fortschrittsbeleg ist nicht die kleine Bewegung von 60.9 auf 61.2 gegenüber GPT-5.6 Sol auf dem Artificial Analysis Intelligence Index; es ist die viel größere Verbesserung bei Computer-Nutzung, agentischem Coding, wissenschaftlichen Workflows, Langkontext-Retrieval, professioneller Aufgabenfertigstellung und Cybersicherheit. Das 1.05M-Kontextfenster und der tiefe Tool-Stack geben Entwicklern mehr Spielraum, Agenten zu bauen, die über eine einzelne Antwort hinaus nützlich bleiben.
Der Trade-off ist der Preis. $10/$50 Standardpreise sind Premium, Langkontext-Anfragen kosten mehr, und unabhängige Tests zeigen, dass Astra bei General-Intelligence-Workloads deutlich teurer als Sol sein kann. Das Modell verdient dieses Premium, wenn bessere Abschlussraten und geringere menschliche Korrektur den Tokenpreis überwiegen. Für einfachere oder hochvolumige Workloads bleiben GPT-5.6, Claude Fable 5.1 und insbesondere Gemini 3.8 Flash relevante Alternativen statt obsolet gewordener Vorgänger.