

TL;DR : Quel fournisseur est le moins cher ?
Pour des requêtes interactives normales GPT-6 Astra, l’API GPT-6 Astra via CometAPI affiche le tarif Standard à contexte court le plus bas clairement publié dans cette comparaison, à 8 $ par million de tokens en entrée et 40 $ par million de tokens en sortie. OpenAI Standard est à 10 $/50 $.
Pour des travaux tolérant un délai, l’économie change : OpenAI fixe Batch et Flex à 50 % du Standard, ce qui revient à 5 $/M en entrée et 25 $/M en sortie pour des requêtes Astra à contexte court. OpenRouter expose également une route Batch à 5 $/25 $. Ces routes sont moins chères que l’inférence Standard interactive, mais ne sont pas des substituts directs pour les applications sensibles à la latence.
Pour tester avant de payer, CometAPI indique que les nouveaux comptes reçoivent des crédits d’inscription gratuits sans carte bancaire requise. Azure offre aux nouveaux clients éligibles 200 $ de crédit pendant 30 jours, tandis qu’AWS propose jusqu’à 200 $ de crédits dans son programme Free Tier. L’éligibilité aux crédits et l’accès au modèle doivent être vérifiés dans le compte avant de supposer que l’utilisation d’Astra est couverte.
Note d’éligibilité : les crédits promotionnels et l’accès à GPT-6 Astra varient selon le compte, la région et le programme. Vérifiez à la fois l’éligibilité aux crédits et l’accès au modèle avant d’estimer un essai gratuit.
Points clés
- Tarif interactif vérifié le plus bas ici : CometAPI Standard à 8 $/M en entrée et 40 $/M en sortie, 20 % en dessous d’OpenAI Standard.
- Route la moins chère tolérant un délai : OpenAI Batch/Flex ou OpenRouter Batch à 5 $/M en entrée et 25 $/M en sortie.
- OpenAI n’a aucun palier API gratuit pour Astra ; le tableau officiel de limites de débit marque Free comme non pris en charge.
- CometAPI est l’essai le plus simple dans cette comparaison car des crédits d’inscription sont offerts sans carte bancaire ; le montant actuel des crédits n’est volontairement pas codé en dur.
- La limite d’entrée à 272 K compte : au-delà, Astra passe à la tarification contexte long pour l’ensemble de la requête.
- Ne comparez pas uniquement les prix par token. La mise en cache, les outils, les réessais, la latence, la croissance du contexte et le taux de réussite des tâches acceptées peuvent dominer le coût total.
Qu’est-ce que GPT-6 Astra et pourquoi son API est-elle premium ?
GPT-6 Astra est le modèle phare d’OpenAI pour les travaux de bout en bout difficiles, plutôt que pour des conversations à bas coût et haut volume. OpenAI le positionne pour le raisonnement complexe, l’ingénierie logicielle, la recherche, l’usage de l’ordinateur, les workflows professionnels et les agents de longue durée.
La spécification officielle du modèle donne à Astra une fenêtre de contexte de 1 050 000 tokens, une sortie maximale de 128 000 tokens, une date de coupure des connaissances au 30 avril 2026, des entrées texte et image, et des sorties texte. Il prend en charge cinq réglages d’effort de raisonnement : faible, moyen, élevé, très élevé et maximum.
| Spécification GPT-6 Astra | Valeur |
|---|---|
| Développeur | OpenAI |
| ID du modèle | gpt-6-astra |
| Fenêtre de contexte | 1 050 000 tokens |
| Sortie maximale | 128 000 tokens |
| Date de coupure des connaissances | 30 avril 2026 |
| Entrée | Texte, images |
| Sortie | Texte |
| Effort de raisonnement | Faible, Moyen, Élevé, Très élevé, Maximum |
| Appels de fonctions | Pris en charge |
| Sorties structurées | Pris en charge |
| Utilisation de l’ordinateur | Pris en charge |
| Recherche Web/fichier | Pris en charge |
| Ajustement fin | Non pris en charge |
| Prix Standard contexte court | 10 $/M entrée ; 50 $/M sortie |
| Entrée mise en cache | 1 $/M |
| Écriture de cache | 12,50 $/M |
| Seuil de contexte long | Plus de 272 K tokens en entrée |
La limite de contexte est aussi une frontière tarifaire. Pour les prompts au-dessus de 272 K tokens en entrée, OpenAI applique 2× le prix d’entrée/cache et 1,5× le prix de sortie à la requête entière. Une requête qui dépasse légèrement 272 K peut donc augmenter sensiblement le coût total.
Astra introduit également des capacités orientées agent, telles que les appels d’outils asynchrones et le pilotage en cours de tour. C’est pourquoi une comparaison utile des fournisseurs doit considérer les outils, la mise en cache, le niveau de traitement et l’achèvement des tâches — pas seulement le prix d’entrée affiché.
Quelle est la qualité de GPT-6 Astra ? Performances officielles sur benchmarks
Le tableau de benchmarks officiel enregistre de solides résultats sur l’usage de l’ordinateur, l’automatisation professionnelle, le long contexte, la science, le code et la cybersécurité. Il annonce 97,6 % sur FrontierMath Tier 4 (v2), 99,9 % sur ARC-AGI-3 et 100 % sur ExploitBench. Ce sont des résultats d’évaluation publiés par le fournisseur et ils doivent être interprétés selon la méthodologie indiquée.
| Benchmark | GPT-6 Astra | Comparaison / signification |
|---|---|---|
| FrontierMath Tier 4 (v2) | 97,6 % | Mathématiques de niveau recherche |
| ARC-AGI-3 | 99,9 % | Raisonnement/Adaptation nouveaux |
| ExploitBench | 100,0 % | Capacité d’exploit en cybersécurité |
| OSWorld 2.0 | 72,6 % | Tâches d’usage de l’ordinateur |
| ScreenSpot-Pro | 92,7 % | Ancrage visuel de l’UI |
| AutomationBench | 41,4 % | Automatisation de workflows pro |
| BenchCAD | 95,9 % | Tâches de conception/CAD pro |
| BrowseComp | 91,5 % | Recherche d’infos via navigateur |
| MRCR v2, 512K–1M | 96,3 % | Récupération à très long contexte |
| Terminal-Bench Science 0.1 | 64,6 % | Workflows scientifiques d’agents |
Pour l’évaluation des coûts, les résultats OSWorld 2.0 d’OpenAI indiquent 72,6 % à environ 40 minutes par tâche pour Astra, contre 65,7 % à environ 75 minutes pour GPT-5.6 Sol. Cela plaide pour évaluer le coût par tâche complétée plutôt que de traiter le prix par token comme l’intégralité du modèle de coût.
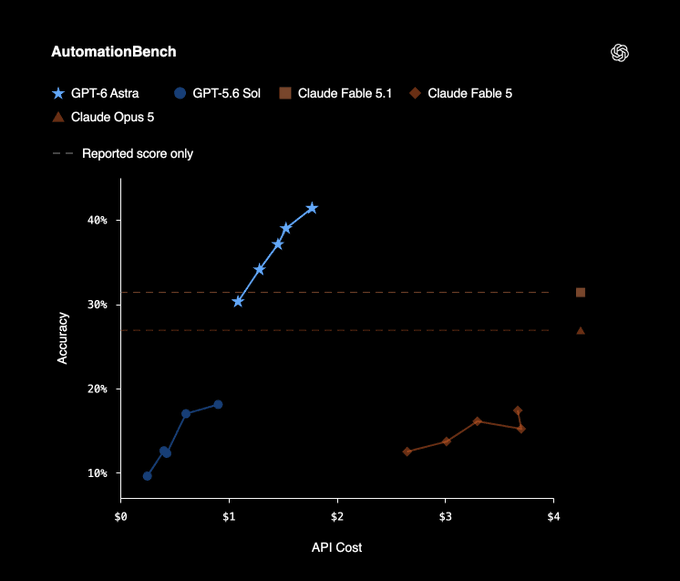
Graphique officiel AutomationBench d’OpenAI.
Quel fournisseur d’API GPT-6 Astra est le moins cher en 2026 ?
Le tableau ci-dessous compare les prix par token publiquement vérifiables pour le même modèle GPT-6 Astra. Il exclut des devis relais anormalement bas lorsque la provenance du modèle, les limites de contexte, la confidentialité ou le comportement du service ne peuvent pas être vérifiés de manière indépendante. La tarification en direct des modèles de CometAPI indique 8 $/M en entrée et 40 $/M en sortie pour l’accès Standard à contexte court.
| Fournisseur / route | Entrée / 1 M | Sortie / 1 M | Essai / crédit | Meilleur usage |
|---|---|---|---|---|
| CometAPI Standard | 8 $ | 40 $ | Crédits d’inscription | Tarif interactif vérifié le plus bas ici |
| OpenAI Standard | 10 $ | 50 $ | Pas de palier API gratuit pour Astra | Accès natif premier parti |
| OpenAI Batch / Flex | 5 $ | 25 $ | Même compte API | Tarif premier parti le plus bas tolérant un délai |
| OpenRouter Standard | 10 $ | 50 $ | Aucun essai spécifique Astra vérifié | Routage multi-fournisseurs |
| OpenRouter Batch | 5 $ | 25 $ | Aucun essai spécifique Astra vérifié | Routage asynchrone à bas coût |
| Azure Global | 10 $ | 50 $ | 200 $ / 30 jours pour nouveaux éligibles | Charges cloud Microsoft |
| Azure US Data Zone | 11 $ | 55 $ | Crédit Azure soumis à éligibilité | Exigences de zone de données |
| AWS Global CRIS | 10 $ | 50 $ | Jusqu’à 200 $ de crédits AWS | Charges AWS natives |
| AWS In-Region | 11 $ | 55 $ | Crédits AWS soumis à éligibilité | Déploiement régional |
Le tableau Astra publié par Azure confirme 10 $/50 $ pour Standard Global et 11 $/55 $ pour US Data Zone. Les détails de tarification Microsoft Foundry montrent également les bandes correspondantes de contexte long. AWS publie 10 $/50 $ pour Global CRIS et 11 $/55 $ pour In-Region/Geo CRIS. La tarification Amazon Bedrock précise qu’il s’agit de tarifs de niveau Standard.
Il y a donc deux réponses “les moins chères” différentes. Pour l’inférence Standard interactive, CometAPI est le leader des prix dans cet ensemble vérifié. Pour des charges asynchrones ou flexibles, Batch/Flex à 5 $/25 $ affiche un taux par token plus bas.
Note de tarification : les tarifs des fournisseurs et les crédits promotionnels peuvent changer. Reconsultez la documentation liée des fournisseurs juste avant la publication ou la budgétisation en production.
En quoi l’API GPT-6 Astra est-elle moins chère via CometAPI ?
| Catégorie de tokens | OpenAI Standard | CometAPI | Différence |
|---|---|---|---|
| Entrée | 10,00 $/M | 8,00 $/M | 20 % de moins |
| Entrée mise en cache | 1,00 $/M | 0,80 $/M | 20 % de moins |
| Écriture de cache | 12,50 $/M | 10,00 $/M | 20 % de moins |
| Sortie | 50,00 $/M | 40,00 $/M | 20 % de moins |
| Entrée contexte long | 20,00 $/M | 16,00 $/M | 20 % de moins |
| Sortie contexte long | 75,00 $/M | 60,00 $/M | 20 % de moins |
L’implication pratique est simple : si votre application a besoin d’une inférence interactive de type Standard plutôt que Batch/Flex, les tarifs publiés d’Astra chez CometAPI réduisent la composante token de 20 % dans les catégories correspondantes.
Quel fournisseur d’API GPT-6 Astra propose le meilleur essai gratuit ?
“API GPT-6 Astra gratuite” peut signifier soit un palier gratuit permanent du modèle, soit des crédits promotionnels temporaires. Ce ne sont pas la même chose. Le tableau officiel des limites de débit d’OpenAI marque le palier Free API comme non pris en charge.
CometAPI : le chemin d’essai le plus simple sans carte
Le guide de démarrage de CometAPI indique que les nouveaux comptes reçoivent des crédits d’inscription gratuits et que aucune carte bancaire n’est requise pour commencer. Étant donné que le montant promotionnel peut changer, l’écran d’inscription ou de tarification en direct doit être traité comme la source de vérité plutôt que de coder en dur un montant.
Azure : l’essai cloud à valeur fixe la plus claire
Les nouveaux clients Azure éligibles peuvent recevoir 200 $ de crédit Azure pendant 30 jours. Si GPT-6 Astra est activé pour le compte et la région, ce crédit peut rendre Azure utile pour des tests de preuve de concept avant la facturation normale.
AWS : une fenêtre de crédits généraux plus longue
AWS offre 100 $ de crédits à l’inscription et des opportunités de gagner 100 $ supplémentaires — jusqu’à 200 $ sur six mois. Comme le plan Free d’AWS n’expose pas tous les services et fonctionnalités, vérifiez l’éligibilité du plan de compte et l’accès au modèle Bedrock avant de considérer le crédit comme un essai Astra garanti.
Quand OpenAI Batch est-il moins cher pour GPT-6 Astra ?
La plus grande erreur de coût est de comparer uniquement les fournisseurs en ignorant le niveau de traitement. OpenAI indique que Batch et Flex coûtent 50 % du Standard, tandis que le mode Fast coûte 2× le tarif applicable. Pour des requêtes Astra à contexte court, la plage est donc 5 $/25 $ en Batch/Flex, 10 $/50 $ en Standard et 20 $/100 $ en Fast.
| Option de traitement | Entrée / 1 M | Sortie / 1 M | Relatif à OpenAI Standard |
|---|---|---|---|
| Batch | 5 $ | 25 $ | 50 % |
| Flex | 5 $ | 25 $ | 50 % |
| CometAPI Standard | 8 $ | 40 $ | 80 % d’OpenAI Standard |
| OpenAI Standard | 10 $ | 50 $ | 100 % |
| OpenAI Fast | 20 $ | 100 $ | 200 % |
Batch/Flex doit être évalué en premier pour l’analyse nocturne, la revue de code hors ligne, l’enrichissement de jeux de données, les campagnes d’évaluation et la recherche non urgente. Pour les applications où un utilisateur attend activement, la comparaison Standard reste la plus pertinente.
Combien GPT-6 Astra vous coûtera-t-il réellement ?
Considérez une requête d’agent à contexte court utilisant 100 000 tokens en entrée et 10 000 tokens en sortie. En ignorant la mise en cache et les frais d’outils, le coût simplifié est tokens d’entrée × tarif d’entrée + tokens de sortie × tarif de sortie.
| Fournisseur / route | Coût par requête | Coût pour 1 000 requêtes équivalentes |
|---|---|---|
| OpenAI Batch/Flex | 0,75 $ | 750 $ |
| CometAPI Standard | 1,20 $ | 1 200 $ |
| OpenAI Standard | 1,50 $ | 1 500 $ |
| OpenRouter Standard | 1,50 $ | 1 500 $ |
| Azure Global | 1,50 $ | 1 500 $ |
| AWS Global CRIS | 1,50 $ | 1 500 $ |
| AWS In-Region | 1,65 $ | 1 650 $ |
La différence de 0,30 $ entre CometAPI Standard et OpenAI Standard semble faible sur une requête. À 10 000 requêtes équivalentes, elle devient d’environ 3 000 $ avant les coûts d’outils ou les réessais.
Le long contexte change encore les calculs. À 300 K en entrée et 20 K en sortie, OpenAI Standard est d’environ 7,50 $ au tarif contexte long publié, tandis que les tarifs correspondants de CometAPI aboutissent à environ 6,00 $. C’est pourquoi le seuil de 272 K doit être explicitement surveillé dans la télémétrie de production.
Comment réduire les coûts de l’API GPT-6 Astra sans changer de fournisseur ?
La mise en cache des prompts est un levier majeur car le tarif d’entrée mise en cache d’Astra en Standard est un dixième de l’entrée fraîche. Les instructions système stables, les définitions d’outils, le matériel de référence réutilisable et les préfixes de prompt communs sont de bons candidats pour une conception sensible au cache.
Le contrôle du contexte est le deuxième levier. Une fenêtre de 1,05 M tokens est une capacité plafond, pas une cible. Rester en dessous de la frontière tarifaire de 272 K lorsque de l’historique supplémentaire est inutile peut avoir un effet plus important qu’une compression mineure du prompt.
Le niveau de traitement est le troisième levier : Batch/Flex pour le travail tolérant un délai, Standard pour la production interactive ordinaire, et Fast uniquement lorsque la baisse de latence a une valeur métier mesurable. Enfin, mesurez le coût par tâche acceptée — pas seulement le coût par token — car les réessais, les appels d’outils et la correction humaine peuvent inverser une simple comparaison de grille tarifaire.
Quel fournisseur d’API GPT-6 Astra devez-vous choisir ?
| Votre priorité | Meilleure option de départ | Pourquoi |
|---|---|---|
| Prix par token interactif le plus bas | CometAPI | 8 $/40 $ tarif Standard contexte court |
| Prix par token le plus bas tolérant un délai | OpenAI Batch/Flex ou OpenRouter Batch | 5 $/25 $ |
| Essai sans carte | CometAPI | Crédits d’inscription ; pas de carte requise |
| Plus grand essai cloud à valeur fixe | Azure | 200 $ pendant 30 jours pour nouveaux éligibles |
| Fenêtre de crédits cloud générale plus longue | AWS | Jusqu’à 200 $ ; vérifier l’éligibilité Astra/Bedrock |
| Accès natif premier parti OpenAI | OpenAI | API directe et nouvelles capacités natives |
| Architecture Microsoft existante | Azure Foundry | Gouvernance et achats Microsoft |
| Architecture AWS existante | Amazon Bedrock | Sécurité AWS, facturation et contrôles régionaux |
| Routage multi-fournisseurs | OpenRouter | Une couche de routage multi-fournisseurs |
Pour un développeur indépendant ou une équipe sensible aux coûts qui a besoin d’inférence interactive Astra, CometAPI est le meilleur point de départ axé sur le prix dans cette comparaison. Pour de gros travaux hors ligne, Batch/Flex doit être évalué avant de changer de fournisseur, car sa remise de 50 % sur le niveau de traitement est supérieure à la différence de 20 % sur le tarif Standard.
Pour les équipes d’entreprise, le tarif par token le plus bas ne produit pas forcément le coût total le plus bas. Azure ou AWS peuvent rester le meilleur choix économique lorsqu’une équipe dépend déjà de dépenses cloud engagées, de réseaux privés, d’achats centralisés ou de contrôles de sécurité et de conformité intégrés. Évaluez ces économies opérationnelles séparément du prix par token du modèle.
Comment appeler l’API GPT-6 Astra via CometAPI ?
CometAPI utilise un schéma d’intégration compatible OpenAI. Créez une clé API CometAPI, pointez le SDK OpenAI vers l’URL de base CometAPI et appelez le modèle gpt-6-astra. La documentation du modèle Astra de CometAPI publie à la fois les endpoints Chat Completions et Responses.
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

response = client.responses.create(
    model="gpt-6-astra",
    reasoning={"effort": "medium"},
    input="Analyze this software architecture and identify the three highest-risk bottlenecks.",
)

print(response.output_text)
Pour les nouveaux agents riches en outils, l’API Responses est l’interface la plus importante car les capacités agentiques d’Astra sont conçues autour de ce flux.
Un relais GPT-6 Astra ultra bon marché est-il vraiment moins cher ?
Les agrégateurs de prix font parfois apparaître des relais qui citent Astra bien en dessous des tarifs habituels. Ces offres ne doivent pas être automatiquement considérées comme équivalentes. Confirmez la provenance du modèle, la prise en charge complète du contexte, le comportement des outils, les conditions de confidentialité, la politique de journalisation, la disponibilité, les limites de débit et la manière dont le fournisseur soutient un prix inférieur à l’économie normale en amont.
Note de risque des relais : pour des agents de production, du code source, des documents d’entreprise, des données clients ou des charges sensibles à la sécurité, la provenance du modèle et la gestion des données font partie du prix effectif. Vérifiez la prise en charge du contexte, le comportement des outils, la confidentialité, la journalisation, la disponibilité et les limites de débit avant d’utiliser un relais à bas coût.
FAQ API GPT-6 Astra : Tarification, essais gratuits et fournisseurs
Quel est le fournisseur d’API GPT-6 Astra le moins cher ?
Pour l’inférence interactive Standard parmi les fournisseurs vérifiés ici, CometAPI est le moins cher à 8 $/M en entrée et 40 $/M en sortie. Pour les charges tolérant un délai, OpenAI Batch/Flex et OpenRouter Batch sont moins chers à 5 $/25 $.
Existe-t-il une API GPT-6 Astra gratuite ?
Il n’existe pas de palier OpenAI Free API permanent pour Astra. Des crédits promotionnels de CometAPI, Azure ou AWS peuvent réduire ou couvrir temporairement les coûts de test, sous réserve des règles d’éligibilité et d’accès au modèle de chaque programme.
CometAPI propose-t-il un essai gratuit GPT-6 Astra ?
CometAPI indique que les nouveaux comptes reçoivent des crédits d’inscription gratuits et qu’aucune carte bancaire n’est requise pour commencer. Comme les promotions évoluent, vérifiez le montant actuel des crédits à l’inscription.
Combien coûte GPT-6 Astra via OpenAI ?
La tarification Standard contexte court d’OpenAI est de 10 $/M en entrée, 1 $/M pour l’entrée mise en cache, 12,50 $/M pour l’écriture de cache et 50 $/M en sortie. Au-dessus de 272 K tokens en entrée, les tarifs Standard deviennent 20 $/M en entrée, 2 $/M pour l’entrée mise en cache, 25 $/M pour l’écriture de cache et 75 $/M en sortie pour la requête entière.
Pourquoi GPT-6 Astra en Batch peut-il être moins cher que CometAPI ?
Batch/Flex est un niveau de traitement différent, pas simplement un autre fournisseur. OpenAI le tarifie à la moitié du Standard, soit 5 $/M en entrée et 25 $/M en sortie pour des requêtes Astra à contexte court. Le tarif 8 $/40 $ de CometAPI est un tarif interactif de type Standard.
Azure est-il moins cher qu’OpenAI pour GPT-6 Astra ?
Azure Standard Global s’aligne sur OpenAI Standard à 10 $/M en entrée et 50 $/M en sortie. Azure peut toutefois rester attractif économiquement grâce aux crédits pour nouveaux comptes, aux accords d’entreprise, à la gouvernance Microsoft et aux dépenses engagées existantes.
AWS Bedrock est-il moins cher qu’OpenAI pour GPT-6 Astra ?
AWS Global CRIS est à 10 $/50 $, tandis que In-Region et Geo CRIS sont à 11 $/55 $ pour le contexte court. AWS peut néanmoins être préférable pour les équipes qui valorisent la facturation cloud existante, les contrôles régionaux et l’intégration d’infrastructure.
OpenRouter est-il moins cher pour GPT-6 Astra ?
OpenRouter Standard est à 10 $/50 $, il ne bat donc pas OpenAI sur le tarif Standard par token. Sa route Batch est à 5 $/25 $ ; son avantage plus large est le routage multi-fournisseurs.
Quel est le plus grand coût caché de l’API GPT-6 Astra ?
Le seuil d’entrée à 272 K est l’une des frontières de coût cachées les plus importantes. Les appels d’outils, la recherche Web/fichier, les réessais, les échecs de cache et des trajectoires d’agent inutilement longues peuvent également augmenter sensiblement le coût total par tâche.
Dois-je choisir un fournisseur uniquement par le prix par token ?
Non. Comparez le coût par tâche réussie, la latence, la disponibilité, la prise en charge du contexte, la compatibilité des outils, le comportement de cache, la politique de données, les limites de compte et les limites de débit. Le token le moins cher n’est utile que si la route fournit de manière fiable la charge de travail dont vous avez besoin.