Construire avec CometAPIBesoin d'une seule API pour plusieurs modèles ?Testez le workflow dans Playground, puis créez une clé API lorsque le modèle et le coût correspondent à votre cas d'usage.
Gemini 4 Carbon contre Gemini 4 Argon : tests de performance, tarifs et lequel choisir
I don’t have verified public details on models named “Gemini 4 Carbon” and “Gemini 4 Argon.” They may be new or internal variants released after my knowledge cutoff. Without official specs, any direct comparison would be speculative. If you can share a link or spec sheet, I can produce a precise side-by-side. In the meantime, here’s a checklist to evaluate them across your requested dimensions:
- Benchmarks:
- General: MMLU, BIG-bench, GPQA, TruthfulQA, HellaSwag
- Reasoning/Math: GSM8K, MATH, ARC-Challenge
- Coding: HumanEval, MBPP, MultiPL-E, EvalPlus
- Multimodal (if applicable): MathVista, ChartQA, DocVQA, MMMU
- Long-context: Needle-in-a-Haystack, RULER-like tests
- What to compare: overall scores, pass@1 vs pass@k, variance across domains, evaluation methodology transparency
- Coding:
- Supported languages and frameworks; pass@1 on HumanEval/MBPP; function calling and tool-use robustness
- Repository-level code generation/refactoring; test generation; doc comprehension
- Safety: secret leakage prevention, license-aware generation, hallucination rate, deterministic modes
- Tooling: inline edits, diff mode, code execution/sandboxes, debugger integrations
- Cybersecurity:
- Alignment: jailbreak resistance, prompt injection resilience, content safeguards
- Secure coding: vulnerability avoidance (OWASP Top 10/LLM Top 10), dependency hygiene
- Model supply-chain: evals against red-teaming suites, reproducible inference, audit logs
- Data handling: PII redaction, regional residency, enterprise compliance certifications
- Context windows:
- Max input tokens and output tokens; effective context retention curves (not just max limit)
- Retrieval augmentation quality; memory/state features; tool-call chaining depth
- Structured inputs (JSON mode), citations/attribution, long-document QA performance
- API pricing:
- Input/output price per million tokens; tiered discounts; burst vs sustained pricing
- Batch/bulk inference rates; streaming vs non-streaming costs; caching credits
- Tool/function-calling billing, image/audio modalities pricing, context caching charges
- Speed:
- Latency percentiles (P50/P90/P99) for short and long prompts; tokens/sec generation
- Throughput under concurrency; cold start vs warm; streaming first-token latency
- Regional performance differences; model sizes/modes (e.g., standard vs “flash”)
- Availability:
- Regions and endpoints (public API vs Vertex AI/AI Studio); on-prem or VPC options
- Quotas and rate limits; SLA tiers; failover versions; versioning and deprecation timelines
- Feature availability parity (function calling, batch, eval tools) across regions
How to proceed:
- Share the official spec or announcement for Carbon and Argon, and I’ll produce a concise, point-by-point comparison table across these metrics.
- Alternatively, check the model catalog and pricing pages for their entries, then provide the listed specs (context size, pricing, latency, benchmark scores), and I’ll align them into a clear recommendation based on your priorities (quality vs cost vs speed).
Deon GoodwinÉquipe de recherche sur les modèles IA et API
Google a annoncé Gemini 4 Carbon le 28 octobre 2026, avec des résultats publiés supérieurs à ceux de Gemini 4 Argon en codage, raisonnement sur longs contextes et cybersécurité. Pour les développeurs, le choix immédiat dépend de l’accès : Argon est disponible via l’API Gemini payante, tandis que Carbon reste en déploiement restreint. Cette comparaison passe en revue leurs benchmarks, spécifications d’API, vitesse et tarification pour vous aider à décider quoi déployer maintenant et quand évaluer Carbon.
Points clés
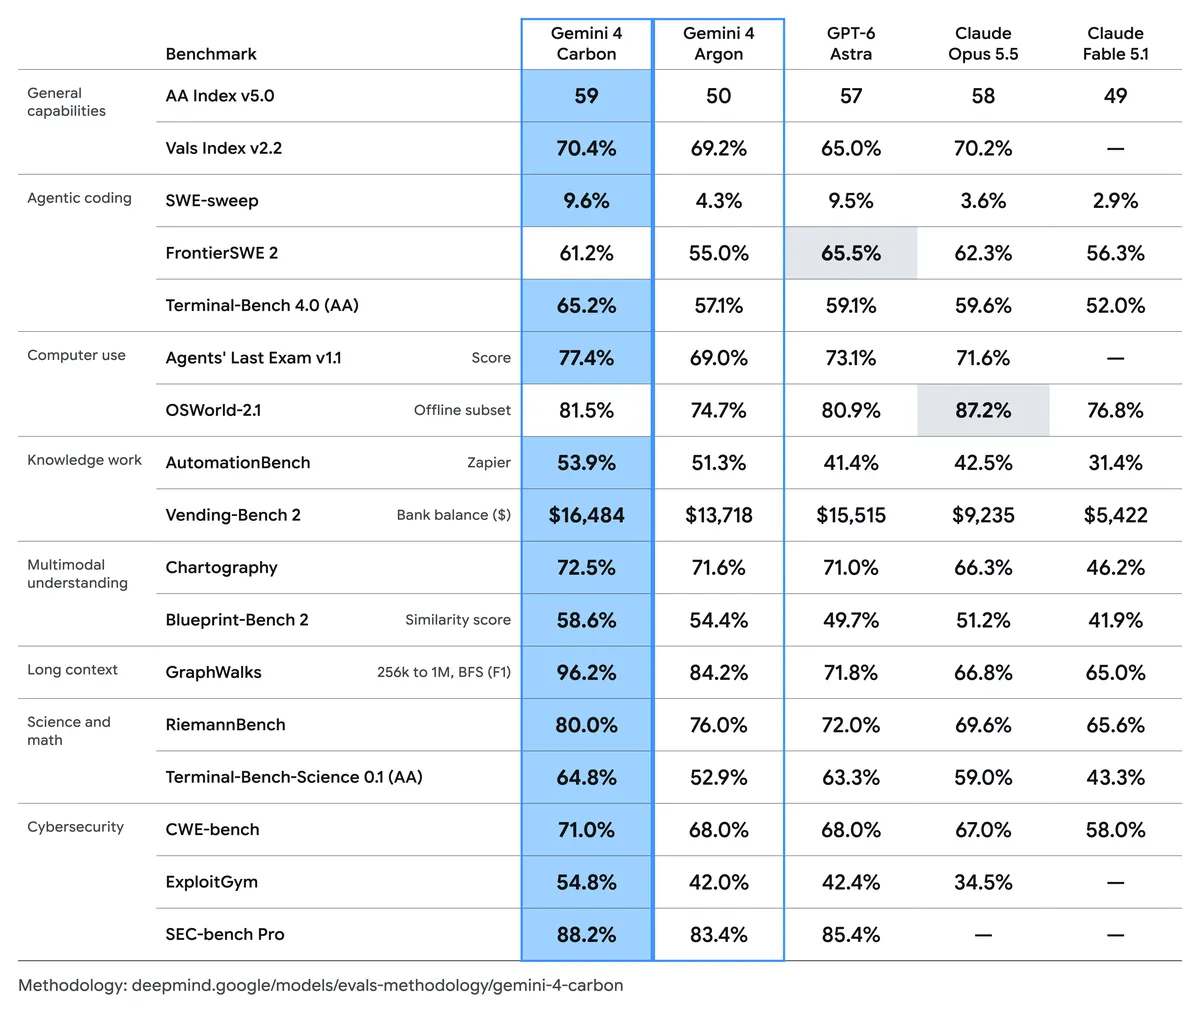
Performance : Carbon obtient 59 contre 50 pour Argon sur l’Artificial Analysis Intelligence Index v5.0. Les gains varient selon le benchmark : SWE-sweep s’améliore de 5,3 points de pourcentage, tandis que GraphWalks BFS F1 s’améliore de 12,0 points.
Spécifications de l’API : Argon documente une fenêtre unifiée de 1,048,576 jetons partagée entre l’entrée, la réflexion et la sortie. Les limites et la prise en charge des outils de l’API publique de Carbon n’ont pas été annoncées.
Revu pour la clarté, l'attribution des sources et la terminologie API actuelle.
Utilisez ce résumé pour une réponse rapide, puis lisez le guide pour le contexte, les exemples et les détails d'implémentation.
Tarification : Les deux modèles ont annoncé des tarifs de lancement de $2 par million de jetons d’entrée et de $10 par million de jetons de sortie. L’offre d’Argon court jusqu’au 30 novembre 2026 ; la date de fin de l’offre de lancement de Carbon n’a pas été annoncée.
Décision de mise à niveau : Comparez le taux d’acceptation des tâches, la latence de bout en bout et le coût par résultat accepté lors de l’évaluation de Carbon. Des scores de benchmark plus élevés ne suffisent pas à montrer qu’un basculement améliorera votre application.
Gemini 4 Carbon vs Gemini 4 Argon : aperçu et spécifications
Commencez par la décision de déploiement : Argon dispose d’une API documentée que vous pouvez utiliser dès maintenant, tandis que Carbon offre des résultats publiés plus solides avec un accès initial restreint.
Gemini 4 Carbon est axé sur des workflows d’ingénierie exigeants et de cybersécurité défensive, avec un accès initial limité à des partenaires sélectionnés. Gemini 4 Argon est disponible via l’API Gemini payante pour le raisonnement, le codage, la résolution de problèmes scientifiques et les workflows d’agent. Le tableau ci-dessous compare leurs spécifications d’API et capacités annoncées.
Contexte, raisonnement et spécifications de l’API
Argon dispose d’une spécification développeur publiée. Carbon a publié des résultats d’évaluation, mais ces résultats n’établissent pas les limites exactes ni la prise en charge des outils d’une future API publique. Ni l’appartenance à la même famille ni des scores plus élevés n’établissent que les modèles utilisent une architecture identique.
Spécification de l’API
Gemini 4 Carbon
Gemini 4 Argon
Positionnement du modèle
Raisonnement de pointe, cybersécurité, agents à long horizon
Raisonnement de pointe, codage, science, agents
Identifiant du modèle pour l’API publique
Non annoncé
gemini-4-argon
Fenêtre de contexte
1M jetons signalés par Artificial Analysis ; limite officielle de l’API non documentée
1,048,576 jetons partagés entre l’entrée, la réflexion et la sortie
Sortie maximale
Non documenté officiellement
Limite synchronisée par défaut de 65,536 ; décodage long jusqu’au reste de la fenêtre unifiée
Modalités d’entrée
Capacité multimodale démontrée ; spécification complète de l’API en attente
Texte, image, audio, vidéo, PDF
Modalités de sortie
Spécification de l’API publique en attente
Texte
Niveaux de raisonnement
Non documentés officiellement
Faible, moyen, élevé
Appel de fonctions et exécution de code
Prise en charge dans l’API publique non confirmée
Pris en charge
Utilisation de l’ordinateur
Prise en charge dans l’API publique non confirmée
Aperçu
Mise en cache du contexte
Remise tarifaire annoncée ; détails d’implémentation en attente
Mise en cache implicite
La fenêtre de 1,048,576 jetons d’Argon est partagée entre l’entrée, la réflexion et la sortie générée, de sorte qu’une entrée plus grande laisse moins d’espace pour la génération. Son budget de génération par défaut est de 65,536 jetons, incluant la réflexion et la sortie. Les générations plus longues utilisent le décodage long, qui retraitent le contexte antérieur à chaque étape de continuation et ajoute des frais sur les jetons d’entrée ; un contexte répété peut bénéficier de remises de mise en cache implicite.
Avec l’Interactions API, les générations plus longues nécessitent le mode en arrière-plan et un réglage max_output_tokens plus élevé. Avec GenerateContent, le client doit gérer les requêtes de continuation.
Gemini 4 Carbon vs Gemini 4 Argon : performances
Carbon devance Argon sur la comparaison rapportée, mais l’ampleur et la signification des gains varient selon la tâche.
Résultats officiels des benchmarks et conditions de test
La comparaison publiée par Google montre Carbon devant sur les 17 lignes ci-dessous. Elle combine des évaluations réalisées par Google avec des scores d’évaluateurs externes et de classements de benchmarks ; ce n’est pas l’affirmation que Google a exécuté chaque test de façon indépendante.
La méthodologie d’évaluation utilise généralement le réglage de réflexion le plus élevé et pass@1, sauf indication contraire d’un benchmark. Les échafaudages d’agent, les sous-ensembles de tâches et les définitions de score varient, de sorte que les pourcentages entre différents benchmarks ne sont pas interchangeables.
Benchmark et métrique
Gemini 4 Carbon
Gemini 4 Argon
Avantage de Carbon
Artificial Analysis Intelligence Index v5.0
59
50
+9 points
Vals Index v2.2
70.4%
69.2%
+1.2 pp
SWE-sweep
9.6%
4.3%
+5.3 pp
FrontierSWE 2
61.2%
55.0%
+6.2 pp
Terminal-Bench 4.0 (AA)
65.2%
57.1%
+8.1 pp
Agents' Last Exam v1.1
77.4%
69.0%
+8.4 pp
OSWorld-2.1 (offline subset)
81.5%
74.7%
+6.8 pp
AutomationBench (Zapier)
53.9%
51.3%
+2.6 pp
Vending-Bench 2 (bank balance)
$16,484
$13,718
+$2,766
Chartography
72.5%
71.6%
+0.9 pp
Blueprint-Bench 2
58.6%
54.4%
pp = points de pourcentage. Vending-Bench 2 rapporte un solde bancaire simulé plutôt qu’un taux de précision.
GraphWalks : le sous-ensemble 256K–1M contient 200 problèmes et rapporte le BFS F1, plutôt qu’un taux de précision générique.
Agents' Last Exam : Google utilise un ensemble v1.1 de 122 tâches, le harnais ALE-Claw, une fenêtre de cinq heures et des filtres de sécurité activés.
OSWorld : la valeur rapportée utilise le sous-ensemble hors ligne de 82 tâches, des captures 1080p, une limite de 500 étapes et le maximum sur trois exécutions en tentative unique. Cela ne représente pas le benchmark en ligne complet.
Performances en codage et travail sur les dépôts
Sur Terminal-Bench 4.0, Carbon obtient 65.2%, contre 57.1% pour Argon, soit un avantage de 8,1 points de pourcentage. Le benchmark teste le travail en ligne de commande et la résolution de problèmes techniques multi-étapes.
Sur SWE-sweep, Carbon obtient 9.6% contre 4.3% pour Argon, soit un avantage de 5,3 points de pourcentage et plus du double du score.
Cet écart relatif est frappant, mais le résultat absolu reste inférieur à 10%. Carbon est plus performant, sans être universellement fiable sur chaque tâche difficile d’ingénierie logicielle.
Les candidats pratiques à l’évaluation sont le débogage à l’échelle du dépôt, les migrations de code et les tâches impliquant un usage répété d’outils et de vérifications. Pour une base de code de production, faire passer vos propres tests reste plus utile que d’extrapoler un taux de réussite à partir d’un benchmark différent.
Performances multimodales et sur longs contextes
Sur l’évaluation GraphWalks 256K–1M BFS F1, Carbon obtient 96.2% contre 84.2% pour Argon, soit 12 points de pourcentage d’avance. Cela fait de la synthèse de longs documents et de l’analyse de dépôts des candidats utiles à l’évaluation. La qualité de la récupération, la structure des documents et les limites réelles de chaque endpoint influent toujours sur le résultat.
Sur Chartography, Carbon obtient 72.5% contre 71.6% pour Argon, soit 0,9 point de pourcentage d’avance. Sur Blueprint-Bench 2, Carbon obtient 58.6% contre 54.4% pour Argon, soit 4,2 points de pourcentage d’avance. Ces résultats de compréhension visuelle encouragent à tester les workflows de documents et de graphiques, tandis que les formats d’entrée pris en charge par la future API publique de Carbon restent à confirmer.
Cybersécurité et fiabilité des agents
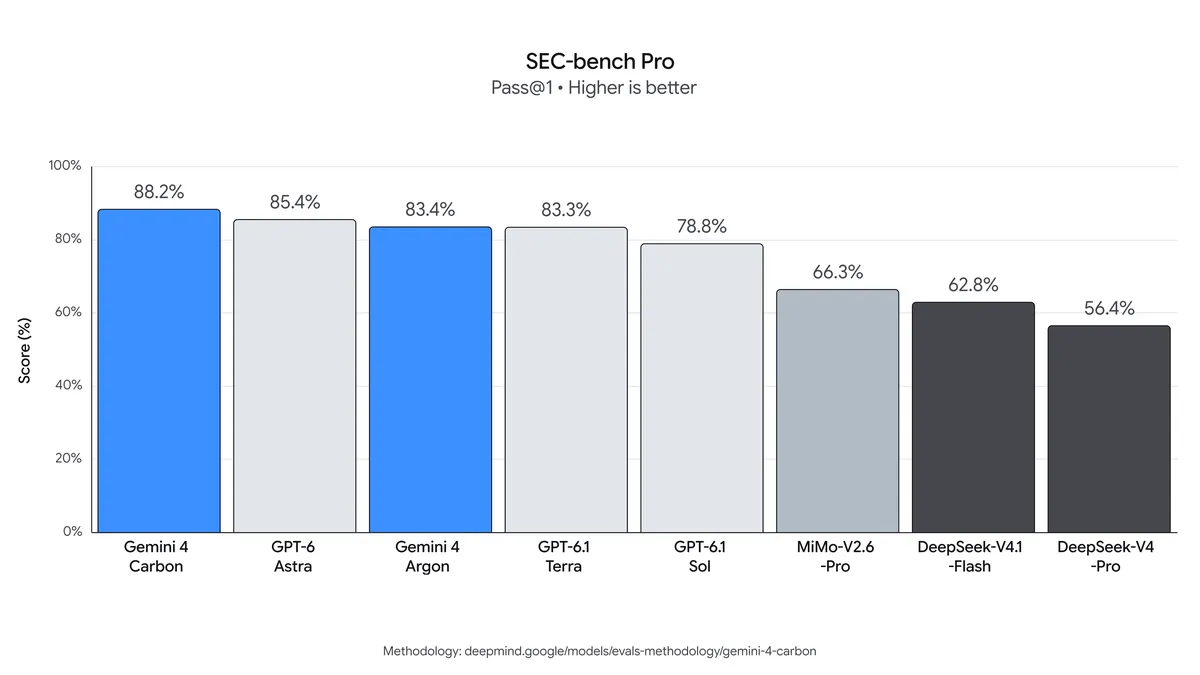
Les résultats de sécurité couvrent la découverte, la validation d’exploits et la remédiation : Carbon obtient 88.2% sur SEC-bench Pro, 54.8% sur ExploitGym et 71.0% sur CWE-bench. Son plus grand avantage sur Argon est sur ExploitGym, à 12,8 points de pourcentage.
Les conditions d’évaluation de sécurité sont importantes : SEC-bench Pro utilise le split JavaScript-engine de 183 tâches (mai 2026), tandis qu’ExploitGym utilise une configuration d’agent hors ligne, à tentative unique, avec les atténuations désactivées. Google rapporte les évaluations de sécurité externes sans garde-fous de déploiement ; ces scores n’établissent pas le comportement sans restriction de l’API.
Pour des agents de longue durée, un modèle utile doit également signaler honnêtement ses échecs et rester dans la tâche autorisée. Google rapporte un taux observé de triche réussie de 0,0% sur Terminal-Bench 4.0, tandis que les tentatives de triche sont restées à 0,4%. Ses évaluations internes ont aussi constaté moins d’affirmations non étayées et des taux plus faibles de dépassement et de sous-service qu’Argon. Ce sont des observations spécifiques à l’évaluation, plutôt que des garanties pour chaque application.
En pratique, conservez les contrôles d’autorisation, l’exécution isolée, la revue de correctifs et la validation indépendante lors de l’évaluation de l’un ou l’autre modèle sur des travaux de sécurité défensive.
Vitesse et latence
Indicateur de performance
Gemini 4 Carbon
Gemini 4 Argon
Débit de sortie
Environ 102 jetons/s
Environ 82 jetons/s
Délai avant le premier jeton
Environ 100 s
Environ 47 s
Jetons de sortie par tâche évaluée
Environ 123K
Environ 116K
Jetons de raisonnement par tâche évaluée
Environ 72K
Environ 68K
Ces mesures tierces décrivent la configuration de test de l’évaluateur et ne constituent pas une garantie de latence ou de débit pour votre déploiement d’API. La comparaison peut évoluer à mesure que l’évaluateur met à jour ses résultats et que Google étend l’accès à Carbon.
Le taux de génération de jetons plus élevé de Carbon et son délai plus long avant le premier jeton décrivent des parties différentes d’une requête. Pour une interface de chat, l’attente avant le début de la sortie peut dominer l’expérience ; pour un travail autonome, évaluez le temps d’achèvement de bout en bout avec le taux de réussite. Le débit seul ne détermine pas quel modèle termine une tâche utile plus rapidement.
Gemini 4 Carbon vs Gemini 4 Argon : coût
Comparez séparément les tarifs officiels par jeton et la facturation du fournisseur, puis calculez le coût d’un résultat accepté. Des prix publiés identiques peuvent tout de même produire des factures différentes lorsque la réflexion, les échecs et l’utilisation d’outils varient.
Tarification de l’API par fournisseur
Les deux modèles ont les mêmes tarifs par jeton de lancement annoncés par Google. CometAPI répertorie des tarifs distincts pour Argon ; il n’y a pas de prix confirmé pour Carbon dans cette comparaison. Tous les prix des fournisseurs ci-dessous reflètent l’instantané du 29 octobre 2026 de l’article.
Fournisseur
Catégorie de tarification
Gemini 4 Carbon
Gemini 4 Argon
Google
Entrée de lancement / 1M de jetons
$2.00
$2.00
Google
Sortie de lancement, réflexion incluse / 1M de jetons
$10.00
$10.00
Google
Entrée mise en cache de lancement / 1M de jetons
$0.10
$0.10
Google
Entrée ultérieure / 1M de jetons
$4.00
$4.00
Google
Sortie ultérieure, réflexion incluse / 1M de jetons
$20.00
$20.00
Google
Entrée mise en cache ultérieure / 1M de jetons
$0.20
$0.20
Google
Période de lancement
Date de fin non annoncée
Jusqu’au 30 novembre 2026
Google
Accès en production public
Déploiement restreint
Disponible
CometAPI
Entrée standard / 1M de jetons
Non confirmé
$1.60
CometAPI
Sortie standard / 1M de jetons
Non confirmé
$8.00
La période de lancement Google d’Argon se termine le 30 novembre 2026, avec des tarifs ultérieurs à partir du 1er décembre. Carbon n’a pas de date de fin annoncée pour son lancement. Ses chiffres d’entrée mise en cache sont calculés à partir de la remise annoncée de 95% ; les détails d’implémentation et d’éligibilité restent en attente.
Avant d’estimer une facture, confirmez les tarifs, les règles de mise en cache, les frais de long contexte et la prise en charge des outils pour le fournisseur et le compte choisis. Les tarifs annoncés par Google pour Carbon n’établissent pas un prix Carbon chez CometAPI.
Exemple de coût : 1,000 requêtes
Pour une requête avec 100,000 jetons d’entrée et 25,000 jetons de sortie facturables au total, y compris les jetons de réflexion, la tarification standard de lancement donne :
Total : $0.45 par requête, soit $450 pour 1,000 requêtes identiques.
Aux tarifs ultérieurs, la même tâche coûte $0.90. Si 25,000 ne décrit que la réponse visible finale, ajoutez tout jeton de réflexion compté séparément avant d’estimer la facture. L’exemple exclut l’ancrage, les outils externes et d’autres frais de service.
Aux tarifs Argon affichés par CometAPI, la même requête avec 100,000 en entrée et 25,000 en sortie facturable coûte $0.16 + $0.20 = $0.36, soit $360 pour 1,000 requêtes identiques. Cette estimation exclut les effets du cache, les reprises et les frais de service séparés ; elle n’estime pas un déploiement Carbon via CometAPI.
Coût par tâche acceptée = dépenses totales de modèle et d’outils ÷ tâches acceptées. Définissez des critères d’acceptation avant les tests, incluez les échecs et reprises dans les dépenses, et consignez séparément le temps de revue humaine.
Où pouvez-vous accéder à Gemini 4 Carbon et Gemini 4 Argon ?
Accès via le fournisseur officiel
Au 29 octobre 2026, Argon est disponible via l’API Gemini et Google AI Studio. Carbon est initialement limité à des défenseurs en cybersécurité et partenaires de confiance sélectionnés ; un endpoint développeur généralement disponible et une date de sortie plus large n’ont pas été confirmés. Commencez par la voie activée pour votre compte et vérifiez son identifiant de modèle et ses fonctionnalités prises en charge.
Accès via CometAPI
API Gemini 4 Argon sur CometAPI propose une voie d’intégration supplémentaire pour les développeurs utilisant une interface de chat compatible.
Pour commencer, créez une clé API CometAPI, sélectionnez le modèle gemini-4-argon et configurez votre application pour utiliser l’endpoint de chat documenté par le fournisseur. Commencez par une requête texte représentative, examinez la réponse et vérifiez l’usage et les frais avant d’étendre la charge.
CometAPI applique ses propres tarifs. Confirmez la prise en charge des outils, les contrôles de réflexion et les longues réponses sur la voie que vous prévoyez d’utiliser. Une interface de chat compatible n’établit pas la prise en charge de chaque fonctionnalité native de Gemini.
La disponibilité de Carbon sur CometAPI et son identifiant de modèle de production ne sont pas confirmés au 29 octobre 2026. Maintenez Argon opérationnel et ne basculez qu’après que le fournisseur a documenté l’accès à Carbon et que votre intégration a passé les vérifications pertinentes.
Devriez-vous choisir Gemini 4 Carbon ou Argon ?
Charge de travail
Point de départ pratique
Ce qu’il faut valider
Une application à livrer maintenant
Argon
Taux d’acceptation des tâches, comportement de l’endpoint et coût d’exploitation
Débogage complexe ou migrations de code
Évaluer Carbon lorsque l’accès est disponible
Tests sur dépôt, qualité de la revue et reprises
Recherche de vulnérabilités autorisée
Évaluer Carbon dans le cadre du programme d’accès autorisé
Contrôles de sécurité, validité des constats et justesse des correctifs
Analyse de grands documents ou d’une base de code
Argon comme référence ; Carbon en candidat
Exactitude des éléments et omissions sur des sources identiques
Une interface utilisateur interactive
Évaluer d’abord l’endpoint Argon disponible
Délai du premier jeton et temps total sous trafic réel
Choisir un point de départ et un candidat à la mise à niveau
Choisissez Argon lorsque vous devez déployer maintenant. Son API accessible et son contexte, ses modalités et ses outils documentés vous permettent de tester l’application complète, y compris la latence et le coût.
Évaluez Carbon lorsque l’accès est disponible et que le travail le justifie. Priorisez les changements difficiles sur les dépôts, la synthèse sur long contexte ou les tâches de sécurité défensive autorisées. Mettez à niveau lorsqu’il fournit plus de correctifs ou de constats acceptés, moins de reprises ou moins d’effort de revue dans vos limites de latence et de budget.
Une base Argon et une trajectoire de mise à niveau vers Carbon
Maintenez le workflow Argon opérationnel tout en construisant un ensemble fixe de tâches représentatives. Quand Carbon devient accessible via une voie prise en charge, exécutez les mêmes tâches avec des autorisations d’outils comparables et les mêmes critères d’acceptation. Ne construisez pas de basculement automatique vers un endpoint restreint ou non documenté ; prenez des décisions de routage seulement après avoir établi la compatibilité et les résultats sur la charge de travail.
Évaluation en production
Gardez l’ensemble d’évaluation fixe lors de la comparaison des modèles. Enregistrez la version du modèle, le réglage de réflexion, le prompt, les autorisations d’outils, l’utilisation de jetons, le délai du premier jeton, la durée totale et si le résultat a passé la revue. Un score de benchmark plus élevé est une preuve utile pour choisir quoi tester ; la décision de mise en production doit suivre les résultats sur votre charge de travail.
Incluez des requêtes routinières et des cas difficiles dont l’échec serait coûteux.
Répétez les tâches et alternez l’ordre des modèles pour réduire l’influence de résultats ponctuels.
Mesurez la latence médiane et en queue, l’usage de jetons, les reprises et les résultats acceptés sur l’ensemble du workflow.
Définissez des limites de reprise et des conditions d’escalade basées sur des résultats de validation observables.
Conclusion
La bonne mise à niveau est celle qui améliore votre travail accompli. Choisissez un petit ensemble de tâches représentatives, définissez ce qui constitue un résultat acceptable et mesurez ensemble le coût du modèle et de la revue. Lorsque Carbon devient disponible pour votre compte, ces mêmes tâches montreront si ses gains de benchmark se traduisent par suffisamment de valeur pour justifier un basculement.
FAQ
Un prompt Argon peut-il être réutilisé tel quel avec Carbon ?
Il peut servir de point de départ pour l’évaluation, mais ce n’est pas une preuve d’un comportement d’API compatible. Gardez la tâche et les critères d’acceptation constants, puis vérifiez l’identifiant de modèle de Carbon, le schéma de requête, le format des outils et les limites documentés lorsque l’accès est disponible. La réutilisation de prompt et la compatibilité d’intégration sont deux questions distinctes.
Faut-il aligner les réglages de raisonnement lors de la comparaison des modèles ?
Alignez-les lorsque les endpoints exposent des contrôles comparables, et consignez toute différence. Les résultats de benchmark au plus haut réglage de réflexion de Google décrivent une configuration d’évaluation particulière ; ils ne prédisent pas la qualité ou la latence d’un déploiement Argon fonctionnant à son réglage moyen par défaut. Les contrôles de réflexion d’Argon proposent des niveaux faible, moyen et élevé ; comparez le réglage le plus bas qui satisfait le seuil d’acceptation de votre application ainsi qu’une configuration de qualité maximale.
Un avantage sur un benchmark établit-il une garantie de service en production ?
Non. Les performances sur benchmarks n’établissent pas l’engagement de disponibilité d’un endpoint, sa disponibilité régionale, ses conditions de gestion des données ou ses modalités de support. Examinez ces conditions séparément avec le fournisseur choisi, et testez les tailles de requêtes et les profils de trafic attendus avant de vous reposer sur l’un ou l’autre modèle pour un workflow critique.