Construire avec CometAPIBesoin d'une seule API pour plusieurs modèles ?Testez le workflow dans Playground, puis créez une clé API lorsque le modèle et le coût correspondent à votre cas d'usage.
GPT-6.1 Terra vs GPT-6.1 Sol : tests de performance, tarifs et lequel choisir
Comparez GPT-6.1 Terra et GPT-6.1 Sol sur les benchmarks officiels, le raisonnement, la tarification de l’API et les charges de travail concrètes, avec un exemple en Python utilisant CometAPI.
lesileÉquipe de recherche sur les modèles IA et API
Commencez avec GPT-6.1 Terra pour les tâches à fort volume, vérifiables et sensibles au coût. Évaluez GPT-6.1 Sol pour le codage complexe, l’utilisation d’outils en plusieurs étapes et les workflows où les échecs sont coûteux. Un choix pratique consiste à utiliser d’abord Terra puis à passer à Sol lorsque des tests prédéfinis ou des contrôles de validation échouent.
Key Takeaways
Tarification standard par jeton: Sur OpenAI Standard, Terra coûte $1 par million de jetons en entrée et $5 par million de jetons en sortie ; Sol coûte $2 et $10, respectivement.
Performances selon la tâche: À effort de raisonnement maximal, Terra devance légèrement sur Agents’ Last Exam v1 et Terminal-Bench-Science 0.1, tandis que Sol mène sur Terminal-Bench 4.0 et OSWorld 2.1.
Capacité de contexte partagée: Les deux modèles offrent une fenêtre de contexte de 1.05 million de jetons et acceptent des entrées texte et image.
Contrôles de raisonnement différents: Terra prend en charge la désactivation du raisonnement avec ; Sol exige au moins un effort de raisonnement .
Revu pour la clarté, l'attribution des sources et la terminologie API actuelle.
none
low
Le coût opérationnel compte: Comparez la dépense par tâche menée à bien, en incluant les reprises et appels d’outils, et suivez séparément les coûts de relecture humaine.
GPT-6.1 Terra vs GPT-6.1 Sol: Overview and Specifications
L’aperçu ci-dessous résume les compromis. Les sections détaillées expliquent les preuves, hypothèses de facturation et limites derrière chaque choix.
Decision factor
GPT-6.1 Terra
GPT-6.1 Sol
Starting workload
Travaux visuels courants et agents répétables
Codage complexe et raisonnement professionnel soutenu
Context and modalities
Même capacité de contexte totale ; saisie texte et image
Même capacité de contexte totale ; saisie texte et image
Reasoning control
Inclut une option de désactivation du raisonnement
Exige au minimum un effort de raisonnement low
Published performance pattern
Bon rapport coût/performance sur des tâches d’agent répétables
Plus performant sur plusieurs tests de codage difficile et d’automatisation de bureau
API access
OpenAI et CometAPI
OpenAI et CometAPI
GPT-6.1 Terra: Efficient Visual and Agent Workflows
OpenAI a présenté GPT-6.1 Terra le 26 octobre 2026. Il combine raisonnement visuel, utilisation de l’ordinateur et génération de texte polyvalente pour des workflows professionnels routiniers. Ses tarifs par jeton plus bas en font un point de départ utile lorsque les tâches sont fréquentes et que les résultats peuvent être vérifiés.
GPT-6.1 Sol: Complex Coding and Professional Reasoning
GPT-6.1 Sol a été lancé le 29 septembre 2026. Il vise le codage exigeant et le travail professionnel. Évaluez-le lorsqu’un dépôt inconnu, une longue chaîne d’actions dépendantes ou des corrections coûteuses rendent précieux un effort de raisonnement supplémentaire.
Context, Reasoning, and API Specifications
Specification
GPT-6.1 Terra
GPT-6.1 Sol
Official release date
October 26, 2026
September 29, 2026
API model ID
gpt-6.1-terra
gpt-6.1-sol
Context window
1,050,000 tokens
1,050,000 tokens
Knowledge cutoff
June 1, 2026
April 30, 2026
Input / output
Text and images / text
Text and images / text
Reasoning effort
none, low, medium, high, xhigh, max
low, medium, high, xhigh, max
Default reasoning effort
medium
medium
API features: Les deux modèles prennent en charge Structured Outputs, le streaming et la Batch API. L’appel d’outils utilise la Responses API, et le fine-tuning n’est pas pris en charge. Vérifiez que votre fournisseur et point de terminaison choisis offrent les fonctionnalités dont votre application a besoin.
Les deux modèles autorisent jusqu’à 128,000 jetons de sortie dans une fenêtre de contexte de 1,050,000 jetons. Réserver l’allocation de sortie complète laisse 922,000 jetons pour le reste de l’échange, y compris votre entrée, les instructions système et l’historique des outils. Il s’agit d’un calcul de planification, pas d’une limite d’entrée distincte et fixe.
Architecture disclosure: Les spécifications publiques liées ne fournissent pas suffisamment de détails internes sur l’architecture pour une comparaison fiable. La capacité de contexte et les paramètres de raisonnement ne doivent pas être considérés comme des preuves du nombre de paramètres ou de l’architecture.
Reasoning controls: Le paramètre none de Terra est utile pour des transformations et extractions simples. Pour une première comparaison, utilisez le même niveau de raisonnement pris en charge sur les deux modèles, puis ajustez chaque modèle en fonction de la qualité et de la latence requises par votre charge de travail.
Les deux modèles ont la même capacité de contexte publiée, mais cela n’implique pas une précision de récupération ou une qualité de raisonnement en long contexte identiques. La sélection du modèle doit donc considérer la qualité du raisonnement, l’efficacité du workflow, le coût et les performances de récupération spécifiques à la tâche.
GPT-6.1 Terra vs GPT-6.1 Sol: Performance
Les résultats rapportés montrent un tableau mixte : Terra devance légèrement sur certaines évaluations d’agents et de codage scientifique, tandis que Sol obtient de meilleurs scores sur le codage général en terminal, l’automatisation de bureau et la vision. Les comparaisons ci-dessous séparent les résultats de lancement d’OpenAI des évaluations indépendantes et expliquent ce que chacune peut — et ne peut pas — dire de la performance en production.
Official Benchmark Results and Test Conditions
Les résultats suivants proviennent des évaluations de lancement de Terra par OpenAI. Terra est présenté aux efforts de raisonnement medium et maximum ; Sol est présenté à effort maximum. La dernière colonne compare uniquement les configurations à effort maximal.
OSWorld utilise l’évaluation hors ligne 2.1. Le test de factualité utilise des invites internes d’OpenAI conçues pour induire des erreurs. Il s’agit de résultats rapportés par le fournisseur dans des configurations d’évaluation spécifiques, plutôt que de mesures de votre charge de travail de production.
Benchmark
GPT-6.1 Terra (medium)
GPT-6.1 Terra (max)
GPT-6.1 Sol (max)
Comparison at max effort
Agents’ Last Exam v1
57.60%
60.00%
58.60%
Terra +1.4 pp
MMMU-Pro (Vision)
84.60%
85.50%
86.30%
Sol +0.8 pp
OSWorld 2.1, offline
66.70%
74.20%
78.00%
Sol +3.8 pp
Terminal-Bench 4.0
35.80%
50.30%
55.90%
Sol +5.6 pp
Terminal-Bench-Science 0.1
34.30%
58.30%
57.00%
Terra +1.3 pp
Factual error rate on difficult prompts
10.10%
4.30%
4.40%
Terra 0.1 pp lower
Toutes les scores sont en pourcentage ; les différences sont exprimées en points de pourcentage (pp). Plus bas est meilleur uniquement pour le taux d’erreurs factuelles. La différence de 0.1 point sur le taux d’erreurs ne suffit pas à établir un avantage de fiabilité significatif.
Pour l’ingénierie logicielle, l’avance de Sol sur Terminal-Bench et l’avance étroite de Terra sur Terminal-Bench-Science suggèrent que les résultats dépendent du type de tâche de codage. Pour les workflows d’application, le score supérieur de Sol sur OSWorld incite à l’évaluer pour l’automatisation de bureau, tandis que le résultat de Terra sur Agents’ Last Exam en fait un candidat pour les tâches d’agent professionnelles. Aucun de ces schémas n’établit un vainqueur universel.
L’échafaudage d’agent, l’accès aux outils et la configuration de l’environnement peuvent affecter ces résultats. Utilisez ces chiffres pour identifier des candidats à tester, puis validez-les selon les modifications de dépôt et les workflows d’application que vous devez réellement accomplir.
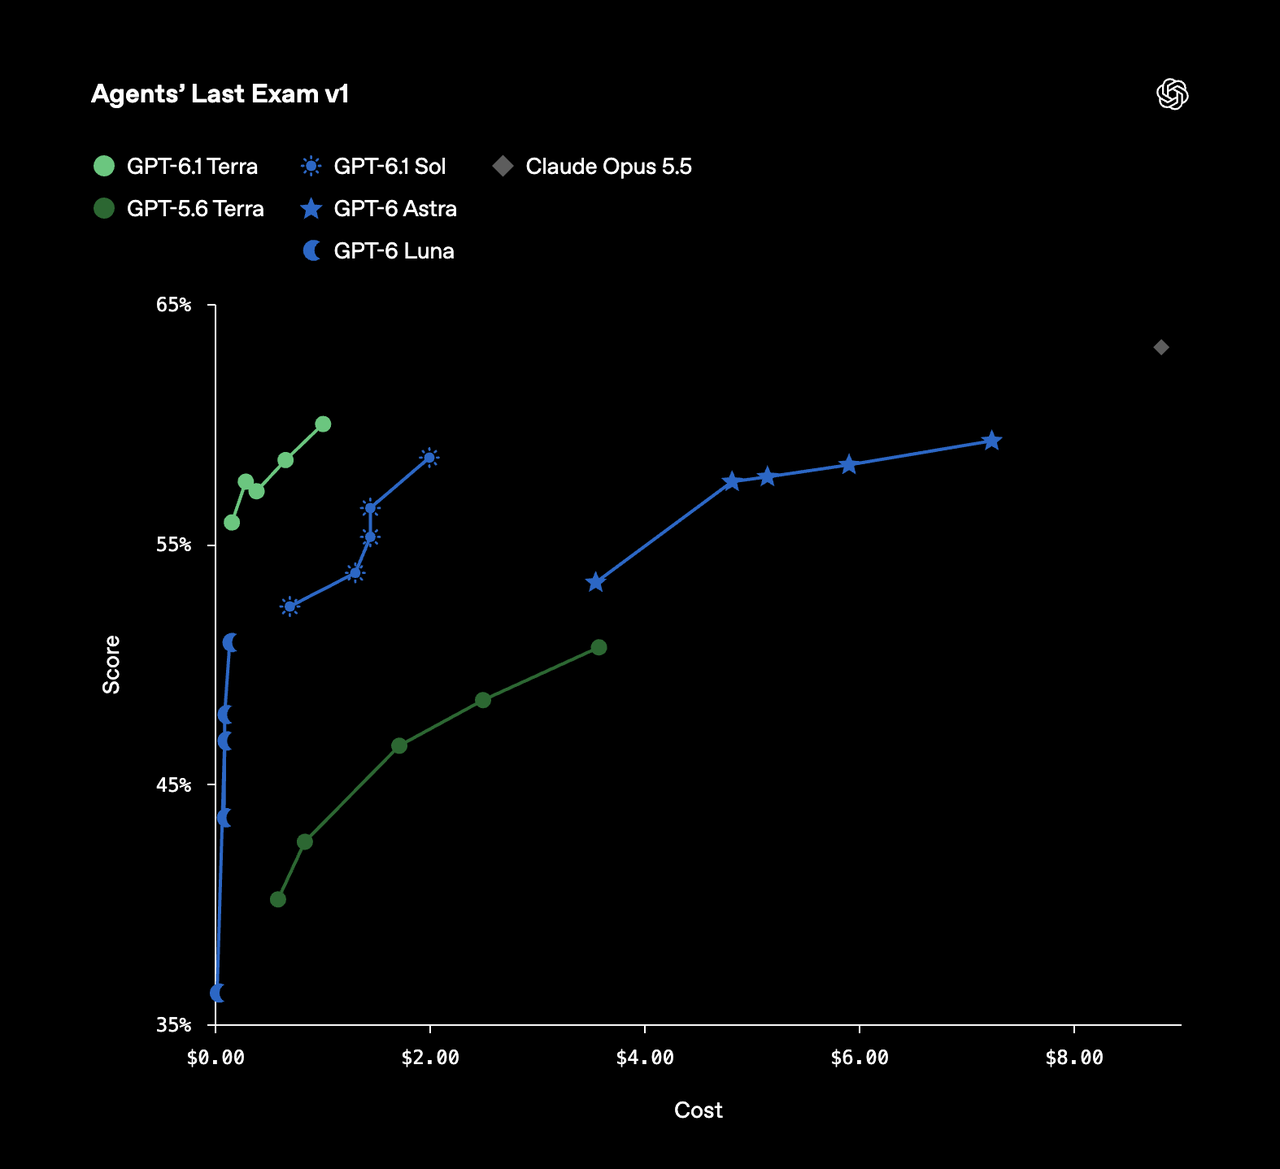
Le graphique Agents’ Last Exam v1 d’OpenAI trace les scores par rapport aux coûts estimés des tâches selon les configurations de modèle. Il ajoute une perspective de rentabilité au tableau ci-dessus ; les coûts tracés sont propres à la configuration d’évaluation.
Independent Intelligence and Coding Evaluations
L’évaluation du 26 octobre par Artificial Analysis place Terra quatre points en dessous de Sol sur son Intelligence Index à effort de raisonnement maximal. Son Coding Agent Index v2.0 donne 48 à Terra et 54 à Sol. Il s’agit d’évaluations distinctes avec leurs propres méthodes et échelles de notation ; elles ne doivent pas être combinées numériquement avec les résultats de benchmark d’OpenAI.
La même analyse identifie les réglages de raisonnement low et medium de Terra comme particulièrement rentables sur l’évaluation d’intelligence. Cela encourage à tester des configurations pratiques en parallèle des réglages à effort maximal. Les coûts d’évaluation restent spécifiques à la configuration du test et ne doivent pas être considérés comme des estimations des dépenses de votre application.
Speed and Latency: Task Completion vs. Token Generation
OpenAI rapporte que Terra termine les tâches évaluées d’Agents’ Last Exam plus de trois fois plus vite que Sol. Il s’agit d’une mesure de tâche de bout en bout qui inclut le raisonnement et les interactions logicielles. Cela n’implique pas un débit de jetons de sortie trois fois plus élevé ni le même gain de vitesse pour chaque requête API.
Pour les applications interactives, distinguez le temps jusqu’au premier jeton, qui mesure l’attente avant le début de la sortie, des jetons de sortie par seconde, qui mesurent la vitesse de poursuite de la réponse. Pour les agents, privilégiez le temps d’achèvement de bout en bout, y compris les appels d’outils, les reprises et la récupération.
Comparez les deux modèles avec les mêmes invites, outils, niveau de raisonnement pris en charge et critères d’acceptation. Enregistrez la latence en parallèle du succès des tâches : une réponse plus rapide a une valeur limitée si elle exige davantage de corrections ou échoue à mener le workflow à bien.
Vision and Long-Context Performance: What the Results Establish
L’avance de 0.8 point de Sol sur MMMU-Pro à effort maximal est un résultat de vision rapporté, plutôt qu’une garantie de meilleures performances sur chaque workflow visuel. Testez de petites étiquettes, de mauvaises numérisations, des schémas denses et des mises en page inconnues à l’aide d’entrées représentatives.
Les évaluations ci-dessus n’établissent pas quel modèle est meilleur en récupération ou raisonnement à long contexte. Bien que les deux aient la même capacité de contexte publiée, la capacité seule ne démontre pas la précision de récupération ni la mémoire intersessions. Testez la capacité de chaque modèle à localiser et utiliser des preuves pertinentes dans vos documents, et maintenez explicitement l’état de l’application d’une requête à l’autre.
GPT-6.1 Terra vs GPT-6.1 Sol: Cost
Les prix par jeton sont le point de départ pour comparer les coûts. Les reprises, jetons de raisonnement, appels d’outils et relecture humaine influent aussi sur ce que vous dépensez pour mener une tâche à bien.
Les tarifs suivants sont en USD par million de jetons et de tarification.
Provider and token category
GPT-6.1 Terra
GPT-6.1 Sol
OpenAI Standard — input
$1.00
$2.00
OpenAI Standard — cached input
$0.05
$0.10
OpenAI Standard — output
$5.00
$10.00
OpenAI Standard — 30-minute cache write
$1.25
$2.50
OpenAI Standard — 12-hour cache write
$2.50
$5.00
CometAPI ordinary input
$0.80
$1.60
CometAPI ordinary output
$4.00
$8.00
OpenAI API Pricing
Les tarifs Standard listés de Terra sont la moitié de ceux de Sol sur ces catégories. Les frais réels dépendent de la configuration de la requête : requêtes à long contexte, niveaux de traitement, traitement régional et utilisation d’outils peuvent avoir des conditions différentes. Consultez la documentation tarifaire applicable d’OpenAI avant d’estimer les coûts de production.
CometAPI Pricing
CometAPI est une voie d’accès tierce avec sa propre tarification et disponibilité des fonctionnalités. Ses tarifs ordinaires d’entrée et de sortie sont indiqués séparément ci-dessous.
À ces tarifs, les prix ordinaires d’entrée et de sortie de CometAPI sont 20% inférieurs aux tarifs OpenAI Standard ci-dessus. Confirmez les prix actuels, les frais long contexte, la prise en charge du cache et la disponibilité des outils pour votre compte avant le déploiement.
Example Cost for 1,000 Requests
Supposons qu’une application effectue 1,000 requêtes, chacune utilisant 2,000 jetons d’entrée non mis en cache et 500 jetons de sortie facturables. Cela produit un total de 2 millions de jetons d’entrée et 500,000 jetons de sortie.
Pour 1,000 requêtes, chacune utilisant 2,000 jetons d’entrée non mis en cache et 500 jetons de sortie facturables, les coûts estimés sont :
Terra via OpenAI: $2.00 pour l’entrée et $2.50 pour la sortie, soit un total de $4.50.
Sol via OpenAI: $4.00 pour l’entrée et $5.00 pour la sortie, soit un total de $9.00.
Terra via CometAPI: $1.60 pour l’entrée et $2.00 pour la sortie, soit un total de $3.60.
Sol via CometAPI: $3.20 pour l’entrée et $4.00 pour la sortie, soit un total de $7.20.
Ces calculs utilisent les tarifs ordinaires listés ci-dessus, sans remise de la Batch API. Ils excluent les écritures de cache, les frais séparés d’outils et les reprises. Tout jeton de raisonnement facturé en sortie doit être inclus dans le total de sortie.
Effective Cost per Successful Task
Dans cet article, une tâche réussie est celle qui passe les contrôles prédéfinis de qualité, de schéma le cas échéant, et d’achèvement sans correction humaine supplémentaire.
Des prix par jeton plus bas ne produisent pas toujours des coûts opérationnels plus faibles. Les économies de Terra peuvent s’amenuiser s’il nécessite davantage de tentatives, de jetons de raisonnement ou d’intervention humaine. Les tarifs plus élevés de Sol peuvent se justifier s’il mène davantage de tâches à bien du premier coup.
Effective model-and-tool cost per successful task = total model and tool spending across all attempts ÷ number of successful tasks.
Suivez séparément les coûts de relecture et de correction humaines. Choisissez le modèle qui atteint votre objectif de qualité au coût total le plus bas, plutôt que de comparer uniquement les prix des jetons.
Which Model Should You Choose: GPT-6.1 Terra or GPT-6.1 Sol?
Choisissez en fonction de la complexité de la tâche, de la qualité de sortie vérifiable et du coût total d’achèvement. Terra est un point de départ utile pour les workflows routiniers ; Sol mérite d’être évalué lorsque des raisonnements difficiles ou des échecs coûteux justifient une dépense supplémentaire.
When to Choose GPT-6.1 Terra
Commencez par Terra pour l’extraction à grand volume, la rédaction de documents, l’appariement de catalogues et les workflows d’application prévisibles. Ces tâches sont de bons candidats lorsque les résultats peuvent être vérifiés par rapport aux documents source, aux champs requis ou aux règles de validation automatisées.
Choisissez Terra lorsqu’il atteint vos objectifs de précision et d’achèvement dans le budget autorisé de reprises et de relecture humaine. Des tarifs par jeton plus bas offrent peu d’avantages si des échecs répétés annulent les économies.
When to Choose GPT-6.1 Sol
Évaluez Sol pour le débogage difficile, les modifications de dépôt impliquant de nombreuses dépendances et les workflows de bureau avec de longues chaînes d’actions dépendantes.
Choisissez Sol lorsque les tests montrent qu’il produit davantage de correctifs acceptés, réussit davantage de tests ou nécessite moins de corrections manuelles. Son coût par jeton plus élevé se justifie lorsque ces améliorations réduisent le coût total pour mener le travail à bien.
When to Use Terra First and Escalate to Sol
Un workflow hybride peut utiliser Terra pour la tentative initiale et passer à Sol lorsque des contrôles prédéfinis échouent. Fondez l’escalade sur des résultats observables plutôt que sur la confiance du modèle seul.
Par exemple, un workflow de génération de code pourrait :
Demander à Terra de produire la modification requise.
Exécuter les tests et contrôles de validation pertinents.
Passer à Sol si la modification échoue à ces contrôles ou sort des capacités vérifiées de Terra.
Envoyer les cas non résolus à une relecture humaine une fois le budget de reprises épuisé.
Lors de l’escalade, conservez la requête d’origine, le contexte pertinent, la sortie ayant échoué et les résultats de validation. Enregistrez l’utilisation des deux modèles afin que la comparaison des coûts inclue le workflow complet.
Production Evaluation Checklist
Avant de sélectionner un modèle par défaut ou de déployer un workflow d’escalade :
Utilisez des tâches représentatives: Incluez des requêtes routinières et des cas où l’échec est coûteux.
Gardez des comparaisons contrôlées: Utilisez des instructions, des preuves, des outils et des critères d’acceptation comparables. Enregistrez les IDs de modèle, les endpoints, les réglages de raisonnement et les dates de test.
Mesurez les résultats acceptés: Vérifiez la précision, la validité de schéma le cas échéant, les résultats de tests et l’achèvement sans correction manuelle.
Mesurez le temps et la dépense: Suivez la latence médiane et en queue, les jetons facturés, les appels d’outils, les reprises et l’effort de relecture humaine.
Répétez la comparaison: Exécutez les tâches plusieurs fois et alternez l’ordre des modèles pour réduire l’influence de résultats ponctuels.
Définissez des limites opérationnelles: Fixez des budgets de reprise, des déclencheurs d’escalade et des exigences d’approbation humaine avant le déploiement.
Comparez le workflow complet: Incluez les tentatives infructueuses et les coûts d’escalade lors du calcul de la dépense par tâche réussie.
Where Can You Access GPT-6.1 Terra and GPT-6.1 Sol?
Official Provider Access
Les deux modèles sont disponibles via l’API OpenAI. Pour les requêtes textuelles, Chat Completions est pris en charge ; l’appel d’outils nécessite la Responses API. Confirmez les paramètres pris en charge par le modèle, vos limites de compte et les outils disponibles sur la voie que vous prévoyez d’utiliser.
CometAPI Access
Pour utiliser l’un ou l’autre modèle via CometAPI, suivez son quickstart guide pour configurer le SDK compatible OpenAI. Fournissez votre clé CometAPI de manière sécurisée via la variable d’environnement COMETAPI_KEY et définissez l’URL de base sur https://api.cometapi.com/v1. Choisissez gpt-6.1-terra ou gpt-6.1-sol comme identifiant de modèle, et confirmez que la voie est activée pour votre compte.
Pour une première comparaison, donnez aux deux modèles les mêmes tâches représentatives et utilisez un effort de raisonnement medium. Gardez les instructions et critères d’acceptation cohérents, répétez chaque tâche et alternez l’ordre des modèles. Comparez les résultats réussis, le temps écoulé, les jetons facturés et les reprises plutôt que de juger l’un ou l’autre modèle à partir d’une seule réponse.
Conclusion
Commencez avec GPT-6.1 Terra pour des workflows fréquents et vérifiables, où un prix par jeton plus bas et un achèvement plus rapide comptent. Évaluez GPT-6.1 Sol lorsque le codage difficile, l’utilisation d’outils multi-étapes ou des échecs coûteux rendent précieux un raisonnement plus poussé. Le choix final doit se fonder sur le coût par tâche acceptée sur un ensemble d’évaluation représentatif, et non sur le prix ou un seul benchmark.
Pour de nombreuses applications, l’étape suivante utile est un petit essai représentatif avec des conditions de réussite claires et une voie d’escalade bornée. Laissez le résultat mesuré déterminer le modèle, plutôt que de vous fier au prix ou à un seul benchmark.
GPT-6.1 Terra vs GPT-6.1 Sol : tests de performance, tarifs et lequel choisir - CometAPI