Construire avec CometAPIBesoin d'une seule API pour plusieurs modèles ?Testez le workflow dans Playground, puis créez une clé API lorsque le modèle et le coût correspondent à votre cas d'usage.
Apprenez à exécuter MiniMax M3.1 Flash localement. Découvrez son architecture MoE 428B/23B, les exigences GPU, la configuration de vLLM et SGLang, les benchmarks et les alternatives d'API.
Deon GoodwinÉquipe de recherche sur les modèles IA et API
MiniMax M3.1 Flash apporte une IA à poids ouverts aux workflows exigeants de codage et d’agents, mais son exécution locale requiert un matériel puissant. Son architecture MoE à 428 Md de paramètres n’active qu’environ 23 Md de paramètres par token, ce qui réduit le calcul sans supprimer la nécessité de stocker le modèle complet. Les développeurs disposant de systèmes multi‑GPU compatibles peuvent le déployer via vLLM ou SGLang. Pour ceux qui veulent éviter la gestion d’infrastructure, l’API MiniMax M3.1 Flash dans CometAPI offre un moyen plus simple de démarrer.
Principaux enseignements
Le matériel est le principal obstacle. Les configurations vLLM publiées utilisent quatre GPU Blackwell ou AMD MI355X compatibles, ou huit GPU H100/H200.
Revu pour la clarté, l'attribution des sources et la terminologie API actuelle.
Le long contexte a un coût mémoire. Le modèle prend en charge jusqu’à un million de tokens, mais les limites pratiques de service dépendent de la mémoire GPU disponible et de la concurrence.
Le déploiement est spécifique au matériel. Utilisez un moteur d’inférence, un format de quantification et une configuration d’accélérateur compatibles plutôt qu’une commande d’installation générique.
Les benchmarks ne sont qu’un point de départ. Évaluez la précision en codage, l’achèvement des tâches d’agents, la latence et le débit sur vos propres charges.
L’inférence locale et hébergée répond à des besoins différents. L’auto‑hébergement offre un meilleur contrôle d’infrastructure, tandis que l’accès via API réduit la complexité d’installation et la maintenance.
Qu’est‑ce que MiniMax M3.1 Flash ?
MiniMax M3.1 Flash accepte du texte, des images et de la vidéo, et génère du texte. Il est conçu pour des workflows de codage, d’automatisation, d’interaction homme‑machine et de sécurité. Les poids sont distribués sous la MiniMax Community License. Avant d’offrir un service commercial, lisez la licence fournie avec le checkpoint et vérifiez les conditions applicables à votre usage.
Spécifications de MiniMax M3.1 Flash
Spécification
MiniMax M3.1 Flash
Développeur
MiniMax
Famille de modèle
MoE multimodal natif
Paramètres totaux
Environ 428 Md
Paramètres actifs
Environ 23 Md par token
Contexte maximal
1 048 576 tokens (capacité du modèle)
Types d’entrée
Texte, images et vidéo (selon la route)
Sortie
Texte
Attention
MiniMax Sparse Attention à chaque couche
Quantification
Couches denses MXFP8 / experts NVFP4
Décodage de draft
Tête de draft DSpark intégrée
Effort de raisonnement
low, medium, high, xhigh, max
Vitesse de sortie annoncée
200+ tokens/s en conditions favorables ; P50 170+ tokens/s
Licence
MiniMax Community License
Inférence documentée
vLLM, SGLang
Topologie typique
4 GPU Blackwell ou MI355X compatibles ; 8 GPU H100/H200
Comment MiniMax M3.1 Flash exploite‑t‑il son architecture 428B/23B ?
Un modèle Mixture‑of‑Experts (MoE) achemine chaque token vers des experts sélectionnés. Dans MiniMax M3.1 Flash, environ 23 Md de paramètres sont actifs pour un token, tandis que le pool total de paramètres est d’environ 428 Md. L’activation clairsemée réduit le calcul ; elle ne transforme pas le checkpoint en modèle dense de 23 Md.
Qu’est‑ce qui a changé dans MiniMax M3.1 Flash ?
Attention clairsemée : appliquée dans tout le modèle pour réduire le travail d’attention sur les longues entrées ; le bénéfice dépend des kernels de service et de l’invite.
Poids en précision mixte : les composants denses MXFP8 et les experts NVFP4 réduisent le stockage et le calcul, mais nécessitent toujours du matériel et des kernels compatibles.
Décodage DSpark : une tête de draft intégrée peut accélérer la génération dans les recettes prises en charge ; les résultats dépendent de l’acceptation des tokens et de la charge.
Service conscient de la consommation : la planification au niveau de l’infrastructure peut améliorer l’utilisation, mais ce n’est pas une fonctionnalité fournie automatiquement en téléchargeant les poids.
Quel matériel est nécessaire pour MiniMax M3.1 Flash ?
Budgez la mémoire GPU en quatre parties : poids du checkpoint, cache key‑value (KV) pour les tokens précédents, tampons d’exécution et marge de manœuvre pour la charge. Les estimations ci‑dessous couvrent uniquement le stockage brut des paramètres. La précision mixte, les échelles de quantification, les composants multimodaux et les surcoûts de service modifient les besoins réels.
Topologies GPU validées
Accélérateurs
Topologie publiée
Remarques
NVIDIA GB200/GB300/B200/B300
4 GPU, parallélisme tensoriel
Chemin NVFP4 natif pour Blackwell
NVIDIA H100/H200
8 GPU, parallélisme tensoriel
Caches FP8 et chemin MoE Marlin
AMD MI355X
4 GPU, parallélisme tensoriel
Requiert un ROCm pris en charge et des paramètres AITER
GPU grand public 24–32 Go
Aucune recette de checkpoint complet
Insuffisant pour un chargement simple sur un seul GPU
Station de travail CPU seule
Aucun déploiement pratique validé
Les expériences d’offloading ne sont pas des guides de production
Estimation mémoire : le stockage brut pour 428 Md de paramètres est d’environ 856 Go en BF16, 428 Go en 8 bits, ou 214 Go en 4 bits idéalisés. Le checkpoint officiel mélange des formats, ces chiffres ne sont donc pas des besoins de VRAM à l’exécution. Prévoyez les échelles de quantification, le cache KV, les tampons d’exécution et la concurrence ; utilisez les fichiers du checkpoint et la recette pour votre GPU afin de dimensionner le système.
Réservez de l’espace NVMe pour le checkpoint, les téléchargements temporaires et une copie de rollback.
Quelle méthode de déploiement choisir ?
Pour un cluster local pris en charge, vLLM est un point de départ pragmatique avec des configurations de référence et une intégration API familière ; SGLang convient aux équipes qui explorent la personnalisation du service après vérification de la compatibilité, tandis que CometAPI offre une voie hébergée pour prototyper et basculer de modèle.
Exigence
vLLM local
SGLang local
CometAPI
Poids et GPU
Télécharger les poids ; exploiter des GPU compatibles
Télécharger les poids ; exploiter des GPU compatibles
Inférence gérée par le fournisseur ; pas de poids locaux
Blackwell / AMD MI355X
Recettes spécifiques au matériel
Recettes spécifiques au matériel
Matériel géré par le fournisseur
H100/H200
Recette à huit GPU documentée
Vérifier la matrice de support actuelle
Matériel géré par le fournisseur
Décodage et parallélisme
DSpark sur chemins pris en charge ; service tensoriel et distribué
Décodage spécifique au matériel ; parallélisme tensoriel et expert
Limité aux options exposées par la route
Contrôle et traitement des données
Votre environnement ; vous gérez la montée en charge
Votre environnement ; vous gérez la montée en charge
Fournisseur externe ; montée en charge gérée par le fournisseur
Choisissez le framework doté d’une recette validée pour votre matériel, puis comparez la latence et le débit avec les mêmes invites, précision et concurrence.
Comment exécuter MiniMax M3.1 Flash en local avec vLLM ?
Les étapes suivantes supposent un hôte Linux équipé de quatre GPU NVIDIA Blackwell compatibles, un environnement driver/CUDA pris en charge et l’accès au checkpoint officiel. Utilisez une build vLLM validée ; une installation ordinaire sur un GPU non pris en charge peut échouer même si l’installation du package réussit.
Assurez‑vous que la roue installée et le runtime CUDA correspondent à votre famille de GPU. Si une build de développement spécifique au projet est requise, suivez les notes d’installation de référence avant d’utiliser les arguments de lancement.
Utilisez un jeton d’accès Hugging Face approprié si nécessaire, conservez la structure du répertoire et vérifiez l’intégralité du téléchargement des shards avant de lancer le serveur.
Attendez que le serveur ait fini de charger et indique être prêt avant d’envoyer une requête. La commande ci‑dessus limite le contexte à 32 768 tokens et les séquences concurrentes à quatre pour un premier smoke test. Ces limites réduites ne sont pas des réglages de benchmark ; ajustez‑les après avoir mesuré l’utilisation mémoire et le comportement des requêtes sur votre matériel.
Si l’identifiant servi diffère du nom de répertoire, appelez /v1/models et utilisez l’ID exact retourné. Une réponse texte réussie ne valide que l’inférence de base ; testez séparément la vision, l’appel d’outils, la concurrence et le long contexte.
Étape 5 : Intégrer avec un client Python compatible OpenAI
L’exemple écoute sur 127.0.0.1 pour les tests locaux. Avant de connecter des clients distants, placez des contrôles d’accès devant l’endpoint et configurez les timeouts client, des retries bornés et la supervision.
Variante H100/H200 : utiliser la recette Hopper à huit GPU
Sur huit GPU H100/H200, utilisez le cache FP8 spécifique à Hopper et le chemin MoE Marlin plutôt que la configuration NVFP4 Blackwell. La commande ci‑dessous suit la recette vLLM Hopper officielle avec le contexte et la concurrence réduits à 32 K et quatre séquences pour un test initial. Elle désactive l’entrée vidéo conformément à cette recette. Gardez cet endpoint derrière vos contrôles d’accès existants.
SGLang propose des recettes de déploiement M3.1 spécifiques au matériel et un service compatible OpenAI. Au snapshot du 23 octobre, la documentation inclut des images de conteneur de développement dédiées ; on ne doit donc pas supposer qu’une installation générique de SGLang contient tout le support spécifique au modèle.
Récupérer l’image de conteneur dédiée
# Image de développement NVIDIA
docker pull lmsysorg/sglang:dev-minimax-m31-flash

# Image de développement AMD MI350X/MI355X
docker pull lmsysorg/sglang:dev-minimax-m31-flash-mi35x
Ensuite, suivez le cookbook SGLang MiniMax M3.1 pour votre accélérateur. Le pull d’une image ne télécharge que le runtime ; vous devez toujours démarrer un conteneur avec accès GPU et lancer la configuration de service correspondante à l’intérieur. Utilisez la commande complète spécifique au matériel du cookbook, attendez la disponibilité, puis interrogez la liste des modèles de l’endpoint avant d’envoyer une requête de test. Les chemins NVIDIA et AMD documentés utilisent des dépendances différentes et doivent être configurés séparément.
Comment MiniMax M3.1 Flash se compare‑t‑il sur les benchmarks ?
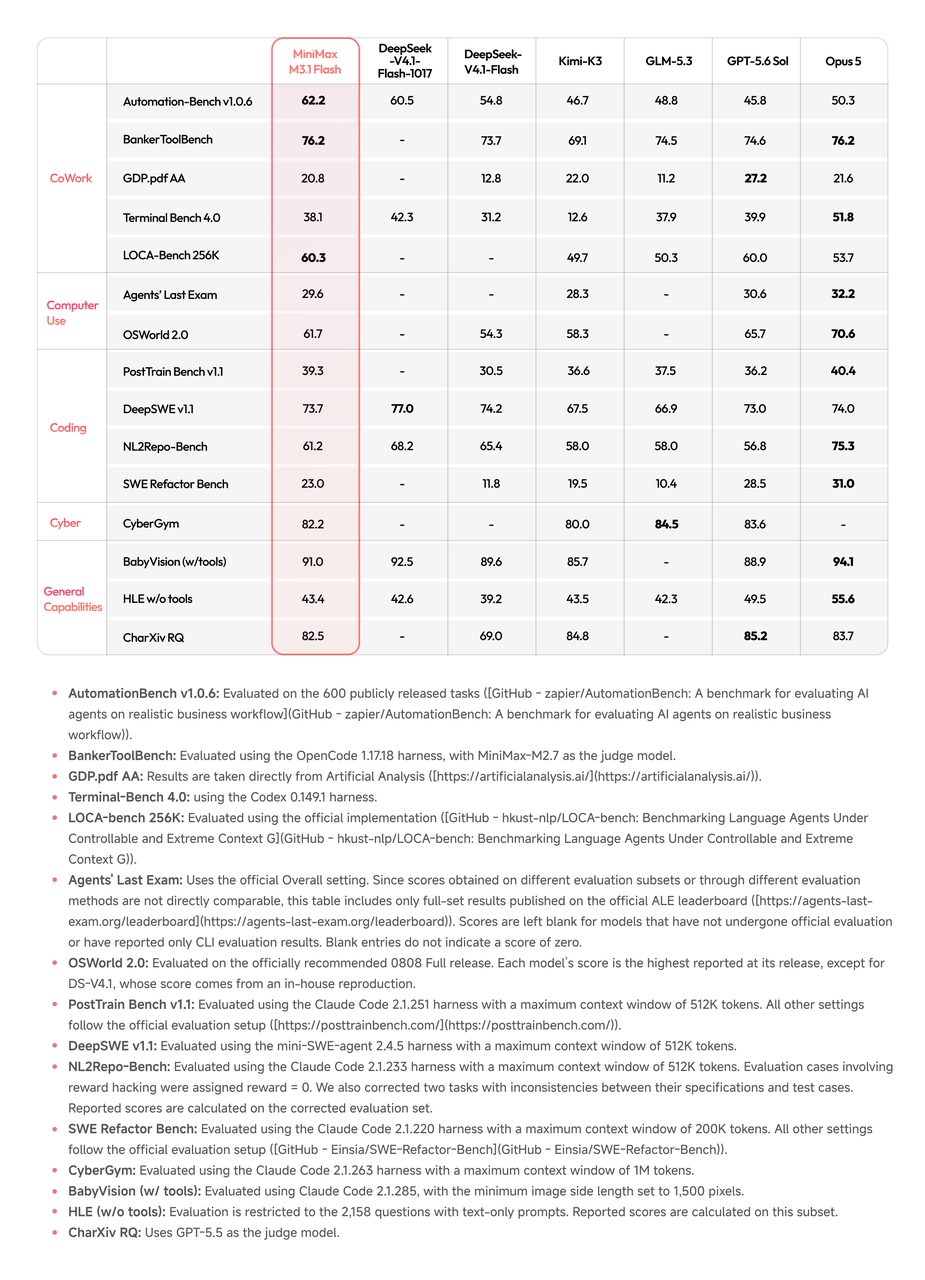
Une fois que votre endpoint passe ses vérifications de base, utilisez les benchmarks publiés pour décider des charges à tester ensuite. Les chiffres ci‑dessous sont des évaluations publiées par le fournisseur, et non des mesures de votre déploiement local.
Benchmark
M3.1 Flash
DeepSeek V4.1 Flash 1017
Kimi K3
Automation-Bench v1.0.6
62.8
60.5
46.7
DeepSWE v1.1
73.7
77.0
67.5
Terminal Bench 4.0
38.1
42.3
12.6
OSWorld 2.0
61.7
N/A
58.3
NL2Repo-Bench
61.2
68.2
58.0
BabyVision with tools
91.0
92.5
85.7
Dans cette comparaison, MiniMax devance les modèles listés sur Automation‑Bench, tandis que DeepSeek mène plusieurs benchmarks de codage. Lisez la fiche modèle et les paramètres d’évaluation avant de tirer des conclusions, et testez les invites et outils que votre application utilise réellement. Les scores issus de versions ou configurations de benchmark différentes ne sont pas directement comparables.
Comment optimiser les performances de MiniMax M3.1 Flash ?
Contrôler le contexte et la concurrence
Après la première requête réussie, augmentez une variable de charge à la fois : longueur d’entrée, longueur de sortie ou requêtes concurrentes. Enregistrez la mémoire maximale et la latence de réponse pour chaque exécution. Conservez les derniers réglages stables comme point de rollback, afin qu’une expérimentation échouée ne devienne pas votre nouveau baseline.
Choisir l’effort de raisonnement de manière réfléchie
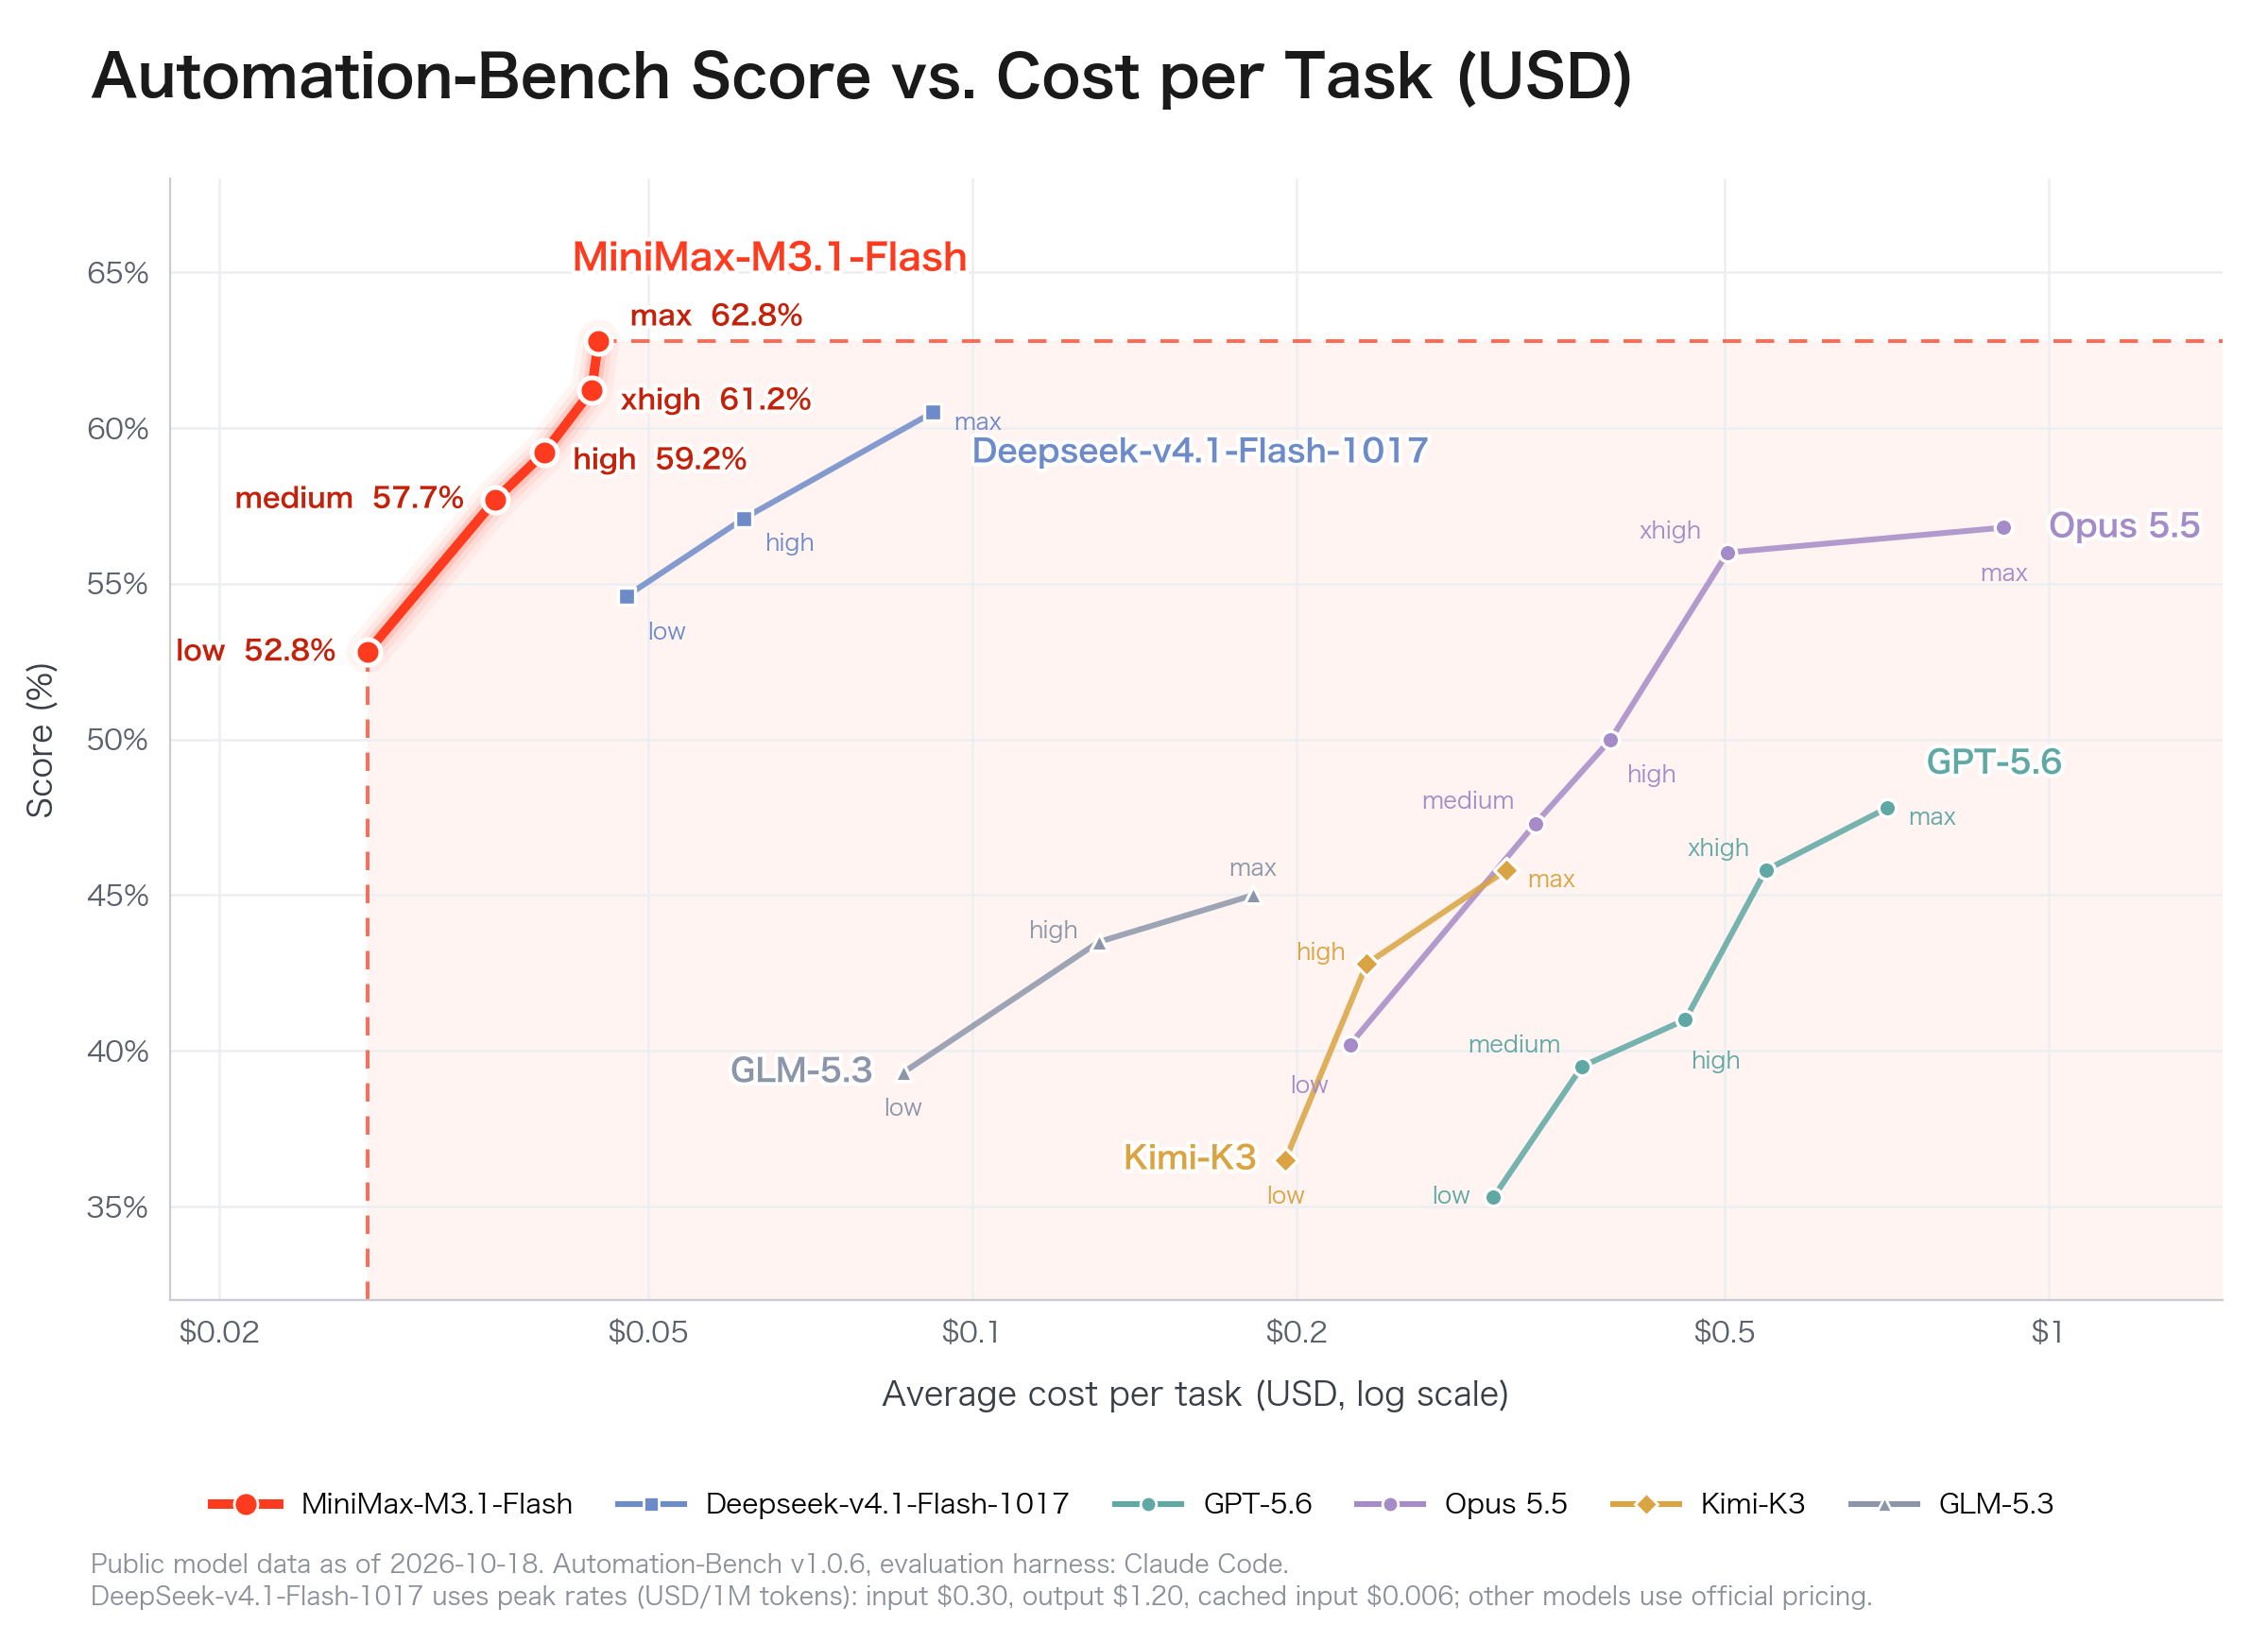
M3.1 Flash prend en charge les efforts low, medium, high, xhigh et max. Des réglages plus élevés peuvent améliorer les scores sur des tâches exigeantes mais requièrent souvent davantage de tokens de raisonnement et une latence plus longue. Utilisez conjointement la qualité d’achèvement des tâches et le coût de calcul écoulé.
Pour les requêtes vLLM locales, la recette indique les réglages d’effort de raisonnement sous chat_template_kwargs. Vérifiez à la fois la réponse finale et tout champ de raisonnement renvoyé séparément lors de la validation de votre client, car les endpoints hébergés et locaux peuvent exposer ces champs différemment.
Suivre le coût par tâche complétée
Pour les agents, les tokens par seconde ne suffisent pas. Enregistrez le temps jusqu’au premier token, le débit de sortie, le taux d’acceptation du décodage spéculatif, le débit concurrent, les échecs d’appel d’outils, l’utilisation mémoire et le coût par tâche complétée. Une réponse plus lente avec moins d’échecs d’outils peut offrir une meilleure économie globale.
Comment utiliser l’API MiniMax M3.1 Flash dans CometAPI ?
Les équipes qui n’ont pas besoin d’une infrastructure d’accélérateurs dédiée peuvent utiliser un endpoint hébergé compatible OpenAI. Cela élimine le téléchargement du checkpoint et les opérations GPU, mais déplace le traitement des requêtes hors de l’environnement auto‑hébergé.
export COMETAPI_KEY="YOUR_COMETAPI_KEY"

curl https://api.cometapi.com/v1/chat/completions \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "minimax-m3.1-flash",
    "messages": [{"role":"user","content":"Review this Python function for edge cases."}],
    "max_tokens": 2048
  }'
Confirmez l’identifiant du modèle dans votre console CometAPI avant d’exécuter cet exemple. Utilisez la passerelle lorsque disposer d’une API commune entre fournisseurs aide votre application ; comparez son tarif actuel avec l’accès direct pour votre usage prévu.
Tarification de l’API MiniMax M3.1 Flash
Prix par million de tokens
API officielle MiniMax
CometAPI
Entrée
0,15 $
0,80 $
Sortie
0,60 $
3,20 $
Entrée mise en cache
0,015 $
Confirmez le tarif de la route actuelle
Les tarifs de l’API directe MiniMax dans l’annonce de lancement du 19 octobre 2026 sont de 0,15 $ en entrée, 0,60 $ en sortie et 0,015 $ pour l’entrée mise en cache par million de tokens. Pour CometAPI, vérifiez la route de modèle active, les tarifs entrée/sortie, les règles de cache et toute remise de compte avant d’estimer les dépenses. Comparez le coût total pour votre mix de tokens et vos retries attendus.
Quels problèmes peuvent survenir lors de l’exécution de MiniMax M3.1 Flash ?
Mémoire insuffisante lors du chargement ou des requêtes
Si les poids ne se chargent pas : vérifiez l’étape en échec dans le log de démarrage, confirmez que le checkpoint est complet et vérifiez que la topologie GPU et le backend de quantification correspondent à la recette. Si les poids dépassent la mémoire disponible, utilisez une configuration avec une capacité suffisante ; raccourcir une requête ne résout pas un échec de chargement des poids.
Si les poids se chargent mais que l’allocation du cache échoue au démarrage : vérifiez les réglages du cache et la mémoire disponible, puis réduisez le contexte ou la concurrence conformément à la recette.
Si le serveur démarre mais qu’une requête manque de mémoire : réessayez avec une courte invite et une requête à la fois, puis augmentez séparément la longueur d’entrée, la longueur de sortie et la concurrence tout en surveillant la mémoire.
Kernels d’attention ou de quantification incompatibles
L’exécution NVFP4 diffère entre le matériel Blackwell, Hopper et AMD. Faites correspondre les versions du moteur d’inférence, les backends de quantification, les versions CUDA/ROCm et les familles d’accélérateurs, plutôt que de réutiliser des flags au hasard.
Configuration du cache d’attention clairsemée
Si le démarrage signale une mise en page de cache non prise en charge, comparez la configuration complète du cache avec la recette spécifique au matériel. La recette vLLM actuelle requiert --block-size 128 pour le cache clairsemé/indexé MSA. Si le démarrage signale une erreur de mise en page ou de taille de bloc, comparez la configuration complète avec la recette pour votre matériel.
Identifiants de modèle inattendus
Un chemin local et un nom de modèle de passerelle distante ne sont pas nécessairement identiques. Interrogez la réponse /v1/models locale et évitez de coder en dur des hypothèses provenant d’un autre endpoint.
Débit observé insuffisant
Distinguez le traitement lent de l’invite et la génération lente des tokens. Comparez des exécutions avec la même longueur d’entrée et la même limite de sortie, puis vérifiez l’utilisation GPU et le comportement de l’interconnexion avant d’augmenter la taille de lot. Un chiffre de vitesse publié par un fournisseur n’est pas un baseline pour votre cluster local.
Conclusion
Choisissez votre première voie de déploiement en fonction du matériel que vous pouvez exploiter aujourd’hui. Utilisez le guide vLLM pour un cluster local pris en charge, le cookbook SGLang spécifique au matériel pour une pile de service alternative, ou une API hébergée si vous souhaitez vous concentrer sur l’intégration applicative. Conservez la configuration qui atteint vos objectifs de qualité de tâche et de latence à un coût d’exploitation soutenable.
La manière la plus fiable de sélectionner une méthode de service est d’optimiser pour des travaux correctement complétés par dollar et par minute, et non uniquement pour le pic de tokens par seconde.
FAQ
Comment rendre un déploiement reproductible après mise à jour du runtime ?
Figez la révision du checkpoint, les versions de l’image runtime ou des packages, la pile de drivers et les paramètres de lancement. Exécutez le même petit jeu d’acceptation avant chaque mise à jour et conservez la configuration précédente fonctionnelle pour rollback.
Comment gérer les retries lorsqu’un agent appelle des outils ?
Séparez la relance du modèle de la répétition d’une action d’outil. Utilisez des clés d’idempotence pour les actions qui modifient des données, vérifiez si la première tentative a réussi et validez l’intégralité des arguments d’outil avant exécution.
Puis‑je basculer entre un endpoint local et CometAPI sans changer le comportement applicatif ?
Gardez l’endpoint, les identifiants et l’ID de modèle configurables. Testez le streaming, les appels d’outils, les champs de raisonnement et les entrées multimodales sur les deux routes, et confirmez vos exigences de routage des données avant d’activer le fallback.
Que tester avant d’accepter des entrées multimodales ?
Testez des images et vidéos représentatives, y compris des fichiers de faible qualité et non pris en charge. Vérifiez séparément le prétraitement, les limites de taille, la qualité de réponse et les timeouts ; une requête texte réussie ne valide pas le chemin multimodal.
Comment savoir si un déploiement est prêt pour de vrais utilisateurs ?
Fixez des objectifs pour la réussite des tâches, les appels d’outils valides, la latence, les erreurs et le coût. Testez un trafic réaliste, vérifiez la supervision et le comportement de fallback, puis élargissez à partir d’un petit déploiement uniquement tant que ces objectifs tiennent.