Construire avec CometAPIBesoin d'une seule API pour plusieurs modèles ?Testez le workflow dans Playground, puis créez une clé API lorsque le modèle et le coût correspondent à votre cas d'usage.
La mise en cache du prompt permet aux modèles de langage de réutiliser des préfixes de prompt déjà traités au lieu de recalculer à chaque fois le même segment d’entrée. Elle peut réduire le coût des jetons d’entrée et améliorer la latence, en particulier pour les agents, l’assistance client, le RAG et l’analyse de documents volumineux. En 2026, OpenAI propose une mise en cache automatique et de nouveaux contrôles explicites, Claude prend en charge la mise en cache automatique et des points de rupture au niveau des blocs, et Gemini met l’accent sur la mise en cache implicite pour ses modèles les plus récents. Les fournisseurs facturent différemment les écritures, les lectures et, le cas échéant, le stockage. L’expiration peut déclencher une nouvelle écriture ou une facturation complète de l’entrée, si bien que les économies réelles dépendent de la fréquence de réutilisation et du taux de hits mesuré.
Ce guide compare la mise en cache du prompt dans GPT-6.1 Sol, Claude Opus 5.5 et Gemini 4 Argon pour les développeurs qui construisent des applications avec de l’entrée répétée. Il se concentre sur les contrôles de cache, la tarification et la manière de vérifier la réutilisation.
Revu pour la clarté, l'attribution des sources et la terminologie API actuelle.
La mise en cache du prompt réutilise l’entrée traitée — pas la réponse précédente du modèle.
Chez OpenAI, la mise en cache du prompt dépend d’un préfixe stable, de fonctionnalités propres au modèle et de seuils et durées de rétention spécifiques au modèle.
Chez Claude, la mise en cache du prompt propose des TTL de 5 minutes et une option à 1 heure, avec contrôle du cache automatique et explicite.
La mise en cache de contexte de Gemini est implicite sur les modèles modernes ; les ressources de cache explicites restent dépendantes du modèle.
Les économies liées à la mise en cache dépendent des écritures, lectures, du stockage et des hits réels ; vérifiez la prise en charge de l’endpoint et la facturation des jetons mis en cache lorsque vous utilisez CometAPI.
Qu’est-ce que la mise en cache du prompt dans les LLM ?
La mise en cache du prompt est une optimisation d’inférence qui permet de réutiliser l’état computationnel dérivé d’un préfixe précédemment traité. Un prompt contient souvent des instructions stables, des définitions d’outils ou des documents, suivis d’une question utilisateur variable. Si une requête ultérieure répète le préfixe éligible, le fournisseur peut réutiliser des états clé-valeur (KV) mis en cache et ne traiter que la partie non mise en cache. Contrairement à la mise en cache de réponse, cela ne rejoue pas une ancienne réponse : le modèle génère une nouvelle réponse pour la requête courante.
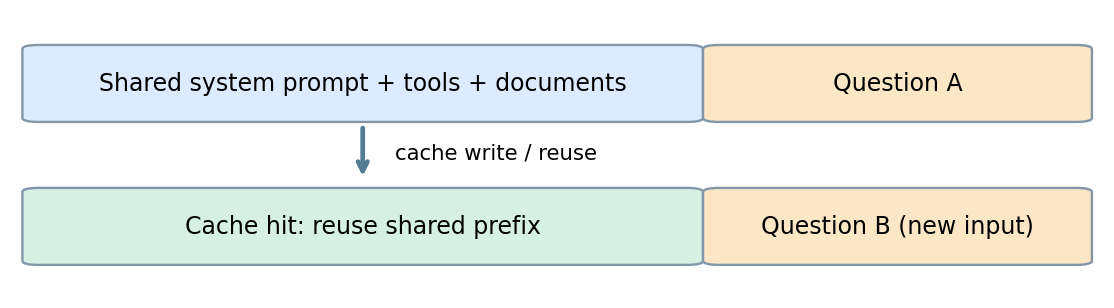
Flux de mise en cache du prompt :
Première requête : envoyer un grand préfixe réutilisable et une question spécifique.
Création du cache : le fournisseur stocke l’état computationnel intermédiaire éligible.
Requête suivante : réutiliser le préfixe identique et remplacer la question.
Lecture du cache : les jetons déjà traités sont réutilisés tandis que les nouveaux jetons sont traités normalement.
Illustration conceptuelle fournie avec la version initiale : un matériau de prompt répété précède une question changeante. Ce n’est pas un schéma d’architecture officiel d’un fournisseur.
Le principe commun de conception est la stabilité du préfixe. Les contrats d’API, les familles de modèles éligibles, la durée de vie du cache et les frais ne sont pas interchangeables.
Aperçu de la mise en cache chez OpenAI, Claude et Gemini
Le même principe de préfixe stable s’applique chez tous les fournisseurs, mais les contrôles ci-dessous sont spécifiques aux modèles utilisés dans ce guide. Vérifiez toujours le modèle et l’endpoint ensemble avant de copier un réglage.
Paramètre
OpenAI : GPT-6.1 Sol
Claude : Opus 5.5
Google : Gemini 4 Argon
Activation du cache
Correspondance implicite ; points de rupture explicites pris en charge
Activation via cache_control au niveau de la requête ou du bloc de contenu
Mise en cache implicite activée par défaut
Préfixe minimal
1,024 jetons d’entrée visibles
512 jetons avant la limite du cache
4,096 jetons d’entrée
Contrôles de durée de vie
Responses API : prompt_cache_options.ttl ; 30m par défaut ou 12h
5 minutes par défaut ; option TTL à 1 heure
Durée de vie implicite gérée par le fournisseur
Où placer le contenu stable
Instructions, outils et références en tête
Définitions d’outils stables, contenu système ou blocs de message avant la limite
Gros contenu partagé au début du prompt
Mesures à inspecter
input_tokens_details.cached_tokens et la création d’écriture de cache déclarée
cache_creation_input_tokens et cache_read_input_tokens
cached_content_token_count dans usage_metadata, lorsque présent
Distinction importante
prompt_cache_key peut séparer la comptabilisation ; non requis pour le routage automatique de Sol
Le point de rupture doit se terminer sur un contenu qui reste inchangé
Pas de ressource de cache explicite pour Argon ; des modèles plus anciens exposent une interface distincte
Contrôles de mise en cache du prompt et exemples Python
Chaque exemple envoie le même matériau de référence avec deux questions différentes. Conservez le contenu partagé inchangé, exécutez les requêtes séquentiellement et inspectez les mesures d’usage pour vérifier si la seconde requête a effectivement réutilisé l’entrée mise en cache.
OpenAI : contrôles de cache et exemple Python
OpenAI associe automatiquement les préfixes de prompt éligibles au cache et, sur les modèles récents pris en charge, permet la configuration explicite de la limite et de la rétention. La réutilisation du cache est particulièrement utile lorsque des instructions système longues, des schémas d’outils ou du contexte de dépôt se répètent d’une requête à l’autre. La longueur de préfixe requise et les multiplicateurs de prix par jeton dépendent de la génération du modèle et du palier de rétention choisi.
Cet exemple utilise la Responses API avec prompt_cache_options en mode implicite et une durée de 30 minutes. Les générations de modèles antérieures utilisent des paramètres de rétention différents ; suivez les paramètres propres à votre modèle.
Installez le SDK openai et définissez OPENAI_API_KEY. Utilisez au moins 1,024 jetons visibles dans le préfixe stable. Exécutez les deux requêtes séquentiellement et inspectez input_tokens_details.cached_tokens et cache_write_tokens dans usage. Un nombre positif de jetons mis en cache confirme une lecture facturée du cache ; cela ne garantit pas une latence plus faible à chaque requête.
Pour exécuter les exemples, installez le SDK Python approprié, définissez la clé API du fournisseur et créez un fichier UTF-8 reference.txt contenant suffisamment de contenu stable pour atteindre le minimum de mise en cache de ce modèle.
from pathlib import Path
from openai import OpenAI

client = OpenAI()  # Lit OPENAI_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
questions = ["Résumez l’architecture.", "Identifiez les principaux risques techniques."]
for question in questions:
    response = client.responses.create(
        model="gpt-6.1-sol",
        instructions="Utilisez le matériel de référence suivant.\n" + shared,
        input=question,
        prompt_cache_key="docs-assistant-v1",
        prompt_cache_options={"mode": "implicit", "ttl": "30m"},
    )
    print(response.output_text)
    print(response.usage)
Claude : contrôles de cache et exemple Python
Dans la Messages API de Claude, la mise en cache du prompt est une option à activer. Ajoutez cache_control au niveau de la requête pour un placement automatique du point de rupture, ou attachez-le à un bloc de contenu pour marquer un point de rupture explicite. Les développeurs peuvent marquer des instructions stables, des documents et des blocs de prompt sélectionnés, tout en modifiant l’entrée utilisateur ultérieure. Le cache standard de courte durée est de cinq minutes, avec une option d’une heure pour les charges adaptées.
Installez le SDK anthropic et définissez ANTHROPIC_API_KEY. Pour Claude Opus 5.5, fournissez au moins 512 jetons avant la limite du cache. Conservez le bloc système identique d’une requête à l’autre. Une entrée de cache devient disponible lorsque la première réponse commence ; cet exemple attend la réponse complète pour simplifier la démonstration. Inspectez les compteurs de création et de lecture du cache ; un préfixe court peut retourner zéro pour les deux sans lever d’erreur.
Gemini : mise en cache implicite et exemple Python
Google appelle son implémentation la mise en cache de contexte. Gemini 4 Argon utilise une mise en cache implicite et ne prend pas en charge de ressources de cache explicites. Certaines familles de modèles plus anciennes prennent en charge des caches explicites avec un TTL configurable. Choisissez l’interface de mise en cache en fonction du contrat du modèle individuel plutôt que de supposer que tous les modèles Gemini exposent les mêmes contrôles.
Installez google-genai et définissez GEMINI_API_KEY. Utilisez au moins 4,096 jetons de contenu partagé en tête pour Gemini 4 Argon, et envoyez la seconde requête peu après la première. Inspectez cached_content_token_count dans usage_metadata lorsque présent. La mise en cache implicite peut rater même quand le préfixe est éligible.
from pathlib import Path
from google import genai

client = genai.Client()  # Lit GEMINI_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Résumez l’architecture.", "Identifiez les principaux risques techniques."]:
    response = client.models.generate_content(
        model="gemini-4-argon",
        contents=shared + "\nQuestion : " + question,
    )
    print(response.text)
    print(response.usage_metadata)
Combien coûte la mise en cache du prompt chez OpenAI, Claude et Gemini ?
Les coûts de mise en cache doivent être évalués comme la combinaison des écritures, des lectures et — sur certains systèmes de cache explicite — de la rétention ou du stockage. Les multiplicateurs suivants illustrent des schémas fréquents et ne constituent pas des garanties de prix universelles pour toutes les versions de modèles.
Catégorie de coût
OpenAI
Claude
Gemini
Entrée non mise en cache
Tarif normal par jeton d’entrée
Tarif normal par jeton d’entrée
Tarif normal par jeton d’entrée
Écriture de cache
Surcoût d’écriture possible sur modèles récents
Surcoûts 5m/1h
Implicite ou explicite selon le modèle
Lecture de cache
Tarif réduit spécifique au modèle
Tarif réduit spécifique au modèle
Tarif réduit spécifique au modèle
Durée de vie du cache
Spécifique au modèle
5m / 1h
Gérée implicitement / configurable en explicite
Stockage additionnel
Selon le modèle
Généralement inclus dans le palier d’écriture
Des frais de stockage explicites peuvent s’appliquer
Exemple illustratif : un préfixe de 10,000 jetons est réutilisé sur N requêtes ; son écriture initiale coûte 1,25 fois l’entrée ordinaire, et les lectures ultérieures coûtent 0,1 fois l’entrée ordinaire. Supposons un prix d’entrée de base de $2 par million de jetons et des hits parfaits après la première requête.
Nombre de requêtes
Sans mise en cache
Avec mise en cache
Économies sur le préfixe réutilisé
10
$0.200
$0.043
78.50%
100
$2.000
$0.223
88.85%
Formule : coût du préfixe mis en cache = 1.25P + (N − 1) × 0.1P, où P est le coût ordinaire de traitement une fois du préfixe partagé. Cet exemple exclut l’entrée dynamique, la sortie, les expirations, les ratés, le stockage et autres services.
L’exemple ci-dessus utilise un taux de lecture illustratif de 10%, pas le taux actuel de GPT-6.1 Sol. La tarification standard court contexte de Sol est de $2 par million de jetons d’entrée non mis en cache, $0.10 par million de jetons d’entrée mis en cache, et $2.50 par million de jetons écrits avec la durée de vie par défaut. Recalculez l’exemple en utilisant votre modèle, palier et facture d’endpoint réels.
Une durée de vie plus longue ne vaut la peine que si elle évite suffisamment d’écritures répétées ou de requêtes non mises en cache pour compenser son prix. Les écritures de 5 minutes et 1 heure de Claude sont facturées respectivement 1.25× et 2× du tarif d’entrée de base. Les caches explicites de certains anciens modèles Gemini peuvent aussi entraîner des frais de stockage. Mesurez la réutilisation sur de vrais intervalles d’inactivité, pas seulement sur une rafale d’appels consécutifs.
Considérez les ratés, l’expiration et la génération de sortie comme faisant partie de la facture. Si un préfixe expire avant d’être réutilisé, la requête suivante peut nécessiter une nouvelle écriture ou un traitement complet de l’entrée. Les prompts courts peuvent ne pas être éligibles du tout, tandis que des réponses longues peuvent faire des jetons de sortie le principal poste de coût même avec une forte réutilisation du cache. Comparez le coût total par tâche terminée avant d’ajouter davantage de complexité de cache.
Quelle API de mise en cache du prompt est la meilleure selon les charges ?
Pour les agents de code et l’assistance client, placez les définitions d’outils stables, le contexte du dépôt, les politiques et la connaissance avant la tâche changeante. OpenAI et Claude offrent des contrôles de point de rupture qui aident à définir des frontières réutilisables ; évaluez les lectures de cache de l’endpoint plutôt que de supposer que le texte répété a été mis en cache.
Pour l’analyse de documents et le multimodal, placez le document source ou le média pris en charge avant la question. L’approche implicite de Gemini réduit le travail de gestion du cache, tandis que Claude permet de marquer directement le bloc stable. Vérifiez la prise en charge du type de média et du modèle avant de compter sur la réutilisation.
Pour les longues conversations, ajoutez de nouveaux tours au lieu de réécrire à chaque fois le début, et choisissez une durée disponible adaptée aux intervalles entre tours. Si votre application a besoin d’une ressource de cache nommée que vous pouvez créer et référencer explicitement, évaluez un modèle Gemini qui prend en charge cette interface ; Argon ne le fait pas.
Il n’y a pas de gagnant universel : comparez le taux de hits de cache, le coût par tâche terminée et la latence sous votre profil de trafic réel.
Comment la mise en cache du prompt affecte-t-elle la latence et les performances ?
Un hit de cache réduit le traitement d’entrée répété et peut raccourcir le temps jusqu’au premier jeton. Il n’améliore pas intrinsèquement la qualité de la réponse ni n’accélère la génération de sortie, et l’entrée mise en cache occupe toujours la fenêtre de contexte. Mesurez la latence du premier jeton et le temps de réponse total sur des requêtes comparables ; un hit de cache seul n’est pas la preuve que l’utilisateur a reçu la réponse finale plus tôt.
Comment optimiser la mise en cache du prompt et diagnostiquer les ratés
Commencer par un préfixe stable et utile
Placez en premier des instructions réutilisables, des définitions d’outils, des politiques et des documents ; mettez les horodatages, IDs de requête, contexte changeant et la question de l’utilisateur après. Conservez l’ordre des outils et les schémas stables. En cas de mise en cache explicite, terminez le point de rupture sur le dernier bloc inchangé. Ajoutez des références utiles lorsqu’elles aident la tâche ; n’alourdissez pas chaque requête juste pour viser une métrique de cache.
Si les jetons mis en cache restent à zéro
Vérifiez l’éligibilité avant de modifier le prompt : confirmez le modèle exact, l’endpoint, la longueur minimale de jetons et les paramètres de contrôle de cache requis. Envoyez ensuite deux requêtes séquentielles avec un contenu partagé identique. Inspectez séparément la création de cache et les lectures de cache ; la première requête peut créer l’entrée qu’une requête ultérieure pourra réutiliser. Un cache implicite est éligible à un hit, pas garanti de le produire.
Pour Claude, une requête sous le minimum peut renvoyer zéro jeton de création et de lecture du cache sans erreur. Son entrée de cache devient disponible une fois que la première réponse commence. Le guide de mise en cache de Claude explique aussi comment le placement du point de rupture et les changements de paramètres de requête affectent la réutilisation.
Si les hits disparaissent entre deux requêtes
Comparez les charges utiles réelles, pas seulement le modèle de prompt. Recherchez un texte de document modifié, des outils réordonnés, des schémas altérés, des premiers tours de conversation réécrits, ou des champs dynamiques insérés avant la frontière réutilisable. Vérifiez le temps écoulé depuis la requête précédente et si la durée choisie le couvre. Changez une variable à la fois et enregistrez l’usage résultant.
Si les hits ne produisent pas d’économies
Distinguez l’entrée mise en cache, les écritures, l’entrée non mise en cache, la sortie et les éventuels frais de stockage. Des écritures répétées après des périodes d’inactivité, une faible réutilisation ou des réponses longues peuvent annuler les remises sur l’entrée. Utilisez le calcul de coût ci-dessus avec l’usage mesuré et les tarifs réels de facturation de l’endpoint. Conservez une optimisation seulement si elle améliore le coût total de la tâche ou la latence visible par l’utilisateur.
Vérifier la prise en charge de l’endpoint et les frontières de données
Un endpoint de compatibilité peut accepter une requête sans exposer les mêmes contrôles de cache ni les mêmes champs d’usage que l’API native. Confirmez la prise en charge des paramètres et comparez l’usage retourné avec la facturation du compte avant de considérer la réutilisation comme une économie. Maintenez l’isolation des tenants et les contrôles d’accès, et respectez les politiques de rétention et de traitement des données du fournisseur. La mise en cache ne remplace pas ces contrôles.
Comment utiliser la mise en cache du prompt avec CometAPI ?
CometAPI propose un point d’intégration unique pour tester des requêtes à travers des familles de modèles. Pour la mise en cache, vérifiez quels contrôles spécifiques au fournisseur l’endpoint choisi accepte et comment l’entrée mise en cache apparaît dans l’usage et la facturation. Les développeurs peuvent centraliser les tests de modèles tout en conservant une validation séparée du comportement de cache et de la comptabilité, car les options natives du fournisseur ne sont pas garanties identiques via un proxy ou un endpoint de compatibilité.
Pour une configuration spécifique au modèle, consultez les pages CometAPI pour GPT-6.1 Sol, Claude Opus 5.5 et Gemini 4 Argon. Confirmez que l’endpoint choisi prend en charge le comportement de cache dont vous avez besoin.
Installez le SDK openai et définissez COMETAPI_KEY. Cet exemple envoie des requêtes avec préfixe répété via l’interface Chat Completions compatible OpenAI de CometAPI. Confirmez la disponibilité du modèle, puis inspectez l’usage retourné et la facturation du compte pour trouver des preuves de réutilisation du cache. Ne copiez pas les paramètres de cache de la Responses API dans cet endpoint sans vérifier la prise en charge.
import os
from pathlib import Path
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Résumez l’architecture.", "Identifiez les principaux risques techniques."]:
    response = client.chat.completions.create(
        model="gpt-6.1-sol",
        messages=[
            {"role": "system", "content": shared},
            {"role": "user", "content": question},
        ],
    )
    print(response.choices[0].message.content)
    print(response.usage)
Conclusion
Pour les applications d’IA à forte répétition, la mise en cache du prompt peut faire une différence matérielle dans l’économie d’inférence. OpenAI offre aux développeurs des contrôles de prompt et de rétention de plus en plus détaillés ; Claude propose des contrôles pratiques automatiques et au niveau des blocs ; Gemini rend la réutilisation implicite simple sur ses modèles modernes. La bonne implémentation dépend du volume de prompt stable, du taux de hits, de l’expiration et du coût total. Commencez par un préfixe partagé clair, vérifiez la télémétrie d’usage, puis optimisez la rétention et le choix du fournisseur en vous appuyant sur des mesures proches de la production.
FAQ
Comment comparer équitablement les fournisseurs de cache ?
Rejouez les mêmes documents sources utiles et des questions équivalentes, mais utilisez les propres décomptes de jetons de chaque fournisseur et leurs tarifs réels de facturation. Gardez des exigences de sortie comparables et rapportez les requêtes infructueuses autant que celles réussies. Un nombre fixe de caractères n’implique pas le même nombre de jetons ; comparez le coût par tâche terminée en parallèle des mesures de hits de cache.
Dois-je mettre en cache chaque document dans une base de connaissance changeante ?
Regroupez les documents selon leur fréquence de mise à jour et de réutilisation. Un document fréquemment mis à jour peut invalider à répétition un grand préfixe partagé ; placer d’abord la matière de politique stable et plus tard la matière changeante peut réduire cette exposition. Versionnez la source de manière délibérée et actualisez-la lorsque la justesse l’exige, même si cela réduit la réutilisation du cache.