
TL;DR
Tencent Hunyuan a présenté Hyra 2.0 le 2 novembre 2026 comme un Harness de recherche pour développer des modèles scientifiques, des outils logiciels et des workflows réutilisables. Sa caractéristique déterminante est la coordination persistante sur des expériences de plusieurs jours ou semaines.
La publication publique consiste actuellement en artefacts de recherche sélectionnés—modèles, code, poids et rapports—plutôt qu’un service Hyra 2.0 hébergé et généralement disponible. Au 4 novembre 2026, les documents publics de Tencent ne décrivent pas d’API d’orchestration générique ni de plan d’abonnement.
Principaux enseignements
- Objectif de recherche : Hyra 2.0 développe des modèles et des outils scientifiques réutilisables pouvant soutenir plus d’un projet de recherche.
- Coordination persistante : Overall, Mission et Worker se répartissent les responsabilités, tandis que des files d’attente et des registres de recherche conservent l’avancement sur de longues expériences.
- Connaissances réutilisables : La mémoire des agents, les Books et les compétences de recherche conservent les découvertes avec leurs preuves et conditions d’utilisation.
- Résultats spécifiques aux tâches : Les modèles publiés de protéines, de champs de force et de cellules répondent à des charges scientifiques différentes ; vitesse et qualité doivent être évaluées conjointement.
- Accès pratique : Commencez avec les artefacts de recherche disponibles. Le Harness Hyra complet et les API de modèles Hunyuan hébergées sont des offres distinctes.
Qu’est-ce que Tencent Hunyuan Hyra 2.0 ?
Hyra 2.0 signifie Hunyuan Research Agent 2.0, un système multi-agents conçu pour automatiser des workflows complexes de recherche scientifique et d’ingénierie.
Tencent présente Hyra 2.0 comme un passage de la résolution de problèmes isolés vers le développement de modèles, méthodes et infrastructures utilisés pour explorer une classe plus large de questions.
Hyra 2.0 n’est pas un modèle de fondation autonome avec un nombre de paramètres ou une fenêtre de contexte fixes. C’est un système d’orchestration qui peut utiliser différents modèles d’IA, exécuter du code, gérer des expériences scientifiques et coordonner des agents de recherche spécialisés.
La recherche scientifique requiert plus que du raisonnement. Un projet complet peut nécessiter la conception d’expériences, l’implémentation, l’entraînement, le débogage, l’évaluation et des révisions répétées. Ces activités peuvent s’étendre sur plusieurs jours ou semaines, impliquant souvent des expériences parallèles et des ressources de calcul partagées.
Hyra 2.0 répond à ce défi opérationnel en combinant intelligence de modèle, exécution persistante, collaboration structurée et vérification fondée sur des preuves.
Spécifications techniques de Hyra 2.0
Les spécifications du système décrivent ses capacités d’orchestration et de recherche. Les modèles scientifiques individuels créés par Hyra 2.0 ont des architectures, des nombres de paramètres et des benchmarks de performance distincts.
Pourquoi Hyra 2.0 construit des outils
Le passage de Hyra 1.0 à Hyra 2.0 répond à une limitation fondamentale de la recherche automatisée : résoudre avec succès un problème ne renforce pas nécessairement la capacité du système à résoudre le suivant.
Hyra 1.0 utilisait une boucle d’agent relativement simple pour générer des solutions, exécuter des évaluations et améliorer les résultats par tentatives répétées. Propulsé par le modèle open source Hy3 de Tencent, Hyra 1.0 a contribué à fixer l’exposant optimal reliant ensembles-somme et ensembles-différence, avec une preuve vérifiée par machine publiée avec le résultat. La distinction est importante : un résultat mathématique évalué est une sortie concrète, tandis qu’une amélioration du processus de recherche peut être réutilisée sur des problèmes ultérieurs.
Le prochain défi est de faire s’accumuler les progrès de recherche.
Des réponses aux capacités réutilisables
Considérez trois niveaux d’automatisation mathématique :
- Un agent résout un problème mathématique individuel.
- Un agent développe un workflow de preuve pouvant résoudre des problèmes similaires.
- Un agent améliore les modèles de raisonnement et les outils de vérification utilisés par les systèmes de recherche futurs.
Le premier produit une réponse. Le second produit une méthode réutilisable. Le troisième peut améliorer la capacité de recherche sous-jacente elle-même.
Hyra 2.0 cible les deuxième et troisième niveaux.
Tencent décrit deux grandes catégories d’outils réutilisables. Les outils symboliques expriment des capacités via du code, des algorithmes, des règles et des workflows. Exemples : systèmes de vérification automatisés, algorithmes de recherche scientifique et pipelines de gestion d’expériences. Les outils paramétriques stockent des capacités apprises dans des poids de modèle, incluant des modèles de conception de protéines et des modèles de fondation scientifiques.
Améliorer l’une ou l’autre catégorie peut bénéficier à plusieurs tâches aval sans exiger que chaque projet de recherche recommence depuis le même point de départ.
La direction vers l’auto-amélioration récursive
Hyra 2.0 crée aussi une trajectoire vers l’auto-amélioration récursive. La recherche sur les modèles de fondation dépend d’infrastructures d’entraînement, de pipelines de données synthétiques, d’algorithmes d’optimisation et de systèmes d’inférence.
Si des agents d’IA améliorent ces outils, ils peuvent aider à développer des modèles plus puissants. Ces modèles plus puissants peuvent ensuite participer aux cycles suivants de développement d’outils.
De meilleurs outils de recherche → des modèles d’IA plus performants → des agents de recherche plus capables → de meilleurs outils de recherche.
Tencent décrit l’application de Hyra à l’infrastructure de préentraînement, à la génération de données post-entraînement et à l’optimisation de l’inférence. Cela crée une boucle de rétroaction plausible entre développement d’outils et développement de modèles. Cela n’établit pas en soi une amélioration récursive illimitée ou pleinement autonome ; chaque gain proposé nécessite encore une expérience isolant son effet.
Comment fonctionne l’architecture du Harness Hyra 2.0 ?
Le Harness est l’innovation d’ingénierie centrale de Hyra 2.0. Une boucle d’agent classique peut exécuter des outils, inspecter des résultats et poursuivre le raisonnement dans une session. Le développement de modèles scientifiques requiert un environnement d’exécution plus sophistiqué.
Les expériences peuvent durer des heures, les tâches d’entraînement des jours, et des directions de recherche distinctes peuvent nécessiter différentes ressources de calcul et méthodes de validation. Hyra 2.0 répond à ces exigences via trois couches d’agents, un ordonnancement de tâches persistant, des enregistrements de recherche structurés et une vérification indépendante.
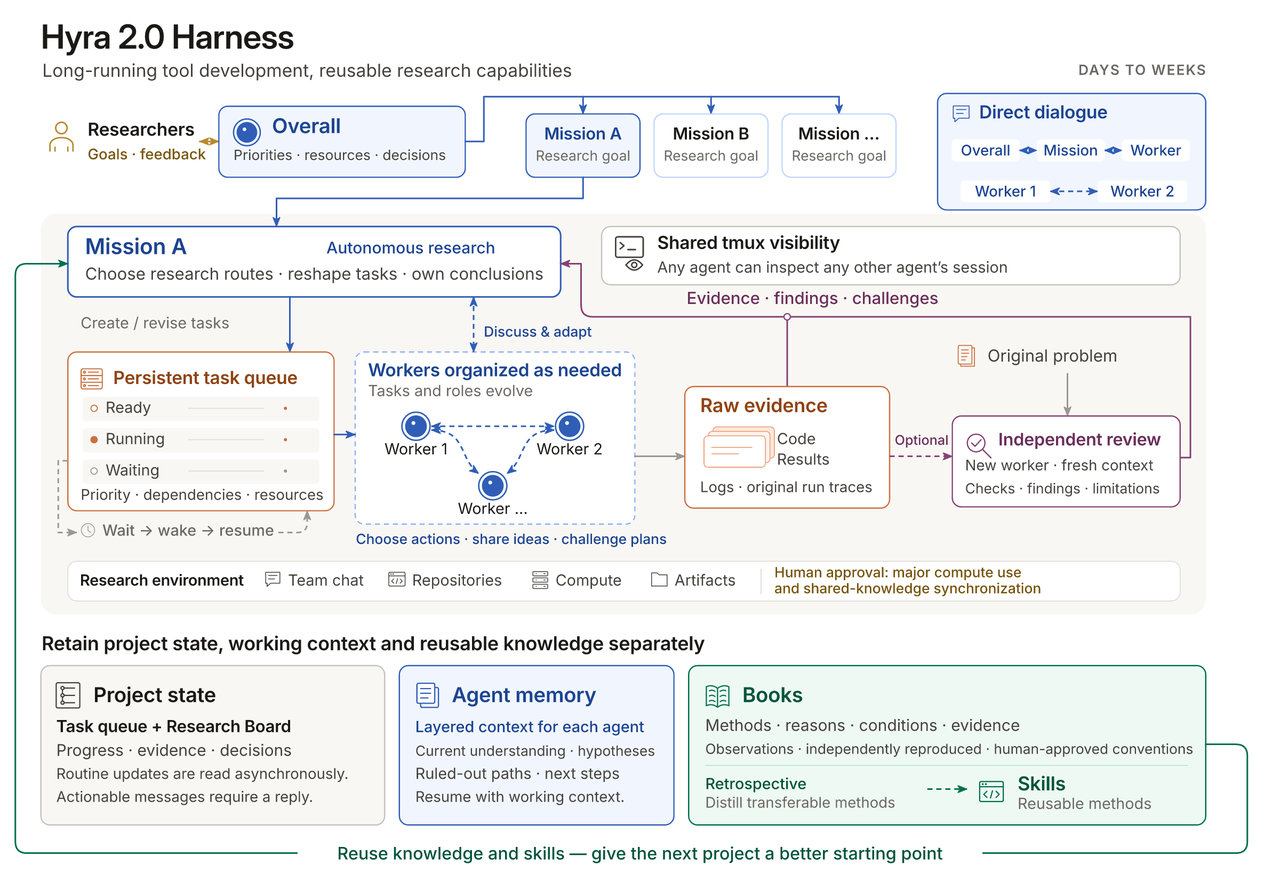
Le diagramme d’architecture officiel Hyra 2.0 de Tencent Hunyuan montre la hiérarchie, la file de travaux persistante, le processus de revue et des magasins séparés pour l’état du projet, la mémoire des agents et la connaissance partagée.
Overall : coordination de la recherche et gestion des ressources
Overall est la couche de coordination la plus élevée. Elle communique avec les chercheurs humains, maintient l’alignement avec les objectifs de recherche, gère les priorités et coordonne les ressources de calcul.
Ses responsabilités incluent la détermination des projets qui doivent recevoir des ressources supplémentaires et l’identification des décisions nécessitant une approbation humaine. Overall fonctionne ainsi comme la couche de coordination entre activités de recherche autonomes et gestion de recherche humaine.
Mission : planification de recherche à long terme
Chaque Mission est responsable d’un problème de recherche particulier. Une Mission maintient la direction de recherche à travers plusieurs expériences, organise les Workers, interprète les résultats et décide si une hypothèse mérite une investigation plus approfondie.
Elle détermine aussi quand une approche de recherche doit être révisée ou abandonnée. Cela crée une continuité sur un projet de longue durée sans exiger qu’une session d’agent conserve chaque action intermédiaire.
Worker : exécution d’expériences et exploration indépendante
Les Workers réalisent des tâches de recherche spécialisées. Leurs responsabilités incluent la lecture de code, l’implémentation d’algorithmes, l’exécution d’expériences, le diagnostic de pannes et la proposition d’approches alternatives.
Les Workers peuvent contester les décisions d’une Mission, et différents Workers peuvent utiliser différents modèles d’IA sous-jacents. Cette structure prend en charge l’exploration parallèle et réduit la dépendance à la trajectoire de raisonnement d’un seul agent.
Ordonnancement persistant et Research Board
Hyra 2.0 place les tâches de recherche dans une file persistante. L’ordonnanceur considère la priorité des tâches, leurs dépendances et les ressources disponibles lors du lancement des Workers.
Quand une expérience attend des résultats d’entraînement ou une approbation humaine, d’autres tâches peuvent continuer. Les agents peuvent aussi planifier leur prochaine activation après la fin d’une expérience.
Le Research Board enregistre hypothèses, constatations, preuves et décisions majeures. Cela sépare l’état persistant du projet de recherche des conversations individuelles des agents.
Vérification indépendante et approbation humaine
Les conclusions des Workers doivent être étayées par des preuves expérimentales, telles que des versions de code, journaux d’exécution, résultats d’évaluation ou traces originales.
Quand un résultat requiert un examen supplémentaire, un Review Worker séparé peut inspecter indépendamment le problème d’origine et les preuves. Ce processus aide à identifier des conclusions non étayées et des erreurs d’implémentation avant qu’elles n’influencent les recherches ultérieures.
Les opérations de calcul à coût élevé et les changements à la connaissance partagée de l’équipe restent soumis à approbation humaine. L’architecture combine donc une exécution autonome avec des points de contrôle explicites pour les décisions conséquentes.
Books : transformer l’expérience de recherche en compétences
Hyra 2.0 sépare l’information en trois catégories de stockage :
- État du projet : files de tâches, registres de collaboration et avancement de la recherche.
- Mémoire des agents : compréhension actuelle, hypothèses, approches rejetées et plans futurs.
- Books : connaissances réutilisables partagées entre projets de recherche.
Books catégorise l’information en observations, constatations vérifiées et conventions. Une seule expérience peut produire une observation. Des constatations reproduites indépendamment peuvent devenir des connaissances vérifiées. Les conventions affectant le comportement de l’équipe requièrent une confirmation humaine.
Lors des revues de projet, des méthodes réutilisables peuvent être converties en compétences. Une procédure de vérification numérique réussie ou une méthode de diagnostic d’instabilité d’entraînement peut devenir un composant réutilisable des futurs workflows de recherche.
Ce mécanisme permet au système de préserver des améliorations opérationnelles au-delà des sessions individuelles.
Quels résultats de recherche Hyra 2.0 a-t-il obtenus ?
Les premiers résultats de Hyra 2.0 couvrent des modèles scientifiques, la recherche mathématique, l’informatique quantique, la robotique, l’analyse unicellulaire et l’ingénierie matérielle.
Le dépôt de recherche officiel contient des implémentations sélectionnées, poids, rapports et artefacts de vérification. La synthèse ci-dessous récapitule les résultats rapportés par Tencent ; les sous-sections suivantes expliquent leurs conditions de test et leur disponibilité. Il s’agit de tâches scientifiques différentes, pas d’un classement unique de la capacité d’agent généraliste.
Ces résultats illustrent plusieurs types de production de recherche plutôt qu’un score d’agent généraliste unique.
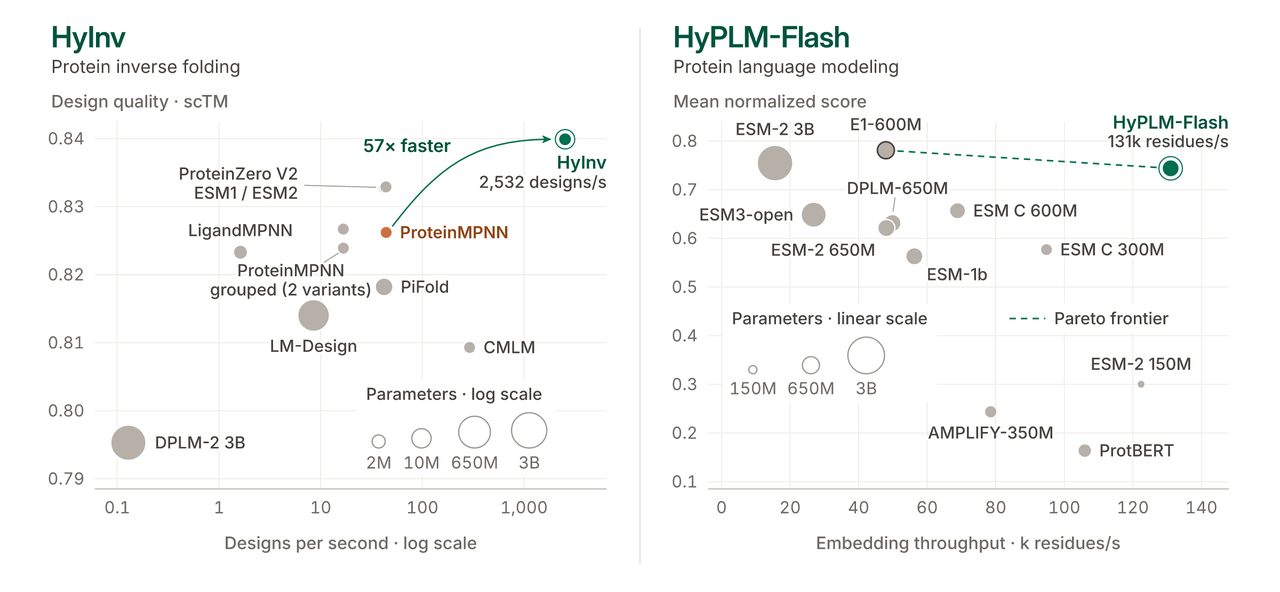
HyInv : inverse folding de protéines 57× plus rapide
HyInv génère des séquences protéiques pour une charpente cible. Son modèle à 1,96 M de paramètres fonctionnerait 57× plus vite que ProteinMPNN. Les 50,6 ms rapportés pour 128 conceptions utilisent une charpente de 402 résidus, un H20 et le BF16, en excluant la compilation et la capture de graphe CUDA. Considérez cela comme une vitesse de génération à chaud ; le filtrage structurel contribue encore au cycle complet de conception.
HyPLM-Flash : modélisation linguistique de protéines à haut débit
HyPLM-Flash est un modèle linguistique de protéines de 650 M de paramètres entraîné sur 726 B de tokens. Dans l’évaluation publiée à 28 checkpoints et 32 tâches, son score ProteinGym était statistiquement à égalité avec des encodeurs comparables. L’inférence INT8 atteint environ 130 000 résidus/s sur un H20 ; le BF16 est préférable lorsque de petites différences de représentation affectent les analyses aval. La figure de lancement ci-dessous utilise un périmètre d’évaluation différent.
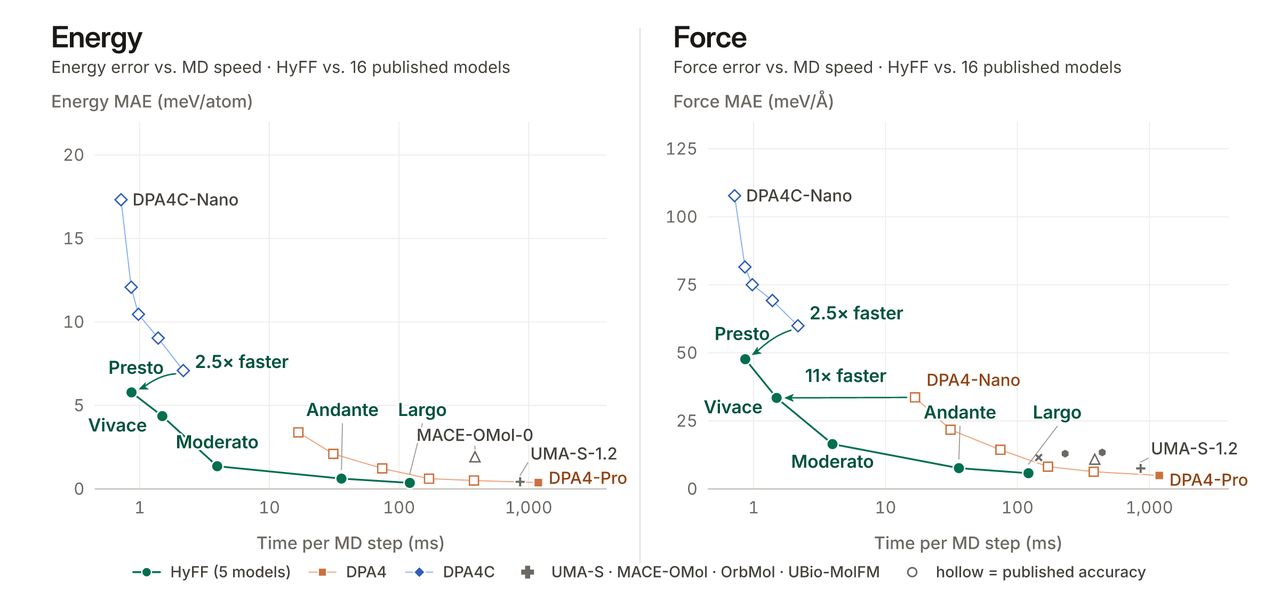
HyFF : simulation moléculaire plus rapide avec cinq tailles de modèle
HyFF prédit les énergies moléculaires et les forces atomiques, avec cinq tailles de modèle allant de 2,3 M à 1,2 B de paramètres. Sur la comparaison OMol25 rapportée, Andante combine une erreur de force similaire à UMA-S-1.2 (7,65 contre 7,55 meV/Å) avec une dynamique moléculaire 29× plus rapide. Largo rapporte une erreur d’énergie inférieure à DPA4-Pro (0,364 contre 0,380 meV/atome) et une vitesse 9,7× plus élevée. Choisissez une taille en testant à la fois précision et temps d’exécution sur les molécules que vous comptez simuler.
HyCell : un modèle d’embedding unicellulaire
HyCell mappe des comptages d’expression génique de cellules humaines vers des embeddings de 512 dimensions avec un modèle de 16,1 M de paramètres. Sur sept atlas cellulaires tenus à l’écart, son score composite est de 0,735, proche des 0,736 de Stack. Ce score combine conservation biologique, correction de lot et transfert d’annotation ; ce n’est pas une précision de classification. Vérifiez les métriques composantes pertinentes pour votre étude.
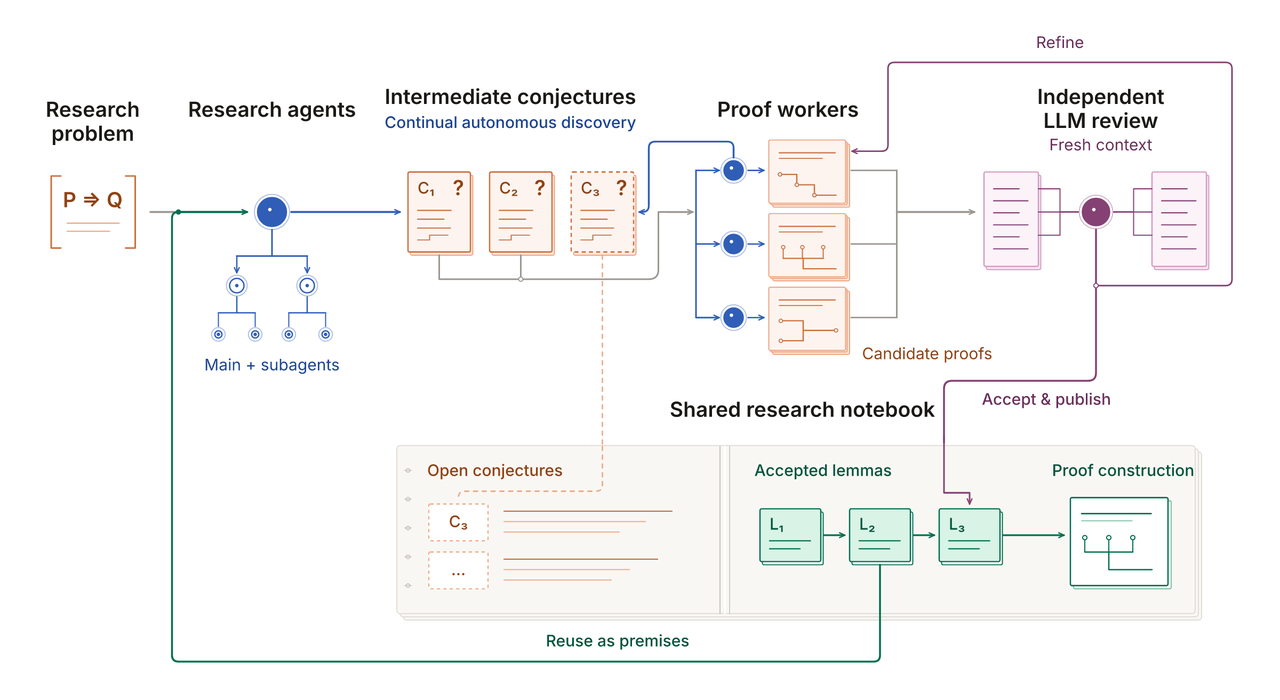
HyProver : workflows réutilisables pour la recherche mathématique
HyProver organise le travail mathématique en exploration, développement de preuve et revue. Ses résultats rapportés établissent le cas en dimension cinq de la conjecture des ensembles équilatéraux de Petty et donnent un contre-exemple à la forme non restreinte de la conjecture d’action du cercle de Yau. Ces résultats ont des limites spécifiques : la conjecture de Petty n’est pas tranchée dans toutes les dimensions, et la formulation simplement connexe de Yau reste ouverte.
HyQEC : une amélioration de 48 % de l’efficacité de code quantique
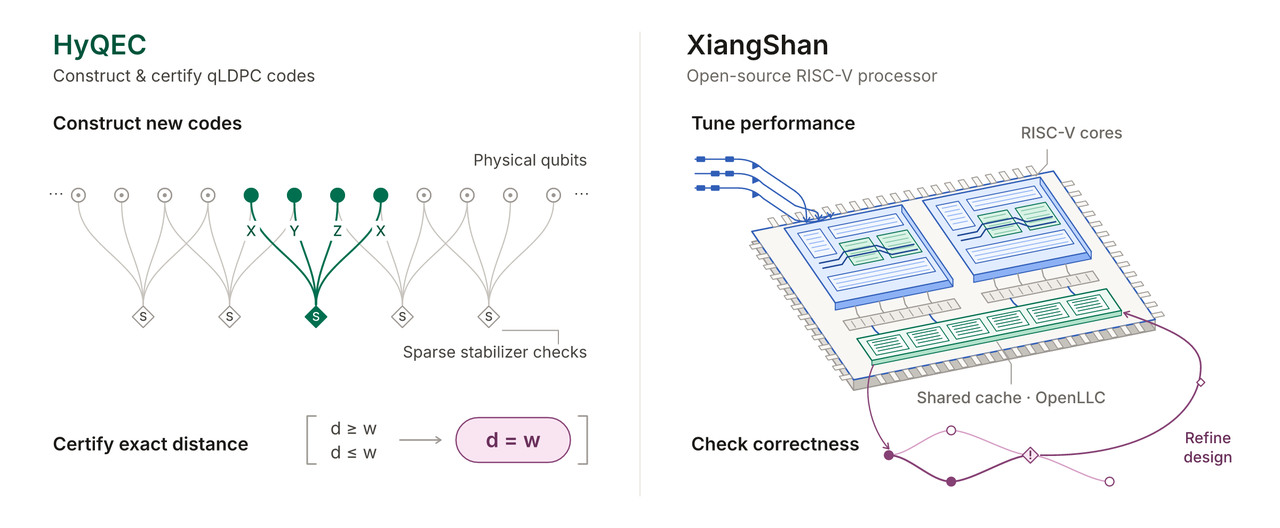
HyQEC recherche des codes de correction d’erreurs quantiques et vérifie leurs distances. Tencent rapporte une construction [[488,123,22]] avec une métrique d’efficacité kd²/n de 122,0, environ 48 % au-dessus du précédent leader du défi dans les contraintes indiquées. Cela mesure l’efficacité du code, pas la performance du matériel quantique. Au 5 novembre 2026, la publication officielle inclut les outils hyqec-verify et hyqec-check, mais répertorie encore le fichier de code et le certificat de cette construction particulière comme preuves à publier. Des outils publics et des preuves publiquement reproductibles pour un résultat spécifique sont des jalons distincts.
Spiral Hand : morphologie robotique conçue par IA
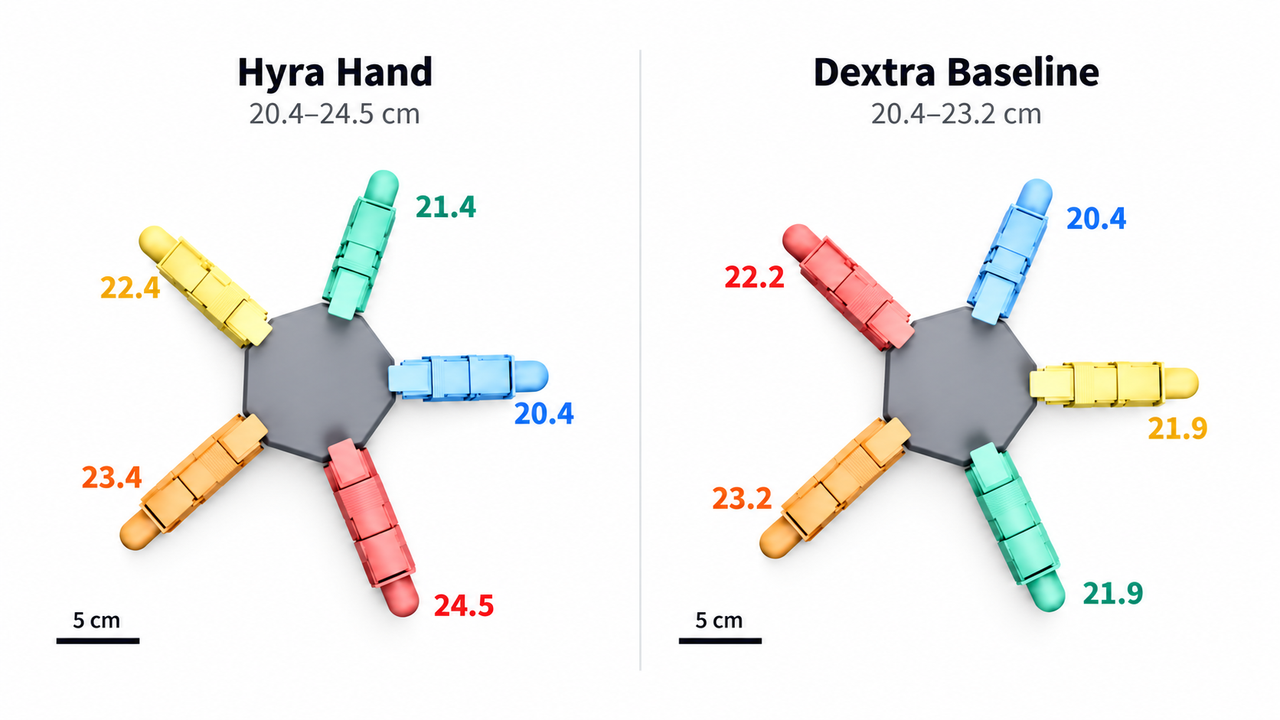
La Spiral Staircase Hand de Hyra utilise des doigts progressivement plus longs autour de la paume. Tencent rapporte une rotation d’objet 28,6 % plus rapide et 21 % de cibles complétées en plus que la base Dextra en simulation DR5 après des budgets d’affinage de politique égaux. La validation sur matériel physique reste à réaliser.
XiangShan : optimisation de processeur et vérification formelle
Pour le processeur RISC-V XiangShan, Tencent rapporte une amélioration de 5,79 % du score SPEC CPU2006 par GHz, une fréquence de cœur inchangée et une augmentation de surface de 0,3 %. Le travail a également trouvé dix bogues auparavant non signalés et un contre-exemple de cohérence de cache. Ces résultats s’appliquent au design et aux charges évalués, plutôt qu’à tous les systèmes RISC-V.
Comment les chercheurs doivent-ils interpréter les benchmarks de Hyra 2.0 ?
Lisez chaque benchmark dans sa propre charge de travail. Comparez les mêmes entrées, matériel, précision et frontière de chronométrage, puis évaluez la qualité de sortie en parallèle du temps d’exécution. Pour les affirmations scientifiques, inspectez le code, les données, la preuve ou le certificat à l’appui : un résultat rapporté et un résultat reproduit indépendamment fournissent des niveaux de preuve différents.
Les développeurs peuvent-ils utiliser Hyra 2.0 via une API ?
Au 4 novembre 2026, les documents publics Hyra décrivent des résultats de recherche et des publications sélectionnées. Ils ne documentent pas une API d’orchestration Hyra 2.0 généralement disponible, un prix d’abonnement, ni un package de déploiement complet. Une annonce de recherche et des artefacts téléchargeables doivent donc être distingués d’un accès hébergé au système complet.
Les documents disponibles se concentrent sur des résultats de recherche et des artefacts sélectionnés. Les développeurs peuvent accéder à certains modèles créés via Hyra, notamment HyInv, HyPLM-Flash, HyFF et HyCell, via les dépôts de recherche associés.
Le Harness Hyra 2.0 complet doit être distingué de ces sorties téléchargeables.
Hyra 2.0 et API Hunyuan hébergées
Les développeurs peuvent accéder à Tencent Hy4 via CometAPI en utilisant l’identifiant de modèle hy4. Cela fournit une inférence de modèle hébergée pour des applications telles que le codage, l’analyse et les workflows d’agents. Cela ne fournit pas le Harness de recherche Hyra 2.0 complet ; les modèles scientifiques développés via Hyra sont disponibles séparément via les dépôts de recherche de Tencent.
Qu’est-ce qui rendrait Hyra 2.0 utile dans une équipe de recherche ?
Commencez avec un artefact publié et une petite charge de référence. Une fois celui-ci exécuté avec succès, testez des données locales représentatives avec un seuil de qualité fixé et un budget de calcul. Conservez ensemble la révision du dépôt, les poids, l’environnement, les entrées et les sorties pour que des collègues puissent reproduire le résultat. Ajoutez une coordination multi-agents persistante lorsque des attentes longues, des expériences dépendantes ou des hypothèses concurrentes la rendent utile.
Conclusion
Hyra 2.0 réunit planification de recherche, exécution d’expériences et connaissance réutilisable dans un workflow persistant. Ses sorties scientifiques sont des points de départ prometteurs pour des travaux ultérieurs. Pour une équipe de recherche, le test pratique est de savoir si un artefact publié améliore une expérience réelle et produit des preuves que d’autres peuvent inspecter et reproduire.
FAQ
Comment un laboratoire doit-il budgéter son premier essai d’artefact Hyra ?
Budgétez trois étapes : mise en place d’un environnement reproductible, exécution d’un petit cas de référence et évaluation d’une charge locale représentative. Incluez le temps de préparation et de revue ainsi que l’utilisation d’accélérateurs. Choisissez un critère d’acceptation avant de commencer, comme maintenir un niveau de qualité requis tout en réduisant le délai d’exécution. Un essai initial doit être suffisamment petit pour diagnostiquer les échecs sans engager les ressources nécessaires à une campagne de recherche complète.
Que doit contenir un paquet de reproductibilité ?
Conservez ensemble la révision du dépôt, les identifiants des poids de modèle, les versions d’environnement, la provenance des données d’entrée, la configuration, les graines aléatoires lorsque pertinent, et les sorties d’évaluation. Enregistrez toute modification de l’exemple publié. Lorsqu’un résultat repose sur une preuve ou un certificat, préservez la version du vérificateur et sa sortie également. Le paquet doit permettre à un autre chercheur de distinguer un problème logiciel, une entrée modifiée et une différence véritable du résultat scientifique.
Comment les chercheurs peuvent-ils éviter la contamination des benchmarks ?
Séparez les données utilisées pour choisir des modèles ou régler des paramètres des données utilisées pour l’évaluation finale. Geler le protocole final avant de comparer des candidats, et documenter tout recouvrement avec des données de préentraînement ou de développement pouvant être établi. Pour de nouveaux jeux de données scientifiques, utilisez des partitions reflétant le contexte de déploiement prévu, comme une étude tenue à l’écart ou une condition expérimentale. Un score élevé est moins informatif si les exemples d’évaluation ont à plusieurs reprises façonné le système testé.
Comment les équipes doivent-elles gérer des conclusions d’agents contradictoires ?
Comparez les expériences sous-jacentes plutôt que de combiner les conclusions par vote majoritaire. Vérifiez si les agents utilisaient la même version de jeu de données, les mêmes hypothèses, métriques et configurations logicielles. Conservez les deux constatations jusqu’à ce que la différence soit expliquée, puis exécutez une expérience ciblée qui discrimine entre les explications concurrentes. L’accord entre agents est utile, mais il ne remplace pas des mesures externes ni un argument vérifiable.
Quand un workflow de recherche plus simple est-il préférable ?
Une tâche courte, déterministe, avec un script mature et un évaluateur clair, peut ne pas bénéficier d’une coordination multi-agents persistante. L’ordonnancement, la tenue de registres et la revue ajoutés peuvent coûter plus qu’ils n’apportent. Introduisez l’orchestration lorsque les expériences ont des dépendances significatives, de longues attentes, plusieurs hypothèses concurrentes, ou des sorties réutilisables nécessitant une maintenance continue. La décision doit suivre la structure de la charge de travail et le coût de coordination observé.