Construire avec CometAPIBesoin d'une seule API pour plusieurs modèles ?Testez le workflow dans Playground, puis créez une clé API lorsque le modèle et le coût correspondent à votre cas d'usage.
Qu'est-ce que Gemini 4 Carbon ? Benchmarks, fonctionnalités & tarifs
Découvrez Gemini 4 Carbon, le nouveau modèle d’IA de pointe de Google. Explorez les benchmarks de cybersécurité, les fonctionnalités, les tarifs, les comparatifs et la disponibilité.
Deon GoodwinÉquipe de recherche sur les modèles IA et API
Gemini 4 Carbon est le modèle de pointe de Google DeepMind pour l’ingénierie exigeante et la cybersécurité défensive. Annoncé le 28 octobre 2026, il améliore Argon sur des évaluations publiées en code, sécurité et long contexte. Les tarifs de lancement sont de 2 $ par million de jetons d’entrée et de 10 $ par million de jetons de sortie, mais l’accès est d’abord limité à des défenseurs cyber sélectionnés et à des partenaires de confiance. Pour les développeurs, l’opportunité est un travail autonome plus robuste ; la contrainte immédiate est l’accès.
Points clés
Gemini 4 Carbon est le prochain modèle de pointe de Google après Argon, optimisé pour une ingénierie agentique soutenue sur plusieurs jours et la défense en cybersécurité.
Gemini 4 Carbon se classe n°1 sur l’Artificial Analysis Intelligence Index v5.0 (score 59), devant Claude Opus 5.5 (58) et GPT-6 Astra (57). Fortes progressions en codage, développement web full-stack (+89 Elo sur WebDev Arena à la 4e place), raisonnement scientifique, compréhension multimodale et alignement (0,0 % de réussite sur le Gray Swan Indirect Prompt Injection Benchmark).
Revu pour la clarté, l'attribution des sources et la terminologie API actuelle.
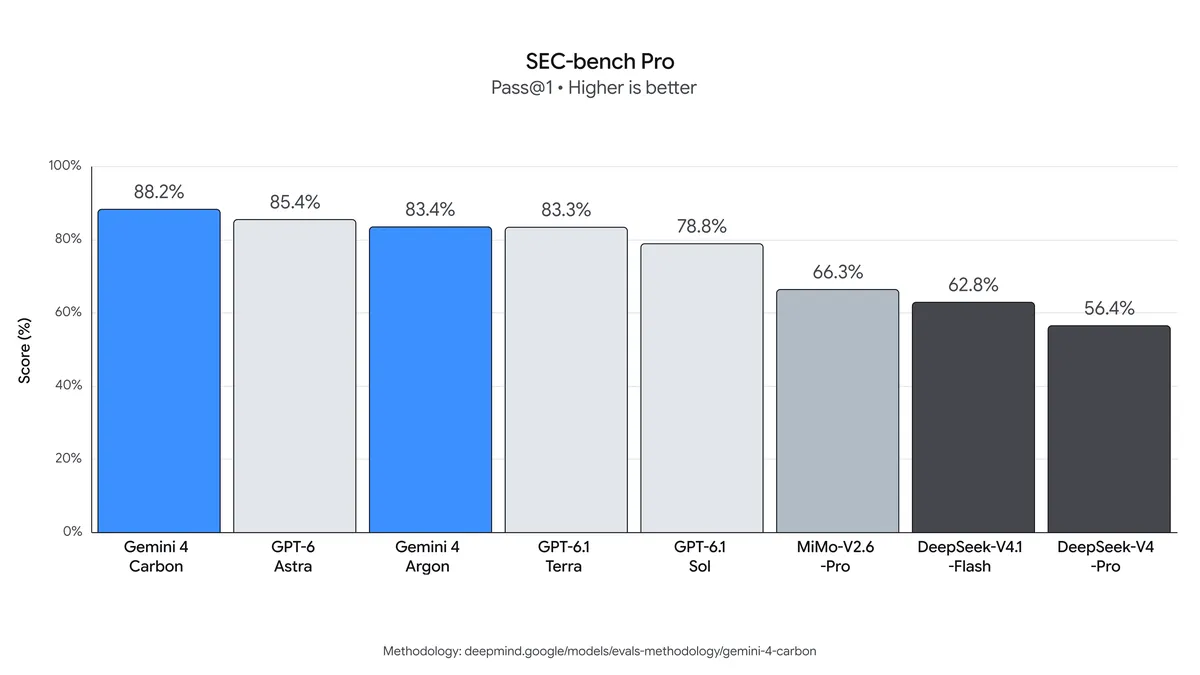
Scores de cybersécurité remarquables (sans garde-fous) : 88,2 % sur SEC-bench Pro (détection de vulnérabilités), 54,8 % sur ExploitGym (exploitation) et 71,0 % sur CWE-bench (correctifs).
Accès initial limité via le Fairwind Program pour les défenseurs cyber ; API publique et déploiement plus large à venir.
Même tarif de lancement qu’Argon ; après la période d’introduction, les tarifs standard s’appliquent.
Des plateformes comme CometAPI prennent déjà en charge la famille Gemini (dont Argon) via une API unifiée compatible OpenAI, ce qui facilite le changement de modèle et la préparation à la sortie élargie de Carbon. Les détails de l’API publique et une date de sortie large ne sont pas annoncés au 29 octobre 2026.
Qu’est-ce que Gemini 4 Carbon ?
Gemini 4 Carbon est le nouveau modèle phare de pointe de Google, conçu pour gérer l’ingénierie logicielle complexe, la recherche en cybersécurité et les workflows autonomes.
Selon l’annonce officielle, Carbon s’appuie sur la base posée par Gemini 4 Argon, avec des améliorations substantielles en codage, raisonnement agentique et tâches axées sur la sécurité.
Carbon est conçu pour un travail impliquant investigation, exécution et vérification en plusieurs étapes. Un agent d’ingénierie défensive peut inspecter un dépôt, valider une vulnérabilité présumée dans un environnement isolé, développer un correctif et tester si la modification corrige le défaut initial.
Google indique que ses équipes internes ont observé Carbon travailler sur des tâches d’ingénierie complexes sur plusieurs jours. Ce sont des observations internes, pas une garantie publiée d’un temps d’exécution autonome particulier. Google n’a pas publié de rapport technique complet, de nombre de paramètres ou de détails d’architecture. La fenêtre de contexte et les limites de sortie devraient être similaires ou meilleures que celles d’Argon (annoncées à l’échelle de plusieurs millions de jetons avec une grande capacité de sortie), et il prend en charge des entrées multimodales incluant texte, images, vidéo, audio et PDF.
Quelles sont les principales fonctionnalités de Gemini 4 Carbon ?
Ingénierie logicielle à long horizon
Carbon est conçu pour des problèmes d’ingénierie qui ne peuvent pas être résolus de manière fiable en une seule étape de raisonnement.
Exemples : analyse des causes profondes sur de grands dépôts, pannes liées aux dépendances, débogage de bas niveau des systèmes et refactorisations complexes.
Ses améliorations visent la capacité à poursuivre le travail après un premier essai infructueux.
Un agent de codage performant doit reconnaître quand sa première solution échoue, inspecter de nouvelles preuves et réviser son approche sans s’éloigner de la tâche initiale.
Flux de travail de cybersécurité défensive
Les résultats de sécurité de Carbon couvrent la détection de vulnérabilités, la validation de l’exploitabilité et la correction des défauts. La question utile pour une équipe de sécurité est de savoir si un agent peut passer d’un problème présumé à une constatation reproductible et à un correctif testé, tout en respectant les permissions et l’environnement qui lui sont assignés.
Compréhension en contexte long et multimodale
Carbon enregistre un score GraphWalks BFS F1 de 96,2 % sur le sous-ensemble 256K–1M jetons, contre 84,2 % pour Argon. C’est un élément de preuve concernant le raisonnement graphique en contexte long, plutôt qu’une garantie de récupération correcte depuis n’importe quel document d’un million de jetons.
Les résultats publiés sur Chartography et Blueprint-Bench 2 couvrent également la compréhension visuelle. Ces tests peuvent aider à identifier des workflows prometteurs pour documents et graphiques, mais ils n’établissent pas le schéma de modalités complet d’une future API publique.
Comment Gemini 4 Carbon se comporte-t-il sur les benchmarks ?
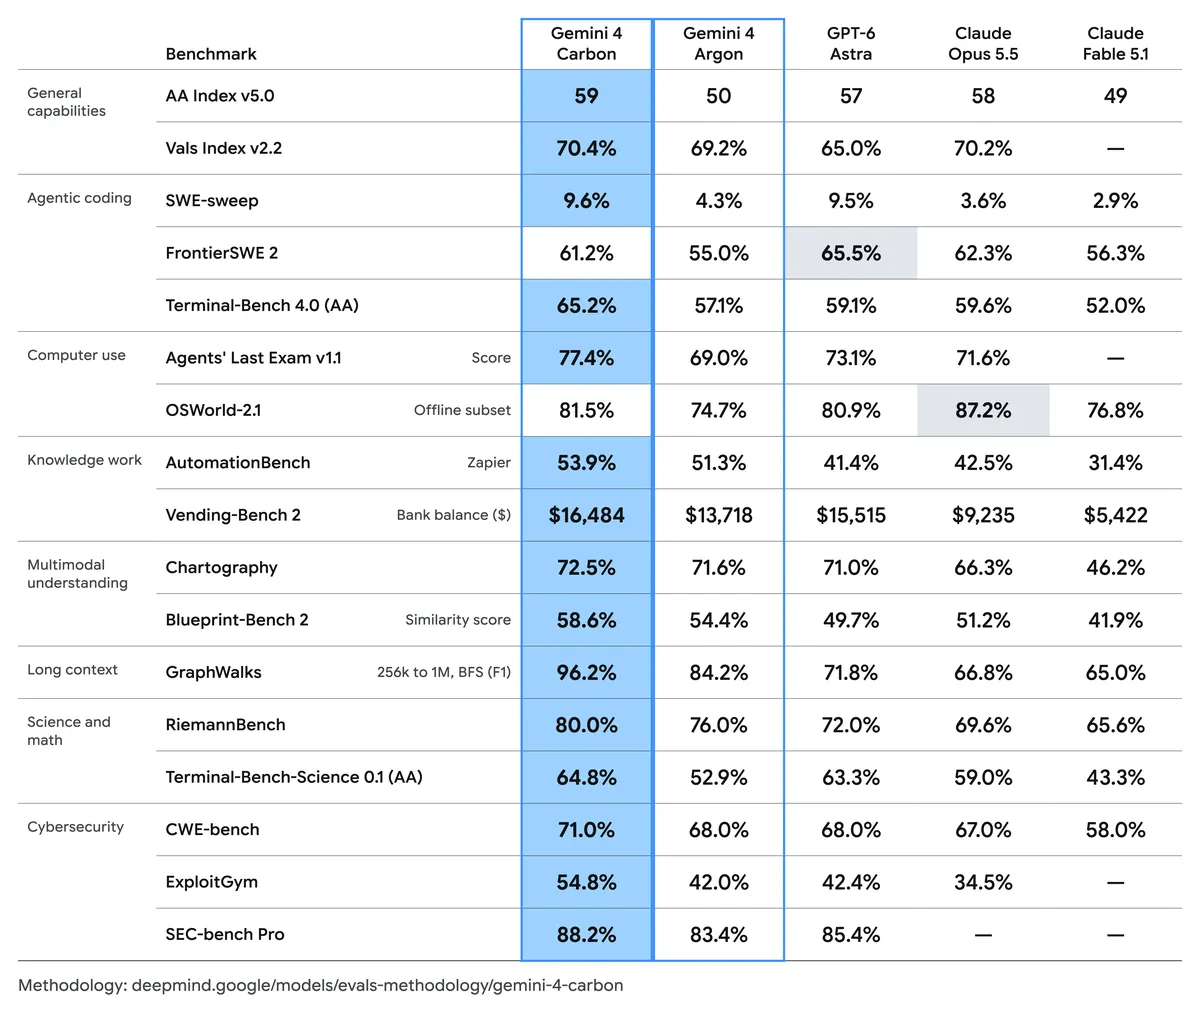
Les résultats publiés mettent en avant trois raisons d’évaluer Carbon : un codage plus performant, un meilleur raisonnement en contexte long et des améliorations sur l’ensemble du workflow de cybersécurité. L’annonce officielle inclut le graphique comparatif original ci-dessous ; les résultats clés sont résumés dans la section suivante.
Choisissez des benchmarks qui ressemblent à votre propre charge de travail. Un modèle qui mène un indice d’intelligence général peut rester derrière un autre modèle sur une tâche d’ingénierie particulière.
Résultats de benchmark et conditions de test
Raisonnement global : Carbon obtient 59 sur AA Intelligence Index v5.0, contre 50 pour Argon, 57 pour GPT-6 Astra et 58 pour Claude Opus 5.5.
Code : Terminal-Bench 4.0 passe de 57,1 % à 65,2 %, soit un gain de 8,1 points de pourcentage par rapport à Argon. SWE-sweep passe de 4,3 % à 9,6 %.
Raisonnement en contexte long : Carbon obtient 96,2 % sur le sous-ensemble GraphWalks 256K–1M jetons BFS F1, contre 84,2 % pour Argon.
Là où des alternatives sont en tête : GPT-6 Astra obtient 65,5 % sur FrontierSWE 2 contre 61,2 % pour Carbon ; Claude Opus 5.5 obtient 87,2 % sur le sous-ensemble hors ligne d’OSWorld, contre 81,5 % pour Carbon. Ces comparaisons se réfèrent aux modèles et aux paramètres d’évaluation du graphique publié.
Sur les 17 résultats sélectionnés de la comparaison originale, Carbon est en tête sur 15. Cette ampleur en fait un candidat prometteur pour des workflows complexes, mais les deux exceptions montrent pourquoi votre propre mix de tâches compte. Comparez les modèles sur les résultats acceptés, le temps de complétion et le coût plutôt que de faire la moyenne de scores de benchmarks sans rapport.
La méthodologie d’évaluation utilise généralement le niveau de réflexion le plus élevé et pass@1 sauf mention contraire. Elle combine des résultats exécutés par Google avec des évaluateurs externes et des scores rapportés par les fournisseurs, de sorte que l’échafaudage d’agent et les budgets de raisonnement ne sont pas identiques pour chaque entrée.
GraphWalks : Le sous-ensemble cité utilise 200 problèmes et rapporte BFS F1.
Agents’ Last Exam : L’évaluation utilise un jeu v1.1 de 122 tâches, le harnais ALE-Claw, une fenêtre de cinq heures et des filtres de sécurité activés.
OSWorld : Le résultat rapporté couvre un sous-ensemble hors ligne de 82 tâches et retient le maximum sur trois exécutions à tentative unique.
Performance de codage en pratique
Carbon améliore Terminal-Bench 4.0 de 57,1 % à 65,2 %, soit un gain de 8,1 points de pourcentage. SWE-sweep passe de 4,3 % à 9,6 %, plus que doublant le score tout en restant en dessous de 10 % en valeur absolue. Ces résultats soutiennent l’évaluation de travaux difficiles sur dépôt, tout en montrant pourquoi des tests indépendants et une revue demeurent nécessaires.
Quelle est la force de Gemini 4 Carbon en cybersécurité ?
Benchmark et tâche de cybersécurité
Gemini 4 Carbon
Gemini 4 Argon
Différence
SEC-bench Pro — découverte de vulnérabilités
88.2%
83.4%
+4.8 points de pourcentage
ExploitGym — validation d’exploit
54.8%
42.0%
+12.8 points de pourcentage
CWE-bench — remédiation de vulnérabilités
71.0%
68.0%
+3.0 points de pourcentage
Le gain le plus important concerne la validation d’exploit. Pour une équipe défensive autorisée, des preuves reproductibles qu’une vulnérabilité est exploitable peuvent améliorer la priorisation ; une constatation plausible ne suffit pas. Les correctifs doivent toujours être accompagnés de tests confirmant que le défaut initial est corrigé et que les fonctionnalités existantes sont préservées.
Google rapporte les évaluations de sécurité externes sans garde-fous de déploiement. SEC-bench Pro utilise une division spécifique de 183 tâches sur moteur JavaScript ; ExploitGym utilise une configuration hors ligne à tentative unique avec les mitigations désactivées. Ces conditions n’établissent pas le comportement de production sans restriction ni un taux de détection pour des logiciels réels arbitraires.
Gemini 4 Carbon est-il plus sûr et plus fiable qu’Argon ?
Les affirmations non étayées ont diminué d’environ 50 % par rapport à Argon dans les tests internes.
Le dépassement de périmètre par l’agent a diminué de 26 %.
La sous-prestation a diminué de 29 %.
Les alertes de désalignement de gravité élevée ont presque diminué de 80 % dans les environnements de codage internes.
La triche réussie sur Terminal-Bench 4.0 est tombée à 0,0 % dans l’évaluation de Google.
Sur le benchmark évalué d’indirect prompt-injection Gray Swan, le taux de réussite des attaques est de 0,0 % pour Carbon contre 0,7 % pour Argon. Cela signifie que les attaques évaluées n’ont pas réussi dans ce contexte ; cela n’établit pas une immunité à de nouvelles attaques ou à des environnements d’outils différents.
Ces chiffres proviennent d’évaluations différentes et ne doivent pas être combinés en un score de fiabilité unique.
Pour un agent en production, conservez des contrôles d’autorisations indépendants, des journaux d’exécution et une validation des résultats revendiqués. Le comportement amélioré d’un modèle aide, mais l’application doit toujours contrôler les fichiers, services et actions auxquels il peut accéder.
Combien coûte l’API Gemini 4 Carbon ?
Google a annoncé les tarifs de lancement et ultérieurs par jeton. Les chiffres d’entrée mise en cache ci-dessous sont calculés à partir de la remise annoncée de 95 % ; la mise en œuvre de l’API publique et les critères d’éligibilité restent à préciser.
Catégorie de facturation, USD par 1 M de jetons
Tarif de lancement
Tarif ultérieur
Jetons d’entrée
$2.00
$4.00
Jetons de sortie
$10.00
$20.00
Jetons d’entrée mis en cache éligibles
$0.10
$0.20
La période d’introduction de Carbon n’a pas de date de fin annoncée. L’offre de lancement publiée pour Argon se termine le 30 novembre 2026 ; cette échéance ne s’applique pas à Carbon. Les tarifs batch, frais d’outils additionnels et un palier gratuit n’ont pas été annoncés pour Carbon.
Exemple de coût de requête
Supposons qu’une requête utilise 200 000 jetons d’entrée non mis en cache et 10 000 jetons de sortie facturables au total. Aux tarifs de lancement annoncés, l’entrée coûte 0,40 $ et la sortie 0,10 $, pour un total de 0,50 $. La même consommation de jetons coûterait 1,00 $ aux tarifs ultérieurs.
Si les 200 000 jetons d’entrée sont tous éligibles à la remise annoncée pour entrée mise en cache, l’estimation de lancement devient 0,12 $ sortie incluse. Il s’agit d’une illustration conditionnelle, pas d’une promesse que chaque entrée répétée sera éligible.
L’allocation de sortie doit inclure tout jeton de réflexion facturé comme sortie selon les règles finales applicables. Si 10 000 se réfèrent seulement à la réponse visible, des jetons de réflexion facturables additionnels augmenteraient l’estimation. Les outils, nouvelles tentatives et autres services sont exclus.
Comment les développeurs peuvent-ils se préparer à l’API Gemini 4 Carbon ?
Disponibilité actuelle de l’API Gemini 4 Carbon
Au 29 octobre 2026, l’accès commence avec des défenseurs en cybersécurité sélectionnés et s’étend progressivement à des partenaires de confiance. Le Fairwind Program de Google décrit une voie d’accès contrôlée. Une date de sortie large pour les développeurs et un identifiant de modèle public pour Carbon n’ont pas été annoncés.
Les tarifs annoncés ne signifient donc pas qu’une application peut appeler aujourd’hui une API Carbon en disponibilité générale. Sa limite de contexte publique finale, sa sortie maximale, son schéma de modalités, la compatibilité des outils et les limites opérationnelles doivent encore faire l’objet de spécifications de production documentées.
Au 29 octobre 2026, Google n’a pas encore lancé d’API Carbon en disponibilité générale, donc Carbon n’est pas encore disponible via CometAPI. En attendant, vous pouvez utiliser Gemini 4 Argon pour une évaluation initiale. Consultez la page CometAPI Carbon pour la disponibilité et les tarifs du fournisseur lorsque l’accès s’ouvrira.
Alternatives en attendant l’API Carbon
Vous pouvez commencer à évaluer votre workflow de codage avant que Carbon ne devienne largement disponible. Établissez une base de référence avec un modèle accessible aujourd’hui, puis comparez Carbon sur les mêmes tâches lorsque son API s’ouvrira. Trois options à considérer sont Gemini 4 Argon, GPT-6.1 Astra et Claude Opus 5.5 ; confirmez le nom exact du modèle, l’accès et le prix auprès de votre fournisseur avant de choisir une voie.
Gemini 4 Argon: Commencez ici si vous utilisez déjà Gemini ou souhaitez une base directe pour Carbon. Essayez des changements représentatifs sur dépôt, des revues de code et des corrections de bugs, et enregistrez quelles sorties passent vos tests d’acceptation.
**GPT-6.1 Astra:** Incluez-le comme comparaison inter-fournisseurs pour les mêmes tâches d’ingénierie. Mesurez les correctifs acceptés, le temps de complétion et le coût total. Les résultats de GPT-6 Astra évoqués plus haut s’appliquent à cette version benchmarkée et ne doivent pas être considérés comme des scores de GPT-6.1 Astra.
**Claude Opus 5.5:** Ajoutez-le comme autre candidat pour l’analyse de dépôt, la refactorisation et la revue. Utilisez les mêmes descriptions de tâches et critères de validation afin de comparer la valeur pratique de chaque résultat.
Gardez votre sélection de modèle configurable et sauvegardez les invites, cas de test et résultats de chaque exécution. Cela vous donne un point de départ utile pour évaluer Carbon sans engager votre workflow sur un format d’API non annoncé.
Benchmark
Gemini 4 Carbon
Gemini 4 Argon
GPT-6 Astra
Claude Opus 5.5
AA Intelligence Index v5.0
59
50
57
58
Vals Index v2.2
70.4%
69.2%
65.0%
70.2%
SWE-sweep
9.6%
4.3%
9.5%
3.6%
FrontierSWE 2
61.2%
55.0%
65.5%
62.3%
Terminal-Bench 4.0 (AA)
65.2%
57.1%
59.1%
59.6%
Agents' Last Exam v1.1
77.4%
69.0%
73.1%
71.6%
OSWorld-2.1, sous-ensemble hors ligne
81.5%
74.7%
80.9%
87.2%
AutomationBench, Zapier
53.9%
51.3%
41.4%
42.5%
Préparer un workflow d’évaluation de modèle
Un cadre d’évaluation pratique doit mesurer plus que la qualité générale des réponses.
Pour les workflows de codage et de sécurité, des métriques utiles incluent :
Taux d’achèvement des tâches : à quelle fréquence l’agent satisfait-il des tests d’acceptation prédéfinis ?
Correction des correctifs : la modification proposée corrige-t-elle le défaut initial sans casser le comportement existant ?
Taux de faux positifs : à quelle fréquence un problème signalé échoue-t-il à la validation ?
Latence de bout en bout : combien de temps prend l’ensemble du workflow, exécution des outils incluse ?
Coût total par tâche : combien coûte chaque résultat accepté après nouvelles tentatives et usage d’outils ?
Conformité aux instructions : l’agent reste-t-il dans les fichiers, outils et actions autorisés ?
Utilisez un ensemble fixe de tâches réelles et conservez un enregistrement pour chaque modèle, ses paramètres, l’usage de jetons et les résultats de tests. Incluez les nouvelles tentatives et corrections manuelles dans le coût. Une fois Carbon disponible, exécutez la même évaluation pour voir s’il fournit plus de travail accepté pour votre temps et votre budget.
Conclusion
Gemini 4 Carbon est une mise à niveau prometteuse pour le codage exigeant, le raisonnement en contexte long et la sécurité défensive. Ses résultats publiés montrent des gains nets par rapport à Argon, tandis que l’accès initial reste limité au 29 octobre 2026. Pour l’instant, établissez une base avec un modèle disponible et gardez votre intégration flexible. Lorsque l’API publique de Carbon s’ouvrira, comparez la qualité du travail accompli, le temps gagné et le coût total avant de décider d’un basculement.
FAQ
Gemini 4 Carbon peut-il fonctionner sans supervision humaine ?
Les rapports de travaux d’ingénierie internes sur plusieurs jours n’établissent pas une fiabilité non supervisée pour des tâches arbitraires. Une équipe envisageant une exécution autonome doit définir les actions autorisées, les conditions d’arrêt et les tests d’acceptation, puis mesurer la fréquence à laquelle l’agent termine le travail sans correction. La durée d’exécution seule ne prouve pas que la sortie de l’agent est correcte.
Une intégration Argon existante peut-elle basculer directement vers Carbon ?
Pas au vu des éléments disponibles ici. Gardez le choix du fournisseur configurable, mais vérifiez l’identifiant réel du modèle Carbon, le schéma pris en charge, les outils, les limites et l’accès au compte avant de modifier un déploiement. Réutiliser une invite peut aider pour une comparaison contrôlée ; cela ne prouve pas la compatibilité d’API.
Quels tests de Gemini 4 Carbon sont pertinents pour un dépôt privé ?
Incluez des bugs représentatifs, des changements de dépôt et des constatations de sécurité avec des critères d’acceptation connus. Vérifiez si les correctifs passent les tests pertinents, si les constatations se reproduisent et s’il n’y a pas de changements de comportement non liés. Incluez les tentatives échouées et la correction manuelle dans l’analyse des coûts pour qu’un bon score public de benchmark ne masque pas le travail opérationnel.