
TL;DR
Claude Haiku 5.5 dan GPT-6 Luna adalah model penalaran berbiaya rendah untuk beban kerja API volume tinggi. Keduanya mulai dari $0,10 per satu juta token input dan $0,50 per satu juta token output. Haiku mencetak nilai lebih tinggi pada enam perbandingan yang dipublikasikan dalam materi peluncuran Anthropic. Luna mempertahankan tarif token dasar untuk prompt hingga 272K token input, dibanding ambang 100K milik Haiku. Bagi pengembang, metrik kunci adalah tingkat penerimaan, latensi ujung-ke-ujung, kompatibilitas API, dan biaya per hasil yang diterima—total biaya semua percobaan dibagi jumlah output yang lulus pemeriksaan yang telah ditentukan.
Poin Penting
- Haiku 5.5 memimpin perbandingan penggunaan komputer OSWorld 2.1 yang dikutip, 72,4% vs 48,9% milik Luna.
- Pada Terminal-Bench 4.0, hasil yang dikutip adalah 39,2% untuk Haiku dan 16,4% untuk Luna.
- Keduanya mulai pada harga konteks pendek yang identik, tetapi tier harga lebih tinggi Haiku dimulai di atas 100K token prompt, dibanding ambang 272K milik Luna.
- Halaman model max-effort Artificial Analysis, diperiksa 9 Oktober 2026, menunjukkan kecepatan output 240,6 token/det untuk Haiku dan 123,0 token/det untuk Luna; throughput tidak termasuk waktu tunggu token pertama.
- Mulailah dengan Haiku untuk tugas penggunaan komputer dan terminal yang tercermin dalam benchmark bersama; pertimbangkan Luna untuk prompt besar. Pertahankan model Anda saat ini sampai uji coba perwakilan menunjukkan peningkatan yang berguna.
Apa itu Claude Haiku 5.5 dan GPT-6 Luna?
Claude Haiku 5.5: Gambaran Umum
Claude Haiku 5.5 diluncurkan pada 7 Oktober 2026. Ia menggabungkan inferensi berbiaya rendah dengan penalaran yang dapat disesuaikan, penggunaan alat, konteks panjang, serta input teks dan gambar. Aplikasi tipikal meliputi ekstraksi dokumen, kueri basis data, dukungan pelanggan, dan subagen ringan.
GPT-6 Luna: Gambaran Umum
GPT-6 Luna diluncurkan pada 22 September 2026. Diposisikan untuk tugas terfokus dalam skala besar, termasuk klasifikasi, ekstraksi informasi, output terstruktur, bantuan pemrograman, dan pemrosesan dokumen panjang. Pengaturan penalarannya fleksibel, termasuk konfigurasi tanpa penalaran untuk pekerjaan yang lebih sederhana.
Spesifikasi
| Spesifikasi | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Pengembang | Anthropic | OpenAI |
| Rilis | 7 Oktober 2026 | 22 September 2026 |
| ID model | claude-haiku-5-5 | gpt-6-luna |
| Jendela konteks | 1.000.000 token | 1.050.000 token |
| Output maksimum (API standar) | 128.000 token | 128.000 token |
| Input | Teks dan gambar | Teks dan gambar |
| Output | Teks | Teks |
| Penalaran | Dapat disesuaikan, Rendah hingga Maks | None hingga Maks |
| Upaya bawaan | Medium | Medium |
| Batas pengetahuan | Juni 2026 | 18 Mei 2026 |
| Penggunaan alat | Ya | Ya |
| Output terstruktur | Ya | Ya |
| Bobot terbuka | Tidak | Tidak |
| Arsitektur dan jumlah parameter | Tidak ditentukan dalam materi resmi yang dikutip | Tidak ditentukan dalam materi resmi yang dikutip |
Spesifikasi menggunakan dokumentasi model API standar dari vendor, diperiksa 9 Oktober 2026: spesifikasi API standar Haiku dan spesifikasi API standar Luna. Arsitektur dan jumlah parameter tidak dicantumkan karena sumber ini tidak menetapkannya.
Claude Haiku 5.5 vs GPT-6 Luna: Hasil Benchmark
| Benchmark | Haiku 5.5 | GPT-6 Luna | Unggul |
|---|---|---|---|
| GDPval-AA v2.1 (Elo) | 1.620 | 1.437 | Haiku +183 |
| AA-Briefcase v1.1 (Elo) | 1.578 | 1.336 | Haiku +242 |
| OSWorld 2.1, skor parsial offline | 72,4% | 48,9% | Haiku +23,5 pp |
| Terminal-Bench 4.0 | 39,2% | 16,4% | Haiku +22,8 pp |
| FrontierCode 1.1 Main | 46,4% | 42,4% | Haiku +4,0 pp |
| Chartography, tanpa alat | 46,4% | 29,1% | Haiku +17,3 pp |
Enam baris di atas mereproduksi hasil perbandingan peluncuran yang dipublikasikan Anthropic, diperiksa 9 Oktober 2026. Ini adalah perbandingan yang dipublikasikan oleh Anthropic, termasuk hasil independen yang direproduksi di sana, bukan pengujian baru untuk artikel ini. GDPval-AA dan AA-Briefcase adalah skor Elo; selisih persentase adalah poin persentase. Keluarga benchmark ini mengukur tugas yang berbeda dan tidak boleh dirata-ratakan menjadi satu pemenang universal.
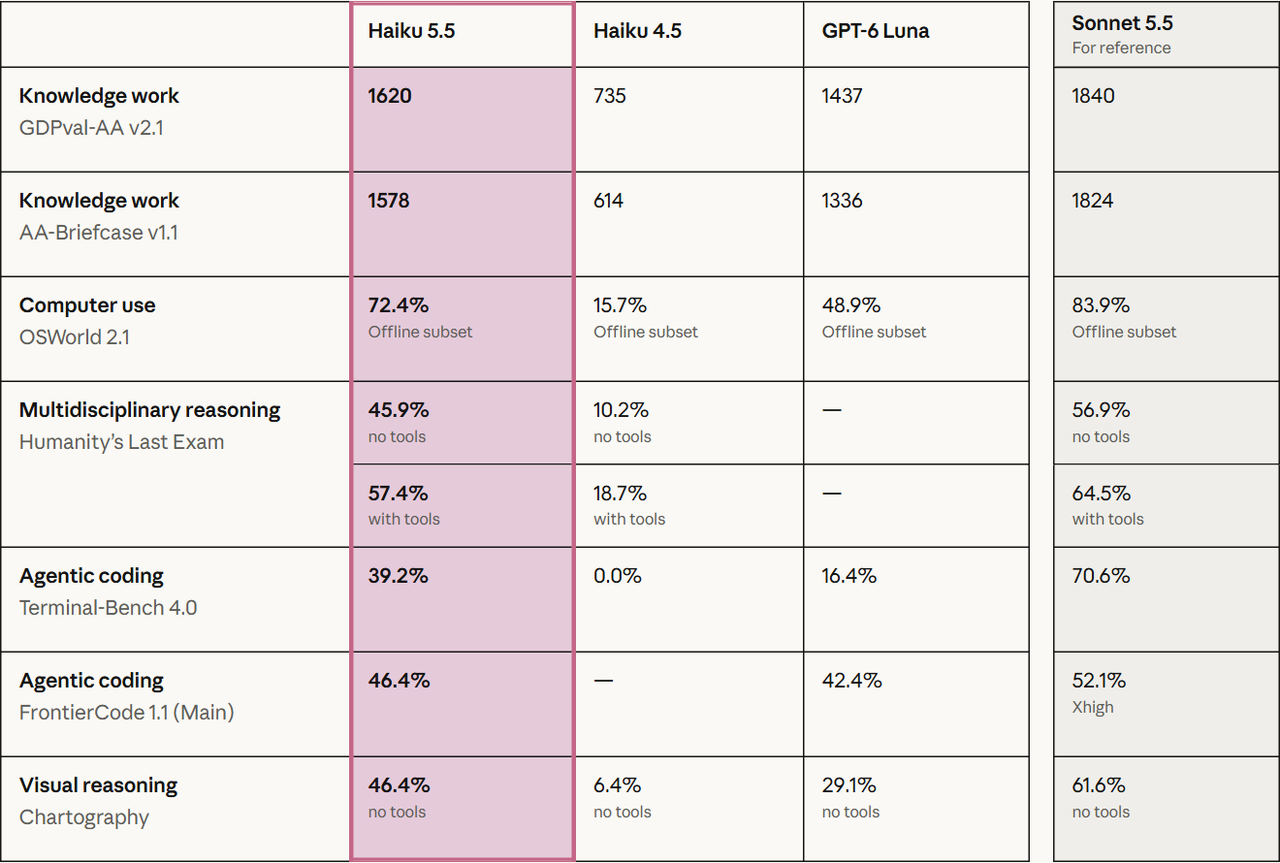
Keunggulan relatif Haiku yang paling kuat dalam tabel peluncuran ini muncul pada interaksi komputer visual dan tugas berbasis terminal. Keunggulan yang lebih kecil pada FrontierCode menjadi peringatan untuk tidak mengekstrapolasi selisih 20 poin ke setiap situasi pengodean. Gunakan hasil ini untuk memilih kandidat uji coba, lalu validasi prompt dan tumpukan alat Anda.
Upaya Penalaran dan Batas Evaluasi
Upaya penalaran mengubah trade-off akurasi–biaya. Bandingkan pengaturan yang tersedia menggunakan beban kerja dan harness yang sama; nama pengaturan vendor yang sama tidak menjamin anggaran token penalaran yang sama. Tabel peluncuran melaporkan subset offline OSWorld dan Chartography tanpa alat. Harness, pemilihan tugas, ulang coba, dan akses alat dapat mengubah hasil. Kartu sistem Anthropic mendokumentasikan kondisi khusus benchmark. Baca metode benchmark di kartu sistem Anthropic.
- OSWorld menggunakan subset offline 82 tugas, mesin virtual Ubuntu, tangkapan layar 1080p, batas 500 aksi, upaya maksimum, dan lima percobaan per tugas. Perbandingan 72,4%/48,9% adalah penilaian kredit parsial, bukan persentase tugas yang diselesaikan sempurna; tingkat lulus ketat Haiku adalah 37,1%. Anthropic menjalankan Luna pada subset tugas yang sama melalui API OpenAI.
- Terminal-Bench menggunakan 66 tugas terkontainerisasi; Haiku berjalan pada upaya maksimum dalam mode bare Claude Code, tanpa egress internet atau model fallback, rata-rata sepuluh uji per tugas.
- FrontierCode Main berisi 100 tugas dengan lima kali jalan per tugas; model Claude menggunakan Claude Code dan model GPT menggunakan Codex.
- GDPval-AA dan AA-Briefcase dievaluasi secara independen oleh Artificial Analysis dan direproduksi dalam materi peluncuran. Ini adalah pipeline evaluasi terpisah, bukan satu harness produksi bersama.
Claude Haiku 5.5 vs GPT-6 Luna: Perbandingan Fitur
Penggunaan Komputer dan Pengodean Agenik
Keunggulan terkuat Haiku berada pada tugas peluncuran bersama yang memerlukan interaksi dengan komputer grafis atau bekerja di terminal. Selisih skor parsial OSWorld adalah 23,5 poin persentase, sementara Terminal-Bench berbeda 22,8 poin. Perbedaan 4,0 poin pada FrontierCode menunjukkan mengapa kategori pengodean yang lebih luas tidak boleh diperlakukan sebagai satu beban kerja tunggal.
Untuk otomatisasi peramban, uji navigasi halaman, pengisian formulir, pemulihan dari kegagalan alat, dan penyelesaian ujung-ke-ujung. Untuk pengodean, uji apakah patch lulus pemeriksaan fungsional repositori Anda dan tetap dalam lingkup. Pemeriksaan penerimaan tersebut lebih berguna daripada memilih model dari selisih tajuk utama terbesar.
Konteks Panjang dan Pemrosesan Dokumen
Perbedaan 5% dalam kapasitas konteks nominal kurang signifikan dibanding keandalan dan harga pemrosesan prompt yang substansial. Tidak ada model yang secara inheren lebih unggul dalam mengambil informasi hanya karena jendela konteksnya lebih besar.
Perbedaan kunci adalah kapan tarif yang lebih tinggi berlaku: prompt 150K token melewati ambang Haiku sementara tetap berada dalam tier dasar Luna. Oleh karena itu Luna adalah titik awal berbiaya lebih rendah untuk beban token tersebut. Apakah itu analis dokumen yang lebih baik masih bergantung pada akurasi ekstraksi, kutipan, dan ulang coba yang diperlukan untuk mendapatkan jawaban yang dapat diterima.
Kontrol Penalaran
Kedua model mengekspose upaya penalaran yang dapat disesuaikan, dengan medium sebagai default dalam dokumentasi yang dikutip. Luna juga mengekspose pengaturan none. Gunakan kontrol tersebut agar sesuai dengan tugas: ekstraksi dan perutean mungkin memerlukan penalaran lebih sedikit daripada alur kerja alat multi-langkah yang tidak pasti. Label upaya yang sama tidak menyiratkan anggaran komputasi yang sama di seluruh vendor.
Input Multimodal dan Alur Kerja Terstruktur
Keduanya menerima teks dan gambar dan menghasilkan teks. Ini membuat keduanya kandidat untuk tangkapan layar, ekstraksi gambar dokumen, dan alur kerja hilir terstruktur. Dukungan input saja tidak menetapkan akurasi yang sama pada teks kecil, grafik, atau antarmuka visual; ukurlah kasus-kasus tersebut secara terpisah.
Kecepatan dan Ekonomi Tugas
| Metrik independen (upaya maksimum) | Haiku 5.5 — Artificial Analysis | GPT-6 Luna — Artificial Analysis |
|---|---|---|
| Intelligence Index v4.3.2 | 43 | 38 |
| Kecepatan output | 240,6 token/det | 123,0 token/det |
| Biaya tertimbang per tugas Intelligence Index | $0,21 | $0,07 |
Artificial Analysis adalah penerbit pengujian independen. Tabel ini adalah cuplikan halaman model upaya maksimum mereka yang diperiksa 9 Oktober 2026, bukan kinerja resmi vendor. Kecepatan output mengukur token yang diterima setelah generasi dimulai; ini terpisah dari waktu ke token pertama dan latensi tugas penuh. Biaya per tugas adalah metrik Intelligence Index berbobot, bukan kutipan untuk tugas produksi Anda atau biaya per hasil yang berhasil.
Throughput output cuplikan Haiku kira-kira 1,96 kali Luna, sementara biaya tugas evaluasi berbobot Luna lebih rendah. Ini tidak menetapkan keunggulan 1,96 kali dalam waktu penyelesaian tugas penuh. Pengujian produksi harus mencatat waktu ke token pertama, waktu penyelesaian, panjang output, konsumsi penalaran, dan waktu eksekusi alat secara terpisah.
Claude Haiku 5.5 vs GPT-6 Luna: Harga dan Akses API
Tarif Standar Resmi
| USD per 1M token | Haiku ≤100K | Haiku >100K | Luna ≤272K | Luna >272K |
|---|---|---|---|---|
| Input | $0,10 | $0,50 | $0,10 | $0,20 |
| Bacaan cache | $0,01 | $0,05 | $0,01 | $0,02 |
| Penulisan cache (Haiku: TTL 5 menit) | $0,125 | $0,625 | $0,125 | $0,25 |
| Output | $0,50 | $2,50 | $0,50 | $0,75 |
USD per satu juta token pada tarif pemrosesan standar, diperiksa 9 Oktober 2026. Tabel menggunakan tarif standar dan penulisan cache 5 menit Haiku dan tarif konteks pendek dan panjang Luna. Biaya alat, pajak, kenaikan regional, dan penyesuaian tier pemrosesan opsional dikecualikan. Di atas ambang input, tarif yang lebih tinggi yang berlaku mencakup permintaan tersebut alih-alih hanya token kelebihannya.
Perbedaan utama adalah ambang penagihan. Haiku beralih ke tarif yang lebih tinggi di atas 100K token prompt, sementara Luna mempertahankan tier rendahnya hingga 272K. Bahkan di atas ambang itu, harga input dan output konteks panjang Luna yang dikutip lebih rendah.
Haiku juga menawarkan penulisan cache 1 jam pada $0,20/$1,00 per satu juta token untuk prompt pendek/panjang. Persistensi cache dan mekanisme harga berbeda antar vendor, jadi bandingkan pola penggunaan ulang alih-alih memperlakukan kedua baris penulisan cache sebagai produk yang identik. Batas output 128K milik Haiku adalah batas API standar; Message Batches API-nya dapat mendukung output 300K dengan header beta.
Biaya Ilustratif pada Anggaran Token Tetap
| Beban kerja | Input / Output | Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| Klasifikasi tiket | 2K / 200 | $0,0003 | $0,0003 |
| Laporan singkat | 40K / 4K | $0,006 | $0,006 |
| Analisis repositori | 150K / 5K | $0,0875 | $0,0175 |
| Tinjauan dokumen besar | 300K / 10K | $0,175 | $0,0675 |
| Analisis konteks masif | 800K / 20K | $0,45 | $0,175 |
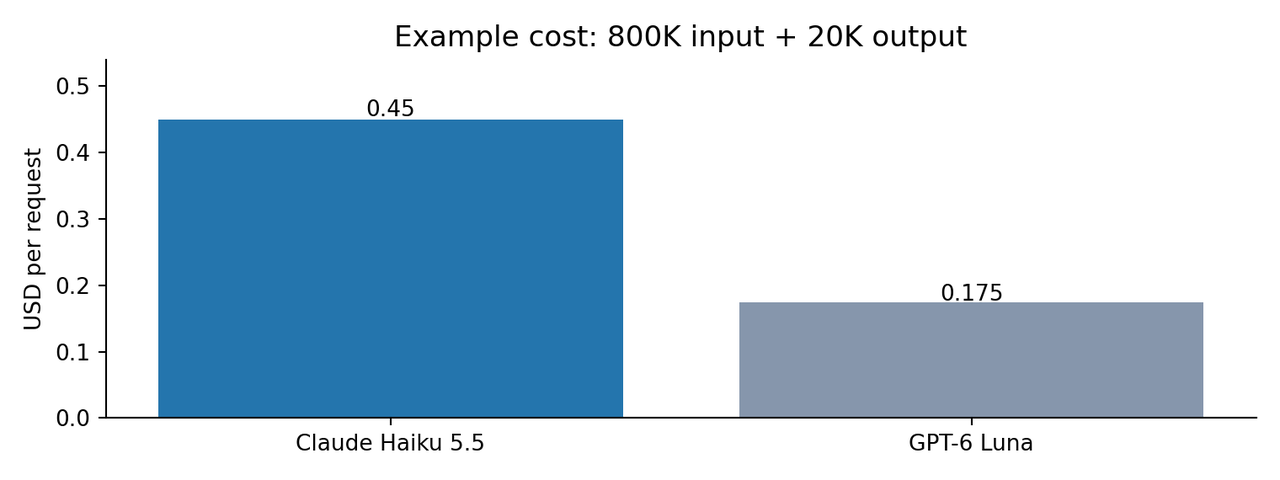
Estimasi tarif standar tanpa cache yang dihitung penulis: biaya = token input × tarif input / 1.000.000 + token output yang ditagihkan × tarif output / 1.000.000. “Output” berarti total output yang ditagihkan untuk estimasi ini, termasuk token penalaran bila ditagihkan sebagai output; ini tidak selalu sama dengan panjang jawaban yang terlihat. Jumlah token yang sama dilaporkan untuk kedua model, meski tokenizer dapat berbeda.
Token murah tidak selalu berarti hasil sukses yang murah. Tim harus memperhitungkan percobaan berulang, panggilan alat yang gagal, konsumsi token penalaran, dan perilaku tokenizer yang berbeda.
Akses CometAPI dan Kendala Integrasi
CometAPI menyediakan opsi akses untuk kedua model. Sebelum membandingkan atau menerapkan keduanya melalui gateway, verifikasi ID model, endpoint yang didukung, parameter permintaan, perilaku alat, dan aturan penagihan untuk tiap rute. Tautan penyedia ini mendokumentasikan opsi akses; tautan tersebut tidak menggantikan sumber teknis atau harga standar vendor.
Untuk integrasi OpenAI langsung, Luna mendukung alat bawaan melalui Responses API; Chat Completions function calling memerlukan upaya penalaran none. Haiku menggunakan Messages API Anthropic dan adaptive thinking. Sebuah gateway tidak membuat skema yang mendasari menjadi dapat dipertukarkan: validasi definisi alat, perilaku output terstruktur, event streaming, dan pencatatan dengan rute persis yang ingin Anda gunakan.
Bagaimana Pengembang Membandingkan Claude Haiku 5.5 dan GPT-6 Luna dengan Prompt yang Sama?
Contoh Ekstraksi Dokumen Panjang
Perbandingan praktis dapat menggunakan bundel kontrak pemasok yang berisi tanggal efektif, ketentuan pembaruan, periode pemberitahuan, dan pengecualian. Pertahankan bundel dokumen, instruksi ekstraksi, field yang diharapkan, dan aturan validasi tetap identik. Berikut adalah desain evaluasi, bukan hasil model baru yang terukur.
Contoh prompt: Ekstrak nama pemasok, tanggal efektif, tanggal pembaruan, periode pemberitahuan pemutusan, dan pengecualian harga untuk setiap kontrak. Untuk setiap nilai yang diekstrak, sebutkan judul dokumen dan potongan pendukung yang tepat. Kembalikan null saat field tidak ada; jangan menyimpulkan tanggal yang hilang. Tandai klausul yang bertentangan dan batasi jawaban akhir dalam 1.000 kata.
| Pemeriksaan | Kriteria penerimaan | Apa yang dicatat |
|---|---|---|
| Akurasi ekstraksi | Field yang diperlukan cocok dengan kunci jawaban yang diperiksa independen | Nilai benar, salah, dan hilang |
| Grounding | Setiap field non-null memiliki potongan pendukung yang valid | Klaim tanpa dukungan dan sitasi dokumen yang salah |
| Kepatuhan instruksi | Tidak ada tanggal yang dikarang; field yang tidak ada mengembalikan null | Kegagalan skema dan pelanggaran batasan |
| Ekonomi | Hitung pengeluaran per ekstraksi yang diterima | Input yang ditagihkan, output, penalaran, ulang coba, dan biaya fallback |
| Latensi | Bandingkan penyelesaian pekerjaan penuh dengan kebijakan alat yang sama | Waktu token pertama dan waktu ujung-ke-ujung |
Jalankan lebih dari satu bundel yang representatif dan ulangi kasus di mana hasil bervariasi. Mulailah dengan tingkat upaya yang tersedia sama, lalu uji konfigurasi berbiaya lebih rendah untuk masing-masing model. Laporkan ukuran sampel, pengaturan, rute, tanggal, dan jumlah kegagalan sebelum menyajikan pemenang.
Haiku 5.5 atau GPT-6 Luna: Mana yang Harus Dipilih?
| Dimensi | Titik awal yang lebih didukung | Batas keputusan |
|---|---|---|
| Interaksi GUI | Claude Haiku 5.5 | Skor parsial OSWorld yang dibagikan menguntungkan Haiku; verifikasi penyelesaian tugas penuh |
| Pengodean terminal | Claude Haiku 5.5 | Skor Terminal-Bench yang dibagikan menguntungkan Haiku; validasi perubahan repositori |
| Prompt pendek dan harga dasar | Uji keduanya | Tarif dasar identik; bandingkan penggunaan yang ditagihkan dan ulang coba |
| Prompt di atas 100K token | GPT-6 Luna pada tarif standar | Luna mempertahankan tier dasar lebih lama; akurasi dapat mengubah total biaya |
| Throughput token streaming | Claude Haiku 5.5 dalam cuplikan bertanggal | Throughput berbeda dari latensi penyelesaian penuh |
| Ekstraksi sederhana berulang | Uji Luna dengan penalaran rendah atau none | Pilih berdasarkan output yang diterima valid, bukan harga saja |
Pilih Claude Haiku 5.5 untuk Tugas Interaktif yang Relevan dengan Benchmark
Mulailah dengan Haiku saat aplikasi Anda menyerupai tugas komputer grafis, pengodean terminal, atau pekerjaan profesional yang dipublikasikan, dan tingkat penyelesaian yang lebih tinggi dapat menutupi pengeluaran penalaran atau konteks panjang tambahan. Konfirmasikan keunggulan itu pada tumpukan alat Anda sendiri sebelum mengarahkan trafik produksi.
Pilih GPT-6 Luna untuk Kontrol Biaya Prompt Besar
Mulailah dengan Luna saat prompt sering melampaui 100K token dan biaya token standar berdampak material pada anggaran Anda. Ini juga kandidat untuk ekstraksi berulang atau perutean yang dapat berhasil dengan penalaran rendah atau none. Pertahankan rekomendasi bersyarat pada tingkat hasil yang diterima dan penggunaan yang benar-benar ditagihkan.
Gunakan Keduanya Saat Beban Kerja Memiliki Kebutuhan Berbeda
Uji coba dapat merutekan ekstraksi dokumen panjang ke Luna dan tugas GUI atau terminal ke Haiku, lalu validasi setiap pilihan terhadap pemeriksaan penerimaan. Aktifkan fallback saat output gagal validasi skema, tidak memiliki bukti yang diperlukan, atau gagal pemeriksaan tugas khusus, dan sertakan biaya serta latensi fallback dalam perbandingan.
Validasi Sebelum Beralih
Sertakan model Anda saat ini sebagai baseline. Pindah hanya ketika kandidat memenuhi target kebenaran yang telah ditentukan dan meningkatkan biaya per hasil yang diterima atau latensi ujung-ke-ujung cukup besar untuk menutupi migrasi dan pemeliharaan. Tahan rollout jika kesalahan alat kritis meningkat. Rekomendasi berubah jika uji coba Anda menunjukkan bahwa tarif lebih rendah Luna diimbangi oleh ulang coba, atau bahwa skor benchmark lebih tinggi Haiku tidak meningkatkan keberhasilan tugas Anda.
- Gunakan sampel beban kerja yang representatif dan nilai hasil benar, salah, dan tidak lengkap.
- Ukur latensi token pertama, waktu tugas ujung-ke-ujung, dan keandalan alat.
- Lacak jumlah token input, cache, output, dan penalaran secara terpisah.
- Hitung biaya per hasil sukses, termasuk ulang coba dan fallback.
- Bandingkan upaya penalaran medium dan tinggi sebelum menyalakan pengaturan maksimum secara default.
Kesimpulan
Claude Haiku 5.5 memiliki bukti head-to-head peluncuran yang lebih kuat di benchmark pekerjaan profesional, penggunaan komputer, dan pengodean agenik yang dibandingkan di sini. Ia juga memiliki throughput output lebih tinggi dalam cuplikan independen. GPT-6 Luna memiliki keunggulan tarif standar yang jelas untuk prompt di atas ambang 100K milik Haiku dan biaya tugas evaluasi berbobot yang lebih rendah. Tidak ada pengamatan tunggal yang menentukan keandalan produksi atau biaya per hasil sukses.
Pemenang praktis adalah model yang memberikan hasil yang dapat diterima dengan biaya operasional terukur terendah secara menyeluruh. Jalankan keduanya terhadap prompt, alat, dan aturan ulang coba Anda sendiri daripada memperlakukan satu benchmark sebagai jawaban.
FAQ
Mengapa biaya tugas dapat berbeda ketika kedua model memiliki harga token dasar yang sama?
Harga dasar yang sama tidak berarti tagihan total yang sama. Model dapat menggunakan jumlah token input, output, dan penalaran yang berbeda, serta mungkin memerlukan jumlah ulang coba atau panggilan alat yang berbeda untuk menghasilkan hasil yang dapat diterima. Tarif konteks panjang dan penggunaan cache juga memengaruhi total. Bandingkan total biaya semua percobaan dibagi jumlah hasil yang diterima, bukan harga token saja.
Apakah tarif konteks panjang yang lebih tinggi hanya berlaku untuk token di atas ambang?
Tidak. Di bawah harga standar yang dijelaskan dalam artikel ini, melewati ambang input menerapkan tarif yang lebih tinggi pada permintaan, bukan hanya token kelebihannya. Misalnya, permintaan 150K token input melewati ambang 100K Haiku tetapi tetap berada dalam tier dasar 272K Luna. Gunakan tarif input dan output yang berlaku untuk seluruh permintaan saat memperkirakan biaya.
Dapatkah Claude Haiku 5.5 dan GPT-6 Luna berbagi cache prompt?
Jangan berasumsi entri cache dapat ditransfer antar model atau penyedia. Rancang strategi penggunaan ulang terpisah, lalu ukur tingkat hit dan penggunaan yang ditagihkan pada masing-masing rute. Dukungan gateway, aturan retensi, dan struktur permintaan dapat memengaruhi apakah input berulang memenuhi syarat untuk caching; verifikasi ini sebelum memproyeksikan penghematan.
Apa yang harus dicakup oleh pengujian migrasi Haiku ke Luna?
Uji input teks dan gambar yang representatif, field terstruktur yang diperlukan, argumen alat, respons streaming, dan pemulihan kesalahan. Tetapkan tingkat penerimaan sistem Anda saat ini sebelum migrasi, lalu bandingkan kedua kandidat dalam kebijakan alat dan ulang coba yang sama. Harga token serupa atau kategori model tidak menetapkan kompatibilitas.
Haruskah skor benchmark mendorong fallback Haiku atau Luna?
Gunakan skor untuk memilih kandidat, lalu picu fallback pada kegagalan yang diamati seperti argumen alat tidak valid, field wajib yang hilang, atau pemeriksaan tugas yang tidak terpenuhi. Lacak frekuensi fallback dan total biaya yang ditagihkan. Model kedua dapat menambah latensi dan biaya, jadi verifikasi bahwa ia meningkatkan hasil yang diterima alih-alih sekadar menghasilkan jawaban kedua.
Dapatkah data sensitif dirutekan melalui kedua API?
Tinjau vendor dan gateway yang terlibat secara spesifik, pengaturan retensi saat ini, lokasi pemrosesan, ketentuan kontraktual, dan kebijakan data organisasi Anda sebelum merutekan input sensitif. Kapabilitas model dan tabel harga tidak menetapkan kelayakan rute untuk data yang diatur atau rahasia. Gunakan rute yang disetujui saat persyaratan tersebut bersifat menentukan.