

TL;DR
Claude Opus 5.5 adalah kandidat awal yang kuat karena menawarkan harga token yang jauh lebih rendah sambil menyamai atau melampaui Fable 5.1 pada beberapa evaluasi yang dipublikasikan, dengan tarif $4 per juta token input dan $20 per juta token output, dibandingkan Fable 5.1 pada $10 dan $50.
Fable 5.1 tetap memiliki peran ketika tugas sangat sulit, berjalan lama, mahal untuk diulang, atau diharapkan beroperasi tanpa pengawasan ketat. Aturan praktisnya sederhana: mulai dengan Opus 5.5, lalu eskalasi hanya ketika pengujian produksi yang representatif menunjukkan bahwa Fable 5.1 mengurangi kegagalan, koreksi, atau biaya retry cukup untuk membenarkan premiumnya.
Claude Opus 5.5 vs Claude Fable 5.1 Sekilas
| Dimensi | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|
| Tanggal rilis | Sep. 22, 2026 | Sep. 1, 2026 |
| API model ID | claude-opus-5-5 | claude-fable-5-1 |
| Konteks / output maks | 1M / 128K | 1M / 128K |
| Input / output per MTok | $4 / $20 | $10 / $50 |
| Baca cache per MTok | $0.20 | $0.25 |
| Terminal-Bench 4.0 | 66.4% | 55.8% |
| FrontierCode v1.1 | 54.4% | 50.3% |
| CursorBench 4.0 | 57.8% | 51.8% |
| GDPval-AA v2.1 | 1846 Elo | 1735 Elo |
| Migrasi HAProxy C-ke-Rust | 9.5 jam; biaya tugas lebih rendah 51% | 12 jam; biaya tugas baseline |
| Opsi kecepatan | Fast mode, hingga 2.5× kecepatan normal | Tidak ada mode peluncuran yang ekuivalen |
| Titik awal upaya | Berorientasi medium | Tinggi |
| Penggunaan default terbaik | Koding frontier harian, agen, produksi terawasi, dan lalu lintas API volume tinggi | Pekerjaan bernilai tinggi, sulit, berjalan lama, atau otonom tanpa pengawasan |
| Akses API | Anthropic API dan penyedia kompatibel termasuk CometAPI | Anthropic API dan penyedia kompatibel termasuk CometAPI |
Catatan membaca: Angka tolok ukur dilaporkan oleh Anthropic dan bergantung pada tingkat upaya, harness, pembatasan, rilis tugas, jumlah percobaan, dan standar error. Angka-angka tersebut hanya boleh dibandingkan dalam kondisi evaluasi yang cocok.
Pokok-Pokok Utama
- Tarif input dan output standar Opus 5.5 60% lebih rendah dibandingkan tarif Fable 5.1.
- Keduanya mendukung jendela konteks 1M token dan hingga 128K output, jadi biaya, setelan upaya, dan kecocokan beban kerja lebih penting daripada ukuran konteks nominal.
- Hasil yang dipublikasikan Anthropic mengunggulkan Opus 5.5 pada banyak evaluasi koding dan agenik, namun setelan tolok ukur sangat memengaruhi hasil.
- Evaluasi independen mendukung posisi frontier Opus 5.5 sambil melaporkan skor absolut yang berbeda, menegaskan perlunya pengujian yang cocok.
- Untuk sebagian besar pekerjaan produksi terawasi, Opus 5.5 adalah titik awal yang lebih kuat. Fable 5.1 adalah tier eskalasi, bukan default otomatis.
Apa itu Claude Opus 5.5?
Claude Opus 5.5 adalah model Claude 5.5 pertama dari Anthropic. Diposisikan untuk koding agenik, agen jangka panjang, kerja pengetahuan profesional, alur kerja enterprise, analisis finansial, visi, dan penggunaan komputer.
API model ID-nya adalah claude-opus-5-5. Penalaran adaptif selalu diaktifkan, sementara pengembang mengontrol intensitas penalaran melalui setelan upaya low, medium, high, xhigh, dan max. Anthropic juga menawarkan Fast mode, yang dapat berjalan hingga 2,5 kali kecepatan normal dengan $8/M input dan $40/M output.
Apa itu Claude Fable 5.1?
Claude Fable 5.1 diposisikan untuk proyek yang menuntut dan berjalan lama seperti koding multi-jam, riset kompleks, interaksi browser, agen otonom, dan alur kerja lintas aplikasi.
API model ID-nya adalah claude-fable-5-1. Ia menggunakan penalaran adaptif, mulai dari setelan upaya API yang lebih tinggi, dan sebaiknya diperlakukan sebagai opsi premium ketika biaya kegagalan atau pengulangan yang diharapkan melebihi biaya inferensi tambahan.
Pembacaan sederhana akan menyatakan bahwa Opus 5.5 menawarkan cakupan hampir sama dengan 40% dari harga token standar Fable. Namun di sinilah tabel spesifikasi sederhana menjadi menyesatkan.
Perbandingan Kode dan Tolok Ukur
Anthropic melaporkan Opus 5.5 unggul atas Fable 5.1 pada Terminal-Bench 4.0, FrontierCode v1.1, CursorBench 4.0, GDPval-AA v2.1, AutomationBench, Humanity's Last Exam dengan tools, Terminal-Bench-Science, OSWorld 2.0, dan Chartography.
Cara Membaca Hasil Tolok Ukur
Anthropic melaporkan Opus 5.5 unggul atas Fable 5.1 pada Terminal-Bench 4.0, FrontierCode v1.1, CursorBench 4.0, GDPval-AA v2.1, AutomationBench, Humanity's Last Exam dengan tools, Terminal-Bench-Science, OSWorld 2.0, dan Chartography. Angka-angka ini adalah hasil evaluasi, bukan konstanta model yang independen dari konfigurasi.
Sebagian besar skor utama Opus 5.5 menggunakan upaya max, sementara Terminal-Bench 4.0 menggunakan upaya xhigh. Desain harness, konfigurasi tool, pembatasan, jumlah percobaan, standar error, perilaku fallback, dan batas biaya semuanya dapat mengubah hasil. Anthropic sendiri memperingatkan bahwa margin tolok ukur mungkin melebih-lebihkan kesenjangan praktis antara model frontier.
Kinerja Pengodean
| Benchmark | Claude Opus 5.5 | Claude Fable 5.1 | Interpretasi |
|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | 55.8% | Keunggulan dilaporkan 10,6 poin untuk tugas agen berbasis terminal |
| FrontierCode v1.1 | 54.4% max; 54.6% medium | 50.3% | Opus 5.5 upaya medium tetap kompetitif untuk ekonomi produksi |
| CursorBench 4.0 | 57.8% max; 52.5% medium | 51.8% | Upaya medium sedikit melampaui hasil Fable yang dilaporkan |
| GDPval-AA v2.1 | 1846 Elo | 1735 Elo | Keunggulan yang dilaporkan pada pekerjaan agenik profesional |
Angka-angka ini adalah hasil tolok ukur yang dilaporkan Anthropic. Tabel ini harus dibaca bersama dengan catatan tentang setelan evaluasi pada bagian berikut dan halaman model resmi Claude Opus.
Tiga hasil pertama menonjol karena mencakup beban kerja di mana Claude semakin penting secara komersial: agen rekayasa perangkat lunak. Terminal-Bench 4.0 menunjukkan perbedaan absolut 10,6 poin persentase; FrontierCode menunjukkan 4,1 poin; CursorBench 4.0 menunjukkan 6 poin.
GDPval-AA, yang mengukur pekerjaan agenik profesional, juga melaporkan 1846 Elo untuk Opus 5.5 versus 1735 untuk Fable 5.1. Jika angka-angka ini seluruh ceritanya, hierarki produk akan tampak terbalik. Tidak sesederhana itu.
Evaluasi Independen
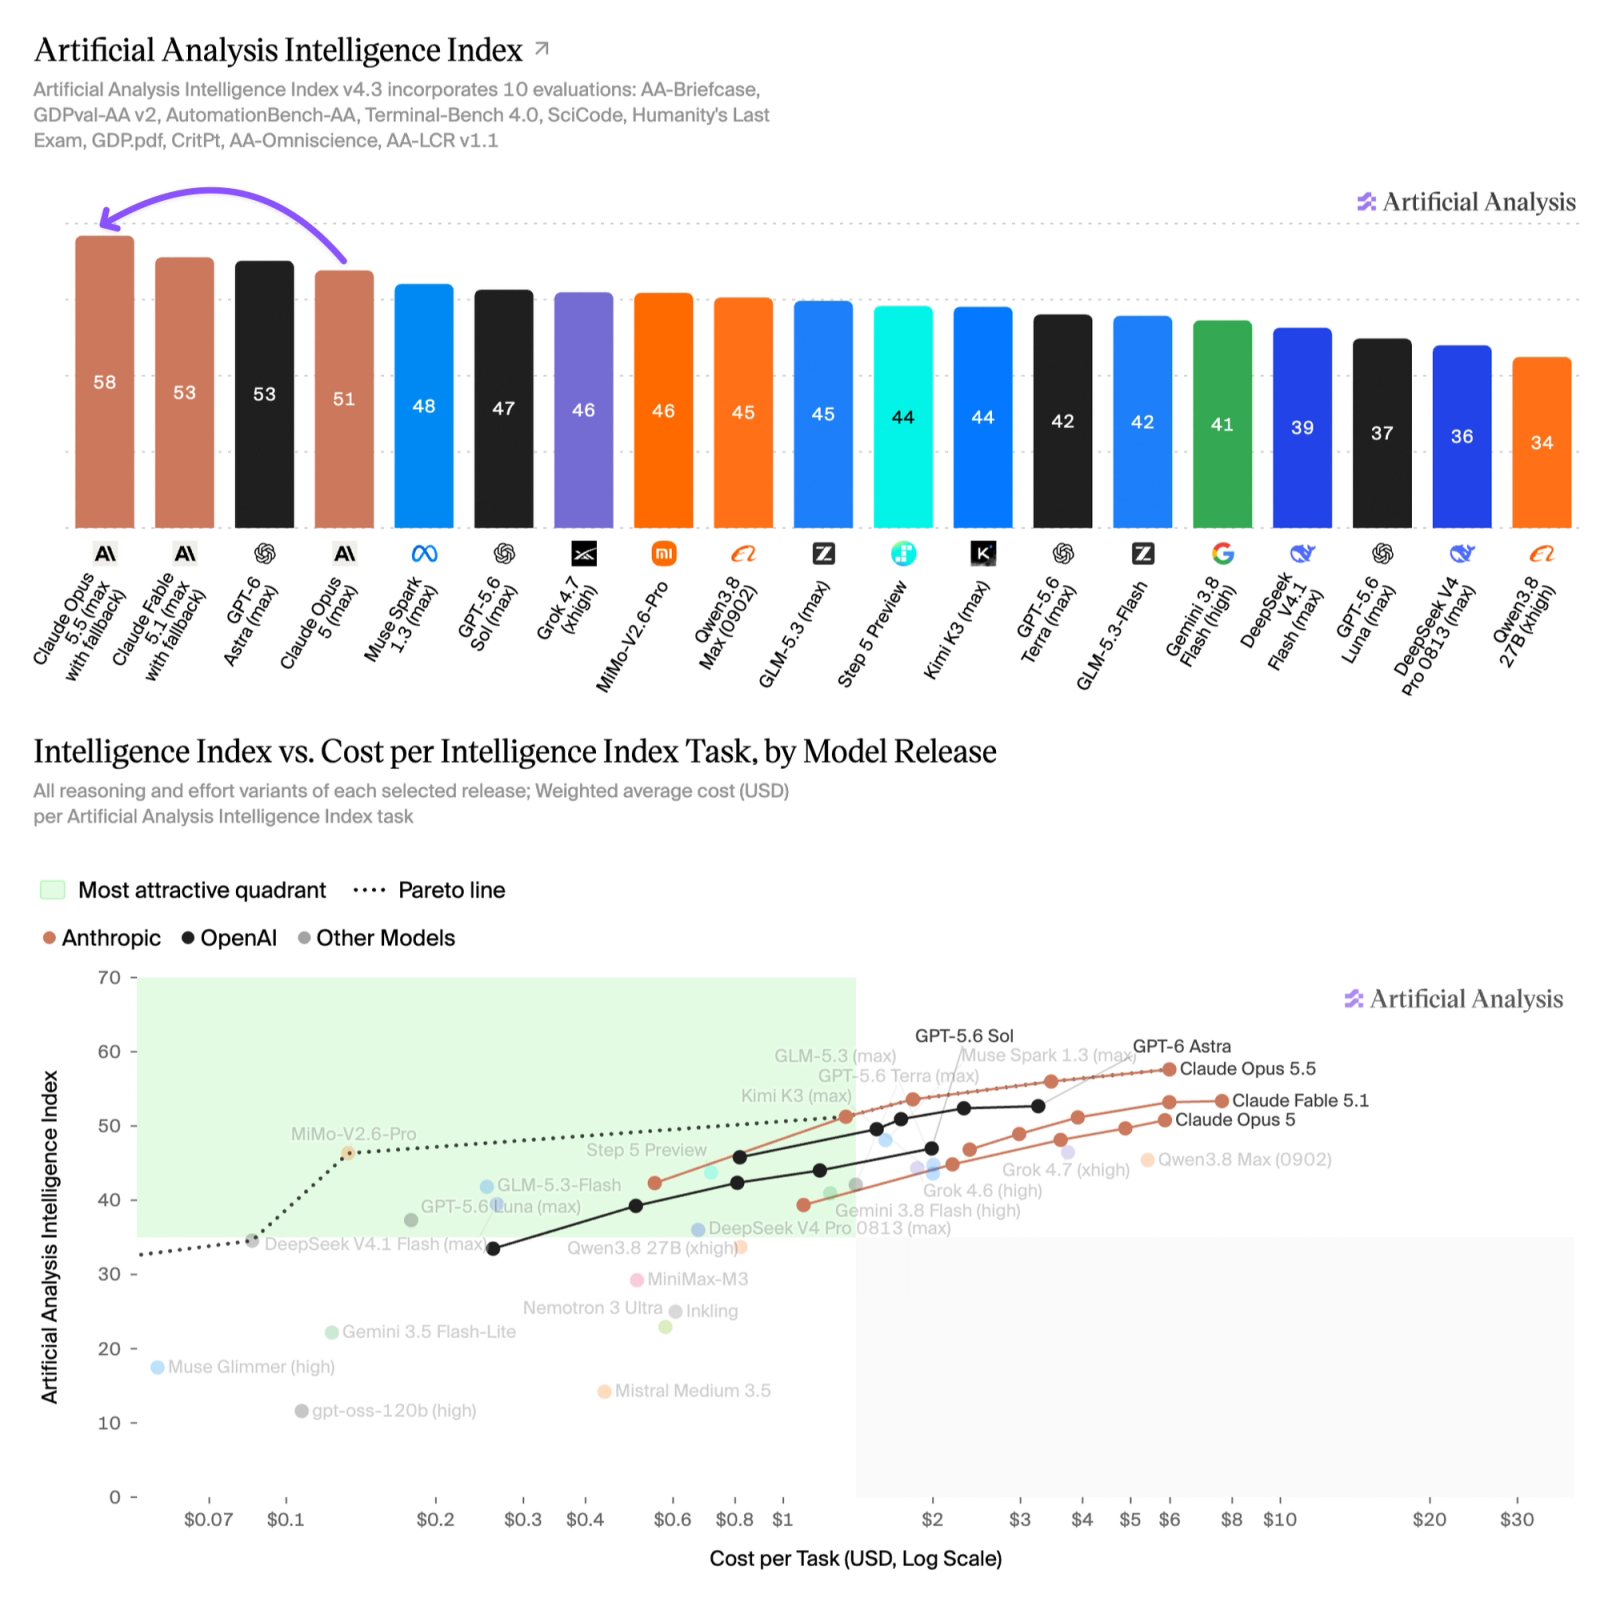
Artificial Analysis menempatkan Opus 5.5 Max pada 58 di Intelligence Index dan melaporkan hasil kuat di AA-Briefcase, GDPval-AA, AutomationBench-AA, Terminal-Bench 4.0, SciCode, dan Humanity's Last Exam. Hasil Terminal-Bench 4.0 adalah 59.6%, di bawah 66.4% milik Anthropic, menunjukkan mengapa tim harus mendokumentasikan versi model, setelan upaya, harness, tool, jumlah percobaan, dan batas biaya setiap kali skor berbeda.
Perbandingan Harga dan Biaya Per Tugas Selesai
CometAPI menawarkan harga token yang lebih rendah dari tarif resmi, memungkinkan pengembang mencapai kinerja yang sama seperti API resmi menggunakan format permintaan pesan standar.
Harga Token
| Harga | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|
| Input | $4 | $10 |
| Output | $20 | $50 |
| Tulis cache 5-menit | $5 | $12.50 |
| Tulis cache 1-jam | $8 | $20 |
| Baca cache | $0.20 | $0.25 |
| Batch input/output | Diskon 50% | Diskon 50% |
Misalkan sebuah beban kerja mengonsumsi 10 juta token input baru dan 2 juta token output. Tanpa efek cache:
10 × $4 + 2 × $20 = $80
10 × $10 + 2 × $50 = $200
Dengan asumsi tersebut, Opus 5.5 berbiaya 60% lebih rendah. Namun, angka ini jangan disamakan dengan pernyataan Anthropic bahwa Opus 5.5 sekitar 40% lebih murah untuk dijalankan daripada Opus 5.
Itu adalah dua perbandingan yang sepenuhnya berbeda. Angka 40% mencakup harga tier Opus yang lebih rendah pada Opus 5.5 dan pengurangan konsumsi token per tugas dibandingkan Opus 5. Angka 60% berasal langsung dari perbandingan harga daftar standar Opus 5.5 dan Fable 5.1.
Biaya per Tugas yang Terselesaikan
API model sebenarnya tidak menjual token. Pengembang membeli pekerjaan yang selesai.
Tim koding tidak peduli bahwa model mengonsumsi 6,2 juta token. Mereka peduli apakah model memperbaiki bug, menyelesaikan migrasi, lulus suite pengujian, atau menuntaskan tugas riset.
Anthropic menegaskan hal ini langsung dalam analisis What a task costs on Opus 5.5: dua model dengan harga serupa dapat memiliki biaya tugas yang sangat berbeda jika satu membutuhkan lebih banyak giliran, lebih sering membaca ulang konteks, lebih kerap mengulang, atau menghasilkan lebih banyak token thinking.
Task Cost = Fresh Input Cost
          + Cache Read Cost
          + Cache Write Cost
          + Output / Thinking Cost
          + Retry Cost
Butir terakhir itu sering diabaikan. Model yang lebih murah tetapi gagal dua kali bisa menjadi lebih mahal daripada model yang lebih mahal yang menyelesaikan tugas dalam satu kali jalan. Demikian pula, setelan upaya tinggi yang menghindari sepuluh giliran retry justru dapat menurunkan total biaya.
Ekonomi Cache Prompt
Agen yang berat pada cache berulang kali menggunakan definisi tool, konteks repositori, instruksi sistem, riwayat percakapan, dan output pengujian. Karena harga baca cache adalah $0.20/M untuk Opus 5.5 dan $0.25/M untuk Fable 5.1, kesenjangannya jauh lebih kecil daripada selisih $6/M pada harga input baru. Oleh karena itu tim harus melacak input baru, baca cache, tulis cache, output, giliran tool, dan retry secara terpisah.
Ekonomi Tingkat Upaya
Potensial, ya. Artificial Analysis menguji lima setelan upaya Opus 5.5 dan menemukan kurva kapabilitas-biaya yang jelas.
| Upaya Opus 5.5 | Artificial Analysis Intelligence Index | Biaya per tugas Indeks |
|---|---|---|
| Low | 42 | $0.55 |
| Medium | 51 | $1.34 |
| High | 54 | $1.82 |
| Xhigh | 56 | $3.46 |
| Max | 58 | $5.98 |
Upaya medium adalah titik awal yang masuk akal untuk perubahan kode rutin, refactor yang diketahui, dan debugging terawasi. High atau xhigh mungkin dibenarkan untuk kegagalan sistem yang ambigu, migrasi semalaman, atau tugas di mana rencana yang salah menciptakan pekerjaan ulang yang substansial.
Perbandingan Keamanan dan Keandalan
Tidak ada model yang seharusnya dilabeli lebih aman hanya dari tolok ukur kapabilitas. Perbandingan yang dapat dipertanggungjawabkan memerlukan prompt, tool, izin, setelan upaya, batas retry, dan kriteria penerimaan yang cocok. Kapabilitas yang lebih tinggi dapat mengurangi kesalahan tidak disengaja, tetapi otonomi yang lebih besar dan eksekusi lebih lama juga meningkatkan dampak dari rencana buruk, prompt injection, panggilan tool yang tidak aman, atau drift yang tidak terdeteksi.
| Dimensi keamanan | Perbandingan praktis | Kontrol produksi |
|---|---|---|
| Penalaran dan upaya | Opus 5.5 mengekspos beberapa tingkat upaya, sementara Fable 5.1 mulai dari postur upaya yang lebih tinggi. Lebih banyak penalaran bukan pengganti penegakan kebijakan. | Kunci kebijakan upaya berdasarkan beban kerja dan uji ulang perilaku keamanan setiap kali berubah. |
| Otonomi jangka panjang | Fable 5.1 diposisikan untuk pekerjaan sulit tanpa pengawasan; Opus 5.5 juga mendukung alur kerja agenik. Risiko tumbuh seiring durasi, izin, dan jumlah tindakan yang tidak reversibel. | Gunakan checkpoint, gerbang persetujuan, batas waktu dan biaya, serta kondisi rollback atau shutdown otomatis. |
| Penggunaan tool dan komputer | Kedua model dapat mengoperasikan tool, sehingga pemilihan model saja tidak mengontrol eksposur data atau tindakan destruktif. | Terapkan least privilege, allowlist, sandboxing, isolasi rahasia, dan konfirmasi sebelum tindakan eksternal atau tidak reversibel. |
| Evaluasi dan auditabilitas | Skor tolok ukur publik tidak menetapkan kualitas penolakan, ketahanan terhadap prompt-injection, atau tingkat insiden produksi. | Catat panggilan tool dan keputusan kebijakan; ukur tingkat kepatuhan tidak aman, penolakan salah, keberhasilan injeksi, kebocoran rahasia, upaya destruktif, dan kualitas pemulihan. |
Aturan keamanan praktis: mulai dengan konfigurasi Opus 5.5 berhak paling rendah yang memenuhi tugas, dan eskalasi ke Fable 5.1 hanya setelah suite keamanan yang sama lolos. Untuk alur kerja berisiko tinggi, minta persetujuan manusia terlepas dari model mana yang skornya lebih tinggi pada uji kapabilitas.
- Jalankan pengujian prompt-injection dan ekstraksi data yang adversarial dengan toolset produksi nyata.
- Pisahkan izin baca, tulis, publikasi, hapus, dan finansial alih-alih memberikan satu peran tool yang luas.
- Definisikan pemicu rollback untuk pelanggaran kebijakan, kegagalan tool yang berulang, perluasan cakupan yang tidak terduga, dan pembengkakan biaya.
- Validasi ulang setelah perubahan model, prompt sistem, upaya, tool, izin, atau routing.
Cara Memilih antara Opus 5.5 dan Fable 5.1
| Beban kerja | Titik awal yang direkomendasikan | Kondisi eskalasi |
|---|---|---|
| Koding harian dan code review | Opus 5.5, upaya medium | Eskalasi hanya untuk kasus yang tidak biasa sulit atau berisiko tinggi |
| Pekerjaan fitur multi-berkas | Opus 5.5, medium atau high | Gunakan Fable ketika kegagalan perencanaan berulang mendominasi biaya |
| Migrasi seluruh repositori | Uji Opus 5.5 high atau xhigh terlebih dulu | Eskalasi untuk proyek otonom yang paling sulit |
| Run otonom semalaman | Opus 5.5 dengan checkpoint ketat | Lebih pilih Fable ketika biaya arah yang salah sangat ekstrem |
| Lalu lintas API volume tinggi | Opus 5.5 | Eskalasi hanya untuk minoritas tugas yang rentan gagal |
| Deployment Fable yang telah divalidasi | Pertahankan deployment saat pengujian | Beralih hanya setelah Opus memenuhi ambang penerimaan yang sama |
Uji Produksi Praktis
Jalankan tugas representatif yang sama, prompt, tool, kebijakan upaya, kriteria penerimaan, dan batas retry pada kedua model. Catat tingkat tugas yang diterima, latensi, input baru dan cache, token output dan thinking, panggilan tool, retry, koreksi manusia, dan total biaya per hasil yang diterima. Sertakan tugas rutin dan kasus kegagalan sulit.
Panduan Migrasi untuk Pengguna Claude Opus 5 yang Ada
Pengguna Opus 5 yang ada harus menguji Opus 5.5 sebagai penerus alih-alih mengasumsikan penggantian model ID bebas risiko. Bandingkan kedalaman perencanaan, pola panggilan tool, panjang respons, kepatuhan format, latensi, perilaku cache prompt, pemulihan dari kegagalan panggilan tool, routing keamanan, dan biaya per tugas selesai. Pertahankan kriteria rollback dan model yang ada hingga Opus 5.5 melewati uji penerimaan mirip produksi.
Pengguna Fable 5.1 yang ada tidak memerlukan bagian migrasi generik. Mereka sebaiknya memperlakukan Opus 5.5 sebagai kandidat optimasi dan mengevaluasinya dengan kriteria penerimaan produksi yang sama sebelum mengubah deployment yang telah divalidasi.
Akses Melalui CometAPI
Pengembang yang mengevaluasi salah satu model dapat meninjau panduan CometAPI terkait untuk Claude Opus 5.5 dan Claude Fable 5.1. Saat mengintegrasikan melalui penyedia API kompatibel mana pun, konfirmasikan model ID yang tepat, parameter upaya yang didukung, perilaku caching, batas laju, ketersediaan regional, dan harga saat ini sebelum deployment produksi.
Gunakan claude-opus-5-5 untuk Opus 5.5 dan claude-fable-5-1 untuk Fable 5.1 di tempat identifier tersebut didukung. Hindari merutekan diam-diam kedua kelas beban kerja melalui satu tingkat upaya tetap; pemilihan model dan kebijakan upaya harus dikonfigurasi secara independen.
Python — Anthropic Messages API melalui CometAPI
import os
import anthropic

client = anthropic.Anthropic(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com",)

message = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=2048,
    messages=[{"role": "user","content": ("Analyze this codebase and propose a safe migration plan."),}],)print(message.content[0].text)
Kesimpulan
Claude Opus 5.5 mengubah batas praktis antara model frontier harian Anthropic dan tier eskalasi premiumnya. Model ini jauh lebih murah pada tarif token standar, unggul di banyak tolok ukur koding dan agenik yang dipublikasikan, dan menawarkan fleksibilitas upaya yang cukup untuk mencakup rentang produksi yang luas.
Claude Fable 5.1 tetap relevan ketika tugasnya sulit, bernilai tinggi, berjalan lama, atau otonom tanpa pengawasan dan biaya kegagalan melebihi tagihan inferensi yang lebih tinggi. Bagi sebagian besar tim, kebijakan terbaik adalah mulai dengan Opus 5.5, ukur hasil per tugas hingga selesai, dan eskalasi secara selektif.
FAQ
Bagaimana tim sebaiknya merancang uji A/B produksi untuk Opus 5.5 dan Fable 5.1?
Gunakan tugas representatif, prompt, tool, kebijakan upaya, kriteria penerimaan, dan batas retry yang sama untuk kedua model. Catat tingkat tugas yang diterima, latensi, input baru dan cache, token output dan thinking, panggilan tool, retry, koreksi manusia, dan total biaya per hasil yang diterima. Jalankan cukup banyak tugas untuk menangkap pekerjaan rutin serta kasus kegagalan sulit.
Kapan harga token yang lebih rendah gagal menurunkan total biaya tugas?
Model berharga lebih rendah masih bisa berbiaya lebih mahal jika membutuhkan lebih banyak giliran, membaca ulang konteks, menghasilkan lebih banyak token thinking, atau perlu retry berulang. Perilaku cache juga penting: kesenjangan harga input menyempit dalam sesi panjang yang didominasi baca cache. Bandingkan biaya per tugas selesai, bukan harga daftar semata.
Apa yang harus didokumentasikan ketika hasil tolok ukur tidak selaras?
Catat versi model, tingkat upaya, harness, setelan fallback dan keamanan, jumlah percobaan, rilis tugas, standar error, dan batas biaya. Labeli setiap hasil sebagai resmi atau independen dan hindari menggabungkan skor dari konfigurasi yang tidak cocok dalam satu peringkat.
Risiko migrasi apa yang harus dipantau pengguna Fable 5.1 yang ada?
Amati perubahan pada kedalaman perencanaan, pola panggilan tool, panjang respons, kepatuhan format, latensi, perilaku cache prompt, pemulihan kegagalan, dan routing keamanan. Pertahankan deployment yang ada selama evaluasi, tetapkan kriteria rollback, dan migrasi hanya setelah Opus 5.5 memenuhi ambang penerimaan yang sama pada tugas mirip produksi.
Metadata SEO
Meta title: Claude Opus 5.5 vs Fable 5.1: Kode, Biaya, dan Tolok Ukur
Meta description: Bandingkan Claude Opus 5.5 dan Claude Fable 5.1 pada tolok ukur koding, harga API, kecepatan, caching, setelan upaya, biaya per tugas selesai, dan kecocokan beban kerja.
Keywords: Claude Opus 5.5 vs Claude Fable 5.1, Claude Opus 5.5, Claude Fable 5.1, tolok ukur coding Claude, harga API Claude, CometAPI, model coding AI
URL slug: claude-opus-5-5-vs-claude-fable-5-1