
TL;DR
DeepSeek V4.1 Flash menggantikan generasi V4 Flash sebelumnya dengan model MoE enkoder–dekoder kausal berparameter 552B, pemahaman gambar native, jendela konteks 1M token, dan biaya penyajian yang jauh lebih rendah. Dalam perbandingan resmi DeepSeek, model ini meningkatkan sebagian besar tolok ukur coding, terminal, keamanan, dan agen dibanding V4 Pro 0813, sementara V4 Pro tetap unggul pada GPQA Diamond dan HLE tanpa tools.
Halaman harga API resmi DeepSeek saat ini kembali mencantumkan deepseek-flash dan deepseek-v4-pro sebagai rute terpisah, masing-masing melayani V4.1 Flash dan V4-Pro-0813. Keduanya memiliki harga, batas konkurensi, dan dukungan visi yang berbeda. Integrasi baru karenanya harus memilih ID model yang sesuai dengan beban kerja yang dimaksud, alih-alih mengandalkan perilaku alias historis.
Poin Penting
- V4.1 Flash dan V4 Pro saat ini adalah pilihan API resmi yang berbeda: gunakan deepseek-flash untuk V4.1 Flash dan deepseek-v4-pro untuk V4-Pro-0813.
- Kenaikan terbesar yang sebanding muncul pada tugas terminal, agen coding, otomasi, dan eksekusi berorientasi keamanan—bukan pada setiap tolok ukur penalaran closed-book.
- V4.1 Flash secara material lebih murah daripada rute V4 Pro yang saat ini tercantum pada input cache hit, input cache miss, dan token output.
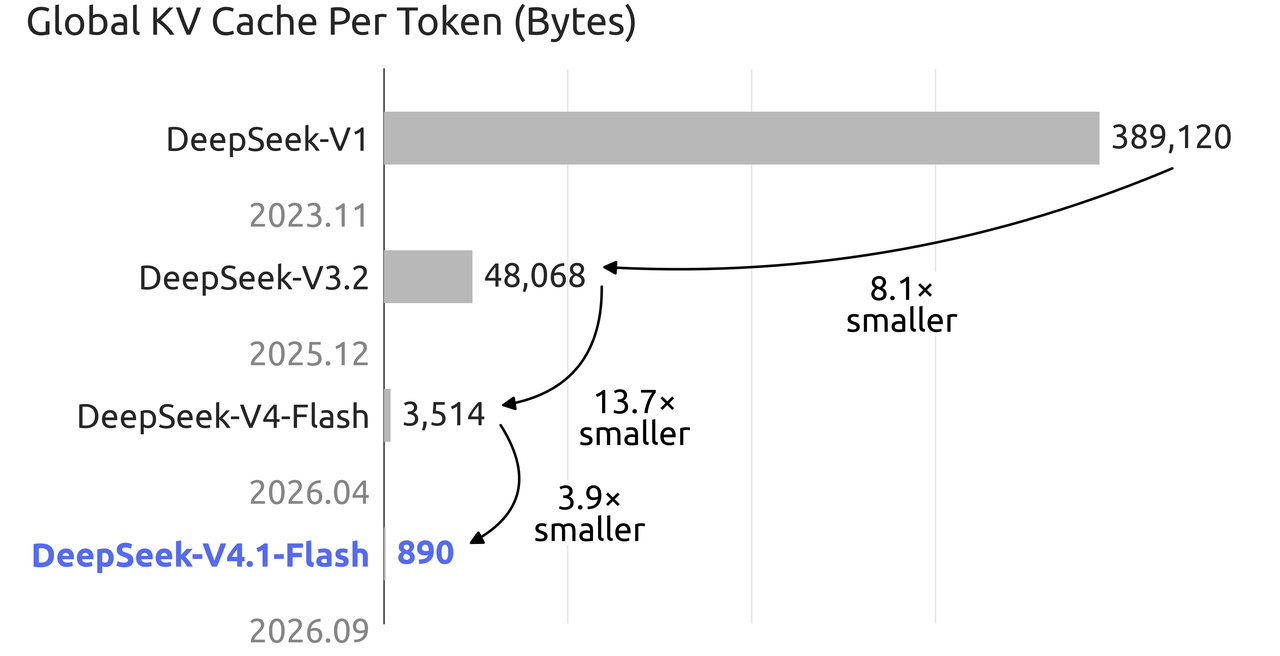
- V4.1 Flash menambahkan visi native, meningkatkan konkurensi terdokumentasi dari 500 menjadi 2.500, dan mengurangi penyimpanan tembolok KV global menjadi 890 byte per token.
- Migrasi harus eksplisit meskipun alias berfungsi: perbarui ID model, validasi perilaku berpikir dan non-berpikir, uji ulang pemanggilan tool dan input gambar, serta pantau penggunaan token dan latensi.
Catatan perutean saat ini: halaman harga resmi mengidentifikasi deepseek-v4-pro sebagai V4-Pro-0813, terpisah dari V4.1 Flash.
Bagaimana Perbandingan Spesifikasi DeepSeek V4.1 Flash dan V4 Pro?
Arsitektur berubah dari desain MoE sparse yang sangat besar pada V4 Pro menjadi desain asimetris enkoder–dekoder kausal pada V4.1 Flash. Model yang lebih baru mengaktifkan lebih sedikit parameter untuk pemrosesan input daripada untuk generasi output, yang membantu mengurangi biaya prefill sambil mempertahankan kapasitas generasi yang lebih kuat.
| Spesifikasi | DeepSeek V4.1 Flash | DeepSeek V4 Pro 0813 |
|---|---|---|
| Arsitektur | MoE enkoder–dekoder kausal | MoE sparse |
| Total parameter Parameter backbone / jumlah bobot repositori | 552B parameter backbone; Hugging Face mencantumkan ukuran model 763B | 1.6T parameter backbone; Hugging Face mencantumkan ukuran model sekitar 1.7T |
| Parameter aktif | 8B untuk input; 16B untuk output | 49B per token |
| Jendela konteks | 1M token | 1M token |
| Output maksimum | 384K token | 384K token |
| Mode berpikir dan non-berpikir | Didukung | Didukung |
| Pemahaman gambar native | Didukung | Tidak didukung |
| Konkurensi terdokumentasi | 2,500 | 500 pada konfigurasi saat ini |
| Status API resmi saat ini | Aktif sebagai deepseek-flash | Aktif sebagai deepseek-v4-pro (V4-Pro-0813) |
Klarifikasi jumlah parameter: Kartu model V4.1 Flash milik DeepSeek menjelaskan 552B parameter backbone, sementara repositori Hugging Face melaporkan ukuran model 763B. Angka-angka ini menggambarkan cakupan perhitungan yang berbeda dan tidak boleh disajikan sebagai total yang dapat dipertukarkan.
Klarifikasi panjang output: kartu model V4.1 Flash merekomendasikan max_tokens ≥ 256K untuk inferensi lokal, sedangkan halaman harga API DeepSeek saat ini secara eksplisit menyatakan output maksimum 384K untuk kedua model API. Pengaturan inferensi yang direkomendasikan tidak sama dengan batas maksimum yang ditegakkan API.
Di Mana DeepSeek V4.1 Flash Meningkat Dibanding V4 Pro?
Tabel tolok ukur resmi DeepSeek menunjukkan peningkatan paling jelas pada beban kerja yang berat di eksekusi. Kolom persentase di bawah dihitung dari skor yang dipublikasikan; perbandingan persentase dihilangkan ketika metriknya berupa rating atau ketika persentase sederhana akan menyesatkan.
| Tolok ukur | V4.1 Flash | V4 Pro 0813 | Perbedaan | Interpretasi |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 90.6 | 87.9 | +2.7 poin; +3.1% | Eksekusi terminal lebih andal |
| Terminal-Bench 3.0 | 30.0 | 11.8 | +18.2 poin; +154.2% | Kenaikan besar pada tugas terminal yang lebih sulit |
| Terminal-Bench 4.0 | 31.2 | 12.4 | +18.8 poin; +151.6% | Kenaikan besar pada tugas terminal yang lebih baru |
| DeepSWE v1.1 | 74.2 | 62.7 | +11.5 poin; +18.3% | Kemampuan perangkat lunak tingkat repositori lebih kuat |
| ProgramBench | 20.3 | 15.5 | +4.8 poin; +31.0% | Sintesis program lebih baik |
| NL2Repo-Bench | 64.0 | 61.5 | +2.5 poin; +4.1% | Kinerja lebih baik pada tugas bahasa-alami-ke-repositori |
| CyberGym | 88.1 | 83.3 | +4.8 poin; +5.8% | Eksekusi tugas siber lebih kuat |
| HLE with tools | 63.9 | 60.0 | +3.9 poin; +6.5% | Penalaran dengan alat lebih baik |
| Automation-Bench | 54.8 | 43.2 | +11.6 poin; +26.9% | Peningkatan signifikan dalam otomasi |
| Agents’ Last Exam | 31.8 | 25.7 | +6.1 poin; +23.7% | Perilaku agen umum lebih kuat |
| Codeforces rating | 3,471 | 3,348 | +123 poin peringkat | Pemrograman kompetitif lebih baik |
| GPQA Diamond | 90.9 | 92.4 | −1.5 poin | V4 Pro tetap unggul |
| HLE without tools | 36.8; 39.1 pada subset teks | 42.7 pada subset teks | −3.6 poin pada subset teks yang sebanding | V4 Pro tetap unggul |

Hasilnya multidimensi: V4.1 Flash jelas lebih baik untuk agen coding, operasi terminal, otomasi, tugas keamanan, penggunaan tool, visi, konkurensi, dan biaya. Keunggulan yang tersisa pada V4 Pro terkonsentrasi pada tes penalaran murni tertentu. Karena itu, beban kerja sebaiknya dievaluasi menurut campuran tugas alih-alih klaim agregat tunggal.
Mengapa DeepSeek V4.1 Flash Lebih Efisien daripada V4 Pro?
Komputasi input dan output yang asimetris
V4.1 Flash mengaktifkan 8B parameter saat memproses input dan 16B saat menghasilkan output. Desain asimetris ini menargetkan kebutuhan komputasi yang berbeda dari prefill dan dekode, mengurangi biaya tanpa memaksa kedua tahap melalui anggaran parameter aktif yang sama.
Jejak tembolok KV yang lebih kecil
DeepSeek melaporkan bahwa V4.1 Flash menggunakan seperempat HBM dan seperdelapan kapasitas SSD yang dibutuhkan oleh tembolok KV generasi sebelumnya. Grafik yang dipublikasikan menempatkan tembolok KV global sebesar 890 byte per token, dibandingkan dengan 3,514 byte untuk V4 Flash.
Input multimodal native dan konkurensi lebih tinggi
V4.1 Flash dapat menafsirkan gambar secara native dan mengekspos batas konkurensi terdokumentasi sebesar 2,500, lima kali angka V4 Pro saat ini yaitu 500. Perubahan tersebut penting untuk agen berbasis tangkapan layar, ekstraksi dokumen, pemecahan masalah visual, dan antrean produksi ber-volume tinggi.
Berapa Biaya DeepSeek V4.1 Flash Dibanding V4 Pro?
Jadwal API resmi saat ini memberi harga kedua rute secara terpisah. Per 1M token, V4.1 Flash berbiaya $0.003/$0.006 untuk input cache hit, $0.15/$0.30 untuk input cache miss, dan $0.60/$1.20 untuk output (off-peak/peak). V4 Pro berbiaya $0.022/$0.044, $0.66/$1.32, dan $1.98/$3.96 secara berurutan. Harga dapat berubah, jadi anggaran produksi harus merujuk ke halaman harga live.
Bagaimana Cara Migrasi dari DeepSeek V4 Pro atau V4 Flash ke V4.1 Flash?
Gunakan ID model produksi yang eksplisit
Gunakan deepseek-flash ketika Anda menginginkan V4.1 Flash. Nama deepseek-v4-flash dan deepseek-v4-flash-vision-exp yang lebih lama masih diarahkan ke V4.1 Flash, tetapi penamaan eksplisit membuat pemantauan dan rollback di masa depan lebih mudah diaudit. Gunakan deepseek-v4-pro ketika Anda sengaja menginginkan backend V4-Pro-0813 yang saat ini tercantum.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_DEEPSEEK_API_KEY",
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-flash",  # atau "deepseek-v4-pro"
    messages=[{"role": "user", "content": "Tinjau rencana migrasi ini."}],
)

print(response.choices[0].message.content)
Uji ulang perilaku, bukan hanya kompatibilitas endpoint
- Jalankan prompt representatif dalam mode berpikir dan non-berpikir; bandingkan keberhasilan tugas, jumlah token, dan latensi.
- Uji ulang skema tool, output JSON, perilaku Responses API, prefix completion, dan FIM jika digunakan.
- Tambahkan uji input gambar jika produk akan menggunakan kapabilitas visual native baru.
- Tetapkan ulang baseline anggaran menggunakan tarif peak dan off-peak alih-alih membawa asumsi V4 Pro sebelumnya.
- Lacak tingkat hit prompt cache karena ini dapat mendominasi biaya input pada skala besar.
Pilih backend yang dimaksud secara eksplisit
Rute deepseek-v4-pro saat ini memilih V4-Pro-0813. Tim sebaiknya mencatat versi model yang diresolusikan, tanggal evaluasi, set prompt, dan jendela harga sehingga perbandingan tetap dapat direproduksi jika perutean berubah lagi.
Beban Kerja Mana yang Paling Cocok untuk DeepSeek V4.1 Flash?
| Beban kerja | Pilihan yang direkomendasikan | Alasan |
|---|---|---|
| Agen pemrograman dan pemeliharaan repositori | V4.1 Flash | Skor DeepSWE, ProgramBench, NL2Repo, dan terminal lebih tinggi |
| Otomasi berbasis tool | V4.1 Flash | Skor Automation-Bench, HLE-with-tools, dan agen lebih tinggi |
| Asisten yang memahami gambar | V4.1 Flash | Pemahaman gambar native |
| Penyajian throughput tinggi atau sensitif biaya | V4.1 Flash | Konkurensi lebih tinggi dan harga token jauh lebih rendah |
| Reproduksi V4 Pro historis Akses dan evaluasi V4 Pro saat ini | V4 Pro | Rute resmi saat ini mengidentifikasi V4-Pro-0813 |
| Penalaran murni closed-book | Validasi pada data domain | V4 Pro tetap lebih tinggi pada GPQA Diamond dan HLE tanpa tools |
FAQ DeepSeek V4.1 Flash vs V4 Pro
Apakah DeepSeek V4.1 Flash lebih baik daripada V4 Pro?
Untuk sebagian besar dimensi produksi—agen coding, tugas terminal, otomasi, penggunaan tool, visi, throughput, dan harga—ya. V4 Pro masih memiliki skor yang lebih kuat pada GPQA Diamond dan HLE tanpa tools, jadi beban kerja penalaran murni harus diuji dengan prompt spesifik domain.
Apakah saya masih bisa memanggil deepseek-v4-pro?
Ya. Halaman API resmi saat ini mencantumkan deepseek-v4-pro sebagai V4-Pro-0813, dengan harga dan batas konkurensinya sendiri.
ID model apa yang harus digunakan integrasi baru?
Gunakan deepseek-flash untuk V4.1 Flash, atau deepseek-v4-pro untuk V4-Pro-0813. Jangan memperlakukan kedua ID sebagai alias.
Apakah ID model V4 Flash lama masih berfungsi?
DeepSeek menyatakan bahwa permintaan deepseek-v4-flash dan deepseek-v4-flash-vision-exp secara otomatis diarahkan ke V4.1 Flash dan ditagih dengan harga Flash baru. Memperbarui ID model yang dikonfigurasi tetap direkomendasikan demi kejelasan.
Apakah DeepSeek V4.1 Flash mendukung gambar?
Ya. Pemahaman gambar native merupakan bagian dari V4.1 Flash; API V4 Pro historis tidak menyediakan kapabilitas ini.
Apakah DeepSeek V4.1 Flash lebih murah daripada V4 Pro saat ini?
Ya. Jadwal resmi saat ini mencantumkan harga input cache hit, input cache miss, dan output yang lebih rendah untuk V4.1 Flash dibanding V4 Pro.
Haruskah saya mengharapkan output yang identik setelah migrasi?
Tidak. Kompatibilitas endpoint tidak menjamin jalur penalaran, pemilihan tool, penggunaan token, atau pemformatan yang identik. Jalankan ulang evaluasi produksi sebelum mengandalkan ambang batas yang sebelumnya digunakan.