Bangun dengan CometAPIButuh satu API untuk banyak model?Uji alur kerja di Playground, lalu buat API key saat model dan biayanya sesuai dengan use case Anda.
Eleven v4 vs Eleven v4 Turbo: Mana yang Harus Anda Pilih?
Here’s a concise, practical comparison and model-picking guide.
Voice quality
- v4: Highest naturalness and timbre fidelity; better long-form stability, nuanced prosody, fewer artifacts at slower synthesis speeds.
- v4 Turbo: Very good and production-ready, but slightly less natural at extreme speed/low-latency settings; occasional minor artifacts compared to v4.
Latency
- v4: Higher TTFT and overall latency; best for batch or non-interactive playback. Streaming works but isn’t tuned for ultra-low latency turns.
- v4 Turbo: Optimized for real-time; low TTFT and fast token-to-audio, designed for conversational turn-taking and interruptions.
API pricing
- v4: Higher per-character/minute rate.
- v4 Turbo: Lower cost per output unit; typically the cost-efficient choice for high-volume or always-on agents.
- Note: Exact rates vary by plan/region—check your dashboard or pricing page.
Streaming
- v4: Supports streaming playback; good for progressive delivery of long content but not ideal for sub-300 ms turn targets.
- v4 Turbo: Real-time streaming with partial audio chunks; strong for barge-in and quick backchannels in interactive use.
CometAPI access
- v4: Limited or not optimized for Comet real-time endpoints.
- v4 Turbo: Full/primary support for Comet-style low-latency streaming and event-driven playback.
Choose the right model
Use v4 when:
- Highest voice fidelity is the top priority (narration, audiobooks, trailers, branded content).
- You can tolerate higher latency (pre-render, batch jobs, non-interactive playback).
- Long-form script stability and prosody nuance matter more than speed.
Use v4 Turbo when:
- You’re building interactive agents, IVR, live assistants, or any voice UX with tight latency budgets.
- You need cost efficiency at scale without sacrificing too much quality.
- You rely on real-time streaming, barge-in, quick turn-taking, and CometAPI endpoints.
Practical routing tips
- For dynamic agents: default to v4 Turbo. Enable streaming with small chunking and immediate playback.
- For content pipelines: default to v4. Pre-render and quality-check before distribution.
- Hybrid: route short, interactive responses to v4 Turbo; route long, polished monologues or final takes to v4.
Pilih Eleven v4 untuk buku audio, narasi, dan performa karakter ketika kualitas produksi menjadi prioritas. Pilih Eleven v4 Turbo untuk agen suara dan aplikasi interaktif ketika waktu respons penting. ElevenLabs menyatakan keduanya memiliki jangkauan ekspresif yang sama; laju karakter API yang dipublikasikan Turbo 50% lebih rendah. Buat keputusan akhir menggunakan skrip Anda sendiri, uji dengar, dan pengukuran latensi end-to-end.
Key Takeaways
Untuk audio terproduksi: Mulai dengan varian standar dan evaluasi penyampaian, konsistensi, serta upaya pengeditan.
Untuk interaksi langsung: Mulai dengan Turbo dan ukur waktu lengkap dari input pengguna hingga respons terdengar.
Untuk biaya: Laju karakter yang dipublikasikan Turbo 50% lebih rendah, sebelum mempertimbangkan percobaan ulang atau layanan lain.
Untuk tolok ukur: Hasil preferensi yang dipublikasikan membandingkan model standar dengan sistem pesaing; hasil tersebut tidak menetapkan margin kualitas langsung atas Turbo.
Ditinjau untuk kejelasan, atribusi sumber, dan terminologi API terkini.
Untuk integrasi: Streaming native dan generasi asinkron pihak ketiga memiliki persyaratan operasional yang berbeda.
Eleven v4 vs v4 Turbo at a Glance
Dimensi — spesifikasi native; harga native
Eleven v4
Eleven v4 Turbo
Beban kerja utama
Narasi terproduksi, buku audio, dan performa karakter
Agen waktu nyata dan ucapan interaktif
ID model
eleven_v4
eleven_v4_turbo
Bahasa
90+
90+
Harga native
$0.08 / 1,000 characters
$0.04 / 1,000 characters
Latensi inferensi median
Tidak ada angka yang sebanding yang diidentifikasi
~100 ms
Waktu median hingga ucapan pertama
Tidak ada angka yang sebanding yang diidentifikasi
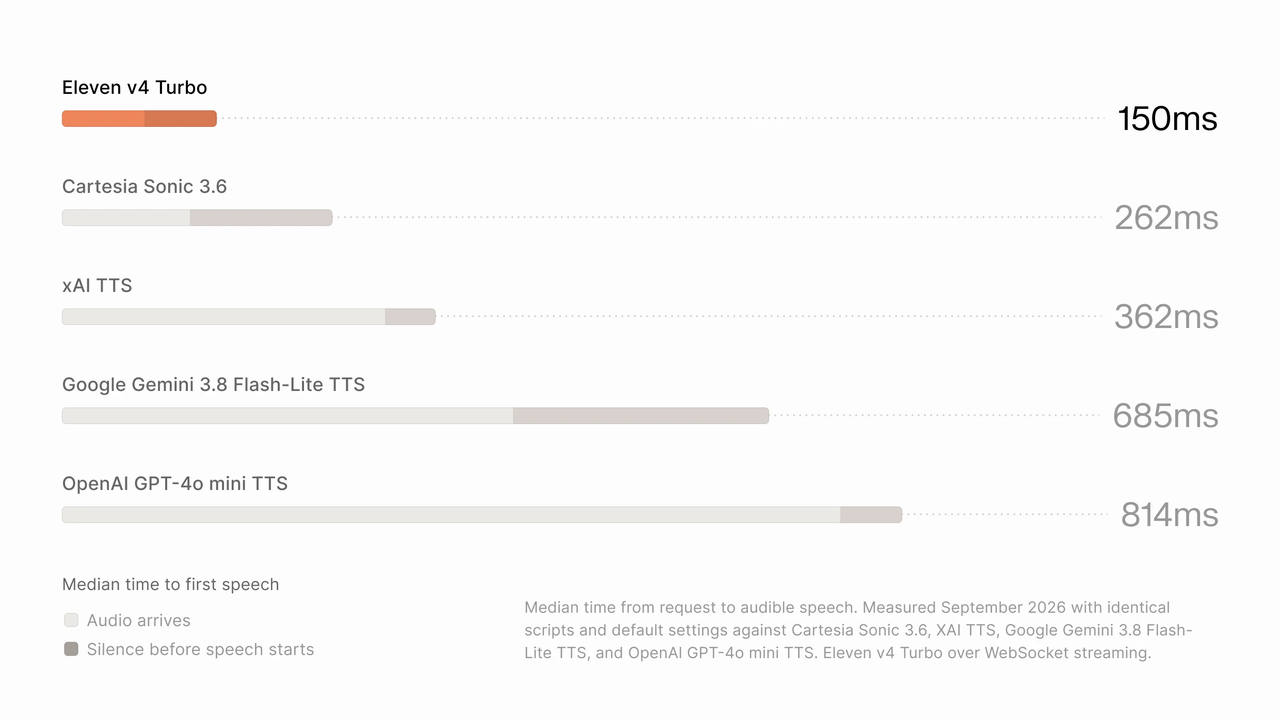
~150 ms median request-to-audible-speech time over WebSocket; measured network latency excluded
Suara terdaftar per koneksi Text to Dialogue WebSocket
Hingga 10
Tepat 1
Angka 150 ms berasal dari perbandingan ElevenLabs pada September 2026 menggunakan skrip identik dan pengaturan default. Angka tersebut mengukur awal ucapan terdengar, bukan total penundaan percakapan agen suara. Batas pendaftaran suara berlaku untuk endpoint Text to Dialogue WebSocket.
Eleven v4 vs v4 Tu
Eleven v4 vs v4 Turbo: Gambaran Umum dan Spesifikasi
Eleven v4: Audio Terproduksi dan Performa Multi-Pembicara
Posisi yang dipublikasikan model standar adalah produksi ucapan berkualitas tertinggi, termasuk dialog multi-pembicara yang natural dan narasi bentuk panjang. Hal itu menjadikannya kandidat pertama yang masuk akal ketika rekaman dapat ditinjau dan diedit sebelum rilis. Pertanyaan relevannya adalah apakah penyampaiannya tetap meyakinkan di seluruh paragraf lengkap dan baris yang dihasilkan ulang.
Eleven v4 Turbo: Ucapan Ekspresif Waktu Nyata
Eleven v4 Turbo dirancang untuk agen waktu nyata, asisten, dan karakter interaktif. ElevenLabs mengatakan model ini mempertahankan jangkauan ekspresif penuh Eleven v4 dan mendukung Professional Voice Clones, sambil memprioritaskan generasi berlatensi rendah.
Evaluasilah saat audio sedang di-stream dan diputar, karena klip terisolasi yang meyakinkan tidak membuktikan bahwa percakapan penuh merespons dengan cepat. Latensi inferensi yang rendah adalah spesifikasi awal, bukan jaminan untuk seluruh aplikasi.
Voiceover instruksional singkat mungkin terdengar sama-sama dapat diterima pada keduanya, sementara adegan dramatis mungkin mengungkap perbedaan yang membenarkan generasi yang lebih mahal.
Arsitektur dan Cakupan Evaluasi
Pengumuman arsitektur resmi menjelaskan Eleven v4 dibangun di atas arsitektur yang sepenuhnya baru dan menyatakan Turbo menghadirkan teknologi yang sama untuk kasus penggunaan berlatensi rendah. Tidak ada detail yang cukup diungkapkan untuk membandingkan jumlah parameter, struktur layer, komputasi pelatihan, atau perubahan spesifik yang bertanggung jawab atas perbedaan kecepatan. Anggap detail tersebut sebagai tidak diungkapkan alih-alih menyimpulkan bahwa Turbo lebih kecil atau hasil distilasi.
Batas Native dan Kontrol Suara
Periksa batas input untuk model dan endpoint yang Anda rencanakan sebelum membagi skrip panjang. Batas yang dipublikasikan untuk satu antarmuka tidak secara otomatis berlaku untuk antarmuka lain, dan ketiadaan batas tidak berarti input tak terbatas.
Kedua varian menawarkan kontrol Stability dan Similarity. Saat Anda memilih Professional Voice Clone dengan Eleven v4, sebuah slider Clone Strength tambahan menyesuaikan seberapa erat keluaran mengikuti rekaman pelatihan clone. Nilai yang lebih rendah memungkinkan penyampaian lebih fleksibel dengan sedikit penghalusan suara; nilai yang lebih tinggi mempertahankan lebih banyak performa asli dan ciri vokal yang khas, termasuk aksen. ElevenLabs merekomendasikan memulai di 0% untuk sebagian besar suara. Slider Style dan Speed tidak tersedia dalam pengalaman v4 native, dan SSML tidak didukung.
Implikasi praktis untuk migrasi: pertahankan makna instruksi suara Anda yang ada, tetapi tinjau bagaimana instruksi tersebut diungkapkan. Skrip lama yang berat SSML sebaiknya diadaptasi dan diuji dengar, bukan disalin begitu saja.
Eleven v4 vs v4 Turbo: Kinerja
Tolok Ukur yang Dipublikasikan dan Batas Sumber
Dua hasil resmi penting di sini: preferensi pendengaran dan latensi respons. Keduanya menjawab pertanyaan yang berbeda.
Bukti yang dipublikasikan — metodologi tolok ukur resmi
Hasil yang dilaporkan
Apa yang ditegaskannya
Uji preferensi buta model standar
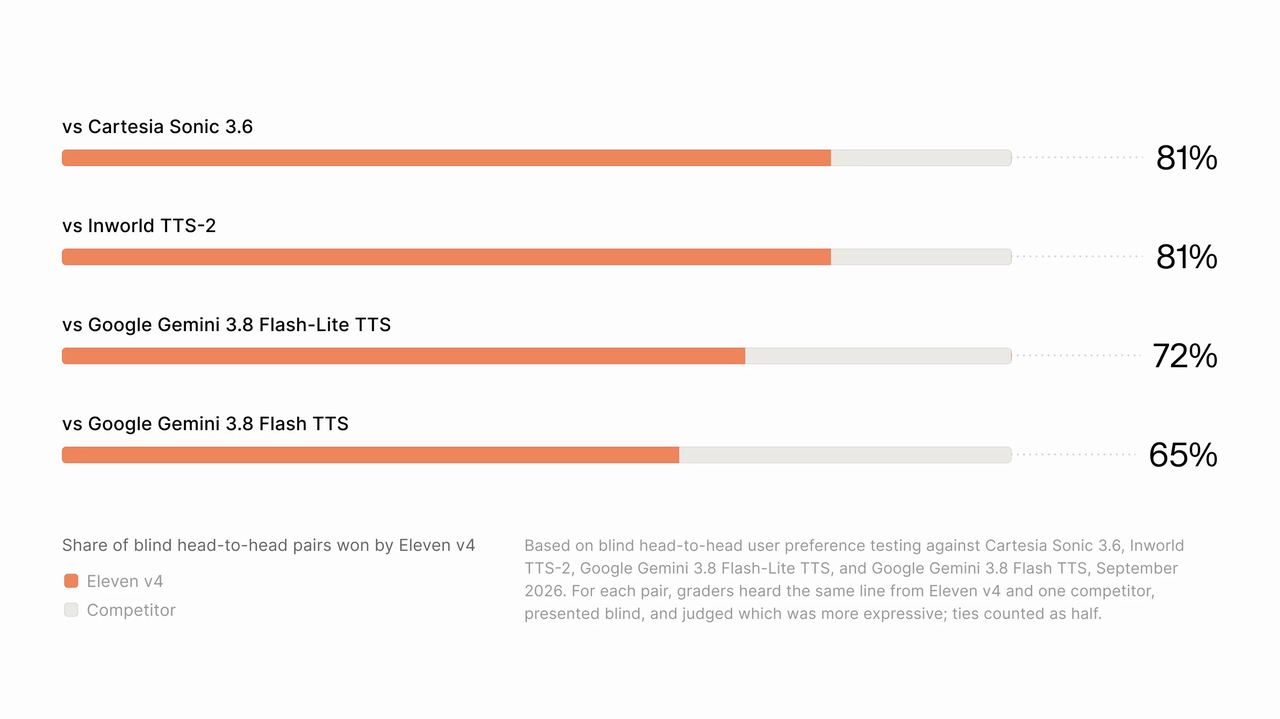
Sekitar 75% preferensi keseluruhan; hasil grafik 65%–81%
Preferensi pendengar dibanding model pesaing yang diuji
Latensi inferensi median Turbo
Sekitar 100 ms
Klaim pengukuran waktu inferensi model
Waktu median hingga ucapan pertama Turbo
Sekitar 150 ms
Waktu permintaan hingga ucapan terdengar dalam setelan uji
Uji dengar yang dipublikasikan membandingkan Eleven v4 dengan model ucapan pesaing. Uji tersebut tidak menetapkan seberapa besar, jika ada, pendengar lebih menyukai model ini dibanding Eleven v4 Turbo. Untuk pilihan itu, bandingkan kedua varian menggunakan skrip dan suara yang sama dalam uji dengar buta Anda sendiri.
Official ElevenLabs preference chart. Bagan ini membandingkan Eleven v4 dengan model ucapan pesaing; tidak mengukur kesenjangan kualitas langsung terhadap Turbo.
Bagan latensi resmi ElevenLabs. Waktu yang dilaporkan mengecualikan latensi jaringan yang terukur.
Kondisi Evaluasi
Studi pendengaran resmi September 2026 menggunakan perbandingan berpasangan buta dari baris yang sama antara Eleven v4 dan model pesaing, menilai ekspresivitas dan kealamian; hasil imbang dihitung setengah. Sistem yang dibandingkan dan tingkat preferensi per sistem tercantum dalam bagan resmi di bawah ini. Ini adalah hasil yang dilaporkan vendor yang membandingkan Eleven v4 dengan sistem pesaing. Hasil tersebut tidak mengukur perbedaan kualitas pendengaran antara Eleven v4 dan Eleven v4 Turbo.
Perbandingan latensi September 2026 menggunakan skrip identik dan pengaturan default, menghapus latensi jaringan yang terukur untuk setiap sistem, dan menjalankan Turbo melalui streaming WebSocket. Angka 150 ms mengukur waktu dari permintaan hingga ucapan terdengar; ini adalah metrik yang berbeda dari angka inferensi sekitar 100 ms. Metodologi yang dikutip tidak menyediakan rincian lengkap perangkat keras, wilayah, beban, dan ukuran sampel, sehingga tidak menetapkan jaminan latensi produksi.
Kualitas Suara dan Konsistensi Produksi
ElevenLabs menyoroti dukungan Professional Voice Clone, peningkatan konsistensi pembicara di baris yang dihasilkan ulang, dan penyambungan permintaan untuk audio bentuk panjang. Evaluasi klaim ini dengan sebuah paragraf penuh dan satu baris pengganti yang disisipkan ke rekaman yang ada.
Untuk audio rekaman, pisahkan penyampaian ekspresif dari konsistensi produksi. Dengarkan penekanan, emosi, pengucapan dan apakah pembicara yang sama tetap mudah dikenali di seluruh paragraf. Model standar adalah opsi vendor yang mengutamakan kualitas, tetapi skrip instruksional sederhana mungkin tidak menyingkap perbedaan yang berguna. Bandingkan take yang diterima alih-alih berasumsi bahwa generasi berharga lebih tinggi selalu memerlukan lebih sedikit pengeditan.
Pengarahan Suara dan Penyampaian Multibahasa
Kedua varian mendukung penyampaian ekspresif, tetapi ekspresi yang bermanfaat bergantung pada skrip dan suara yang Anda pilih. Mulailah dengan sejumlah kecil arahan yang jelas, lalu dengarkan apakah arahan tersebut meningkatkan makna yang dimaksud.
Respons dukungan yang meyakinkan dapat menggabungkan nada hangat dengan jeda singkat:
[warm, reassuring] I found your reservation.
[short pause] Let me confirm the arrival time with you.
Ini adalah prompt ilustratif, bukan hasil kinerja yang terukur. Ujilah berdampingan dengan versi tanpa tag. Arahan tambahan hanya berguna ketika benar-benar memperbaiki keluaran.
Lokalisasi juga layak mendapat sesi dengar tersendiri. Menurut panduan produk native, generasi dalam bahasa yang sama mempertahankan aksen asli suara referensi, sementara generasi lintas bahasa mengadopsi pengucapan bahasa target yang natural alih-alih membawa aksen bahasa sumber.
Perilaku itu mungkin sesuai untuk tutorial produk yang dilokalkan, tetapi karakter fiksi dengan aksen asing yang sengaja dikenali mungkin memerlukan arahan tambahan. Evaluasi pengucapan, identitas, dan aksen yang dimaksud secara terpisah; sebuah suara dapat terdengar fasih namun tidak memenuhi brief kreatif.
Latensi dan Keandalan
Untuk agen suara produksi, sintesis ucapan hanyalah bagian dari penundaan. Pengenalan ucapan, deteksi giliran, keluaran model bahasa, perjalanan jaringan, dan buffering audio semuanya dapat memengaruhi kapan pengguna mendengar respons.
Ukur waktu respons median dan ekor lambat dalam aplikasi Anda sendiri. Median yang rendah bisa berdampingan dengan jeda sesekali yang membuat percakapan terasa menjengkelkan.
Eleven v4 vs v4 Turbo: Biaya
Harga Karakter API Resmi
Perbandingan API native di bawah ini menggunakan tarif yang dipublikasikan dan diperiksa pada 19 Oktober 2026. Total volume adalah perhitungan dari tarif tersebut, bukan penawaran paket terpisah.
Penggunaan — harga API resmi
Varian standar
Varian Turbo
Penghematan yang dihitung dengan Turbo
1,000 characters
$0.08
$0.04
$0.04
100,000 characters
$8.00
$4.00
$4.00
1 million characters
$80.00
$40.00
$40.00
10 million characters
$800.00
$400.00
$400.00
Angka-angka ini menjelaskan generasi ucapan berbasis karakter, bukan tagihan agen suara secara keseluruhan. Jatah langganan, layanan lain, dan ketentuan komersial yang berlaku perlu dipertimbangkan secara terpisah.
Harga dan Ketentuan Penagihan CometAPI
CometAPI menampilkan harga dalam denominasi token, sementara tarif native di atas adalah per karakter. Bandingkan biaya hanya setelah mengonfirmasi bagaimana endpoint yang dipilih mengukur dan menagihkan penggunaan. Jika Anda memerlukan Turbo, konfirmasikan bahwa model tersebut tersedia pada rute CometAPI yang Anda pilih sebelum merencanakan integrasi.
Biaya per Rekaman atau Interaksi yang Diterima
Untuk penganggaran, gunakan:
Biaya pembuatan ucapan = karakter yang ditagihkan ÷ 1,000 × tarif karakter yang berlaku
Untuk produksi konten, ukuran operasional yang lebih berguna adalah biaya per rekaman yang diterima. Sertakan take yang dihasilkan ulang dan waktu pengeditan. Jika varian yang lebih murah berulang kali gagal pada performa sulit, keunggulan harga satuannya bisa menyusut.
Untuk agen live, bandingkan biaya interaksi yang diselesaikan pada kualitas dan waktu respons yang Anda butuhkan. Tagihan sintesis yang rendah memiliki nilai terbatas jika pengguna meninggalkan percakapan yang lambat atau membingungkan.
Eleven v4 vs v4 Turbo: Perbandingan dan Pemilihan
Pemilihan Berdasarkan Kapabilitas dan Beban Kerja
Rekomendasi berikut menggabungkan posisi yang dipublikasikan dengan kriteria evaluasi praktis. Ini adalah titik awal untuk pengujian, bukan hasil tolok ukur tambahan.
Proyek
Titik awal yang direkomendasikan
Evaluasi yang menentukan
Buku audio atau dokumenter
Varian standar
Konsistensi di seluruh paragraf dan baris yang dihasilkan ulang
Adegan karakter dramatis
Varian standar
Penyampaian emosional dan interaksi antarpembicara
Agen dukungan pelanggan
Turbo
Waktu respons terdengar, pengucapan, dan penanganan interupsi
Karakter gim interaktif
Turbo
Responsivitas dan kinerja selama giliran pendek
Klip instruksional sederhana
Uji keduanya
Apakah pendengar menyadari perbedaan kualitas yang berarti
Produksi multibahasa
Uji keduanya per bahasa
Pengucapan, aksen, dan identitas suara
Produk dengan audio rekaman dan live
Routing terpisah per beban kerja
Apakah tiap rute memenuhi kriteria penerimaan masing-masing
Untuk buku audio, iklan, dan adegan dramatis, uji Eleven v4 dengan satu paragraf netral, satu paragraf emosional, dan satu baris yang dihasilkan ulang disisipkan ke rekaman yang ada. Dengarkan konsistensi identitas suara, tempo, dan pengucapan di titik sambungan. Pilih varian standar ketika performa yang diterima atau waktu yang dihemat dalam pengeditan membenarkan tarif generasi yang lebih tinggi.
Untuk agen dukungan dan karakter interaktif, uji Turbo sepanjang percakapan lengkap: ucapan pengguna, deteksi giliran, generasi respons, sintesis, dan pemutaran. Sertakan koneksi lambat, kegagalan koneksi, dan interupsi. Pastikan pemutaran berhenti segera saat pengguna menyela dan respons berikutnya dimulai dengan bersih. Pilih Turbo ketika model tersebut memenuhi ambang kualitas pendengaran Anda dan target waktu respons Anda.
Bangun set uji representatif: masukkan penjelasan netral, respons yang menenangkan, paragraf emosional, nama atau singkatan, dan teks multibahasa yang digunakan audiens Anda.
Pertahankan skrip, suara, dan pengaturan keluaran sekurang-kurangnya sebanding sejauh yang diizinkan tiap antarmuka.
Tinjau rekaman tanpa label model. Catat kesalahan pengucapan, ketidakkonsistenan identitas suara, dan koreksi yang diperlukan tiap take.
Ukur waktu respons live secara terpisah dari kualitas pendengaran, termasuk latensi median dan keterlambatan ekor lambat.
Tetapkan ambang penerimaan sebelum memilih rute: pengucapan, konsistensi suara, upaya pengeditan, waktu respons median, dan waktu respons ekor lambat.
Jalankan trafik representatif melalui endpoint yang akan Anda gunakan di produksi. Lacak keluaran yang ditolak, percobaan ulang, serta kegagalan pemutaran atau koneksi.
Bandingkan biaya per rekaman yang diterima atau interaksi yang diselesaikan, termasuk take yang dihasilkan ulang dan upaya pengeditan.
Untuk produk dengan audio prarekam dan live, uji routing terpisah dan konfirmasikan bahwa setiap rute memenuhi ambang penerimaan masing-masing.
Di Mana Anda Dapat Mengakses Eleven v4 dan v4 Turbo?
Akses dari Penyedia Resmi
Gunakan rute penyedia native yang sesuai dengan beban kerja: ucapan dan dialog yang dihasilkan untuk audio terproduksi, dan streaming Text to Dialogue WebSocket untuk interaksi Turbo. Contoh resmi di bawah ini mendokumentasikan koneksi streaming dan batasan pendaftaran suara. Verifikasi skema endpoint saat ini, persyaratan autentikasi, dan batas akun sebelum menghubungkan beban kerja produksi.
Referensi yang sama menyebutkan tepat satu suara yang terdaftar per koneksi Turbo, dibanding hingga sepuluh untuk varian standar pada endpoint tersebut. Ini adalah aturan tingkat koneksi, bukan pernyataan universal tentang setiap antarmuka.
Akses CometAPI
Eleven v4 API di CometAPI menyediakan rute untuk menghasilkan ucapan melalui antarmuka yang kompatibel dengan Runway. Pengumuman integrasi 10 Oktober 2026 mendokumentasikan perilaku spesifik penyedia yang diringkas di bawah ini.
Detail integrasi — pengumuman CometAPI
Perilaku yang dipublikasikan
ID model
eleven_v4
Endpoint pengiriman
POST /runwayml/v1/text_to_speech
Pemrosesan
Pengajuan tugas asinkron
Keluaran
Audio MP3
Batas input
Hingga 2,500 karakter per permintaan
Konfigurasi suara
Suara preset
Kontrol tambahan yang diekspos
Kecepatan ucapan dapat diatur
Ini adalah detail integrasi spesifik penyedia. Batas 10.000 karakter native dan kontrol UI native tidak boleh disubstitusikan untuk perilaku antarmuka yang didokumentasikan ini. Demikian pula, alur kerja asinkron tidak menetapkan bahwa performa WebSocket Turbo native tersedia melalui rute ini.
Urutan integrasi yang praktis adalah mengirimkan skrip pendek, mengikuti alur status tugas yang didokumentasikan, mengambil hasilnya, dan memeriksa pengucapan serta durasi keluaran sebelum meningkatkan volume.
Kesimpulan
Pilih Eleven v4 ketika rekaman yang diterima memberikan kualitas performa atau penghematan produksi yang cukup untuk membenarkan tarif karakter yang lebih tinggi. Pilih Eleven v4 Turbo ketika model tersebut melewati ambang pendengaran Anda dan mendukung responsivitas yang dibutuhkan untuk percakapan live. Buat keputusan akhir pada endpoint yang akan Anda gunakan di produksi, dengan skrip representatif, percobaan ulang, dan total biaya operasional yang disertakan.
FAQ
Bagaimana cara membagi skrip Eleven v4 yang panjang untuk produksi?
Bagi di batas paragraf, kalimat, atau adegan ketimbang di tengah kata atau giliran pembicara. Sisakan ruang untuk teks arahan apa pun di dalam batas input yang diizinkan endpoint, catat skrip dan pengaturan suara untuk tiap segmen, dan uji sambungannya setelah menyusun audio. Bandingkan loudness, tempo, pengucapan, dan identitas suara di batas tersebut; menerima tiap klip secara individual tidak membuktikan bahwa rekaman gabungan mulus. Gunakan batas dari endpoint penyedia aktual, karena batas permintaan native dan CometAPI berbeda.
Bagaimana cara mencoba ulang permintaan Eleven v4 yang terinterupsi?
Lacak pengenal permintaan atau tugas asli dan tentukan statusnya sebelum mengirimkan teks yang sama lagi. Untuk alur kerja penyedia asinkron, periksa apakah tugas asli telah selesai dan apakah hasilnya masih dapat diambil. Untuk stream live, catat audio mana yang sudah diputar dan putuskan apakah akan memutar ulang ujaran atau memulihkan di batas yang bersih. Konfirmasikan aturan retry, idempoten, dan penagihan endpoint; jangan berasumsi bahwa mengulang permintaan itu gratis atau menghasilkan audio identik.
Bagaimana tim dapat melakukan regression test rilis suara Eleven v4?
Pertahankan set penerimaan tetap yang berisi nama merek, singkatan, angka, pengucapan sulit, paragraf emosional, dan bahasa yang digunakan produk. Arsipkan skrip, pengenal model, pengenal suara, pengaturan yang tersedia, tanggal generasi, dan rekaman referensi yang diterima. Ketika model, suara, atau integrasi berubah, dengarkan sampel baru terhadap referensi tersebut dan dokumentasikan koreksi yang diperlukan. Pisahkan prosedur uji yang dapat direproduksi dari asumsi waveform identik: lolos satu rekaman tidak menjamin setiap generasi berikutnya akan lolos.