
Ringkas
Google mengumumkan Gemini 4 Argon pada 30 September 2026 sebagai model frontier untuk alur kerja kompleks yang berjalan lama. Hasil yang dipublikasikan menunjukkan pola jelas: kinerja kuat dalam pekerjaan pengetahuan profesional, tugas berkonteks panjang, dan evaluasi rekayasa perangkat lunak tertentu, dengan hasil yang lebih lemah pada beberapa tolok ukur terminal dan penggunaan komputer. Google memperkenalkan model ini melalui peluncuran bertahap. Terpisah, CometAPI melaporkan ketersediaan di katalog per 1 Oktober; kelayakan akun dan permintaan uji yang berhasil harus diperiksa sebelum penerapan. Cerita kinerja yang lebih berguna adalah di mana peningkatannya muncul.
Argon meraih 68,9% pada Vals Index, 65,4% pada Vals Finance Agent v2, 77,9% pada DeepSWE v1.1, 91,7% pada LVBench, dan 84,2% pada GraphWalks pada konteks 256K–1M. Pada saat yang sama, model ini berada di belakang model frontier pesaing pada FrontierSWE v2, Terminal-Bench 4.0, Terminal-Bench Science, dan OSWorld-2.0.
Hasil ini mendukung pandangan spesifik beban kerja untuk Argon. Skor terkuatnya mengelompok di sekitar pekerjaan pengetahuan profesional, tugas berkonteks sangat panjang, dan evaluasi multimodal serta rekayasa perangkat lunak yang dipilih. Model lain tetap unggul pada beberapa tes terminal dan penggunaan komputer.
Poin Utama
- Gemini 4 Argon paling kuat dalam pekerjaan pengetahuan perusahaan, penalaran konteks panjang, pemahaman multimodal, dan beberapa evaluasi pengodean horizon panjang.
- Batas keluaran maksimum 1 juta token memberikan kelonggaran generasi lebih besar untuk lintasan penalaran panjang; tidak menetapkan spesifikasi konteks input publik.
- Argon memimpin beberapa hasil pekerjaan-pengetahuan dan konteks panjang yang dipublikasikan, tetapi GPT-6 Astra dan Claude Opus 5.5 tetap unggul pada evaluasi pengodean dan penggunaan komputer tertentu.
- Skor tolok ukur menggambarkan konfigurasi model-dan-agen tertentu. Metrik, kondisi input, dan pengaturan evaluasi sama pentingnya dengan persentase utama.
- Peluncuran Google dan akses CometAPI adalah klaim ketersediaan terpisah. Verifikasi rute aktif, pengenal model, dan kelayakan akun sebelum memigrasikan trafik.
Apa Itu Gemini 4 Argon?
Gemini 4 Argon adalah model Gemini frontier baru dari Google DeepMind, dibangun untuk alur kerja sulit yang membutuhkan penalaran melalui banyak langkah alih-alih menjawab satu prompt pendek.
Posisioning resmi Google menekankan rekayasa perangkat lunak dunia nyata, pekerjaan pengetahuan perusahaan seperti hukum dan keuangan, keamanan siber defensif, pemahaman multimodal, dan tugas agenik yang berjalan lama.
Ini adalah pembedaan penting dari rilis Flash terbaru. Gemini 3.8 Flash API di CometAPI dirancang sebagai andalan berbiaya lebih rendah untuk beban kerja agenik berskala besar. Argon justru mewakili ujung frontier dari tumpukan Google, memprioritaskan kedalaman dan eksekusi berkelanjutan.
Spesifikasi Model
| Spesifikasi | Gemini 4 Argon |
|---|---|
| Pengembang | Google DeepMind |
| Diumumkan | 30 September 2026 |
| Keluarga model | Gemini 4 |
| Posisioning | Model penalaran frontier dan horizon panjang |
| Keluaran maksimum | 1,000,000 tokens |
| Evaluasi konteks panjang | Diuji hingga 256K–1M pada GraphWalks |
| Batas konteks input publik | Tidak ditentukan secara formal dalam tabel spesifikasi API publik standar saat peluncuran |
| Pemahaman multimodal | Ya; mencakup evaluasi grafik, dokumen, dan video panjang |
| Pengodean agenik | Ya |
| Penggunaan komputer | Dievaluasi |
| Keamanan siber | Kemampuan defensif khusus |
| ID model API publik Google | Tidak diumumkan dalam dokumentasi publik awal Google; CometAPI menggunakan gemini-4-argon sebagai pengenal katalog. |
Anggaran Keluaran dan Kompromi
Google mengumumkan batas keluaran maksimum 1 juta token untuk Argon, naik dari batas 64K yang dikutip dalam pengumuman peluncuran. Ini memberikan kelonggaran untuk lintasan penalaran yang lebih panjang. Ini tidak boleh ditafsirkan sebagai anggaran total yang dijamin untuk seluruh sesi agen multi-panggilan, atau sebagai bukti bahwa setiap tugas akan meningkat.
Keluaran maksimum bukan berarti kecerdasan. Memberi model lebih banyak token keluaran tidak otomatis membuatnya lebih mampu; itu menghilangkan satu potensi hambatan. Model tetap harus menggunakan anggaran tersebut secara produktif.
Ada juga kompromi biaya dan latensi. Model yang benar-benar mengonsumsi ratusan ribu token yang dihasilkan bisa mahal dan lambat bahkan ketika harga per token nominal terlihat menarik.

Hasil tolok ukur terpilih yang direproduksi dari artikel. Bandingkan model dalam setiap baris; metrik dan kondisi evaluasi berbeda. Grafik ini menggantikan karya seni gradien dekoratif dan bukan representasi pengujian independen.
Batas keluaran maksimum dan jendela konteks input menggambarkan kapasitas berbeda. Rentang evaluasi GraphWalks adalah bukti tentang input yang diuji, bukan pengganti spesifikasi API publik.
Bagaimana Kinerja Gemini 4 Argon pada Tolok Ukur?
Tabel kinerja Google DeepMind mencakup alur kerja agen, pekerjaan pengetahuan profesional, dan tugas multimodal. Nilai di bawah ini mereproduksi perbandingan yang dipublikasikan. Mereka mengukur kinerja tugas, bukan throughput token atau latensi respons; “—” berarti hasil tidak dilaporkan dalam perbandingan ini.
| Tolok ukur | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 | Kondisi evaluasi |
|---|---|---|---|---|---|
| Vals Index | 68.9% | 63.1% | 65.8% | 67.0% | Vals AI |
| AutomationBench | 51.3% | 41.4% | 31.4% | 42.5% | Set privat; papan peringkat Zapier |
| Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% | 58.6% | Vals AI |
| Harvey's Legal Agent | 19.6% | 5.4% | 6.7% | 3.8% | Vals AI |
| DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% | mini-swe harness; sumber campuran |
| FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% | Papan peringkat Proximal |
| Vibe Code Bench | 91.9% | 89.6% | 90.3% | 90.3% | Papan peringkat Vals AI |
| Terminal-Bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% | Uji mandiri / papan peringkat |
| PostTrainBench | 45.3% | 44.3% | 40.2% | 49.3% | v1.1; OpenCode; 10h; one H100 |
| Terminal-Bench Science 0.1 | 57.6% | 68.1% | 52.6% | 63.3% | Verifier timeout ×6 |
| LABBench 2 | 88.8% | 85.4% | 68.6% | 73.1% | Perkakas Linux; internet |
| RiemannBench | 76.0% | 72.0% | 65.6% | 69.6% | Papan peringkat Surge |
| GraphWalks hingga 128K | 99.7% | 98.7% | 91.4% | 90.6% | BFS F1; 650 item |
| GraphWalks 256K–1M | 84.2% | 71.8% | 65.0% | 66.8% | BFS F1; 200 item |
| Agent's Last Exam | 39.5% | 34.2% | — | 38.2% | Lulus biner; ALE-Claw; 5h |
| OSWorld-2.0 | 69.2% | 72.6% | — | — | Skor parsial offline; best of 3 runs |
| Chartography | 71.6% | 71.0% | 46.2% | 66.3% | Tanpa alat; papan peringkat Surge |
| LVBench | 91.7% | 87.5% | 79.7% | 83.7% | Tanpa alat; pengambilan sampel frame khusus model |
| CWE-bench v1 | 68.0% | 68.0% | 58.0% | 67.0% | pass@1; pass@4 memecahkan seri |
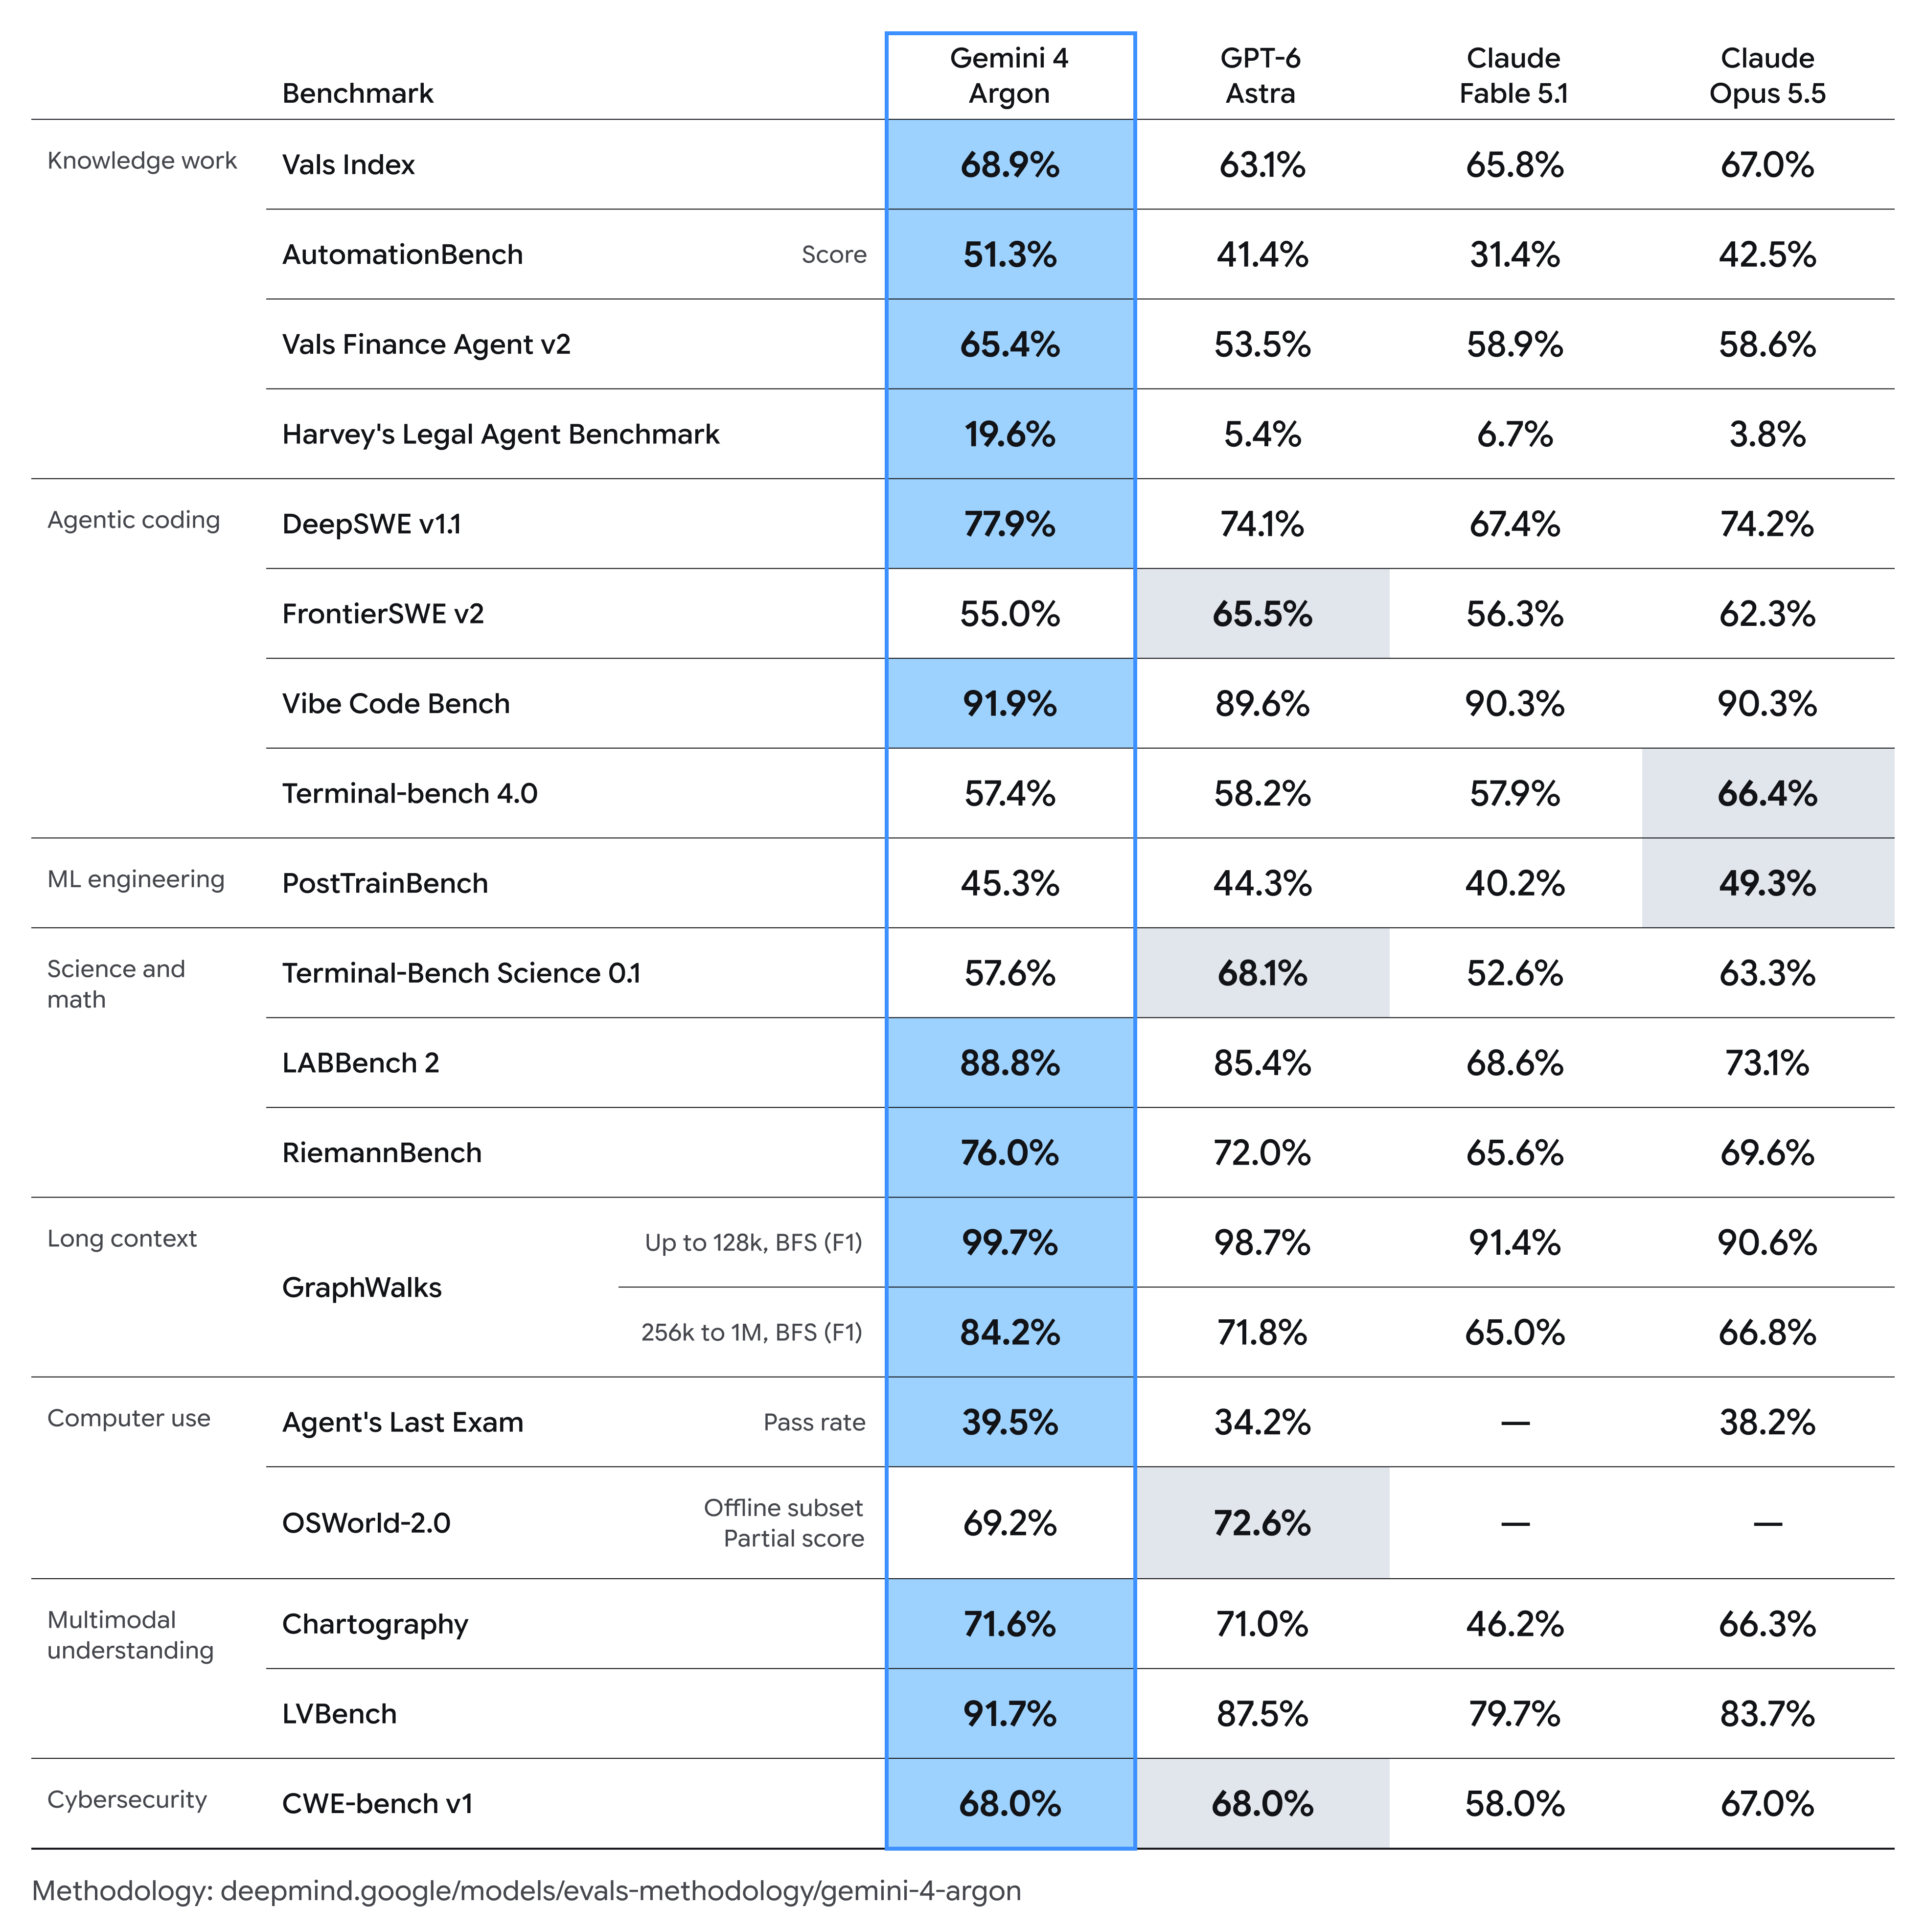
Perbandingan tolok ukur resmi Gemini 4 Argon dari Google
Kecuali dinyatakan sebaliknya, hasil Argon menggunakan satu percobaan dan pengaturan berpikir tertinggi. Hasil model lain umumnya berasal dari laporan penyedia, dengan pengecualian spesifik tolok ukur. LVBench menggunakan 1 FPS untuk Gemini, 800 frame untuk GPT-6 Astra, 300 untuk Fable 5.1 dan 600 untuk Opus 5.5. Input ini tidak identik, jadi bandingkan konfigurasi yang dilaporkan daripada memperlakukan setiap baris sebagai pengulangan terkontrol.
Kondisi Evaluasi dan Keterbatasan
Tabel ini berguna, tetapi tidak boleh ditafsirkan sebagai papan peringkat universal independen.
- Pemilihan tolok ukur adalah pilihan Google.
- Pengaturan evaluasi spesifik tolok ukur berbeda di seluruh baris, termasuk kerangka agen, anggaran waktu, alat, dan pengambilan sampel input.
- Metodologi resmi mengidentifikasi hasil pesaing yang dilaporkan penyedia sebagai default, dengan pengecualian papan peringkat dan perhitungan mandiri spesifik tolok ukur.
- Pengaturan tolok ukur tertinggi mungkin tidak mencerminkan konfigurasi inferensi produksi default.
- Satu skor tolok ukur utama saja tidak mengungkap penggunaan token, pemanggilan alat, percobaan ulang, waktu berlalu, atau intervensi manusia.
Untuk sistem produksi, metrik yang lebih baik sering kali adalah biaya per tugas yang berhasil diselesaikan daripada harga per token atau satu persentase tolok ukur.
Beban Kerja Apa yang Paling Cocok untuk Gemini 4 Argon?
Kinerja Pekerjaan Pengetahuan
Pola paling jelas dalam hasil Argon muncul pada pekerjaan pengetahuan profesional multi-langkah.
Pada Vals Index, Argon mencapai 68,9%, dibandingkan 67,0% untuk Claude Opus 5.5. Kesenjangan numerik sederhana, tetapi polanya menjadi lebih jelas dalam alur kerja khusus.
- Vals Finance Agent v2: 65,4%, 6,5 poin di atas pesaing terkuat yang ditampilkan di tabel Google.
- AutomationBench: 51,3%, 8,8 poin di atas Claude Opus 5.5.
- Tolok Ukur Agen Hukum Harvey: 19,6%, dibandingkan 6,7% untuk model tertinggi berikutnya yang dilaporkan.
Profil kinerja menunjukkan bahwa Argon paling diuntungkan ketika model harus mengumpulkan informasi, menyimpan state, bernalar lintas beberapa tahap, dan menghasilkan artefak profesional alih-alih sekadar menjawab pertanyaan tertutup.
Skor absolut agen hukum yang rendah juga penting. Skor 19,6% saja tidak mengungkap berapa banyak kriteria atau alur kerja lengkap yang gagal. Kesimpulan yang berguna adalah bahwa Argon menunjukkan peningkatan relatif besar pada evaluasi ini, sementara hasil tersebut tidak menetapkan otomatisasi pekerjaan hukum yang andal.
Penalaran Konteks Panjang
Keunggulan paling mencolok Argon mungkin pada GraphWalks versi 256K–1M.
- Gemini 4 Argon: 84,2%
- GPT-6 Astra: 71,8%
- Claude Opus 5.5: 66,8%
- Claude Fable 5.1: 65,0%
Itu adalah keunggulan 12,4 poin atas model terdekat dalam perbandingan yang dipublikasikan.
Kesenjangan jauh lebih kecil pada panjang konteks lebih pendek: pada GraphWalks hingga 128K, Argon meraih 99,7% dan GPT-6 Astra 98,7%. Ini menunjukkan bahwa Argon menurun kurang tajam dibandingkan model yang dibandingkan pada evaluasi konteks sangat panjang tertentu ini.
Apa yang belum diungkap Google adalah informasi arsitektural yang cukup untuk mengatribusikan perbedaan ini pada mekanisme perhatian tertentu, sistem pengambilan, resep pelatihan, atau strategi saat inferensi. Klaim seperti “Gemini 4 memperkenalkan arsitektur perhatian baru” akan melampaui bukti publik.
Kinerja Pengodean
Tabel tolok ukur resmi tidak mendukung jawaban sederhana ya.
Argon berkinerja sangat baik pada beberapa bentuk pengodean dan kalah jelas pada yang lain. Pada DeepSWE v1.1 mencapai 77,9%, versus 74,2% untuk Claude Opus 5.5 dan 74,1% untuk GPT-6 Astra. Skor Vibe Code Bench juga kuat di 91,9%.
- FrontierSWE v2: 55,0% Argon vs. 65,5% GPT-6 Astra.
- Terminal-Bench 4.0: 57,4% Argon vs. 66,4% Claude Opus 5.5.
- Terminal-Bench Science 0.1: 57,6% Argon vs. 68,1% GPT-6 Astra.
Perbedaan ini penting bagi pengembang. Argon tampak sangat kuat ketika pengodean menjadi alur rekayasa panjang dengan konteks dan perencanaan substansial, sementara eksekusi yang berat di terminal tetap lebih kompetitif. Tolok ukur migrasi repositori dan tolok ukur terminal interaktif tidak boleh dianggap sebagai ukuran “kemampuan pengodean” yang dapat dipertukarkan.
Keamanan Siber Defensif
Keamanan siber adalah area penerapan inti. Posisioning keamanan siber defensif Google mencakup penemuan, validasi, dan penambalan kerentanan secara otonom. Ini adalah klaim kemampuan penyedia; hasil CWE-bench di bawah mengukur remediasi kerentanan pada evaluasinya sendiri.
Pada CWE-bench v1, Argon meraih 68%, setara dengan GPT-6 Astra dan sedikit di depan Claude Opus 5.5 di 67%.
Google juga menyoroti pengamanan yang lebih kuat terhadap penyalahgunaan, injeksi prompt tidak langsung, perilaku agen berisiko, dan kompromi lingkungan eksekusi. Ini menjadikan Argon sama pentingnya sebagai rilis keamanan agen seperti peningkatan model konvensional.
Pemahaman Multimodal
Argon meraih 71,6% pada Chartography dan 91,7% pada LVBench untuk pemahaman video panjang. Hasil LVBench 4,2 poin persentase di atas GPT-6 Astra di tabel Google. Karena model menerima konfigurasi pengambilan sampel frame yang berbeda, ini adalah perbandingan setup yang dilaporkan, bukan keunggulan murni model saja.
Ini penting karena banyak alur kerja profesional tidak hanya teks. Agen riset keuangan mungkin perlu memeriksa grafik; asisten perusahaan mungkin menggabungkan laporan, PDF, dan tangkapan layar; sistem analisis video mungkin perlu mempertahankan peristiwa sepanjang urutan panjang alih-alih memproses frame individual secara independen.
Kombinasi persepsi multimodal dan penalaran berkelanjutan Argon karenanya lebih relevan daripada dukungan multimodal saja.
Kinerja Sains dan Matematika
Hasilnya beragam namun umumnya kuat. Argon mencapai 88,8% pada LABBench 2 dan 76,0% pada RiemannBench, di depan model yang dibandingkan pada tabel Google. Namun, pada Terminal-Bench Science 0.1, GPT-6 Astra meraih 68,1% dibandingkan 57,6% milik Argon.
Perbedaan tersebut mengarah pada pola yang lebih luas: Argon tampak lebih kuat dalam bernalar atas informasi ilmiah daripada pada setiap bentuk eksekusi ilmiah yang didorong oleh alat.
Kinerja Penggunaan Komputer
Pada Agent's Last Exam, Argon mencetak tingkat lulus biner 39,5%, di depan GPT-6 Astra di 34,2% dan Claude Opus 5.5 di 38,2%. Pada subset offline OSWorld-2.0, skor parsialnya 69,2%, di bawah 72,6% milik GPT-6 Astra. Nilai OSWorld bukan tingkat keberhasilan tugas penuh, dan entri Claude yang hilang tidak menyiratkan nol kemampuan.
Jadi data saat ini tidak menunjukkan keunggulan penggunaan komputer menyeluruh. Untuk penerapan produksi, skor tolok ukur sebaiknya dilengkapi dengan pengujian tingkat tugas atas akurasi navigasi, klik gagal, frekuensi ulang, tindakan yang tidak diinginkan, waktu penyelesaian, dan tingkat koreksi manusia.
Gemini 4 Argon vs GPT-6 Astra dan Claude
| Dimensi | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|---|---|
| Pekerjaan pengetahuan | Sangat kuat | Kuat | Sangat kuat | Kuat |
| Tolok ukur konteks panjang | Hasil terkuat yang dipublikasikan | Kuat | Sedang–kuat | Sedang |
| Pengodean horizon panjang | Sangat kuat | Sangat kuat | Sangat kuat | Kuat |
| Pengodean terminal | Kompetitif | Kuat | Terkuat pada uji terpilih | Kompetitif |
| Agen sains terminal | Kompetitif | Terkuat pada uji terpilih | Kuat | Kompetitif |
| Pemahaman multimodal | Sangat kuat | Sangat kuat | Kuat | Kompetitif |
| Penggunaan komputer | Kompetitif | Kuat | Campuran / perbandingan terbatas | Perbandingan terbatas |
| Keamanan siber | Terikat teratas pada CWE-bench v1 | Terikat teratas | Sangat dekat | Lebih rendah |
Argon menonjol dalam perbandingan ini untuk pekerjaan agenik berkonteks panjang, berat dokumen, dan profesional. Pengembang dapat membandingkannya dengan GPT-6 Astra, Claude Opus 5.5 dan Claude Fable 5.1 melalui CometAPI.
Pemilihan berbasis kinerja
Label kualitatif di atas merangkum tabel tolok ukur terpilih, bukan peringkat universal. Utamakan Argon untuk pilot ketika pekerjaan menyerupai evaluasi unggulannya; uji Astra dan Opus pada beban kerja yang berat terminal sebelum memilih default.
Spesifikasi dan kendala penerapan
Perbandingan kinerja ini tidak menetapkan keunggulan arsitektur atau pemenang harga-kinerja umum. Jumlah parameter dan arsitektur Argon tidak ditentukan dalam materi peluncuran Google yang ditinjau. Batas konteks input publiknya memerlukan dokumentasi API resmi. CometAPI melaporkan rute gemini-4-argon; konfirmasikan parameter yang didukung dan akses akun secara independen dari peluncuran lebih luas Google. Bandingkan batasan tiap rute dan biaya tugas aktual sebelum menerapkan.
Bagaimana Pengembang Mengakses Gemini 4 Argon melalui CometAPI?
CometAPI melaporkan model tersedia dengan nama gemini-4-argon. Gunakan dasbor akun untuk membuat kunci API, pilih pengenal tersebut di playground, dan jalankan permintaan uji sebelum integrasi. Contoh yang kompatibel dengan OpenAI menggunakan base URL https://api.cometapi.com/v1. Konfirmasikan endpoint dan parameter yang didukung model dalam dokumentasi akun; lencana katalog saja tidak memverifikasi panggilan yang berhasil.
- Buat akun CometAPI dan hasilkan kunci API di dasbor.
- Pilih gemini-4-argon dan validasi permintaan representatif di playground.
- Konfigurasikan klien yang kompatibel dengan base URL CometAPI, kunci Anda, dan pengenal model; konfirmasikan skema permintaan yang didukung dan penagihan sebelum penerapan.
CometAPI dan harga resmi
Google mengumumkan harga perkenalan $2 per juta token input dan $10 per juta token output, dengan input dalam cache diberi harga diskon 95% dari tarif input. Setelah periode perkenalan, tarif yang diumumkan adalah $4 input dan $20 output per juta token. Ini adalah tarif yang diumumkan Google, bukan harga CometAPI atau konfirmasi akses API umum langsung.
| Dasar penagihan | API Gemini 4 Argon di CometAPI | Pengumuman resmi Google | Perbandingan |
|---|---|---|---|
| Input / 1M token | $3.20 | $4.00 setelah periode perkenalan | 20% di bawah tarif pasca-perkenalan yang diumumkan |
| Output / 1M token | $16.00 | $20.00 setelah periode perkenalan | 20% di bawah tarif pasca-perkenalan yang diumumkan |
Kesimpulan
Profil tolok ukur Gemini 4 Argon lebih menarik daripada klaim papan peringkat sederhana.
Hasil terkuat dalam perbandingan ini mengelompok di sekitar pekerjaan pengetahuan profesional, konteks panjang, dan eksekusi agenik berkelanjutan. Pola ini berguna untuk pemilihan beban kerja, tetapi tidak mengidentifikasi arsitektur yang mendasari atau membuktikan mekanisme mana yang menyebabkan peningkatan.
Hasil keuangan, hukum, video panjang, dan rekayasa perangkat lunak yang dilaporkan mendukung pilot terfokus untuk beban kerja tersebut. Apakah keunggulan yang sama bertahan di produksi bergantung pada campuran input, kerangka agen, pengaturan inferensi, dan persyaratan verifikasi.
Pada saat yang sama, hasil menunjukkan bahwa kinerja model frontier semakin terspesialisasi. Argon bisa memimpin DeepSWE sambil tertinggal di FrontierSWE; memimpin Agent's Last Exam sambil tertinggal di OSWorld; dan memimpin LABBench sambil tertinggal di Terminal-Bench Science. Tolok ukur ini menekan bagian berbeda dari sistem agen.
Bagi pengembang, pelajaran terpenting adalah bahwa pemilihan model semakin perlu dilakukan pada tingkat beban kerja daripada merek atau keluarga.
FAQ
Bagaimana pengembang harus memvalidasi Gemini 4 Argon pada beban kerja mereka sendiri?
Bangun set tugas representatif dengan kriteria penerimaan eksplisit. Jaga agar alat, batas waktu, persiapan input, dan kebijakan percobaan ulang sebanding di seluruh model. Catat tugas yang selesai, total token, waktu berlalu, dan koreksi manusia. Mulai dengan pilot kecil dan periksa kasus kegagalan sebelum merutekan trafik produksi.
Dapatkah persentase tolok ukur Gemini 4 Argon dirata-rata menjadi satu skor?
Tidak. Tabel menggabungkan metrik berbeda, termasuk F1, tingkat kelulusan, dan skor parsial. Gunakan kriteria spesifik tugas daripada merata-rata semua persentase.
Haruskah agen Gemini 4 Argon selalu menggunakan anggaran keluaran penuhnya?
Tidak. Pilih anggaran terkecil yang teruji yang memenuhi persyaratan kualitas dan keandalan Anda. Batas keluaran maksimum adalah plafon, bukan target.
Bagaimana tim harus mengevaluasi akses Gemini 4 Argon melalui CometAPI?
Mulailah dengan pemeriksaan ketersediaan tingkat akun dan permintaan kecil menggunakan rute CometAPI yang didokumentasikan. Ukur kualitas respons, latensi, batasan, dan token yang ditagihkan, lalu terapkan uji penerimaan yang sama seperti untuk model alternatif. Perlakukan klaim akses CometAPI secara terpisah dari peluncuran lebih luas Google, dan pertahankan perutean dapat dikonfigurasi hingga rute memenuhi persyaratan Anda.