Bangun dengan CometAPIButuh satu API untuk banyak model?Uji alur kerja di Playground, lalu buat API key saat model dan biayanya sesuai dengan use case Anda.
GLM-5.3 Flash vs GLM-5.3: Model Z.ai mana yang sebaiknya Anda gunakan?
Catatan singkat: Vendor sering merilis varian “Flash” sebagai turunan yang lebih cepat dan hemat biaya dari model dasar. Poin-poin di bawah merangkum pola perbedaan yang lazim antara GLM-5.3 Flash dan GLM-5.3. Verifikasi angka spesifik pada dokumentasi resmi vendor.
Ringkasan perbedaan inti
- Fokus: GLM-5.3 memaksimalkan akurasi dan kemampuan penalaran; GLM-5.3 Flash memaksimalkan latensi rendah, throughput tinggi, dan biaya rendah.
- Trade-off: Flash umumnya sedikit mengorbankan akurasi pada tugas panjang/kompleks demi kecepatan dan efisiensi.
- Kecocokan: GLM-5.3 untuk beban kerja bernuansa dan kontekstual panjang; Flash untuk aplikasi interaktif, skala tinggi, dan biaya sensitif.
Spesifikasi inti
- Ukuran model: GLM-5.3 biasanya lebih besar; GLM-5.3 Flash lebih ringan (melalui distilasi, pruning, atau konfigurasi layer yang dioptimalkan).
- Panjang konteks: Model dasar cenderung menawarkan konteks lebih panjang; Flash bisa sama atau sedikit lebih pendek, bergantung konfigurasi.
- Fitur tool-use: Keduanya umumnya mendukung fungsi seperti tool/function calling, retrieval, dan kontrol sistem; performa tool chaining mendalam cenderung lebih stabil di model dasar.
- Latensi dan throughput: Flash menargetkan latensi per respons lebih rendah dan QPS lebih tinggi; model dasar lebih stabil pada respon panjang.
- Konsumsi memori: Flash biasanya memori GPU/CPU lebih hemat, lebih bersahabat untuk deployment skala besar.
- Stabilitas keluaran: Model dasar sering lebih konsisten pada instruksi kompleks dan keluaran panjang; Flash menitikberatkan respons cepat dengan stabilitas memadai pada prompt pendek-menengah.
Arsitektur dan optimisasi
- Optimisasi inference: Flash lazim memakai kombinasi kuantisasi (mis. 8-bit/4-bit), optimisasi KV-cache, speculative decoding, dan kernel yang dipercepat.
- Distilasi/kompresi: Flash sering merupakan model terdistil atau kompresi dari GLM-5.3 untuk mempertahankan sebagian besar kemampuan di ukuran/biaya lebih kecil.
- Variasi lapisan: Bisa ada pengurangan lebar/tinggi arsitektur atau adaptasi MoE ringan; model dasar tetap arsitektur penuh untuk akurasi maksimal.
- Stabilitas numerik: Model dasar mempertahankan presisi lebih tinggi; Flash menyeimbangkan presisi dan kecepatan.
Benchmark pengkodean (coding)
- Tugas pendek-menengah: Flash sering mendekati performa model dasar pada bug-fix kecil, snippet generation, dan refactor lokal.
- Tugas kompleks: GLM-5.3 unggul pada reasoning multi-tahap, constraint ketat, integrasi multi-file, dan prompt panjang.
- Integrasi tool: Pada skenario dengan tool calling berantai atau evaluasi unit test menyeluruh, model dasar cenderung memberi akurasi lebih tinggi.
- Konsistensi gaya: Model dasar lebih konsisten mengikuti style guide dan konvensi linting yang kompleks; Flash memprioritaskan respons cepat yang “cukup baik”.
Multimodalitas
- Cakupan modal: Jika lini GLM-5.3 mencakup varian multimodal, model dasar biasanya menawarkan dukungan lebih lengkap/stabil untuk teks+visi (dan audio jika ada). Flash dapat mendukung subset fitur multimodal dengan optimisasi latency-first.
- Kualitas persepsi: Pada input visual kompleks (grafik, dokumen panjang), model dasar cenderung lebih akurat; Flash memadai untuk OCR ringan, captioning singkat, dan deteksi sederhana.
- Ukuran input: Model dasar lebih toleran terhadap resolusi/urutan panjang; Flash disetel untuk pipeline yang membatasi resolusi atau melakukan pre/post-processing agresif.
Kecepatan dan efisiensi
- Latensi: Flash biasanya 2–5x lebih cepat pada prompt respons pendek hingga sedang, terutama di perangkat keras yang sama.
- Throughput: Flash memberi QPS lebih tinggi dan utilisasi lebih baik pada beban paralel.
- Biaya komputasi: Flash mengurangi kebutuhan memori dan compute per token, cocok untuk skala besar dan edge deployment.
Harga
- Biaya per token: Flash umumnya 30–80% lebih murah per token input/output dibanding model dasar.
- Penagihan: Struktur harga sering sama (per 1K token), dengan diskon signifikan di Flash.
- Kebijakan kuota: Flash mungkin memiliki batasan lebih longgar pada rate limit untuk mendukung kasus penggunaan QPS tinggi.
Akses API
- Endpoint: Biasanya tersedia di endpoint yang sama atau varian model name berbeda; antarmuka kompatibel drop-in.
- Streaming: Keduanya mendukung streaming; Flash dioptimalkan untuk waktu-karakter pertama yang cepat.
- Batch dan job asinkron: Model dasar dan Flash umumnya mendukung batch; Flash memberi keuntungan biaya/waktu pada batch besar.
- Fitur kontrol: Parameter seperti temperature, top_p, penalti, dan tool calling tersedia di keduanya; default tuning mungkin berbeda.
- SLA dan limit: Flash bisa menawarkan SLA berbeda atau limit lebih tinggi; cek dokumentasi vendor.
Use case yang direkomendasikan
- Pilih GLM-5.3 jika:
- Diperlukan reasoning mendalam, konteks sangat panjang, atau kualitas tertinggi untuk tugas kompleks.
- Anda menjalankan coding multi-file, analisis dokumen berat, atau multimodal presisi tinggi.
- Konsistensi gaya dan akurasi sangat krusial (mis. produksi berisiko tinggi).
- Pilih GLM-5.3 Flash jika:
- Prioritas pada latensi rendah dan biaya rendah, dengan volume permintaan tinggi.
- Chat interaktif, asisten produktivitas, auto-reply, summarization singkat, retrieval Q&A cepat.
- Coding ringan-menengah, bug triage, dan scaffolding awal.
- Deployment skala besar atau edge dengan sumber daya terbatas.
Panduan pemilihan praktis
- Jika Anda mengoptimalkan pengalaman pengguna responsif pada biaya ketat: mulai dengan Flash; fallback ke GLM-5.3 untuk permintaan sulit atau panjang.
- Jika Anda mengoptimalkan akurasi: mulai dengan GLM-5.3; gunakan Flash untuk langkah-langkah pipeline yang tidak kritis.
- Terapkan routing berbasis sinyal: deteksi panjang prompt, kompleksitas, atau kebutuhan alat; alihkan ke model yang sesuai.
- Lakukan evaluasi A/B pada korpus internal: ukur akurasi, latensi, biaya, dan stabilitas keluaran; pilih konfigurasi yang menyeimbangkan KPI Anda.
Checklist evaluasi cepat
- Akurasi pada set tugas prioritas (termasuk edge cases)
- Latensi P50/P95 dan token-per-detik
- Biaya per permintaan dan total cost of ownership
- Konsumsi memori dan utilisasi GPU/CPU
- Stabilitas output pada prompt panjang dan chaining
- Ketersediaan fitur multimodal dan tool-use yang dibutuhkan
- Kompatibilitas API dan integrasi observabilitas/logging
Ringkasnya, GLM-5.3 menekankan kualitas dan cakupan kemampuan, sementara GLM-5.3 Flash menekankan kinerja runtime dan efisiensi biaya. Kombinasi keduanya melalui model routing sering memberikan hasil terbaik di lingkungan produksi.
GLM-5.3 Flash adalah default yang lebih baik untuk sebagian besar beban kerja produksi: menambahkan input visual native dan jendela konteks 1M token, sementara harga daftar standarnya jauh lebih rendah. GLM-5.3 tetap menjadi pilihan yang lebih kuat ketika kedalaman pengodean maksimum, penalaran jangka panjang yang sulit, atau kinerja keamanan siber lebih penting daripada biaya per unit.
Ini bukan cerita model kecil versus model besar. Flash adalah MoE 320B total/18B aktif yang dilatih dari basis multimodal baru dengan atensi hibrida sparse dan linear. Flagship adalah yang peningkatan GLM-5.3-nya berasal dari pascapelatihan berskala di atas basis GLM-5.2.
Pilih Flash untuk pengodean multimodal, pemahaman dokumen, agen browser atau GUI, otomasi volume tinggi, dan aplikasi sensitif biaya.
Pilih flagship untuk tugas rekayasa tingkat repositori paling sulit, penalaran mendalam berbantuan alat, dan riset keamanan defensif.
Kedua model mendukung konteks 1M token, penalaran selalu aktif, function calling, streaming, dan deployment open-weight.
Pada benchmark yang dilaporkan Z.ai dan disetarakan, flagship memimpin DeepSWE, NL2Repo, HLE dengan alat, dan Agents’ Last Exam; Flash memimpin AutomationBench, Toolathlon, dan GDPval-AA v2.
Pengujian independen memberi flagship Intelligence Index lebih tinggi dan output lebih cepat, sementara Flash memiliki waktu ke token pertama sedikit lebih baik dan biaya gabungan jauh lebih rendah.
GLM-5.3 Flash vs GLM-5.3 sekilas
Dimension
GLM-5.3 Flash
GLM-5.3
Practical result
Positioning
Model agen dan pengodean multimodal native yang efisien
Z.ai memosisikan Flash sebagai model multimodal native pertama dalam seri GLM-5. Model ini memiliki 320B parameter total dan 18B aktif, namun “Flash” tidak berarti “kecil.” Checkpoint penuh tetap sangat besar; efisiensinya berasal dari aktivasi subset expert yang lebih kecil dan redesain stack atensi.
Basis modelnya dilatih pada korpus multimodal 30 triliun token. Visi native terintegrasi dalam loop pengodean, memungkinkan model memeriksa tangkapan layar, antarmuka terender, grafik, tata letak halaman, dan umpan balik visual lain sebelum menyempurnakan aksi berikutnya.
Spesifikasi GLM-5.3 Flash
Specification
GLM-5.3 Flash
Developer
Z.ai / Zhipu AI
Model ID
glm-5.3-flash
Model type
Mixture-of-Experts multimodal native
Total / active parameters
320B / 18B
Layers
45
Architecture
Atensi hibrida sparse + linear; mHC; MTP
Training corpus
Korpus pra-pelatihan multimodal 30T token
Input modalities
Input teks dan visual, termasuk gambar dan workflow video/berkas yang didukung
Output modality
Teks
Context / max output
1M / 128K token
Reasoning
Selalu aktif; low, high, max effort
Tools
Function calling, streaming tool calls, alur kerja terstruktur
Model flagship ini dioptimalkan untuk rekayasa perangkat lunak kompleks, agen jangka panjang, dan keamanan siber. Z.ai menyatakan model ini menggunakan basis yang sama dengan GLM-5.2; peningkatannya berasal dari pascapelatihan berskala, bukan pra-pelatihan baru.
Repositori resmi mencantumkan checkpoint 744B parameter total dengan 40B aktif. Dibandingkan Flash, model ini mengaktifkan lebih dari dua kali lipat parameter per token dan mengalokasikan kapasitas lebih besar untuk penalaran multi-langkah yang sulit.
Spesifikasi GLM-5.3
Specification
GLM-5.3
Developer
Z.ai / Zhipu AI
Model ID
glm-5.3
Model type
Flagship teks Mixture-of-Experts
Total / active parameters
744B / 40B
Base model
Basis GLM-5.2; semua peningkatan GLM-5.3 dari pascapelatihan
Input / output
Teks / teks
Context / max output
1M / 128K token
Reasoning
Selalu aktif; low, high, max effort
Tools
Function calling, streaming tool calls, context caching, structured output
Ini adalah perbandingan level arsitektur, bukan jaminan pengganda latensi end-to-end. Kecepatan API nyata juga bergantung pada perangkat keras, kuantisasi, batching, panjang penalaran, perangkat lunak penyajian, dan beban penyedia.
Arsitektur atensi hibrida GLM-5.3-Flash dan perbandingan komputasi/cache konteks panjang.
Sumber: Dokumentasi arsitektur resmi Z.ai
Kinerja Benchmark: Di Mana Masing-Masing Model Unggul
Perbandingan paling bersih memisahkan benchmark tugas yang dilaporkan vendor dari pengukuran API independen. Bahkan saat nama benchmark sama, versi harness, konfigurasi alat, manajemen konteks, dan effort penalaran bisa berbeda. Tabel di bawah menggunakan nilai paling cocok dalam evaluasi flagship dan evaluasi Flash, memperlakukan selisih kecil sebagai indikasi arah, bukan kepastian.
Benchmark
GLM-5.3 Flash
GLM-5.3
Skor lebih tinggi
Apa yang diuji
Terminal-Bench 2.1
84.3
88.2
GLM-5.3
Pengodean terminal dan agen
DeepSWE v1.1
63.4
66.9
GLM-5.3
Rekayasa perangkat lunak
NL2Repo
56.3
58.0
GLM-5.3
Generasi repositori
Toolathlon Verified
78.4
73.0
Flash
Penggunaan alat
AutomationBench
48.8
48.2
Seri / Flash
Otomasi penggunaan komputer
Agents’ Last Exam
26.3
28.5
GLM-5.3
Penalaran agen jangka panjang
HLE with tools
55.3
62.5
GLM-5.3
Penalaran sulit berbantuan alat
GDPval-AA v2
1773 Elo
1769 Elo
Seri / Flash
Pekerjaan pengetahuan profesional
Sumber: evaluasi flagship dan evaluasi Flash. Bandingkan secara indikatif karena setelan evaluasi dapat berbeda.
Pengodean dan Rekayasa Repositori
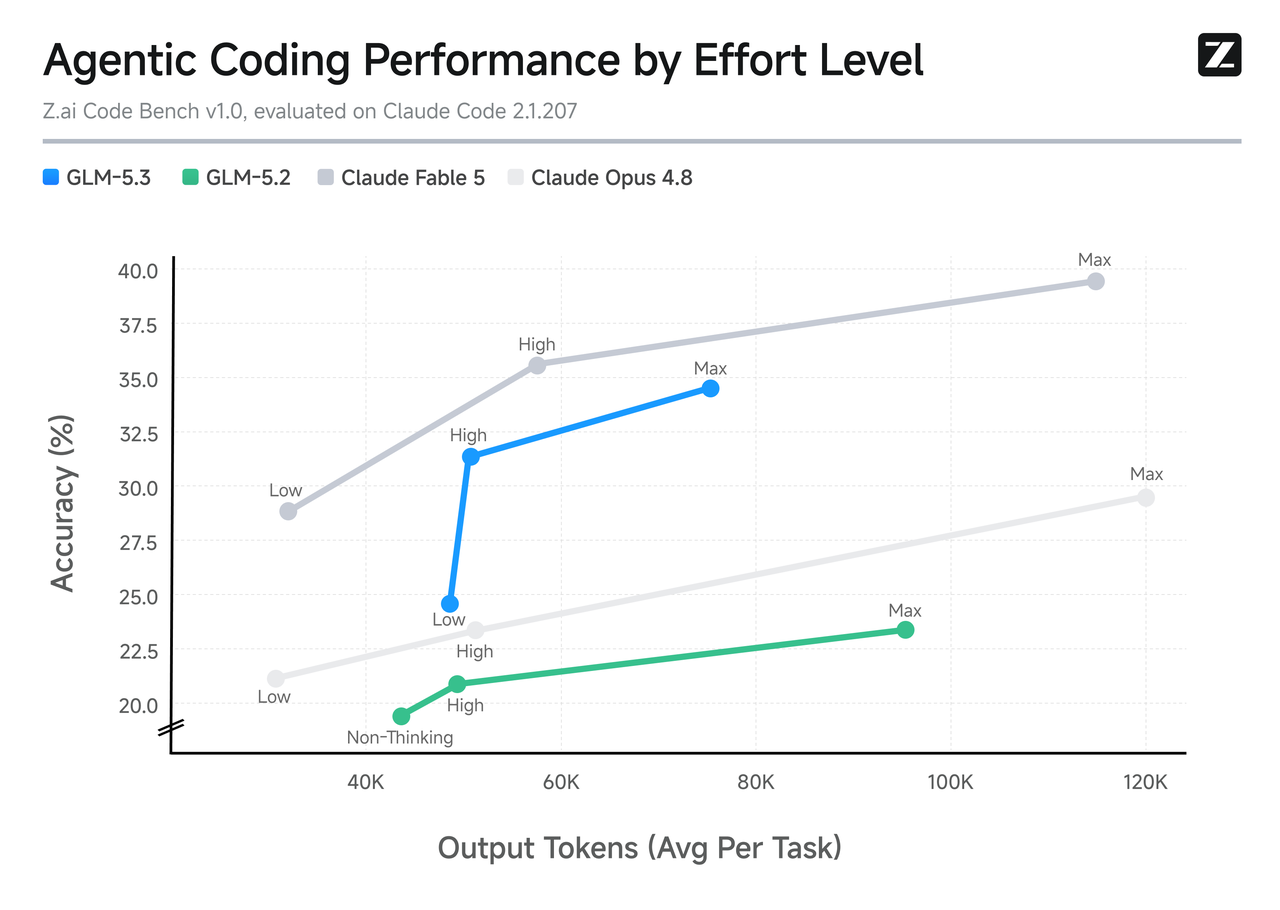
Flagship memiliki plafon kinerja lebih tinggi. Model ini memimpin Flash sebesar 3,5 poin pada DeepSWE dan 1,7 poin pada NL2Repo. Pada Z.ai Code Bench v1.0, dengan kedua model dievaluasi menggunakan Claude Code 2.1.207, flagship mencapai 34,5% pada effort maksimum, sementara Flash mencapai 29,0% — selisih 5,5 poin.
Meski begitu, Flash tetap cukup kompetitif untuk menjadi model pertama yang diuji untuk pemeliharaan repositori rutin, pembuatan tes, debugging, refactoring, dan agen pengodean volume tinggi. Eskalasikan hanya tugas tersulit atau lintasan yang gagal ke flagship.
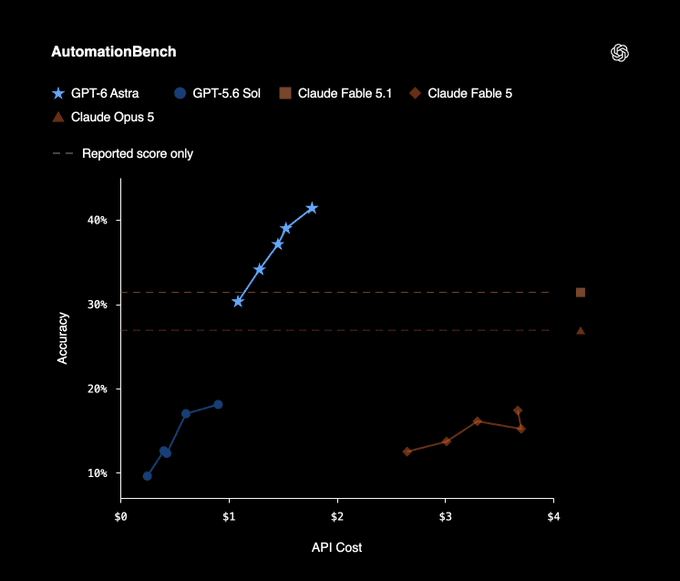
Evaluasi enam benchmark Z.ai atas GLM-5.3-Flash dan model pengodean/agen lainnya.
Sumber: Dokumentasi resmi Flash Z.ai
Akurasi pengodean agen GLM-5.3 dan penggunaan token output di berbagai tingkat effort penalaran.
Sumber: Dokumentasi resmi flagship Z.ai
Penggunaan Alat, Otomasi, dan Pekerjaan Pengetahuan
Flash tidak selalu lebih lemah. Model ini mencetak 78,4 pada Toolathlon Verified versus 73,0 untuk flagship, dan unggul tipis pada AutomationBench 48,8 versus 48,2. Model ini pada dasarnya seri pada GDPval-AA v2. Ini membuat Flash sangat menarik saat tugas kurang tentang satu rantai penalaran yang sangat sulit dan lebih tentang mengoordinasikan alat secara andal di banyak permintaan murah.
Intelijensi, Kecepatan, dan Latensi Independen
Independent measurement
GLM-5.3 Flash
GLM-5.3 (max)
Result
Artificial Analysis Intelligence Index
57
60
GLM-5.3
Output speed
50.2 token/dtk
76.6 token/dtk
GLM-5.3
Time to first token
1,49 dtk
1,61 dtk
Flash
Context window
1M
1M
Seri
Blended price in AA comparison
$0.10 / 1M token
$0.90 / 1M token
Flash
Sumber: Perbandingan API yang disetarakan oleh Artificial Analysis.
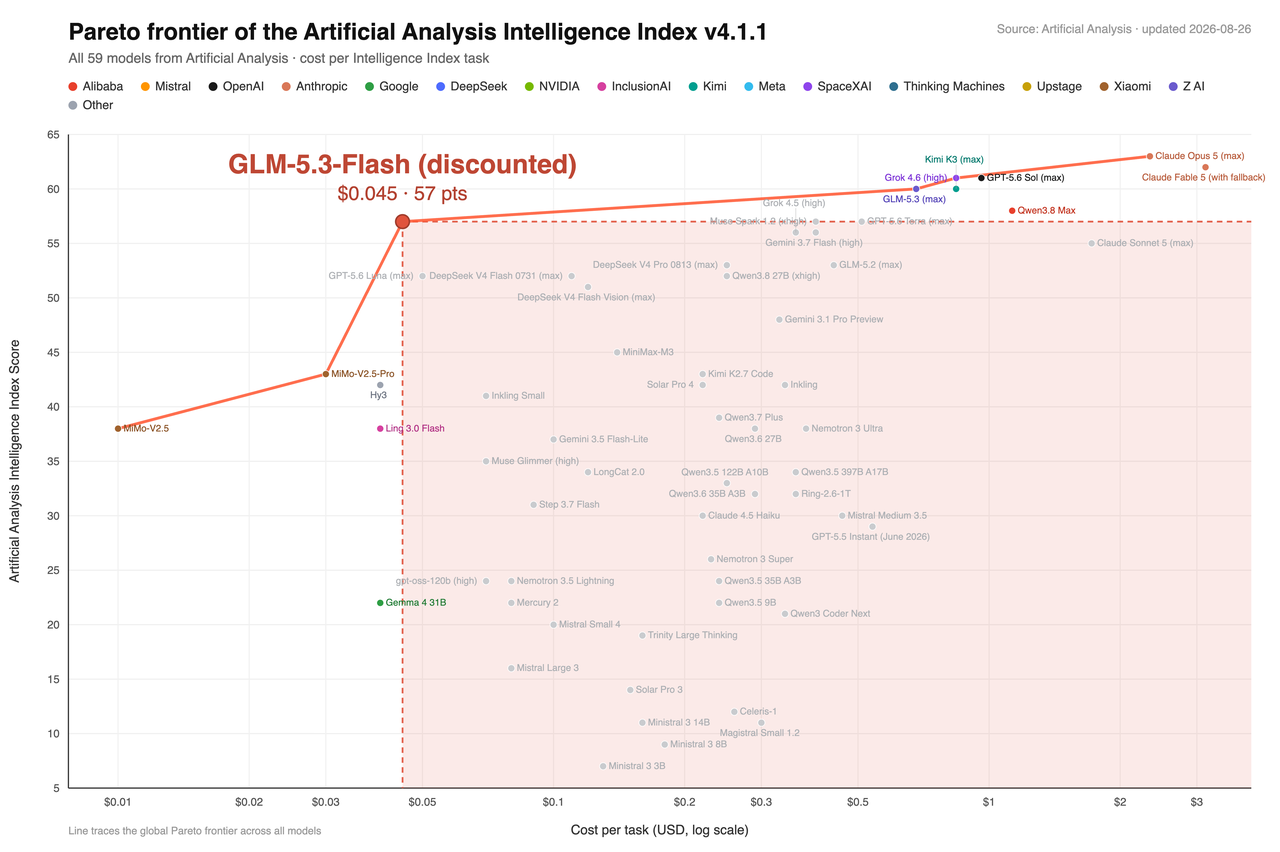
Hasil independen menambahkan koreksi penting pada asumsi “Flash berarti lebih cepat.” Flash merespons sedikit lebih cepat di awal, tetapi endpoint flagship yang diuji menghasilkan token lebih cepat setelah output dimulai. Perlakukan pengukuran ini sebagai snapshot spesifik penyedia, bukan properti model yang tetap.
Frontier biaya–intelijensi Artificial Analysis yang direproduksi dalam dokumentasi resmi Flash Z.ai.
Sumber: Dokumentasi resmi Flash Z.ai
Multimodalitas: Flash Memiliki Keunggulan Jelas
Flash menerima input visual dan mengintegrasikannya ke dalam alur kerja agen. Model ini dapat memeriksa tangkapan layar, gambar halaman, grafik, status antarmuka, rekaman layar, dan berkas yang didukung, lalu menggunakan bukti visual saat mengode atau mengoperasikan alat. Flagship saat ini hanya mendukung input teks.
Frontend dan design-to-code: Flash dapat memeriksa tangkapan layar referensi dan memvalidasi implementasi terender.
Workflow dokumen dan Office: Flash dapat menalar struktur halaman, grafik, tata letak, dan penempatan gambar.
Penggunaan browser dan komputer: Flash dapat menggabungkan status visual dengan panggilan alat dan koreksi iteratif.
Pekerjaan repositori berbasis teks: flagship tetap lebih disukai saat input berupa kode dan teks serta tugas memerlukan kedalaman penalaran maksimum.
Konteks Panjang dan Kontrol Penalaran
GLM-5.3 Flash mendukung jendela konteks 1M token dan hingga 128K token output; GLM-5.3 menyediakan batas yang sama. Keduanya menjaga penalaran tetap aktif dan menerima tingkat effort low, high, dan max. Z.ai merekomendasikan max untuk pengodean sulit dan reproduksi benchmark.
Kapasitas konteks bukanlah pembeda utama. Perbedaannya adalah seberapa ekonomis masing-masing model melayani urutan panjang dan berapa banyak kapasitas penalaran yang dapat dibawa ke tugas tersulit. Flash secara arsitektural lebih murah pada konteks panjang; flagship memiliki plafon kualitas lebih tinggi.
Keamanan Siber: GLM-5.3 adalah Spesialis
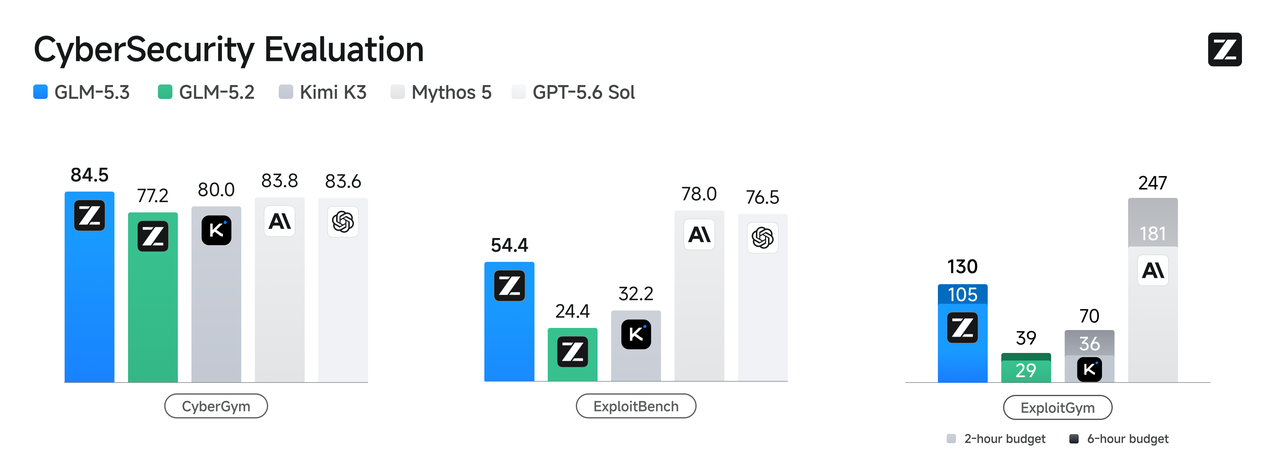
Keamanan siber adalah kapabilitas paling khas milik flagship. Z.ai melaporkan 84,5 pada CyberGym dan 54,4 pada ExploitBench. Di bawah batas waktu terstandardkan dua jam dan enam jam, model ini menyelesaikan 105 dan 130 tugas ExploitGym.
Flash tidak memiliki penekanan peluncuran setara atau suite siber publik yang cocok. Untuk code review, pengembangan aman, dan penemuan kerentanan terotorisasi, gunakan flagship sebagai model utama dan sertakan persetujuan manusia, perkakas terisolasi, log audit, dan kontrol pengungkapan dalam alur kerja.
Kinerja GLM-5.3 di berbagai benchmark penemuan kerentanan dan rantai eksploitasi.
Harga dalam USD per 1M token. Sumber: harga Z.ai, rute Flash, dan rute GLM-5.3. Promosi dapat berubah.
Contoh Biaya Bulanan
Untuk beban kerja yang menggunakan 100M token input dan 20M token output, tarif CometAPI saat ini menghasilkan perkiraan $10,00 untuk Flash versus $182,56 untuk flagship, sebelum efek cache atau biaya alat. Flash mengurangi tagihan token sekitar 94,5% pada contoh ini.
Flash lebih mudah disajikan daripada flagship, namun ini bukan model untuk GPU konsumen. Checkpoint 320B, komponen multimodal, cache KV, dan konteks 1M tetap membutuhkan infrastruktur serius. Self-hosting paling menarik ketika kontrol data, penyajian kustom, atau utilisasi tinggi berkelanjutan membenarkan biaya operasional.
Model Mana yang Harus Anda Pilih?
Pilih GLM-5.3 Flash jika?
Anda membutuhkan pemahaman gambar, tangkapan layar, grafik, dokumen, browser, atau GUI.
Anda menjalankan agen pengodean volume tinggi, alur kerja riset, atau otomasi bisnis.
Anda menginginkan penggunaan alat dan kinerja pekerjaan pengetahuan yang kuat dengan biaya token terendah.
Anda memerlukan jendela konteks 1M tetapi tidak ingin ekonomi flagship pada setiap permintaan.
Anda berencana self-hosting dan 320B/18B lebih praktis daripada 744B/40B.
Pilih GLM-5.3 jika?
Anda menyelesaikan tugas pengodean tingkat repositori tersulit atau rekayasa jangka panjang.
Evaluasi Anda lebih menghargai penalaran lebih dalam daripada biaya per unit yang rendah.
Anda membutuhkan hasil lebih kuat pada DeepSWE, HLE dengan alat, atau Agents’ Last Exam.
Anda membangun workflow keamanan defensif atau penemuan kerentanan yang terotorisasi.
Tingkat keberhasilan lebih tinggi dapat menutupi premi token sekitar satu orde besaran.
Matriks Keputusan menurut Use Case
Workload
Recommended starting model
Why
High-volume chat and automation
GLM-5.3 Flash
Biaya jauh lebih rendah; penggunaan alat kuat
Visual coding and UI debugging
GLM-5.3 Flash
Input visual native
Document, chart, and Office analysis
GLM-5.3 Flash
Workflow profesional multimodal
Routine repository maintenance
Start with Flash
Eskalasi tugas gagal atau sangat sulit
Difficult repository-scale engineering
GLM-5.3
Plafon pengodean lebih tinggi
Long-horizon research with tools
GLM-5.3
Hasil HLE-with-tools lebih kuat
Defensive security and vulnerability discovery
GLM-5.3
Pelatihan dan benchmark siber khusus
Cost-sensitive self-hosting
GLM-5.3 Flash
Jejak aktif dan total lebih kecil
Uncertain mixed workload
Hybrid routing
Flash default; eskalasi ke flagship
Strategi Produksi yang Lebih Baik: Rute, Bukan Ganti
Bagi sebagian besar tim, desain terkuat bukanlah pilihan eksklusif. Gunakan Flash sebagai rute default, lalu eskalasikan hanya tugas dengan kompleksitas tinggi, validasi gagal, sensitivitas keamanan, atau nilai ekonomi yang diharapkan cukup untuk membenarkan premi flagship.
Kirim tugas visual, rutin, dan volume tinggi ke Flash.
Ukur tingkat penerimaan, token, latensi, kegagalan alat, dan intervensi manusia.
Eskalasikan tugas teks yang gagal atau berisiko tinggi ke flagship.
Rute pekerjaan sensitif keamanan melalui otorisasi tambahan dan kontrol sandbox.
Optimalkan biaya per hasil yang diterima, bukan peringkat benchmark atau harga semata.
Cara Menguji Kedua Model melalui CometAPI
CometAPI mencantumkan rute GLM-5.3 Flash dan rute GLM-5.3 di balik URL dasar yang kompatibel dengan OpenAI yang sama. Buat kunci API, lalu jalankan tugas teks yang sama melalui kedua ID model. Untuk pengujian adil, pertahankan prompt, effort penalaran, definisi alat, output maksimum, dan rubrik penerimaan tetap sama.
Python
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

models = ["glm-5.3-flash", "glm-5.3"]

for model in models:
    response = client.chat.completions.create(
        model=model,
        messages=[
            {
                "role": "user",
                "content": "Tinjau rencana migrasi ini dan identifikasi tiga asumsi dengan risiko tertinggi.",
            }
        ],
    )
    print(model, response.choices[0].message.content)
Untuk evaluasi multimodal, gunakan dokumentasi rute Flash live untuk memverifikasi skema konten gambar yang didukung. Perbandingan flagship sebaiknya menggunakan padanan teks saja karena tidak menerima input visual.
Keterbatasan Perbandingan Ini
Beberapa skor pengodean dan agen dilaporkan oleh vendor. Reproduksi independen dapat menggunakan alat, prompt, dan setelan inferensi berbeda.
Nama benchmark yang cocok tidak selalu menjamin versi harness atau strategi manajemen konteks yang identik.
Reduksi level arsitektur pada komputasi atensi dan cache KV tidak secara langsung memprediksi latensi API.
Harga, promosi, ketersediaan model, batas laju, dan kapabilitas rute dapat berubah; verifikasi halaman model live sebelum deployment.
Open weights tidak menjadikan checkpoint mana pun murah untuk self-hosting pada konteks penuh.
Kapabilitas keamanan siber bersifat dual-use dan memerlukan otorisasi, sandboxing, logging, tinjauan pakar, dan pengungkapan yang bertanggung jawab.
Conclusion
GLM-5.3 Flash adalah default yang praktis. Model ini mempertahankan konteks panjang, menambahkan visi native, tampil kuat pada penggunaan alat dan pekerjaan profesional, serta mengubah ekonomi cukup signifikan untuk mendukung penerapan yang jauh lebih luas. GLM-5.3 adalah model eskalasi spesialis: lebih mahal, hanya teks, tetapi lebih kuat pada tugas pengodean, penalaran, dan keamanan siber tersulit.
Putusan akhir karenanya berbasis beban kerja: mulai dengan Flash, ukur tingkat penerimaan nyata, dan rute ke flagship hanya saat kapasitas penalaran tambahannya menghasilkan cukup banyak hasil sukses tambahan untuk membenarkan premi.
Frequently Asked Questions
Apakah GLM-5.3 Flash lebih baik daripada GLM-5.3?
Tidak secara universal. Flash lebih baik untuk harga, multimodalitas, dan beberapa benchmark alat/otomasi. Flagship lebih kuat pada pengodean tersulit, penalaran berbantuan alat, dan beban kerja keamanan siber.
Apakah GLM-5.3 Flash adalah model kecil?
Tidak. Model ini memiliki 320B parameter total dan mengaktifkan 18B per token. Lebih efisien daripada flagship 744B/40B, tetapi tetap memerlukan perangkat keras substansial untuk self-hosting.
Model mana yang lebih murah?
Flash jauh lebih murah. Harga daftar standar Z.ai sekitar sepersepuluh harga flagship, dan rute CometAPI saat ini menunjukkan kesenjangan yang bahkan lebih besar saat harga promosi aktif.
Model mana yang lebih cepat?
Tergantung metrik dan penyedia. Artificial Analysis mengukur waktu ke token pertama sedikit lebih rendah untuk Flash tetapi kecepatan output lebih tinggi untuk flagship.
Model mana yang mendukung gambar?
Flash mendukung input visual native. Flagship saat ini hanya mendukung input teks.
Apakah kedua model mendukung konteks 1M token?
Ya. Flash mendukung konteks 1M dan hingga 128K output; flagship menyediakan batas yang sama.
Model mana yang lebih baik untuk pengodean?
Gunakan Flash untuk agen pengodean rutin dan volume tinggi. Gunakan flagship untuk tugas rekayasa tingkat repositori paling sulit atau ketika biaya kegagalan lebih besar daripada selisih harga.
Model mana yang lebih baik untuk keamanan siber?
Flagship. Z.ai secara khusus melatih dan mengevaluasinya untuk penemuan kerentanan dan penalaran rantai eksploitasi. Gunakan hanya di lingkungan yang terotorisasi dan terkontrol.
Apakah kedua model dapat di-self-host?
Ya. Repositori Z.ai mencantumkan checkpoint yang dapat diunduh dan kerangka penyajian yang didukung, tetapi keduanya tetap merupakan proyek infrastruktur besar.
Apa strategi deployment terbaik?
Gunakan Flash sebagai rute default dan eskalasikan tugas teks yang sulit, gagal, atau sensitif keamanan ke flagship. Ukur biaya per hasil yang diterima.