
TL;DR
Z.AI telah secara publik menamai GLM-6.0 dan menempatkan Full Self-Training di pusat peta jalan generasi berikutnya. Arah yang diungkapkan menghubungkan pengalaman yang dihasilkan sendiri di seluruh pra-pelatihan, pelatihan tengah, dan pasca-pelatihan dengan penilaian dan koreksi diri, mengubah pelatihan menjadi loop umpan balik yang diatur alih-alih satu kali lintasan pembuatan data.
Bagian tersulitnya adalah kontrol: GLM-6.0 perlu memurnikan data sintetis, mendeteksi dan memperbaiki kesalahan, menghentikan iterasi yang tidak produktif, dan mencegah evaluatornya memberi penghargaan pada jalan pintas. Mekanisme tersebut menimbulkan pertanyaan praktis tentang verifikasi independen, keamanan, biaya, dan tata kelola. Karena tidak ada kartu model lengkap, suite tolok ukur, spesifikasi API, harga, atau tanggal rilis yang dipublikasikan, artikel ini mengevaluasi arsitektur pelatihan dan buktinya—bukan spesifikasi yang bersifat spekulatif.
Poin Penting untuk GLM 6.0?
- Bukti publik terkuat berkaitan dengan sistem Full Self-Training, bukan jumlah parameter atau hasil tolok ukur yang bocor.
- Arah yang diungkapkan mencakup data yang diproduksi sendiri, lingkungan pelatihan yang dibangun sendiri, dan optimisasi infrastruktur yang dibantu model.
- Loop umpan balik yang dimaksud mencakup pra-pelatihan, pelatihan tengah, dan pasca-pelatihan alih-alih memperlakukan self-training sebagai teknik yang hanya pasca-pelatihan.
- Pemodelan multimodal native, pembelajaran penguatan dengan horizon lebih panjang, perencanaan, penggunaan alat, pemulihan, dan verifikasi adalah arah penelitian yang relevan, namun belum menjadi spesifikasi GLM 6.0 yang dipublikasikan.
- Ox Alpha bukan bukti kinerja GLM 6.0 yang bocor; Z.AI mengidentifikasinya sebagai identitas pra-rilis GLM-5.3-Flash.
Apa yang Sebenarnya Telah Dikonfirmasi Z.AI tentang GLM 6.0?
Materi publik Z.AI menetapkan empat sinyal konkret: nama GLM-6.0, Full Self-Training sebagai arah pelatihan pusat, loop yang dimaksud di seluruh pra-pelatihan, pelatihan tengah, dan pasca-pelatihan, serta mekanisme penilaian dan koreksi diri. Perusahaan juga menyatakan bahwa sekitar 60% dari hasil bersih dimaksudkan untuk mendukung model generasi berikutnya, Full Self-Training, pelatihan skala besar, inferensi, komputasi, dan infrastruktur terkait.
Kerangka Full Self-Training Z.AI
Full Self-Training disajikan sebagai ide pengorganisasi untuk GLM-6.0, bukan sebagai fitur kecil pasca-pelatihan. Sistem yang dimaksud akan menghasilkan pengalaman pelatihan, belajar dari hasil, menyaring sampel lemah, dan mengulangi siklus di bawah kontrol kualitas eksplisit.
Self-Training GLM-6.0 di Seluruh Pra-, Tengah-, dan Pasca-Pelatihan
Urutan yang diungkapkan—pra-pelatihan, pelatihan tengah, dan pasca-pelatihan—menyiratkan bahwa pengalaman yang dihasilkan sendiri dapat memengaruhi pengetahuan fondasi, pembentukan kapabilitas, dan penyelarasan tugas alih-alih hanya muncul selama tuning akhir. Z.AI belum mengungkapkan dataset, batas tahap, atau rasio campuran, sehingga ini harus diperlakukan sebagai arah yang dikonfirmasi daripada resep lengkap.
Mekanisme Penilaian dan Koreksi Diri GLM-6.0
Peta jalan mengaitkan Full Self-Training dengan penilaian diri, deteksi kesalahan, koreksi, dan pemurnian data secara mandiri. Dalam istilah praktis, model perlu menilai trajektori, merevisi langkah yang gagal, membuang data yang tidak andal, dan memutuskan kapan iterasi lebih lanjut tidak lagi meningkatkan kinerja yang diukur secara independen. Desain evaluator dan aturan penghentian belum diungkapkan.
The GLM-6.0 and Full Self-Training disclosure should be read together with Z.AI’s public proceeds allocation.
Apa yang Kita Ketahui vs yang Tidak Kita Ketahui
Catatan publik mendukung peta jalan, tetapi bukan spesifikasi yang selesai. Tabel memisahkan arah yang dikonfirmasi dari pertanyaan terbuka sehingga artikel ini tidak mengubah niat yang diungkapkan menjadi klaim produk yang tidak didukung.
| Klaim | Status bukti | Apa yang didukung | Apa yang masih tidak diketahui |
|---|---|---|---|
| Nama GLM-6.0 | Diidentifikasi publik | Z.AI telah menamai model generasi berikutnya GLM-6.0. | Tanggal rilis dan penentuan posisi akhir. |
| Full Self-Training | Peta jalan dikonfirmasi | Ini adalah prioritas strategis yang dinyatakan. | Detail implementasi dan perilaku penskalaan. |
| Pra-pelatihan → Pelatihan tengah → Pasca-pelatihan | Arah dikonfirmasi | Self-training dimaksudkan untuk mencakup siklus hidup pelatihan. | Dataset, validator, batas tahap, dan rasio data. |
| Penilaian dan koreksi diri | Tujuan dikonfirmasi | Peta jalan mencakup pemurnian diri, deteksi kesalahan, dan koreksi. | Keandalan, verifikasi independen, dan kriteria penghentian. |
| Spesifikasi | Tidak diungkapkan | Tidak ada spesifikasi publik yang lengkap. | Parameter, jendela konteks, modalitas, harga, dan identifier API. |
| Tolok ukur | Tidak diungkapkan | Tidak ada set hasil GLM-6.0 resmi. | Skor, metodologi, dan hasil yang dapat direproduksi secara independen. |
Apa Itu Full Self-Training dan bagaimana cara kerjanya
Full Self-Training adalah loop pembelajaran tertutup di mana model membantu membuat tugas atau lingkungan, mencoba menyelesaikannya, mengevaluasi trajektori yang dihasilkan, memperbaiki langkah yang lemah, dan memasukkan pengalaman yang diterima kembali ke pelatihan. Pergeseran pentingnya adalah dari pipeline data sintetis satu kali menjadi proses yang diatur secara berkelanjutan.
- Generate: menyusun masalah, lingkungan alat, dan jalur solusi kandidat.
- Act: menyelesaikan tugas dan menyimpan aksi, observasi, serta penalaran perantara sebagai trajektori.
- Evaluate and correct: memberi skor hasil dengan verifier, mendeteksi kesalahan, merevisi langkah yang gagal, dan menolak sampel berkepercayaan rendah.
- Train and stop: belajar dari pengalaman yang diterima, lalu lanjut hanya selama evaluasi independen menunjukkan peningkatan yang bermanfaat.
Memperluas loop ini di seluruh pra-pelatihan, pelatihan tengah, dan pasca-pelatihan memungkinkan GLM-6.0 meningkatkan kualitas data, pembentukan kapabilitas, dan penyelarasan tugas pada tahap yang berbeda. Arsitektur ini tetap bergantung pada evaluator yang dapat dipercaya: tanpa pemeriksaan independen, self-training dapat memberi penghargaan pada titik buta miliknya sendiri.
Bagaimana Full Self-Training Dapat Mengubah GLM 6.0?
Desain yang diungkapkan lebih tepat dipahami sebagai arsitektur sistem daripada satu blok Transformer baru. Desain ini berupaya menutup loop di sekitar model sehingga model semakin membantu menghasilkan sumber daya yang dibutuhkan untuk siklus pelatihan berikutnya.
Bagaimana GLM 6.0 dapat menghasilkan data pelatihan?
Loop pertama adalah produksi data mandiri. Alih-alih hanya bergantung pada dataset yang ditulis manusia atau dikumpulkan secara eksternal, model dapat menggunakan self-play, pemeriksaan berbasis aturan, hasil eksekusi, penilaian model, dan pemeriksaan acak oleh manusia untuk menghasilkan dan menyaring contoh baru. Contoh yang diterima kemudian mengalir kembali ke pra-pelatihan, pelatihan tengah, dan pasca-pelatihan.
Batasan pentingnya adalah verifikasi: generasi sintetis yang murah hanya berguna ketika sistem dapat mengidentifikasi contoh yang benar, beragam, dan tidak degeneratif. Loop praktisnya adalah generasi model → eksekusi tugas → verifikasi aturan atau alat → penyaringan → pelatihan ulang.
Bagaimana GLM 6.0 dapat membangun lingkungan pelatihan?
Loop kedua adalah konstruksi lingkungan mandiri. Agen dapat mengumpulkan atau mentransformasi tugas dunia nyata, mencoba tugas-tugas tersebut, membuat validator, dan memeriksa apakah tugas tersebut benar-benar dapat diselesaikan sebelum menjadi materi pelatihan. Ini penting terutama untuk pengodean dan pekerjaan agen, di mana keadaan terminal, output alat, keadaan browser, hasil uji, dan pemulihan kegagalan memberikan supervisi yang lebih kuat daripada jawaban berbasis teks saja.
Target evaluasi bergeser dari apakah jawaban terdengar masuk akal menjadi apakah suatu tindakan berhasil, hasilnya dapat diverifikasi secara independen, dan agen dapat pulih setelah kegagalan.
Bagaimana GLM 6.0 dapat mengoptimalkan infrastrukturnya?
Loop ketiga adalah optimisasi infrastruktur mandiri. Dalam praktiknya, ini paling tepat ditafsirkan sebagai rekayasa sistem yang dibantu AI: model pengodean yang kuat mengusulkan perubahan pada operator, kernel, penjadwalan, caching, atau kode penyajian, sementara tolok ukur otomatis dan validasi yang dikendalikan manusia menentukan perubahan mana yang diterima.
Siklus yang dihasilkan adalah model yang lebih baik → usulan sistem yang lebih baik → peningkatan efisiensi tervalidasi → lebih banyak eksperimen pelatihan → model yang lebih baik. Tinjauan manusia dan tolok ukur yang dapat direproduksi tetap menjadi titik kontrol, bukan tambahan opsional.
Apa yang Dapat Diberitahu Patokan GLM 5.3 Flash Saat Ini tentang GLM 6.0?
Karena GLM 6.0 tidak memiliki kartu model publik, perbandingan yang paling defensif memisahkan kapabilitas GLM yang diukur saat ini dari arah generasi berikutnya. Z.AI mendeskripsikan GLM-5.3-Flash sebagai model MoE 320B-total, 18B-active yang dilatih pada korpus multimodal 30T-token. Ini adalah spesifikasi GLM-5.3-Flash, bukan spesifikasi GLM 6.0.
| Dimensi perbandingan | API GLM-5.3-Flash di CometAPI | Arah GLM 6.0 yang diungkapkan |
|---|---|---|
| Status rilis | Tersedia | Dalam pengembangan; nama produk final belum ditetapkan secara independen oleh dokumen yang dikutip |
| Parameter | 320B total / 18B aktif | Tidak diungkapkan |
| Arsitektur inti | MoE; atensi sparse + linear hibrida; mHC | Tidak diungkapkan pada level blok |
| Data pelatihan | Korpus multimodal 30T-token | Data yang diproduksi sendiri dimaksudkan masuk ke loop rekursif |
| Multimodalitas | Input multimodal native | Pemodelan multimodal terpadu adalah arah penelitian, bukan spesifikasi yang dipublikasikan |
| Tahap pelatihan | Resep pelatihan bertahap yang dipublikasikan | Self-training di seluruh pra-, tengah-, dan pasca-pelatihan |
| Lingkungan pelatihan | Lingkungan yang dirancang dan di-benchmark oleh peneliti | Agen membantu membangun dan memvalidasi lingkungan |
| Verifikasi | Pipeline evaluasi dan pelatihan yang ada | Penilaian diri yang lebih kuat, umpan balik eksekusi, dan verifikasi diri |
| Infrastruktur | Stack inferensi yang dioptimalkan | Model membantu optimisasi infrastruktur |
| Detail API | ID model yang dipublikasikan dan API aktif | Tidak diungkapkan |
Teks rilis Z.AI melaporkan sekitar 3.0× komputasi atensi yang lebih rendah dan 4.4× ukuran KV-cache yang lebih kecil untuk GLM-5.3-Flash dibanding GLM-5.3 API. Grafik resmi yang menyertai memberi label perbandingan satu juta token sebagai 3.40× untuk komputasi atensi dan 3.80× untuk cache KV per-lapis. Karena dua aset resmi menggunakan angka yang berbeda, angka tersebut sebaiknya dilaporkan dengan konteks masing-masing, bukan digabung menjadi satu pengukuran.
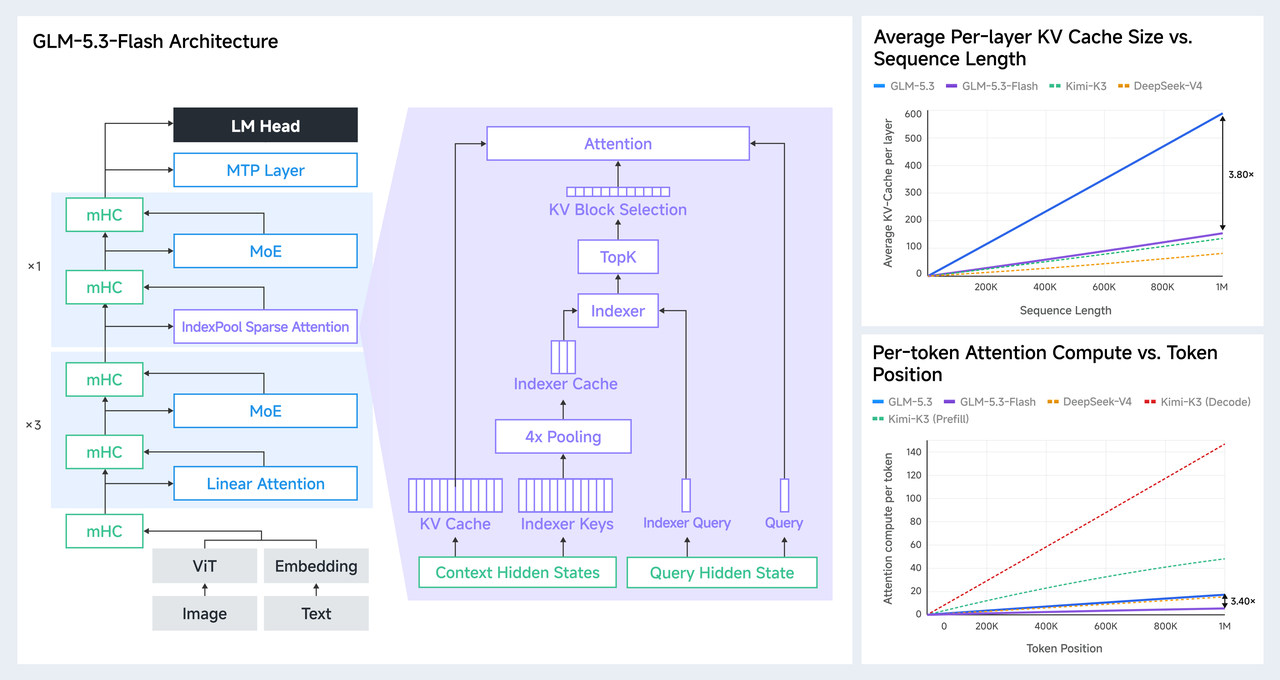
Perbandingan arsitektur dan efisiensi resmi GLM-5.3-Flash yang dipublikasikan oleh Z.AI
Tolok Ukur Mana yang Membentuk Baseline GLM 6.0?
Tidak ada tabel tolok ukur GLM 6.0 terverifikasi yang dipublikasikan. Generasi GLM saat ini hanya berguna sebagai baseline karena evaluasi di bawah ini mengukur perencanaan, pengodean, penggunaan alat, automasi, dan eksekusi ber-horizon panjang—kapabilitas yang paling relevan dengan arah Full Self-Training yang diungkapkan.
| Evaluasi resmi Z.AI | GLM-5.3-Flash | GLM-5.2 | Perbedaan yang dilaporkan |
|---|---|---|---|
| Terminal Bench 2.1 | 84.3 | 81.0 | +3.3 |
| DeepSWE v1.1 | 63.4 | 46.2 | +17.2 |
| NL2Repo | 56.3 | 48.9 | +7.4 |
| Toolathlon Verified | 78.4 | 59.9 | +18.5 |
| AutomationBench v1.0.6 | 48.8 | 26.2 | +22.6 |
| Agents’ Last Exam | 26.3 | 20.4 | +5.9 |
| HLE with Tools | 55.3 | 54.7 | +0.6 |
| GDPval-AA v2 | 1773 Elo | 1504 Elo | +269 Elo |
Perbandingan ini multidimensi alih-alih peringkat skor tunggal. GLM-5.3-Flash menunjukkan kenaikan terbesar yang dilaporkan pada AutomationBench (+22.6), Toolathlon Verified (+18.5), dan DeepSWE (+17.2), sementara perbedaan HLE-with-Tools hanya +0.6. Pola ini menyarankan kenaikan yang lebih kuat pada tugas agen yang berat pada eksekusi daripada pada setiap bentuk penalaran berbantuan alat. Ini tidak memprediksi skor GLM 6.0.
Mengapa tolok ukur ini penting
Tolok ukur penting di sini hanya jika mereka mengungkap kapabilitas yang dimaksudkan untuk ditingkatkan oleh Full Self-Training. Enam kategori dalam tabel tersemat membentuk progresi dari menghasilkan pekerjaan yang benar hingga mempertahankan perilaku efektif di lingkungan nyata. Pengodean menguji apakah model dapat mengeksekusi tugas kompleks; penggunaan alat menguji apakah model dapat mengubah tindakan menjadi umpan balik dan memilih langkah berikutnya; dan automasi menguji apakah model dapat mempertahankan loop tersebut di sepanjang alur kerja panjang.
| Kategori Tolok Ukur | Mengapa Penting bagi GLM-6.0 |
|---|---|
| Pengodean | Menguji eksekusi tugas kompleks |
| Penggunaan alat | Menguji loop aksi-ke-umpan balik |
| Automasi | Menguji eksekusi alur kerja ber-horizon panjang |
| HLE | Menguji pemecahan masalah tingkat ahli yang kompleks |
| GDPval | Menguji kualitas kerja profesional |
| Multimodal | Menguji penggunaan umpan balik visual |
HLE kemudian meningkatkan tingkat kesulitan masalah yang diselesaikan, GDPval menanyakan apakah output berguna dalam pekerjaan profesional, dan evaluasi multimodal menguji apakah observasi visual dapat memandu tindakan berikutnya. Dibaca bersama, enam kategori ini bergerak dari kompetensi terisolasi ke penyelesaian tugas end-to-end: menghasilkan rencana, bertindak, mengamati umpan balik, memperbaiki kesalahan, dan melanjutkan hingga tujuan tercapai.
Hasil GLM-6.0 di masa depan karena itu akan bermakna bukan karena menghasilkan skor agregat yang lebih tinggi, tetapi karena kenaikan di seluruh dimensi ini akan menunjukkan bahwa pengalaman pelatihan yang dihasilkan sendiri mentransfer ke eksekusi dunia nyata yang andal. Tujuan utama Full Self-Training bukan untuk meningkatkan skor tes, tetapi untuk meningkatkan kemampuan model menyelesaikan tugas dunia nyata.
Mengapa Full Self-Training Bisa Penting bagi GLM 6.0?
Janji sebenarnya bukan bahwa GLM 6.0 akan “melatih dirinya sendiri.” Perubahan yang lebih bermakna adalah bahwa bagian yang lebih besar dari pipeline pengembangan dapat menjadi hasil buatan mesin dan diverifikasi mesin. Saat ini, peneliti masih melakukan banyak pekerjaan di sekitar model: mengumpulkan data, merancang tugas, membangun evaluator, membangun lingkungan, mendiagnosis kegagalan, dan menyetel perangkat lunak sistem. Full Self-Training mendorong model ke lebih banyak tahap tersebut.
Jika pendekatan ini berhasil, variabel penskalaan penting menjadi kurang tentang berapa banyak parameter yang dapat ditambahkan dan lebih tentang berapa banyak siklus pembelajaran yang berguna dan terverifikasi yang dapat dijalankan per unit komputasi. Itu adalah interpretasi praktis dari perbaikan diri rekursif alih-alih versi fiksi ilmiah tentang modifikasi diri otonom tanpa batas.
Strategi yang diungkapkan harus dievaluasi sebagai sistem umpan balik yang direkayasa dengan validator, lingkungan yang dapat direproduksi, tolok ukur infrastruktur, dan kontrol manusia—bukan sebagai bukti perbaikan diri otonom tanpa batas.
Apa yang Bisa Salah dengan Full Self-Training?
Loop self-training dapat memperbanyak kesalahan seefisien memperbanyak pengalaman yang berguna. Empat mode kegagalan patut mendapat perhatian khusus:
- Amplifikasi kesalahan: trajektori sintetis yang lemah dapat menjadi data pelatihan masa depan, memungkinkan pola yang masuk akal namun salah untuk menguatkan diri.
- Permainan reward dan evaluator: jika sistem yang sama menghasilkan pekerjaan dan menilainya, sistem dapat mengoptimalkan celah pada verifier alih-alih keberhasilan tugas yang sejati.
- Penyempitan distribusi: berulang kali belajar dari data yang dihasilkan model dapat mengurangi keragaman dan membuat kasus dunia nyata yang jarang terjadi lebih sulit ditangani.
- Tekanan biaya, keamanan, dan tata kelola: konstruksi lingkungan, akses alat, dan iterasi persisten meningkatkan permintaan komputasi dan memperlebar permukaan serangan.
Implementasi GLM-6.0 yang kredibel karena itu memerlukan validator independen, asal-usul data, ambang penerimaan, uji red-team, audit manusia, dan aturan penghentian eksplisit. Koreksi diri berguna hanya ketika sinyal koreksi lebih dapat dipercaya daripada perilaku yang dikoreksi.
Kapan API GLM 6.0 Bisa Tersedia?
Z.AI belum memublikasikan tanggal rilis API GLM 6.0, ID model, jendela konteks, keluaran maksimum, harga token, komitmen open-weight, atau persyaratan penerapan. Nilai spesifik apa pun saat ini merupakan spekulasi.
Pengembang dapat mengevaluasi arah saat ini melalui GLM-5.3-Flash API di CometAPI untuk beban kerja multimodal native dan berorientasi efisiensi, GLM-5.3 API di CometAPI untuk cabang flagship saat ini, atau GLM-5.2 API di CometAPI sebagai baseline perbandingan generasi sebelumnya.
Kesimpulan
GLM-6.0 lebih penting sebagai ujian apakah Z.AI dapat mengubah Full Self-Training menjadi sistem rekayasa yang berulang daripada sebagai produk yang dijanjikan. Peta jalan menghubungkan pengalaman yang dihasilkan sendiri, pelatihan bertahap, penilaian diri, koreksi, dan iterasi terkontrol; bukti yang menentukan adalah apakah mekanisme tersebut meningkatkan keandalan pada alur kerja dunia nyata yang panjang dan menggunakan alat.
Bukti tersebut masih belum lengkap. Z.AI belum memublikasikan kartu model GLM-6.0, tanggal rilis, identifier API, harga, atau suite tolok ukur. Hingga artefak tersebut ada, kesimpulan yang defensif tetap sempit: perusahaan telah mengungkap arah pelatihan, bukan profil kapabilitas yang selesai.
Tujuan utama Full Self-Training bukan untuk meningkatkan skor tes, tetapi untuk meningkatkan kemampuan model menyelesaikan tugas dunia nyata.