
TL;DR
Claude Fable 5.1 memiliki bukti benchmark yang lebih kuat untuk pengodean otonom yang sulit dan pekerjaan berjangka panjang. GPT-5.6 Sol menawarkan biaya token biasa yang lebih rendah, tumpukan alat native yang luas, dan waktu ke token pertama yang lebih rendah dalam perbandingan independen pada upaya maksimum. Default yang tepat bergantung pada biaya kegagalan tugas, bukan hanya skor benchmark tertinggi.
Dalam snapshot Intelligence Index 8 September 2026, Fable 5.1 meraih skor 53, dibandingkan 47 untuk GPT-5.6 Sol. Throughput output praktis seri di 69,9 versus 69,8 token/detik. Hasil ini mendukung keputusan kualitas versus biaya; tidak menetapkan pemenang universal untuk kecepatan.
Poin Penting
- Pilih Fable 5.1 untuk tugas otonom tersulit ketika evaluasi Anda sendiri membenarkan harga yang lebih tinggi.
- Mulai dengan GPT-5.6 Sol untuk inferensi frontier yang sensitif biaya dan aplikasi yang diuntungkan oleh alat terintegrasinya.
- Bandingkan jeda startup terpisah dari kecepatan output: GPT-5.6 Sol memiliki waktu ke token pertama yang lebih rendah, sementara throughput hampir sama.
- Modelkan penulisan cache, pembacaan, retensi, dan tarif konteks panjang secara terpisah. Harga input/output utama tidak menggambarkan setiap beban kerja agen.
Data diperiksa 8 September 2026. Hasil independen menggunakan GPT-5.6 Sol pada upaya maksimum dan Fable 5.1 dengan Adaptive Reasoning, Max Effort, Default Fallback. Benchmark vendor dan benchmark independen menggunakan setup evaluasi yang berbeda. Harga dalam USD per satu juta token (MTok), kecuali dinyatakan lain.
GPT-5.6 Sol vs Fable 5.1: ringkasan cepat
| Dimension | GPT-5.6 Sol | Claude Fable 5.1 | Pilihan lebih baik |
|---|---|---|---|
| Independent Intelligence Index v4.3 (Sep 8) | 47 | 53 | Fable 5.1 |
| Independent Terminal-Bench 4.0 (Sep 7) | 39.9% | 52.0% | Fable 5.1 |
| Anthropic-run Terminal-Bench 4.0 | 37.3% | 55.8% | Fable 5.1 |
| Context window | 1.05M | 1M | Secara efektif seri |
| Maximum output | 128K | 128K | Seri |
| Text/image input | Yes | Yes | Seri |
| Official input price / MTok | $4 | $10 | Sol |
| Official output price / MTok | $20 | $50 | Sol |
| Official cache read / MTok | $0.40 | $0.25 | Fable 5.1 |
| Independent output speed (Sep 8) | 69.8 tok/s | 69.9 tok/s | Secara efektif seri |
| API tool breadth | Sangat luas | Kuat | Sol |
| Long-running autonomous work | Sangat baik | Kekuatan inti | Fable 5.1 |
| Cost-sensitive production | Default lebih baik | Eskalasi premium | Sol |
Kebijakan awal yang berguna adalah Sol untuk pekerjaan frontier rutin, dengan Fable 5.1 sebagai rute eskalasi ketika suatu tugas gagal melewati ambang kualitas atau otonomi Anda. Validasi kebijakan tersebut terhadap biaya per tugas yang berhasil.
GPT-5.6 Sol mengekspos enam tingkat upaya penalaran, dari none hingga max, dengan default medium. Fable 5.1 menggunakan adaptive thinking selalu aktif; pengaturan effort mengendalikan kedalaman penalaran, dan default-nya adalah high.
Tambahan 50.000 token pada konteks GPT-5.6 Sol kecil kemungkinannya menentukan sebagian besar arsitektur. Penagihan dan reuse cache menjadi lebih konsekuensial saat sebuah permintaan mendekati satu juta token; bagian konteks panjang di bawah menunjukkan alasannya.
Apa itu GPT-5.6 Sol?
GPT-5.6 Sol adalah tier kapabilitas tinggi dalam keluarga GPT-5.6 OpenAI untuk workflow coding, riset, perencanaan, dan agen yang menuntut. Daya tarik utamanya dalam perbandingan ini adalah kombinasi kontrol penalaran dan lingkungan eksekusi di sekelilingnya.
Melalui Responses API, GPT-5.6 Sol mendukung portofolio alat native yang luas: web search, file search, code interpreter, hosted shell, apply patch, computer use, MCP, skills, dan tool search. Ini dapat mengurangi jumlah komponen runtime terpisah yang perlu diintegrasikan oleh aplikasi.
OpenAI juga menjelaskan pemanggilan alat terprogram dan eksekusi multi-agen untuk keluarga tersebut. Fitur platform ini penting ketika model harus mengoordinasikan pekerjaan di berbagai alat alih-alih mengembalikan satu jawaban.
Apa itu Claude Fable 5.1?
Claude Fable 5.1 menargetkan coding yang menuntut, pekerjaan pengetahuan profesional, riset, dan agen jangka panjang. Hasil benchmark langsungnya menjadikannya kandidat kuat untuk tugas di mana pemulihan, ketekunan, dan penyelesaian yang sukses lebih penting daripada respons singkat.
Anthropic menekankan eksekusi otonom berkelanjutan di berbagai aplikasi, termasuk perencanaan, pemulihan dari langkah yang gagal, dan komunikasi progres. Perlakukan positioning tersebut sebagai alasan untuk menguji tugas yang lebih panjang, bukan jaminan bahwa setiap workflow akan selesai dengan benar.
Fable 5.1 juga berbeda dari GPT-5.6 Sol dalam perilaku API: pembatasan pemilihan alat paksa berdampak pada workflow yang memerlukan model memanggil alat tertentu. Periksa mode tool_choice yang didukung saat memigrasikan loop agen deterministik.
Pertanyaan integrasinya karenanya praktis: apakah aplikasi Anda dapat mentoleransi loop penalaran yang lebih otonom, atau memerlukan kontrol yang lebih halus atas setiap langkah? Uji perilaku alat yang tepat sebelum memilih rute.
Perbandingan benchmark: Fable 5.1 punya bukti langsung yang lebih kuat
Perbandingan benchmark antar vendor pesaing mudah disalahgunakan. Evaluasi peluncuran GPT-5.6 awal dari OpenAI mendahului Fable 5.1, sementara rilis Fable 5.1 dari Anthropic berisi perbandingan GPT-5.6 Sol langsung yang lebih baru.
Cara paling bersih membaca buktinya adalah dalam tiga lapis: perbandingan langsung dari Anthropic, pengujian independen saat ini, dan profil kapabilitas GPT-5.6 Sol dari OpenAI sendiri.
Hasil langsung Anthropic: Fable 5.1 vs GPT-5.6 Sol
Hasil benchmark resmi mencakup lima tugas dengan skor yang dilaporkan untuk kedua model. Selisih poin persentase dan Elo di bawah dihitung dari nilai yang dipublikasikan tersebut.
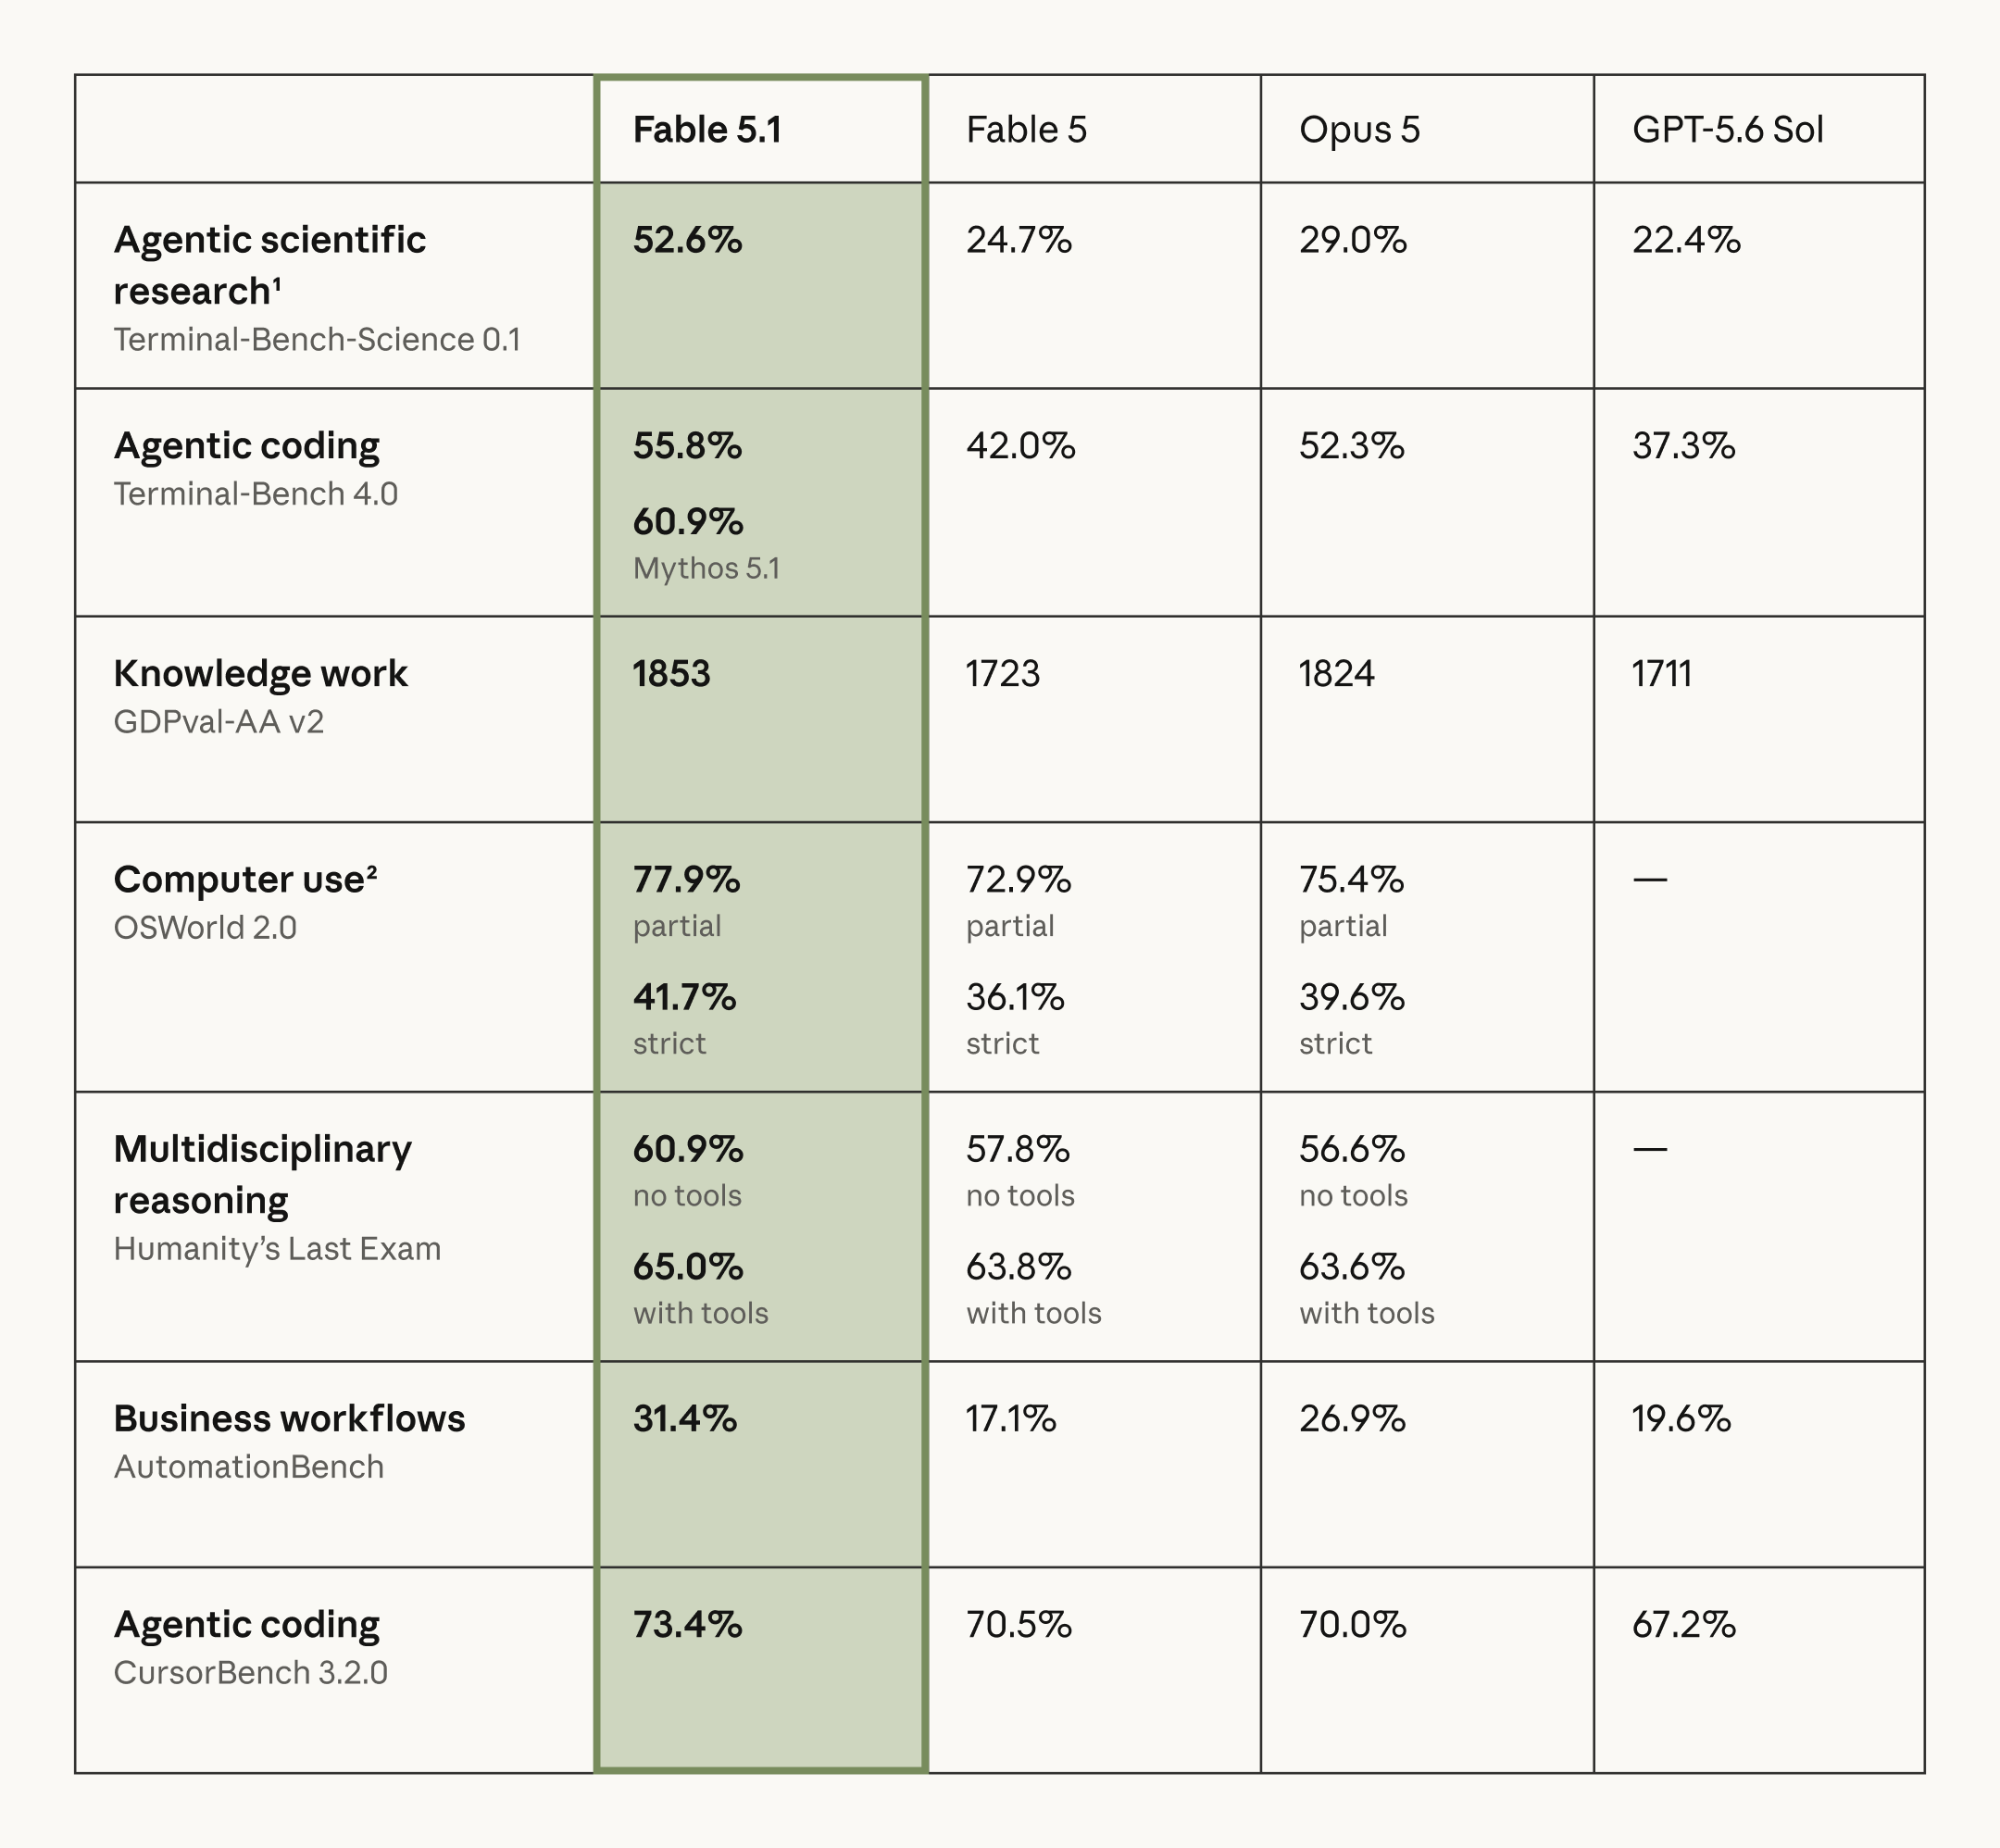
| Benchmark | GPT-5.6 Sol | Claude Fable 5.1 | Keunggulan Fable 5.1 |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 22.4% | 52.6% | +30.2 pts |
| Terminal-Bench 4.0 | 37.3% | 55.8% | +18.5 pts |
| GDPval-AA v2 | 1711 Elo | 1853 Elo | +142 Elo |
| AutomationBench | 19.6% | 31.4% | +11.8 pts |
| CursorBench 3.2.0 | 67.2% | 73.4% | +6.2 pts |
Hasilnya luar biasa konsisten: Fable 5.1 unggul atas GPT-5.6 Sol di setiap baris langsung yang dipublikasikan Anthropic. Perbedaan terbesar muncul dalam riset ilmiah agenik dan coding berbasis terminal alih-alih penalaran bentuk pendek biasa.
Sumber: Anthropic — grafik benchmark asli.
Ini adalah evaluasi yang dijalankan vendor: Anthropic menguji modelnya dan model pesaing. Mereka memberikan bukti perbandingan langsung, tetapi bukan tes independen. Anthropic melaporkan galat baku ±3,5–4,5 poin persentase per model pada Terminal-Bench-Science; tabel di atas menunjukkan estimasi titik, bukan interval kepercayaan.
Hasil vendor mendukung Fable 5.1, tetapi bukti independen memerlukan tanggal dan konfigurasi tersendiri.
Benchmark independen: pisahkan hasil bertanggal dari pengukuran live
Artificial Analysis memperkenalkan Intelligence Index v4.3 pada 7 September, mengganti Terminal-Bench 2.1 dengan Terminal-Bench 4.0 dan menambahkan AutomationBench-AA. Rilis tersebut melaporkan 53 untuk Fable 5.1 dan 47 untuk GPT-5.6 Sol, cocok dengan skor pembulatan pada perbandingan 8 September. Tabel membedakan hasil terminal rilis dari snapshot performa yang lebih baru.
| Independent metric AA comparison / v4.3 release | GPT-5.6 Sol (max) | Claude Fable 5.1 (max) | Hasil |
|---|---|---|---|
| Intelligence Index v4.3 (Sep 8) | 47 | 53 | Fable |
| Terminal-Bench 4.0 (Sep 7 release) | 39.9% | 52.0% | Fable |
| OSWorld 2.0 | 62.6% | 41.7% | |
| Output speed (Sep 8) | 69.8 tok/s | 69.9 tok/s | Secara efektif seri |
| Time to first token (Sep 8) | 132.10 s | 277.47 s | Sol |
| AA normalized token-mix price / MTok | $3.08 | $7.175 | Sol |
Snapshot: 8 September 2026, kecuali baris Terminal-Bench 7 September yang disebut eksplisit. Fable 5.1 menggunakan Adaptive Reasoning, Max Effort, Default Fallback; Sol menggunakan max. Pengukuran live dapat berubah. Harga token-mix ternormalisasi AA menggunakan rasio cache-hit/input/output 7:2:1; ini bukan biaya setiap permintaan API.
OSWorld 2.0 adalah keunggulan terbesar yang dilaporkan untuk Sol dalam perbandingan ini: 62,6% versus 41,7% untuk Fable 5.1, selisih 20,9 poin. Ini menyeimbangkan hasil Fable yang lebih kuat pada Intelligence Index dan Terminal-Bench.
Bukti mendukung trade-off spesifik: Fable 5.1 memiliki Intelligence Index yang lebih tinggi, sementara Sol memiliki waktu ke token pertama yang lebih rendah dan harga ternormalisasi yang lebih rendah. Throughput output praktis seri. Pengukuran ini mendukung pilihan yang berbeda untuk pekerjaan batch sensitif kualitas dan aplikasi interaktif.
Perbandingan Terminal-Bench independen bertanggal mengarah ke arah yang sama seperti tes Anthropic: 52,0% versus 39,9%, dibandingkan dengan 55,8% versus 37,3% milik vendor. Kedua celah tersebut tidak dapat dipertukarkan karena setup evaluasi berbeda.
Apa yang masih dikatakan benchmark OpenAI tentang GPT-5.6 Sol
Evaluasi peluncuran OpenAI menyediakan konteks tambahan untuk kapabilitas GPT-5.6 Sol. Mereka mendahului hasil head-to-head yang lebih baru yang dibahas di atas, sehingga tidak boleh digunakan sebagai perbandingan langsung dengan Fable 5.1.
OpenAI melaporkan 88,8% pada Terminal-Bench 2.1 untuk GPT-5.6 Sol. Itu adalah bukti kemampuan coding agenik yang kuat di bawah setup peluncuran; versi benchmark yang lebih lama tidak boleh dibandingkan secara numerik dengan skor Terminal-Bench 4.0.
GPT-5.6 Sol vs Fable 5.1 untuk coding
Untuk generasi kode langsung, kedua model ini berlebihan untuk banyak beban kerja produksi. Pemisahan menjadi lebih jelas ketika coding berubah menjadi rekayasa perangkat lunak agenik: memeriksa repositori besar, mengedit banyak file, menjalankan perintah, mendiagnosis kegagalan, menulis tes, dan beriterasi hingga tugas lulus.
Di sini, Claude Fable 5.1 memiliki kasus benchmark saat ini yang lebih kuat. Ia memimpin baik perbandingan Terminal-Bench 4.0 yang dijalankan vendor maupun independen, dan hasil CursorBench Anthropic juga mendukungnya 73,4% versus 67,2%.
Untuk evaluasi coding yang praktis, sertakan perubahan seluruh repositori, tes, review, dan pekerjaan performa. Cuplikan kode pendek yang berhasil adalah proksi lemah untuk menyelesaikan tugas yang mencakup beberapa file dan upaya yang gagal.
GPT-5.6 Sol tetap menarik ketika lingkungan eksekusi di sekelilingnya sama pentingnya dengan kualitas model mentah. Dukungan native untuk eksekusi shell, apply-patch, code interpreter, file search, computer use, dan MCP dapat mengurangi infrastruktur orkestrasi yang harus Anda bangun sendiri.
Kesimpulan coding: pilih Fable 5.1 ketika evaluasi Anda menekankan pekerjaan repositori otonom tersulit. Pilih GPT-5.6 Sol ketika kapabilitas benchmark sedikit lebih rendah dapat diterima sebagai imbalan biaya lebih rendah dan tumpukan eksekusi terintegrasi yang luas.
Kontrol penalaran dan pengalaman pengembang
Kedua API mengekspos kecerdasan secara berbeda.
Rentang penalaran none-to-max milik Sol memungkinkan tim menguji kualitas dan jeda pada beberapa pengaturan. Upaya yang lebih rendah dapat mengurangi pekerjaan penalaran, tetapi pengaturan yang tepat bergantung pada biaya kegagalan tugas.
Adaptive thinking selalu aktif milik Fable membuat penyetelan effort menjadi latihan yang berbeda. Bandingkan pengaturan yang akan diterapkan aplikasi Anda alih-alih memperlakukan label effort identik sebagai anggaran komputasi yang identik.
Akibatnya tidak ada perbandingan yang sepenuhnya adil antara “default Sol” dan “default Fable.” Konfigurasi penalaran default mereka berbeda. Evaluasi produksi harus membandingkan baik anggaran effort yang setara atau pengaturan persis yang akan benar-benar diterapkan oleh aplikasi Anda.
GPT-5.6 Sol vs Fable 5.1: mana yang lebih baik untuk agen AI?
Pilihan bergantung pada apakah bottleneck-nya adalah penalaran yang sulit atau runtime yang mengelilinginya.
Keunggulan Fable pada benchmark terminal, automasi, dan pekerjaan profesional yang dikutip menjadikannya kandidat masuk akal untuk tugas tersulit. Ukur tingkat penyelesaian dan pemulihan dari langkah yang gagal sebelum menggeneralisasi keunggulan tersebut ke agen Anda.
Portofolio alat Responses yang didokumentasikan GPT-5.6 Sol menjadikannya menarik untuk aplikasi yang dibangun di sekitar pencarian, file, eksekusi shell, dan patch. Itu adalah keunggulan integrasi yang perlu dievaluasi berdampingan dengan akurasi tugas, bukan penggantinya.
| Kebutuhan agen | GPT-5.6 Sol | Claude Fable 5.1 |
|---|---|---|
| Penalaran keras berjangka panjang | Sangat baik | Paling cocok |
| Otonomi terminal/repositori | Sangat baik | Bukti lebih kuat |
| Portofolio alat terintegrasi native | Lebih kuat | Kuat |
| Pemilihan alat paksa | Didukung; periksa API yang dipilih | Dibatasi; periksa mode tool_choice |
| Integrasi platform multi-agen | Keunggulan kuat | Tersedia lewat arsitektur agen |
| Komunikasi progres selama pekerjaan lama | Baik | Perilaku inti |
| Agen volume tinggi sensitif biaya | Lebih baik | Premium |
| Konteks besar berulang dengan cache | Baik | Berpotensi sangat menarik |
Menggunakan keduanya bisa ekonomis ketika hanya sebagian kecil tugas yang perlu dieskalasi. Ukur apakah tambahan penyelesaian yang berhasil menutupi harga dan jeda startup model kedua yang lebih tinggi.
Konteks panjang: 1,05M vs 1M bukan perbedaan penting
Angka utama terlihat hampir identik: GPT-5.6 Sol menawarkan 1,05M token dan Fable menawarkan 1M. Perbedaan kapasitas 5% kecil kemungkinan menentukan apakah Anda dapat menganalisis repositori besar, korpus legal, arsip riset, atau riwayat agen berjam-jam. Keduanya sudah kelas sejuta token.
Untuk GPT-5.6 Sol, input di atas 272K memicu tarif konteks panjang yang lebih tinggi untuk permintaan: $8/MTok input, $0,80/MTok cache-read, dan $30/MTok output. Cache write juga naik dari $5 menjadi $10/MTok.
Fable 5.1 mempertahankan tarif konteks 1M standar: $10/MTok input, $50/MTok output, dan $0,25/MTok cache read. Tidak ada premium terpisah di atas 272K dalam konfigurasi terdokumentasi ini.
Pertimbangkan satu giliran dengan 100K token input tanpa cache, 900K token cache-read, dan total 20K token output yang ditagih. Biaya GPT-5.6 Sol adalah 0,1 × $8 + 0,9 × $0.80 + 0,02 × $30 = $2.12. Biaya Fable 5.1 adalah 0,1 × $10 + 0,9 × $0.25 + 0,02 × $50 = $2.225.
Giliran berat-cache ini hampir menutup celah harga karena Fable memiliki cache-read yang lebih murah. Hasilnya bergantung pada campuran token beban kerja; ini tidak berarti kedua model berbiaya sama untuk satu sesi agen penuh.
Asumsi biaya: prefiks 900K token sudah di-cache, dan input 100K yang baru tidak ditagih sebagai cache write baru. Estimasi mengecualikan cache write awal dan biaya alat. Alokasi 20K output mencakup semua output yang ditagih, termasuk token penalaran yang ditagih.
Harga: Sol unggul di beban kerja biasa, Fable unggul dalam satu metrik cache penting
Pada tarif yang diperiksa, Sol berbiaya $4 input / $20 output per MTok, dengan $0,40 cache read. Fable 5.1 berbiaya $10 input, $50 output, dan $0,25 cache read. Tabel memisahkan harga penyedia dari GPT-5.6 Sol API di CometAPI dan Claude Fable 5.1 API di CometAPI.
| Price component | GPT-5.6 Sol Official prices | Claude Fable 5.1 Official prices |
|---|---|---|
| Official input / MTok | $4.00 | $10.00 |
| Official output / MTok | $20.00 | $50.00 |
| Official cache read / MTok | $0.40 | $0.25 |
| Official cache write / MTok | $5.00 (30 minutes) | $12.50 (5 minutes) |
| Above 272K input: input / cache read / cache write / output | $8 / $0.80 / $10 / $30 | Same documented base rates |
| CometAPI input / MTok | $3.20 | $8.00 |
| CometAPI output / MTok | $16.00 | $40.00 |
Durasi cache-write berbeda: Sol menggunakan periode retensi default 30 menit, sementara tarif Fable 5.1 yang ditampilkan adalah untuk write 5 menit. Periksa perilaku pembuatan, penyegaran, dan kedaluwarsa cache untuk penyedia dan rute yang benar-benar Anda gunakan.
Pada tarif penyedia langsung yang diperiksa, Fable 5.1 berbiaya 2,5× lebih mahal daripada Sol untuk input tanpa cache ($10 vs $4/MTok) dan output ($50 vs $20/MTok). Perlakukan tarif yang diperiksa ini sebagai perbandingan bertanggal, karena promosi penyedia dan harga gateway dapat berubah.
Permintaan konteks pendek dengan 100K input dan 10K output total yang ditagih berbiaya sekitar $0,60 dengan Sol atau $1,50 dengan Fable pada tarif penyedia langsung. Pada tarif CometAPI yang ditampilkan di atas, campuran yang sama berbiaya $0,48 atau $1,20. Contoh ini mengecualikan cache write dan biaya alat.
Tarif cache-read konteks pendek Fable 37,5% lebih rendah: ($0.40 − $0.25) ÷ $0.40. Itu dapat berarti bagi agen yang menggunakan kembali prefiks besar yang stabil, tetapi penghematan total tetap bergantung pada input baru, frekuensi write, dan volume output.
Kesimpulan harga: Sol adalah titik awal yang lebih murah untuk trafik konteks segar. Fable menjadi lebih kompetitif saat porsi cache-read tumbuh; bandingkan biaya sesi penuh, termasuk pembuatan dan penyegaran cache.
Kecepatan dan latensi
Tes upaya maksimum dapat menghabiskan waktu yang besar untuk bernalar sebelum token pertama terlihat.
Pengukuran throughput dan latensi 8 September menunjukkan 69,9 token/detik untuk Fable dan 69,8 untuk Sol. Waktu ke token pertama adalah 277,47 detik versus 132,10 detik. Throughput output praktis sama; Sol mulai menghasilkan output terlihat lebih cepat dalam konfigurasi ini.
Ini adalah pengukuran benchmark upaya maksimum, bukan janji latensi untuk setiap panggilan API. Panjang prompt, konfigurasi penalaran, beban penyedia, alat, dan status cache dapat mengubah hasil. Waktu ke token pertama dan waktu respons penuh adalah metrik berbeda.
Untuk pekerjaan interaktif, jeda startup teramati yang lebih rendah dapat menguntungkan Sol. Untuk riset asinkron atau pekerjaan repositori semalaman, penyelesaian yang berhasil bisa lebih penting daripada menunggu token pertama. Benchmark kedua model pada pengaturan dan konkurensi yang Anda niat gunakan.
Safeguards adalah perbedaan produksi
Kedua model menerapkan safeguards yang lebih kuat karena kapabilitasnya menjangkau domain keamanan siber dan sains yang sensitif, tetapi mereka mengimplementasikannya secara berbeda.
OpenAI menjelaskan perlindungan berlapis dan pemantauan untuk keluarga GPT-5.6. Aplikasi di domain sensitif harus mengevaluasi safeguards relevan sebagai bagian dari perilaku penerapan.
Ketentuan rerouting dan retensi Anthropic menggambarkan pengalihan beberapa permintaan keamanan siber atau biologi yang sensitif ke model yang kurang mampu, tanpa menagih tarif Fable untuk permintaan yang dialihkan tersebut. Periode retensi data default adalah 30 hari, dengan pengecualian untuk pengaturan enterprise yang memenuhi syarat.
Untuk coding biasa dan pekerjaan pengetahuan, perbedaan ini mungkin tidak pernah muncul. Untuk produk keamanan, beban kerja teratur, atau penerapan sensitif privasi, perbedaan ini termasuk dalam daftar periksa evaluasi berdampingan dengan kualitas benchmark dan harga.
Model mana yang harus Anda pilih?
Perbandingan keseluruhan dapat direduksi ke bentuk beban kerja.
| Workload | GPT-5.6 Sol | Claude Fable 5.1 | Recommendation |
|---|---|---|---|
| Difficult autonomous coding | Excellent | Stronger current benchmarks | Fable 5.1 |
| Long-horizon research | Excellent | Core strength | Fable 5.1 |
| High-volume frontier API | Much cheaper | Expensive | Sol |
| Interactive coding assistant | Lower measured max-effort TTFT | Higher measured max-effort TTFT | Test deployed settings |
| Tool-heavy API agent | Broader native tool stack | Strong | Sol |
| Million-token cached agent | Competitive | Very low cache-read price | Test both |
| Maximum reasoning quality | Excellent | Independent lead | Fable 5.1 |
| Cost per ordinary request | Clear advantage | Premium | Sol |
| Image/document reasoning | Strong | Strong | Test on workload |
| Single-provider OpenAI stack | Natural fit | Requires migration/gateway | Sol |
| Model-independent routing | Strong | Strong | Use both through CometAPI |
Kebijakan perutean harus menghasilkan nilai setimpal dengan kompleksitasnya. Bandingkan baseline satu model dengan kebijakan Sol-first yang mengeskalasi tugas sulit ke Fable 5.1, dan pertahankan router hanya jika itu meningkatkan biaya per tugas yang berhasil pada kualitas yang diperlukan.
Cara membandingkan GPT-5.6 Sol dan Fable 5.1 melalui CometAPI
CometAPI sudah mengintegrasikan GPT-5.6 Sol dan Claude Fable 5.1. Akses kedua model dengan format permintaan native mereka, kirim set evaluasi yang sama, dan bandingkan hasil yang dikembalikan dalam pengaturan yang disesuaikan.
Gunakan permintaan format native untuk setiap model dan tahan prompt, dataset, pengaturan effort, konkurensi, dan aturan penilaian tetap. Ulangi run; satu permintaan berurutan per model tidak cukup untuk memperkirakan latensi atau kualitas yang andal.
Untuk evaluasi produksi, gunakan set prompt tetap, ulangi run dalam urutan bergantian, catat pengaturan effort, dan nilai kebenaran, tingkat lulus tes, keberhasilan alat, percobaan ulang, penggunaan token, waktu berlalu, dan total biaya per tugas yang berhasil. Tuning setiap model secara terpisah setelah baseline umum.
Kesimpulan akhir: GPT-5.6 Sol atau Claude Fable 5.1?
Fable 5.1 memiliki bukti langsung yang lebih kuat untuk coding otonom tersulit dan pekerjaan berjangka panjang. Ia memimpin lima baris benchmark bersama milik vendor dan perbandingan terminal independen bertanggal. Itu menjadikannya kandidat eskalasi yang kuat, dengan syarat validasi pada tugas Anda sendiri.
Sol memiliki harga token biasa yang lebih rendah, kontrol penalaran yang lebih halus, dan tumpukan alat native yang luas. Dalam konfigurasi upaya maksimum independen yang diperiksa, ia juga memiliki waktu ke token pertama yang lebih rendah; throughput output praktis seri.
Prioritaskan Fable 5.1 ketika tugas otonom tersulit menentukan tingkat keberhasilan Anda. Mulai dengan Sol untuk inferensi frontier yang hemat biaya atau aplikasi yang berat alat. Untuk beban kerja interaktif, uji pengaturan effort yang diterapkan untuk memastikan apakah keunggulan jeda startup yang diamati tetap ada.
Pilih satu model ketika ia memenuhi kebutuhan Anda secara sederhana. Tambahkan perutean ketika hasil evaluasi menunjukkan bahwa beralih di antara keduanya meningkatkan kualitas atau biaya per tugas yang berhasil.
FAQ
Apakah Claude Fable 5.1 lebih baik daripada GPT-5.6 Sol?
Ia memiliki Intelligence Index independen yang lebih tinggi pada snapshot 8 September: 53, dibandingkan 47 untuk Sol. Ia juga memimpin tes terminal independen bertanggal. Itu mendukung keunggulan kualitas pada evaluasi ini, bukan klaim bahwa ia lebih baik untuk setiap beban kerja.
Apakah GPT-5.6 Sol lebih murah daripada Claude Fable 5.1?
Untuk trafik API tanpa cache biasa, ya: tarif penyedia langsung yang diperiksa adalah $4/$20 per MTok untuk Sol dan $10/$50 untuk Fable 5.1. Beban kerja berat-cache dapat mempersempit celah itu karena tarif cache-read Fable lebih rendah. Sertakan perilaku write dan kedaluwarsa dalam estimasi.
Model mana yang lebih baik untuk coding?
Fable 5.1 memiliki bukti benchmark coding otonom yang lebih kuat dalam perbandingan ini. Sol tetap menarik untuk workflow berbiaya lebih rendah dan alat eksekusi terintegrasinya. Gunakan tugas repositori dengan tes yang dapat dijalankan untuk memutuskan apakah celah kapabilitas yang terukur penting bagi aplikasi Anda.
Model mana yang punya context window lebih besar?
Secara teknis Sol unggul di 1,05M dibandingkan 1M token pada Fable 5.1, sementara keduanya mengizinkan hingga 128K output. Dalam praktiknya, ambang harga >272K milik Sol dan cache-read murah milik Fable biasanya lebih penting daripada selisih kapasitas 50K token.
Bisakah saya mengakses kedua model melalui CometAPI?
Ya. GPT-5.6 Sol API di CometAPI dan Claude Fable 5.1 API di CometAPI mendukung titik awal bersama untuk evaluasi teks. Periksa dukungan penalaran, caching, dan alat spesifik rute sebelum memperluas baseline ke agen produksi.