
Ringkas
Mulailah dengan GPT-6.1 Sol bila Anda sudah menggunakan alat Responses dari OpenAI atau membutuhkan tangga upaya penalaran yang eksplisit; uji Claude Sonnet 5.5 untuk iterasi pengkodean yang terdefinisi dengan baik dan deliverable profesional berbasis template. Ini adalah prioritas evaluasi, bukan peringkat kualitas yang terbukti. Keduanya mulai dari $2/M input dan $10/M output serta mengenakan $0.10/M untuk pembacaan cache dasar. Dengan konteks sekitar 1M dan output maksimum standar 128K, perbedaan praktis adalah integrasi, perilaku tugas, retensi cache, dan penagihan konteks panjang alih-alih diskon pembacaan cache dasar.
Pertukaran kunci adalah perilaku tugas dan kondisi penagihan. GPT-6.1 Sol menggunakan lima tingkat upaya dan memerlukan Responses untuk pemanggilan alat; Sonnet 5.5 menggunakan pemikiran adaptif. Di atas 272K token input, GPT-6.1 Sol menerapkan tarif lebih tinggi ke seluruh permintaan. Sumber yang ditinjau di sini tidak menetapkan pemenang benchmark versi yang cocok dan persis, jadi pilih model yang memenuhi kriteria penerimaan Anda dengan biaya total alur kerja terendah.
Poin-Poin Penting
- Harga dasar setara: kedua model mengenakan $2/M input, $10/M output, dan $0.10/M pembacaan cache. Bandingkan penulisan cache, retensi, tier konteks panjang, dan penggunaan yang benar-benar ditagihkan.
- Kapasitas konteks dekat: 1.05M versus 1M token; keduanya mendukung output maksimum standar 128K.
- Integrasi berbeda: GPT-6.1 Sol memerlukan Responses untuk pemanggilan alat dan tidak menerima upaya none atau minimal; Sonnet 5.5 menggunakan pemikiran adaptif dan batasan alat khusus model.
- Jaga bukti spesifik versi: skor GPT-6 Sol tidak dapat diberi label ulang sebagai hasil GPT-6.1 Sol.
- Pilih berdasarkan pekerjaan yang selesai: ukur kualitas, latensi, retry, penulisan dan pembacaan cache, biaya alat, dan koreksi manusia.
GPT-6.1 Sol vs Claude Sonnet 5.5 Sekilas
| Faktor keputusan / spesifikasi | GPT-6.1 Sol | Claude Sonnet 5.5 |
|---|---|---|
| Penyedia | OpenAI | Anthropic |
| Tanggal rilis | 29 September 2026 | 28 September 2026 |
| ID model | gpt-6.1-sol | claude-sonnet-5-5 |
| Konteks / output maksimum standar | 1,050,000 / 128,000 token | 1,000,000 / 128,000 token |
| Input → output | Teks dan gambar → teks | Teks dan gambar → teks |
| Kontrol penalaran | low, medium, high, xhigh, max; medium default | Pemikiran adaptif; default high di Claude Platform |
| Upaya default | medium | high di Claude Platform |
| Batas pengetahuan | 30 April 2026 | Juni 2026 |
| Tarif resmi dasar input/output per 1M | $2 / $10; Permintaan Standar hingga 272K token input | $2 / $10 |
| Tarif resmi pembacaan cache dasar per 1M | $0.10 | $0.10 |
| Tarif resmi penulisan cache dasar per 1M | $2.50 | $2.50 untuk 5 menit; $4.00 untuk 1 jam |
| Penagihan konteks panjang | Di atas 272K input: $4 input, $0.20 pembacaan cache, $5 penulisan cache, $15 output per 1M; berlaku untuk seluruh permintaan Standar | Tidak ada biaya tambahan ekuivalen yang dinyatakan dalam ikhtisar model yang dikutip |
| Posisi utama | Pengodean kompleks, penggunaan komputer, dan pekerjaan profesional | Iterasi pengodean cepat dan alur kerja profesional |
| Uji terlebih dahulu ketika | Anda sudah menggunakan alat Responses atau perlu kontrol upaya eksplisit | Pekerjaan Anda berpusat pada pengodean, dokumen, slide, atau spreadsheet |
| Batas bukti dan keputusan | Kapabilitas terdokumentasi; tidak ada pemenang numerik versi yang cocok dan persis yang ditetapkan di sini | Hasil pengodean dan pekerjaan pengetahuan yang dipublikasikan; bukan kemenangan terkontrol atas GPT-6.1 Sol |
Ikhtisar GPT-6.1 Sol
GPT-6.1 Sol adalah rilis Sol OpenAI tanggal 29 September 2026 untuk pengodean kompleks, penggunaan komputer, dan pekerjaan profesional. OpenAI menggambarkannya sebagai performa mendekati Astra dengan biaya lebih rendah; posisi tersebut harus divalidasi pada tugas Anda. Konteks besar dan penalaran yang dapat disesuaikan menjadikannya kandidat untuk agen repositori dan alur kerja profesional multi-langkah.
Keterbatasan operasionalnya sama pentingnya dengan posisinya: medium adalah upaya default, low adalah pengaturan terendah yang didukung, dan pemanggilan alat memerlukan Responses. Alur kerja yang dibangun di sekitar jalur tanpa penalaran atau alat Chat Completions memerlukan pekerjaan migrasi sebelum dapat menggunakan model ini secara andal.
Ikhtisar Claude Sonnet 5.5
Claude Sonnet 5.5 adalah rilis Anthropic tanggal 28 September 2026 untuk pengodean sehari-hari yang terdefinisi dengan baik, agen, dan pekerjaan profesional. Ikhtisar modelnya mendokumentasikan pemikiran adaptif, upaya default high di Claude Platform, input teks-dan-gambar, dan output maksimum standar 128K. Anthropic menekankan perbaikan bug, dokumen yang jelas, slide yang dipoles, dan iterasi yang efisien.
Bagi tim pengembangan, hal itu membuat Sonnet menjadi kandidat yang berguna untuk siklus implementasi dan peninjauan berulang. Untuk alur kerja kantor, evaluasi kualitas draf pertama dan kepatuhan terhadap template. Klaim kecepatan penyedia membandingkan Sonnet 5.5 dengan Sonnet 5; itu tidak menetapkan keunggulan kecepatan atas GPT-6.1 Sol.
GPT-6.1 Sol vs Claude Sonnet 5.5: Performa
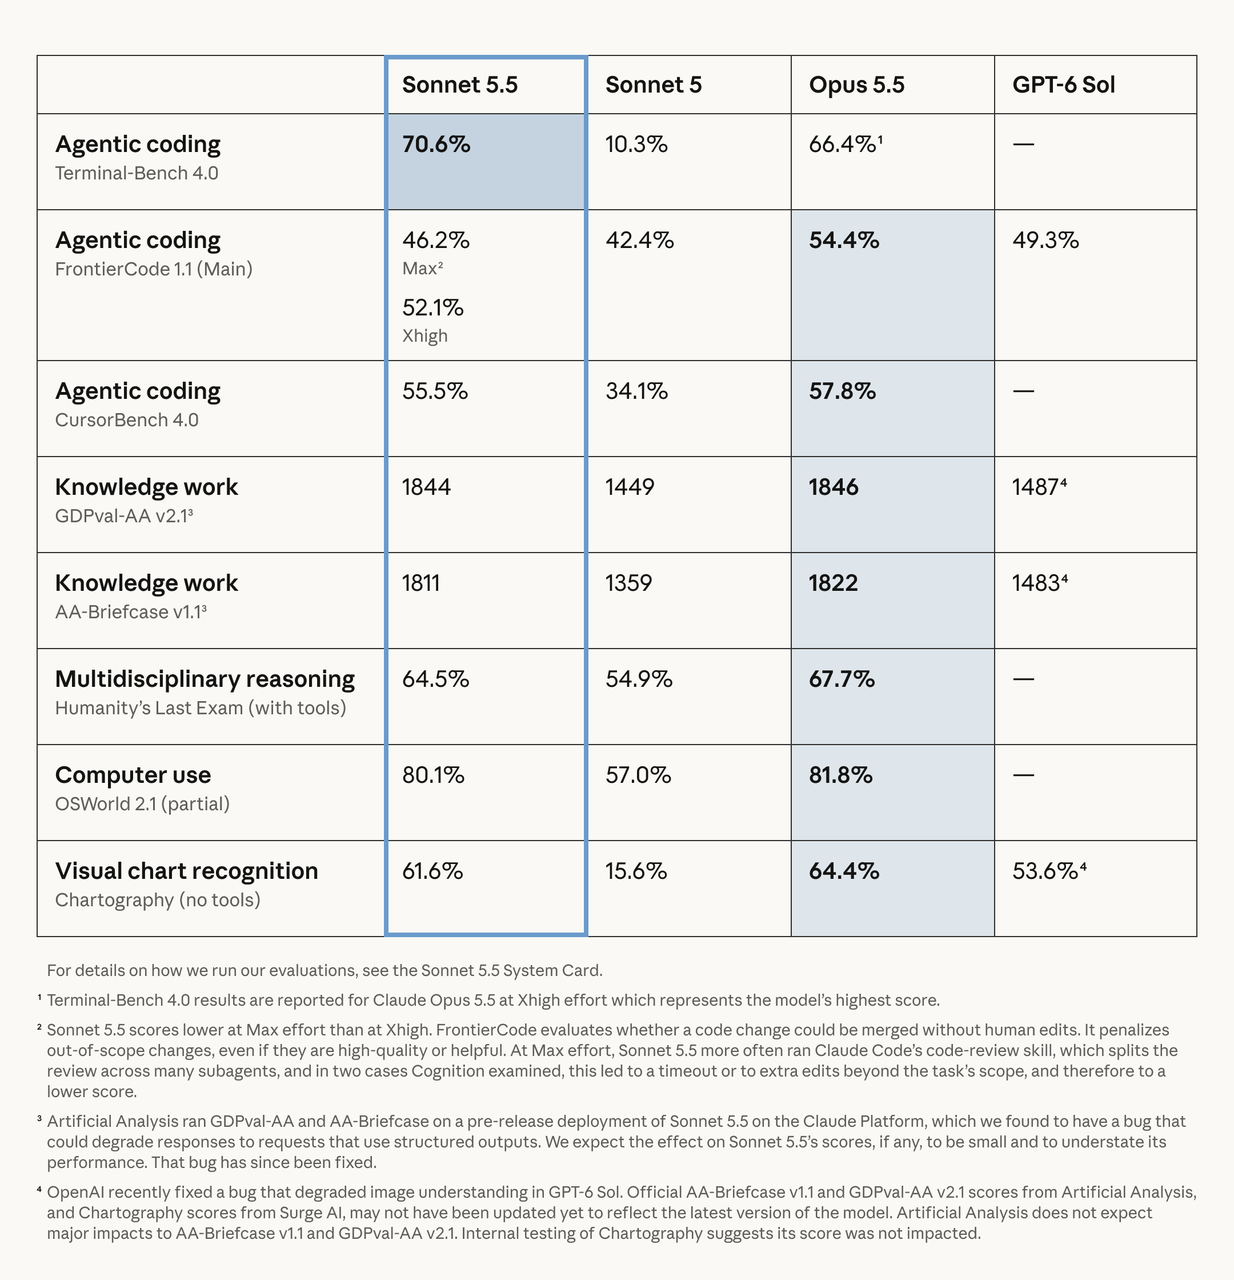
Hasil peluncuran Sonnet 5.5 dari Anthropic menyediakan kumpulan sinyal beban kerja yang berguna. Perbandingannya mencakup GPT-6 Sol yang lebih lama, jadi nilai kolom OpenAI tersebut dikeluarkan dari tabel model saat ini di bawah. “Belum ditetapkan” berarti sumber yang dikutip tidak mendukung skor versi yang persis cocok untuk perbandingan ini; itu tidak berarti nol performa.
| Benchmark / kondisi | GPT-6.1 Sol | Claude Sonnet 5.5 | Apa yang diukur |
|---|---|---|---|
| Terminal-Bench 4.0 | Belum ditetapkan di sini | 70.6% | Tugas pengodean terminal |
| FrontierCode 1.1 Main | Belum ditetapkan di sini | 52.1% Xhigh; 46.2% Max | Perubahan repositori yang dapat digabung |
| CursorBench 4.0 | Belum ditetapkan di sini | 55.5% | Pengembangan agentik dalam tugas Cursor |
| GDPval-AA v2.1 | Belum ditetapkan di sini | 1844 | Pekerjaan pengetahuan profesional |
| AA-Briefcase v1.1 | Belum ditetapkan di sini | 1811 | Pekerjaan pengetahuan jangka panjang |
| Humanity’s Last Exam, tools | Belum ditetapkan di sini | 64.5% | Penalaran multidisiplin |
| OSWorld 2.1, parsial | Belum ditetapkan di sini | 80.1% | Reward parsial penggunaan komputer |
| Chartography, tanpa alat | Belum ditetapkan di sini | 61.6% | Pengenalan grafik visual |
Kondisi uji: upaya dan harness agen memengaruhi hasil pengodean. GDPval-AA dan AA-Briefcase adalah evaluasi Artificial Analysis, sementara hasil Chartography berasal dari Surge AI. Anthropic mencatat bug output terstruktur yang kemudian diperbaiki dalam deployment pra-rilis Sonnet yang mungkin sedikit menurunkan hasil pekerjaan profesionalnya. Gunakan tautan System Card dari pengumuman untuk lingkungan uji dan metodologi lengkap; jangan menggabungkan metrik yang tidak sejenis menjadi satu peringkat keseluruhan.
Gambar Anthropic asli di bawah menyertakan catatan kaki evaluasinya. Kolom GPT-6 Sol adalah konteks historis saja dan tidak melaporkan performa GPT-6.1 Sol saat ini.
Pengkodean Agentik dan Rekayasa Perangkat Lunak
Sonnet 5.5 memiliki bukti yang dilaporkan pada pengodean terminal, perubahan kode yang dapat digabung, dan tugas agen bergaya IDE. GPT-6.1 Sol didokumentasikan untuk pengodean kompleks dan terintegrasi dengan ekosistem alat OpenAI. Baik posisi produk maupun skor pendahulu tidak menetapkan pemenang pengodean saat ini. Untuk evaluasi yang berguna, pilih perubahan nyata dengan uji regresi dan mintalah peninjau menilai ruang lingkup, kemampuan pemeliharaan, dan kesiapan untuk digabung.
Pekerjaan Pengetahuan, Penalaran, Matematika, dan Sains
Hasil GDPval-AA dan AA-Briefcase dari Sonnet menjadikan laporan, analisis, dan deliverable kantor sebagai target evaluasi yang masuk akal. GPT-6.1 Sol juga menargetkan pekerjaan profesional, tetapi sumber yang digunakan di sini tidak memberikan perbandingan yang cocok di seluruh model ini. Gunakan template dokumen, spreadsheet, dan presentasi Anda sendiri. Klaim matematika lanjutan dan ilmiah memerlukan bukti khusus tugas daripada ekstrapolasi dari kontrol penalaran umum.
Penggunaan Komputer, Otomasi Browser, dan Alur Kerja Multimodal
Kedua model menerima gambar, yang mendukung debugging tangkapan layar dan analisis visual. Hasil OSWorld dan Chartography dari Sonnet adalah bukti untuk evaluasi khusus tersebut. GPT-6.1 Sol mendokumentasikan penggunaan komputer melalui alat Responses. Uji seluruh alur kerja: akurasi navigasi, pemulihan setelah pemanggilan alat gagal, kebenaran output, dan waktu penyelesaian. Input teks-dan-gambar tidak dengan sendirinya menjamin integrasi penggunaan komputer yang identik.
Evaluasi Independen dan Kualitas Bukti
Tabel yang dipublikasikan penyedia dapat memuat hasil pihak ketiga tanpa menjadi eksperimen terkontrol tunggal. Untuk perbandingan independen, catat ID model yang tepat, tanggal deployment, upaya, alat, perlindungan, batas waktu, kebijakan retry, dan aturan penghentian. Indeks kecerdasan agregat, tingkat keberhasilan pengodean, dan skor reward parsial penggunaan komputer menjawab pertanyaan yang berbeda. Sumber yang ditinjau tidak menetapkan kumpulan hasil independen yang lengkap dan cocok untuk pasangan tepat ini.
GPT-6.1 Sol vs Claude Sonnet 5.5: Biaya
Harga API Resmi
| Metrik harga | Tarif resmi GPT-6.1 Sol | Tarif resmi Claude Sonnet 5.5 |
|---|---|---|
| Input / 1M token, dasar Standar | $2.00 | $2.00 |
| Output / 1M token, dasar Standar | $10.00 | $10.00 |
| Pembacaan cache / 1M token, dasar | $0.10 | $0.10 |
| Penulisan cache / 1M token, dasar | $2.50 | $2.50 untuk 5m; $4.00 untuk 1 jam |
| Pemrosesan batch | 50% di bawah Standar | Diskon input/output 50% |
| Input di atas 272K, seluruh permintaan Standar | $4 input / $0.20 pembacaan cache / $5 penulisan cache / $15 output | Tidak ada biaya tambahan ekuivalen yang dinyatakan dalam ikhtisar yang dikutip |
Semua tarif adalah USD per juta token. Tarif pembacaan cache dasar GPT-6.1 Sol adalah $0.10/M dan pembacaan cache Sonnet 5.5 juga $0.10/M. Kondisi di atas-272K input pada Sol menaikkan tarif untuk seluruh permintaan Standar, bukan hanya token berlebih. Bandingkan penulisan cache, retensi, tier konteks panjang, pemrosesan regional, dan tier layanan; harga pembacaan dasar saja tidak memberi keunggulan pada salah satu model.
Biaya per Tugas yang Selesai
Biaya per hasil yang diterima = total biaya di semua tugas yang dicoba / jumlah hasil yang diterima. Total biaya mencakup input baru yang ditagihkan, pembacaan dan penulisan cache, output (termasuk token penalaran yang ditagihkan bila berlaku), panggilan alat berbayar, dan peninjauan atau koreksi manusia. Biaya retry dihitung berdasarkan penggunaan aktualnya, tidak ditambahkan lagi sebagai biaya duplikat.
Untuk satu juta token pembacaan cache yang ditagihkan sepenuhnya pada tarif dasar, kedua model berbiaya $0.10; perbedaan harga pembacaan dasar adalah $0.00. Ini adalah ilustrasi tarif, bukan permintaan Sol dengan satu juta token input yang dihargai pada tier dasar. Biaya sesi aktual juga mencakup input baru, penulisan cache, output, alat, dan retry. Bandingkan sesi dingin dan hangat di bawah tier konteks yang berlaku dan laporkan tingkat hasil yang diterima bersamaan dengan penggunaan yang ditagihkan.
Harga CometAPI
| Tier CometAPI yang dipublikasikan | API GPT-6.1 Sol di CometAPI | API Claude Sonnet 5.5 di CometAPI |
|---|---|---|
| Input / output dasar per 1M | $1.60 / $8.00 | $1.60 / $8.00 |
| Diskon dasar vs penyedia | 20% | 20% |
| Input / output konteks panjang GPT | $3.20 / $12.00 | Periksa ketentuan jalur terkini |
| Pembacaan cache GPT, dasar / panjang | $0.08 / $0.16 | Tidak ditentukan dalam tabel harga dasar yang dikutip |
Ini adalah harga jalur model yang dipublikasikan untuk revisi ini, terpisah dari tarif penyedia. Harga GPT-6.1 Sol di CometAPI membedakan konteks pendek dan panjang. Tabel dasar Sonnet yang dikutip mencantumkan input dan output, sehingga tidak membenarkan asumsi kebijakan cache gateway yang identik. Periksa ketentuan penagihan jalur yang dipilih saat mengestimasi sesi produksi.
Bagaimana Perbandingan Jendela Konteks, Kecepatan, dan Spesifikasi Teknis?
GPT-6.1 Sol mendukung 1.05M token, sedangkan Claude Sonnet 5.5 mendukung 1M token. Perbedaan nominal hanya sekitar 5%, jadi kapasitas konteks saja tidak mungkin memutuskan sebagian besar penerapan.
Tangga upaya GPT-6.1 Sol adalah low, medium, high, xhigh, dan max; medium adalah default. Sonnet 5.5 menggunakan pemikiran adaptif dengan default high di Claude Platform. Nama-nama tersebut tidak menyiratkan anggaran penalaran yang setara. Pada persyaratan kualitas yang sama, ukur waktu ke token pertama, laju keluaran, latensi loop alat, dan penyelesaian ujung-ke-ujung secara terpisah.
Anthropic melaporkan generasi output lebih dari 30% lebih cepat untuk Sonnet 5.5 dibanding Sonnet 5. Perlakukan itu sebagai perbandingan dengan pendahulu. Bukti artikel ini tidak menetapkan satu angka latensi universal untuk GPT-6.1 Sol atau pemenang kecepatan langsung antara model saat ini. Untuk beban kerja interaktif, uji pengaturan upaya yang lebih rendah terhadap rubrik penerimaan yang sama alih-alih mengasumsikan max adalah pengaturan penerapan terbaik.
Apa yang Penting untuk Keamanan, Alignment, dan Penerapan?
Keputusan penerapan harus membedakan perilaku model yang terdokumentasi dari kontrol aplikasi. Perbandingan model saja tidak dapat menetapkan deployment mana yang memenuhi persyaratan penanganan data atau akses organisasi Anda. Evaluasi penyedia atau gateway yang benar-benar Anda gunakan, termasuk pencatatan permintaan, residensi data, izin alat, dan penanganan kegagalan.
- Migrasi penalaran: GPT-6.1 Sol tidak mendukung none atau minimal. Panduan migrasi OpenAI mengarahkan alur kerja pemanggilan alat ke Responses.
- Perilaku alat Claude: perubahan kompatibilitas Sonnet 5.5 yang didokumentasikan mencakup mode alat paksa yang tidak didukung dan blok pemikiran terikat percakapan. Uji jalur ini sebelum roll-out.
- Kontrol operasional: berikan agen hanya alat yang diperlukan untuk tugas, catat panggilan gagal, dan pertahankan peninjauan manusia untuk tindakan eksternal yang berakibat. Ini adalah pilihan desain aplikasi, bukan keunggulan terukur untuk salah satu model.
GPT-6.1 Sol vs Claude Sonnet 5.5: Mana yang Harus Anda Pilih?
Uji GPT-6.1 Sol terlebih dahulu bila Anda sudah menggunakan alat Responses atau membutuhkan tangga upaya yang dapat diprediksi. Uji Sonnet 5.5 untuk iterasi pengodean yang terdefinisi dengan baik, slide, spreadsheet, dan alur kerja dokumen di mana buktinya yang dilaporkan cocok dengan tugas Anda. Untuk sesi awalan ter-cache, uji keduanya: tarif pembacaan cache dasar mereka setara, sementara biaya penulisan, retensi, tier konteks panjang, dan keberhasilan tugas dapat mengubah total tagihan. Rute pekerjaan hanya setelah evaluasi representatif menetapkan perbedaan kualitas, biaya, atau latensi yang berguna.
Seleksi Berbasis Beban Kerja
| Beban kerja | Titik awal | Yang perlu diverifikasi |
|---|---|---|
| Agen OpenAI Responses yang ada | GPT-6.1 Sol | Kompatibilitas alat dan perubahan upaya |
| Iterasi pengodean / perbaikan bug | Sonnet 5.5, lalu bandingkan Sol | Kesiapan merge, latensi dan retry |
| Slide / spreadsheet / laporan | Sonnet 5.5, lalu bandingkan Sol | Kepatuhan template dan waktu edit manusia |
| Sesi awalan ter-cache stabil | Keduanya; tarif pembacaan cache dasar setara | Tingkat hit, penulisan, tier konteks, dan kualitas yang diterima |
| Permintaan penuh di atas 272K input | Keduanya | Tagihan konteks panjang aktual dan kualitas retrieval |
| Otomasi komputer / browser | Keduanya | Pemulihan, penyelesaian tugas, dan izin |
| Matematika / analisis ilmiah | Keduanya pada uji khusus tugas | Kebenaran dengan jawaban yang dapat diverifikasi |
| Produksi sensitif biaya | Keduanya | Biaya total per hasil yang diterima |
Perbandingan produksi harus menahan sistem di sekelilingnya konstan. Gunakan prompt yang sama, repositori atau dokumen yang sama, izin alat, batas waktu, kebijakan retry, dan rubrik penerimaan output yang sama.
Catat input baru, penulisan dan pembacaan cache, penggunaan output, panggilan alat berbayar, retry, waktu peninjauan manusia, keberhasilan tugas, dan latensi ujung-ke-ujung. Respons pertama yang lebih murah masih dapat menghasilkan hasil yang diterima yang lebih mahal.
Bagaimana Cara Mengakses GPT-6.1 Sol dan Claude Sonnet 5.5?
Pengembang dapat mengakses API GPT-6.1 Sol di CometAPI dan API Claude Sonnet 5.5 di CometAPI melalui jalur model yang terdokumentasi. Buat kunci API, simpan dengan aman, dan verifikasi akses model serta penagihan spesifik jalur sebelum penggunaan produksi.
Akses GPT-6.1 Sol
Untuk Sol, gunakan jalur Responses yang terdokumentasi saat pemanggilan alat diperlukan. Pilih gpt-6.1-sol dan tingkat upaya yang didukung, dengan medium sebagai default. Berikan input tugas, konfigurasikan hanya alat yang diperlukan, dan validasi teks yang dikembalikan, panggilan alat, error, dan penggunaan. Konfirmasi dukungan gateway untuk fitur spesifik penyedia alih-alih mengasumsikan setiap opsi OpenAI tersedia.
Akses Claude Sonnet 5.5
Untuk Sonnet, pilih claude-sonnet-5-5 pada antarmuka yang kompatibel dan kirim tugas sebagai pesan percakapan dengan anggaran output yang sesuai. Konfirmasi bagaimana jalur tersebut menangani pemikiran native dan parameter alat; field penalaran OpenAI tidak secara otomatis dapat dipertukarkan dengan opsi Claude. Validasi kelanjutan percakapan dan penanganan error sebelum penerapan agen.
Pemeriksaan endpoint memverifikasi konektivitas, bukan performa komparatif. Untuk evaluasi, selaraskan prompt, anggaran output dan penalaran efektif, alat, retry, batas waktu, dan kriteria penerimaan, lalu bandingkan pekerjaan yang diterima, latensi, dan biaya total yang ditagihkan.
Kesimpulan
GPT-6.1 Sol dan Claude Sonnet 5.5 memiliki tarif input, output, dan pembacaan cache dasar yang sama, dengan kapasitas konteks yang serupa. Sol adalah kandidat alami untuk agen Responses yang ada dan kontrol upaya eksplisit. Pemikiran adaptif Sonnet serta hasil pengodean dan pekerjaan profesional yang dilaporkan menjadikannya kandidat yang berguna untuk deliverable sehari-hari. Alur kerja yang berat pada cache memerlukan perbandingan sesi penuh: tarif pembacaan dasar yang setara tidak menjamin biaya penulisan, retensi, konteks panjang, atau biaya tugas yang selesai yang setara.
Pilih model yang menyelesaikan pekerjaan Anda yang sebenarnya dalam persyaratan kualitas, latensi, dan biaya. Pisahkan skor pendahulu dari bukti model saat ini, harga tier konteks yang digunakan beban kerja Anda, dan bandingkan kedua jalur sebelum mengadopsi default.
FAQ
Bisakah GPT-6.1 Sol dan Sonnet 5.5 berbagi satu skema alat?
Definisi alat JSON umum dapat menjadi titik awal, tetapi dukungan endpoint, perilaku alat paksa, blok pemikiran, dan penanganan respons berbeda. Validasi panggilan alat setiap model dengan pengujian kontrak untuk argumen, jalur kegagalan, dan kelanjutan percakapan. Pertahankan adaptor khusus model untuk opsi yang tidak didukung alih-alih mengasumsikan permintaan teks yang sukses membuktikan kompatibilitas agen.
Bagaimana upaya penalaran harus dicocokkan di kedua model?
Jangan menganggap pengaturan bernama sama sebagai anggaran komputasi yang setara. Tentukan rubrik penerimaan dan batas biaya atau target latensi, lalu sapu pengaturan upaya untuk setiap model. Bandingkan konfigurasi terbaik yang memenuhi kendala operasional yang sama, termasuk retry dan koreksi manusia, daripada hanya membandingkan pengaturan tertinggi kedua model.
Kapan alur kerja konteks 1M harus menggunakan retrieval sebagai gantinya?
Gunakan retrieval ketika suatu tugas membutuhkan bagian kecil yang dapat diidentifikasi dari korpus besar dan uji retrieval Anda menunjukkan materi relevan secara konsisten ditemukan. Uji permintaan konteks penuh saat bukti tersebar atau hubungan lintas file penting. Bandingkan kebenaran jawaban, cakupan sitasi, biaya input, dan latensi; batas konteks besar saja tidak menetapkan bahwa mengisi seluruh jendela itu ekonomis atau andal.
Bagaimana tim dapat menghindari perbandingan biaya cache yang menyesatkan?
Ukur sesi cache dingin dan cache hangat secara terpisah, catat penulisan cache serta pembacaan, dan terapkan jendela retensi dan tier konteks panjang yang benar. Jaga awalan bersama tetap stabil dan bandingkan sesi berulang realistis, bukan hanya satu permintaan yang didiskon. Laporkan tingkat hit dan penggunaan total yang ditagihkan sehingga penghematan yang tampak dapat direproduksi.
Apa yang harus memicu evaluasi baru GPT-6.1 Sol vs Sonnet 5.5?
Jalankan kembali kumpulan tugas yang terpengaruh setelah pembaruan penerapan, perbaikan bug penyedia, perubahan routing, alat atau prompt, atau revisi harga material. Catat tanggal evaluasi, ID model, endpoint, upaya, dan versi harness. Pertahankan run sebelumnya sebagai baseline sehingga perubahan kualitas atau latensi tidak tertukar dengan perubahan di sistem sekeliling.