TL;DR
GPT-6.1 Sol bukan pengganti GPT-6 Sol dengan konteks lebih besar atau harga lebih mahal. Model ini tetap mempertahankan jendela konteks 1,05 juta token, output maksimum 128K, dan harga API Standar $2/$10, sambil meningkatkan kemampuan coding, penggunaan komputer, alur kerja profesional, keandalan faktual, dan perilaku agen. Perubahan harga paling jelas adalah cache prompt: biaya input yang di-cache turun dari $0,20 menjadi $0,10 per juta token.
Hasil praktisnya adalah GPT-6.1 Sol bukan soal mengubah bentuk API, melainkan menghasilkan kerja yang jauh lebih berguna dengan kisaran anggaran token yang kurang lebih sama.
Poin Utama
- GPT-6.1 Sol adalah peningkatan kapabilitas atas GPT-6 Sol, dengan jendela konteks 1.050.000 token dan batas output 128.000 token yang sama.
- Harga input dan output API Standar tetap $2/M dan $10/M; input yang di-cache turun dari $0,20/M menjadi $0,10/M.
- Evaluasi resmi menunjukkan penguatan pada coding, penggunaan komputer, otomasi bisnis, dan alur kerja sains; hasil bergantung pada tolok ukur dan pengaturan penalaran.
- Migrasi memerlukan pengecekan upaya penalaran dan kompatibilitas endpoint API: GPT-6.1 Sol tidak menghapus apa pun dan mewajibkan Responses API untuk pemanggilan tool.
- Validasi keberhasilan tugas, latensi, hit cache aktual, dan biaya end-to-end sebelum mengganti deployment GPT-6 Sol yang stabil.
Apa itu GPT-6.1 Sol, dan Mengapa Hadir Begitu Cepat setelah GPT-6 Sol?
OpenAI memperkenalkan GPT-6 Sol pada 22 Sep 2026. Satu minggu kemudian, addendum kartu sistem tanggal 29 Sep mengumumkan GPT-6.1 Sol. OpenAI menyajikan rilis baru ini sebagai upgrade ke GPT-6 Sol alih-alih tier harga terpisah.
Jarak rilis yang singkat penting karena GPT-6.1 Sol tidak diposisikan sebagai tier produk baru. OpenAI mempertahankan tier harga Sol dan memfokuskan pembaruan pada kapabilitas tugas sulit, efisiensi biaya, dan keandalan agen.
OpenAI memposisikan GPT-6.1 Sol seputar coding agenik, penggunaan komputer, dan pekerjaan profesional. Perbandingan penting adalah keberhasilan tugas pada biaya tertentu, bukan nama model semata. Ringkasan tolok ukur resmi di bawah memisahkan kenaikan kapabilitas dari spesifikasi API yang tidak berubah.
Ini membuat perbandingan menjadi tidak biasa karena lebih lugas: GPT-6.1 Sol terutama merupakan peningkatan kapabilitas dan efisiensi, bukan peningkatan jendela konteks atau harga dasar.
GPT-6.1 Sol vs. GPT-6 Sol: Apa yang Tetap Sama?
Kedua model mempertahankan kapasitas utama yang sama, modalitas input/output yang didukung, dan harga Standar untuk input/output. Tabel juga mencatat perbedaan tanggal cutoff, opsi penalaran, pemanggilan tool, dan tarif input cache; perbedaan tersebut tidak boleh disalahartikan sebagai spesifikasi yang sama.
Spesifikasi yang Sama dan Perbedaan Kompatibilitas
| Spesifikasi | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|
| ID model | gpt-6.1-sol | gpt-6-sol |
| Tanggal rilis | 29 Sep 2026 | 22 Sep 2026 |
| Jendela konteks | 1.050.000 token | 1.050.000 token |
| Output maksimum | 128.000 token | 128.000 token |
| Batas pengetahuan | 30 Apr 2026 | 20 Apr 2026 |
| Input / output teks | Ya / Ya | Ya / Ya |
| Input gambar | Ya | Ya |
| Harga input Standar | $2,00 / 1M | $2,00 / 1M |
| Input cache | $0,10 / 1M | $0,20 / 1M |
| Penulisan cache | $2,50 / 1M | $2,50 / 1M |
| Harga output | $10,00 / 1M | $10,00 / 1M |
| Upaya penalaran | low, medium, high, xhigh, max | none, low, medium, high, xhigh, max |
| Output terstruktur | Ya | Ya |
| Panggilan fungsi | Ya melalui Responses API; tidak tersedia melalui Chat Completions | Ya melalui Responses API; Chat Completions hanya dengan reasoning_effort=none |
| Fine-tuning | Tidak | Tidak |
| Input audio / video | Tidak didukung | Tidak didukung |
| Output gambar bawaan | Tidak didukung; pembuatan gambar adalah alat terpisah | Tidak didukung; pembuatan gambar adalah alat terpisah |
Dua kolom model resmi di atas mendokumentasikan batas konteks dan output yang sama. Angka-angka ini menggambarkan kapasitas; angka tersebut tidak menetapkan akurasi retrieval atau latensi yang sama di setiap beban kerja konteks panjang.
Batas pengetahuan bergerak sedikit maju, dari 20 April ke 30 April 2026. Yang lebih penting, GPT-6.1 Sol tidak lagi mendukung reasoning.effort="none"; pengaturan penalaran yang tersedia dimulai dari low.
Bagi pengembang yang bergantung pada perilaku dengan latensi minimal, detail kompatibilitas ini layak diuji karena GPT-6 Sol masih mendukung reasoning effort none.
Arsitektur: Apa yang Masih Tidak Diungkapkan
Tidak ada halaman model yang digunakan untuk perbandingan ini menyediakan jumlah parameter atau rincian arsitektur. Addendum kartu sistem resmi menyatakan GPT-6.1 Sol menggunakan jenis data dan pelatihan yang sama seperti Astra; pernyataan ini tidak membuktikan bahwa Sol dan Astra memiliki arsitektur yang identik. Perbedaan arsitektur dan skala parameter tetap tidak diungkapkan dalam materi yang dikutip.
Harga Dasar Tidak Berubah; Pembacaan Cache Lebih Murah
Untuk token biasa yang tidak di-cache, tidak. Tarif input dan output Standar tidak berubah. Peningkatan harga utama adalah input yang di-cache.
| Harga resmi API — USD per 1M token | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|
| Input / 1M token | $2,00 | $2,00 |
| Input cache / 1M | $0,10 | $0,20 |
| Penulisan cache / 1M | $2,50 | $2,50 |
| Output / 1M token | $10,00 | $10,00 |
GPT-6.1 Sol memangkas input yang di-cache menjadi $0,10 per juta token, atau 5% dari tarif input tidak di-cache.
Sebagai contoh, menggunakan kembali 100 juta token input yang di-cache biayanya sekitar $10 pada GPT-6.1 Sol dibanding $20 pada GPT-6 Sol. Perbedaan ini moderat untuk prompt satu kali namun lebih bermakna bagi agen volume tinggi dengan prefiks prompt yang stabil.
Ketentuan harga resmi yang ditampilkan di dokumentasi model juga berlaku: permintaan di atas 272K token input menggunakan tarif input dan cache 2x serta harga output 1,5x untuk seluruh permintaan. Fast mode GPT-6.1 Sol adalah 2x Standar; Batch dan Flex berada 50% di bawah Standar. Pemrosesan regional menambah premi 10% bila tersedia, dan Fast mode tidak tersedia dengan residensi data UE. Biaya alat terpisah dapat berlaku. Susun anggaran berdasarkan mode pemrosesan, wilayah, dan hit cache aktual yang dipilih.
Apa yang Meningkat di GPT-6.1 Sol?
Peningkatan terbaik dinilai di bidang coding, alur kerja agen, pekerjaan profesional, sains, faktualitas, dan pemulihan kegagalan. Bagian di bawah mengelompokkan peningkatan tersebut sambil mempertahankan kondisi dan keterbatasan tolok ukur asli.
Ikhtisar Benchmark: Kenaikan yang Dilaporkan dan Kondisi Evaluasi
Kasus terkuat untuk GPT-6.1 Sol berasal dari performa tingkat tugas, bukan spesifikasi mentah. OpenAI melaporkan peningkatan di rekayasa perangkat lunak, otomasi bisnis, interaksi komputer, alur kerja sains, faktualitas, dan alignment agen.
| Benchmark/hasil evaluasi resmi | GPT-6.1 Sol vs. GPT-6 Sol | Arti Perubahan |
|---|---|---|
| DeepSWE v1.1 | +6,4 poin persentase dibanding hasil terbaik GPT-6 Sol, pada upaya penalaran dan biaya tugas yang lebih rendah; ini bukan perbandingan upaya yang disamakan | Rekayasa perangkat lunak jangka panjang lebih kuat |
| AutomationBench 1.0.6 | +4,8 poin pada upaya medium untuk kedua model Sol; +2,2 poin dibanding Opus 5.5 pada upaya medium | Eksekusi agen bisnis multi-langkah lebih baik |
| OSWorld 2.0 offline | +7 poin pada upaya max; reward parsial pada set offline, rilis v2026.08.08; kurang dari setengah biaya tugas | Alur kerja penggunaan komputer lebih baik |
| Terminal-Bench Science 0.1 | Lebih dari 2x skor GPT-6 Sol pada upaya max, dengan kurang dari setengah biaya per tugas | Kenaikan besar pada alur kerja agen sains |
| Evaluasi faktualitas sulit | Pada upaya low, respons yang mengandung error turun dari 11,4% menjadi 7,7%; ini adalah evaluasi prompt sulit yang dipilih | Lebih sedikit kesalahan faktual pada prompt sulit |
| Uji penyelarasan saat pencarian rusak | Pada upaya maksimum, kegagalan mengungkap pencarian yang rusak turun dari 4,9% menjadi 2,1%; tugas yang sengaja adversarial | Pengakuan kegagalan tool lebih baik |
Ini adalah hasil yang dilaporkan OpenAI, bukan pengukuran independen CometAPI. OpenAI mengevaluasi modelnya di lingkungan risetnya atau melalui API; perilaku produksi dapat berbeda dengan prompt sistem dan tool yang tersedia. Angka kompetitor berasal dari laporan publik. Biaya tugas mencerminkan konfigurasi yang diuji dan tidak sama dengan harga token. Detail yang tidak dilaporkan seperti anggaran per-run atau scaffold tidak boleh disimpulkan.
Hasil resmi dalam tabel benchmark membandingkan GPT-6.1 Sol pada upaya penalaran lebih rendah dengan skor terbaik GPT-6 Sol. Ini tidak boleh digambarkan sebagai perbandingan kecepatan upaya yang setara. DeepSWE v1.1 mengevaluasi tugas rekayasa perangkat lunak orisinal di basis kode nyata.
Sebagai konteks, peluncuran GPT-6 Sol melaporkan 68,8% pada upaya maksimum di DeepSWE v1.1.
Pengodean: Rekayasa Perangkat Lunak Jangka Panjang yang Lebih Kuat
Coding mungkin adalah peningkatan yang paling jelas. DeepSWE v1.1 mengevaluasi agen pada tugas rekayasa perangkat lunak orisinal di basis kode nyata yang memerlukan kerja berkelanjutan multi-langkah.
Peningkatan DeepSWE yang diringkas di atas relevan ketika agen harus memeriksa repositori, merencanakan perubahan, menggunakan tool, dan memperbaiki kegagalan dalam banyak langkah. Pengembang dapat membandingkan peningkatan ini dengan GPT-6 Astra API di CometAPI saat memutuskan apakah tugas tersulit membenarkan model dengan biaya lebih tinggi.
Ini lebih penting daripada tolok ukur coding singkat karena agen coding yang berjalan lama mengakumulasi biaya melalui penalaran berulang, pemanggilan tool, pembacaan file, patch, dan penggunaan ulang konteks. GPT-6.1 Sol meningkatkan baik penyelesaian tugas maupun ekonomi konteks berulang tanpa menaikkan tarif token $2/$10 standar.
GPT-6 Sol API di CometAPI tetap berguna untuk deployment yang ada dan menyediakan jalur yang kompatibel dengan OpenAI untuk beban kerja coding dan berbasis agen.
Agen AI dan Alur Kerja Bisnis: Otomasi dan Penggunaan Komputer
Ya, dan peningkatannya melampaui coding. AutomationBench mengevaluasi apakah agen dapat menyelesaikan alur kerja end-to-end menggunakan banyak tool di penjualan, pemasaran, operasi, dukungan, keuangan, dan HR.
Hasil AutomationBench pada medium yang disamakan dalam ringkasan benchmark relevan untuk alur kerja bisnis yang padat tool. Ini tetap hasil tolok ukur, bukan jaminan keberhasilan di stack tool perusahaan Anda. Perbandingan juga mencakup Claude Opus 5.5 API di CometAPI; evaluasi semua kandidat dengan tool dan kriteria keberhasilan yang sama sebelum memilih.
Untuk penggunaan komputer, hasil OSWorld di atas menggunakan set offline dan reward parsial. Skor reward parsial yang lebih tinggi tidak selalu berarti setiap tugas selesai end-to-end. Keadaan peramban, izin, perilaku pemulihan, dan kualitas integrasi tool masih mempengaruhi hasil deployment.
Dokumen Profesional dan Sains: Kapabilitas Tugas Kompleks yang Lebih Luas
GPT-6.1 Sol juga mendorong tier Sol lebih jauh ke kerja pengetahuan profesional. OpenAI mengevaluasi pemahaman dokumen kompleks dengan GDP.pdf, di mana model menjawab pertanyaan realistis berdasarkan PDF yang berisi tabel, grafik, diagram, format padat, dan detail catatan kaki di bidang seperti keuangan, kesehatan, dan hukum.
GDP.pdf menambah bukti untuk analisis PDF profesional di luar tanya jawab teks biasa. Perlakukan hasilnya dalam pengumuman peluncuran sebagai evaluasi pemahaman dokumen, bukan jaminan bahwa setiap grafik, catatan kaki, atau halaman hasil pindai akan ditafsirkan dengan benar.
Hasil Terminal-Bench Science dalam ringkasan benchmark resmi mencakup alur kerja seperti analisis data, simulasi, dan pembuktian teorema. Evaluasi lokal yang berguna harus menilai ketepatan dan reprodusibilitas output akhir, sekaligus mengukur total biaya tool dan model.
Ini tidak berarti GPT-6.1 Sol secara universal menggantikan Astra. OpenAI terus memposisikan Astra sebagai model berkapabilitas tertinggi untuk pekerjaan end-to-end tersulit. Perubahan pentingnya adalah jarak performa antara Sol dan Astra menyempit sementara jarak harga token mereka tetap besar.
Faktualitas dan Keandalan Agen: Lebih Sedikit Kesalahan dan Penanganan Kegagalan yang Lebih Baik
Data faktualitas OpenAI mengarah ke sana, meski evaluasi tidak boleh ditafsirkan sebagai tingkat halusinasi universal.
Pengumuman resmi langsung melaporkan peningkatan faktualitas pada upaya low: respons yang mengandung error turun dari 11,4% dengan GPT-6 Sol menjadi 7,7% dengan GPT-6.1 Sol, penurunan 3,7 poin persentase, atau sekitar 32% penurunan relatif. Percakapan terpilih ini sebelumnya memicu error; angka tersebut bukan tingkat halusinasi universal.
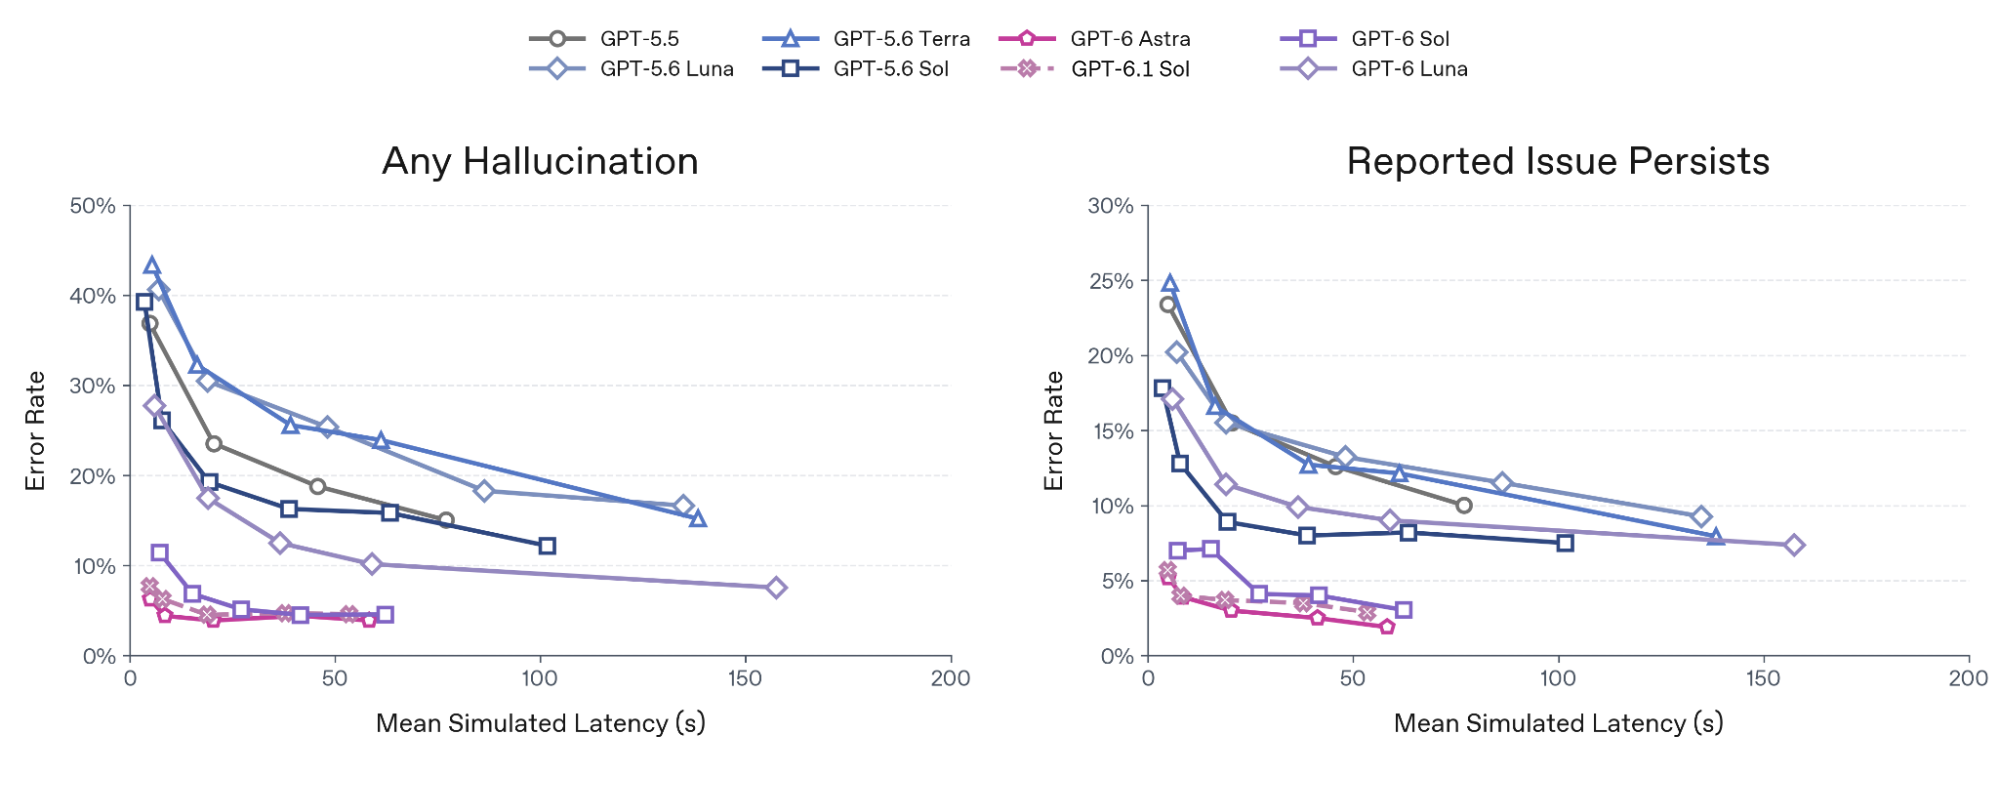
Bagan asli di atas diekstrak langsung dari PDF kartu sistem OpenAI tanpa digambar ulang. Bagan memplot evaluasi percakapan sulit yang dipilih terhadap latensi simulasi; dua panel mengukur halusinasi apa pun dan persistensi masalah yang dilaporkan. Bagan ini tidak boleh dibaca sebagai estimasi error di seluruh produksi.
| Model | Tingkat Kegagalan Pencarian Rusak — upaya maksimum |
|---|---|
| GPT-6.1 Sol | 2,1% |
| GPT-6 Sol | 4,9% |
| GPT-6 Astra | 1,5% |
| GPT-6 Luna | 28,7% |
GPT-6 Luna API di CometAPI adalah opsi berorientasi biaya lain, tetapi hasil pencarian rusak di sini menunjukkan mengapa agen harus diuji pada penanganan kegagalan selain eksekusi tool yang berhasil.
Ini adalah evaluasi yang sengaja adversarial, bukan tingkat kegagalan produksi yang representatif. Evaluasi ini berguna sebagai bukti bahwa GPT-6.1 Sol lebih baik dalam mengenali saat tool tidak tersedia atau rusak, alih-alih dengan yakin melanjutkan dengan klaim yang tidak didukung.
GPT-6.1 Sol vs. GPT-6 Sol: Haruskah Anda Meng-upgrade?
Untuk alur kerja kompleks baru, GPT-6.1 Sol adalah kandidat evaluasi yang kuat. Untuk deployment GPT-6 Sol yang stabil, upgrade hanya ketika kenaikan yang terukur membenarkan migrasi. Batas konteks yang sama dan harga token dasar membuat perbandingan adil menjadi mungkin, tetapi tolok ukur publik tidak dapat memutuskan apakah aplikasi Anda sendiri akan menjadi lebih cepat, lebih andal, atau lebih murah.
Kapan Upgrade Layak Diuji
Prioritaskan uji coba ketika coding skala repositori, otomasi bisnis multi-langkah, penggunaan komputer, atau analisis dokumen sulit menyumbang porsi substansial dari beban kerja Anda. Peningkatan yang dilaporkan pada bagian sebelumnya relevan untuk use case ini. Perlakukan sebagai alasan untuk menguji, bukan jaminan bahwa tingkat keberhasilan produksi Anda akan naik sebesar itu.
Aplikasi konteks berulang adalah kasus uji bermanfaat lainnya. Tarif pembacaan cache yang lebih rendah dapat mengurangi porsi tagihan input ketika permintaan benar-benar menggunakan ulang prefiks yang stabil. Jika sebagian besar pengeluaran berasal dari token yang dihasilkan, tool, atau percobaan yang gagal, diskon cache saja mungkin berdampak kecil. Bandingkan total biaya per hasil yang diterima, termasuk retry dan waktu review.
Kapan Tetap dengan GPT-6 Sol Masuk Akal
Pertahankan GPT-6 Sol ketika model tersebut sudah memenuhi target kualitas, latensi, dan anggaran Anda, dan model yang lebih baru tidak memberikan manfaat material dalam evaluasi yang representatif. Integrasi yang berfungsi juga bernilai: hindari mengganti rute yang stabil semata-mata karena nama model lebih baru.
Kompatibilitas bisa menentukan. GPT-6 Sol mendukung penalaran none; GPT-6.1 Sol dimulai dari low. Aplikasi yang menggunakan Sol Chat Completions function calls pada none harus memindahkan loop alatnya ke Responses untuk menggunakan 6.1 Sol. Audit juga parameter sampling dan parsing respons. Ini adalah perubahan migrasi, bukan sekadar ganti ID model. Lihat panduan migrasi OpenAI.
Cara Membuat Keputusan Upgrade
Buat set evaluasi tetap dengan tugas rutin, kasus sulit, dan kegagalan tool dari alur kerja yang dimaksud. Jaga definisi tugas, izin tool, dan kriteria penerimaan tetap konsisten. Bandingkan baseline Sol yang tervalidasi dengan konfigurasi 6.1 Sol yang valid; catat pengaturan penalaran secara eksplisit alih-alih berpura-pura bahwa none dan low itu ekuivalen.
- Kualitas: ukur penyelesaian yang diterima, koreksi faktual, pemanggilan tool tidak valid, dan upaya review manusia.
- Kecepatan: bandingkan latensi end-to-end p50/p95, termasuk retry dan waktu tunggu tool.
- Biaya: catat input tidak di-cache, pembacaan cache, penulisan cache, token output/penalaran, biaya tool, dan upaya rekayasa.
- Peluncuran: mulai dengan porsi trafik kecil, pertahankan fallback Sol, dan perbesar hanya ketika ambang yang ditentukan terpenuhi.
Rekomendasi praktis: pilih GPT-6.1 Sol ketika uji coba memberikan ekonomi tugas diterima yang lebih baik atau kenaikan kapabilitas yang dibutuhkan tanpa regresi yang tidak dapat diterima. Pertahankan GPT-6 Sol untuk rute di mana kompatibilitas dan hasil terbukti mengungguli manfaat terukur. Deployment campuran masuk akal ketika hanya sebagian kelas tugas yang membaik. Ini adalah rekomendasi berbasis beban kerja, bukan klaim bahwa salah satu model menang secara universal.
Bagaimana Cara Migrasi dari GPT-6 Sol ke GPT-6.1 Sol?
Pada tingkat paling sederhana, pengenal model berubah dari gpt-6-sol menjadi gpt-6.1-sol.
Permintaan Responses API dapat terlihat seperti ini:
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "medium"},
    input="Analisis repositori ini dan identifikasi penyebab kegagalan pengujian."
)

print(response.output_text)
Mengganti pengenal model hanyalah langkah pertama. GPT-6.1 Sol mendukung low, medium, high, xhigh, dan max, sementara GPT-6 Sol juga mendukung none. Hapus pengaturan none eksplisit dan pilih upaya yang diizinkan. Aplikasi yang menggunakan tool juga memerlukan Responses API: Chat Completions GPT-6.1 Sol tidak mendukung pemanggilan tool, sedangkan Chat Completions GPT-6 Sol mendukung function calling hanya dengan none. Kolom model resmi dalam tabel spesifikasi mendokumentasikan pembatasan endpoint ini.
Tim harus menguji ulang alur kerja sensitif terhadap latensi, pemanggilan tool, caching prompt, perilaku konteks panjang, dan logika apa pun yang secara eksplisit mengirim reasoning.effort="none".
Contoh ini menargetkan OpenAI langsung menggunakan OPENAI_API_KEY; ini bukan contoh endpoint CometAPI yang terverifikasi. Pertahankan rute GPT-6 Sol Anda selama rollout bertahap, catat keberhasilan tugas dan latensi p95, dan rollback jika kriteria penerimaan aplikasi Anda tidak terpenuhi.
Beban Kerja GPT-6.1 Sol Mana yang Paling Diuntungkan dari Upgrade?
| Beban kerja | Keunggulan GPT-6.1 Sol |
|---|---|
| Agen coding | Performa DeepSWE lebih tinggi |
| Debug skala repositori | Rekayasa perangkat lunak jangka panjang lebih baik |
| Agen peramban/komputer | +7 poin pada OSWorld 2.0 |
| Otomasi enterprise | Performa AutomationBench lebih tinggi |
| Agen konteks berulang | Input cache 50% lebih murah |
| Analisis PDF kompleks | Performa dokumen profesional mendekati Astra |
| Alur kerja sains | Lebih dari 2x skor GPT-6 Sol di evaluasi Terminal-Bench Science OpenAI |
| Alur kerja sensitif fakta | Tingkat error faktual pada prompt sulit lebih rendah |
| Agen padat tool | Perilaku lebih baik saat tool gagal |
GPT-6 Sol tetap berguna ketika integrasi yang ada sudah stabil atau ketika pengembang secara khusus membutuhkan pengaturan penalaran none. Untuk deployment baru yang berpusat pada agen, coding, penggunaan komputer, atau alur kerja konteks berulang, GPT-6.1 Sol mengubah persamaan biaya-performa tanpa mengubah harga token input/output normal.
Bagaimana CometAPI Dapat Membantu Upgrade dari GPT-6 Sol ke GPT-6.1 Sol?
Bagi pengembang yang sudah menggunakan GPT-6 Sol API di CometAPI, upgrade ke GPT-6.1 Sol dapat ditangani sebagai migrasi yang relatif kecil, bukan penulisan ulang integrasi penuh.
GPT-6.1 Sol kini tersedia melalui CometAPI dengan pengenal model gpt-6.1-sol. CometAPI saat ini menampilkan harga input konteks pendek awal sebesar $1,60 per juta token, dibandingkan tarif resmi $2,00 dari OpenAI, sementara harga output dimulai dari $8,00 per juta token. Ini menjaga model Sol yang lebih baru dalam struktur harga diskon yang sama seperti GPT-6 Sol, sambil memberi pengembang akses ke performa coding, agen, dan penggunaan komputer yang lebih kuat.
Karena CometAPI menyediakan antarmuka yang kompatibel dengan OpenAI, aplikasi GPT-6 Sol yang ada biasanya dapat mempertahankan struktur SDK dan alur permintaan yang sama sambil mengganti ID model menjadi gpt-6.1-sol. CometAPI juga menyediakan alat untuk membandingkan model, menguji prompt, memperkirakan biaya beban kerja, dan memeriksa perilaku migrasi sebelum rollout produksi.
Proses upgrade yang lebih aman adalah menjalankan prompt representatif yang sama terhadap GPT-6 Sol dan GPT-6.1 Sol terlebih dahulu, kemudian membandingkan kualitas output, latensi, perilaku tool, dan total biaya. Ini sangat penting untuk aplikasi yang bergantung pada pengaturan penalaran, output terstruktur, pemanggilan tool, atau agen yang berjalan lama, karena kompatibilitas model tidak menjamin perilaku identik pada setiap beban kerja.
Bagi tim yang menjalankan beban kerja konteks berulang atau padat agen, rute yang lebih baru juga dapat meningkatkan ekonomi. CometAPI saat ini mematok harga pembacaan cache konteks pendek GPT-6.1 Sol sebesar $0,08 per juta token, dibanding tarif resmi $0,10 dari OpenAI, sementara tarif input dan output konteks pendek tercantum 20% di bawah harga resmi.
Dalam praktiknya, CometAPI dapat membuat transisi GPT-6 Sol → GPT-6.1 Sol menjadi proses tiga langkah:
- Ganti
gpt-6-soldengangpt-6.1-sol. - Benchmark prompt produksi dan alur kerja agen yang sama sebelum mengalihkan trafik.
- Pindahkan beban kerja secara bertahap setelah kualitas output, perilaku tool, latensi, dan biaya memenuhi kebutuhan Anda.
Pendekatan ini memungkinkan pengembang mengadopsi GPT-6.1 Sol tanpa membangun ulang aplikasi di sekitar stack API baru, sambil tetap memvalidasi perbedaan perilaku yang diperkenalkan model yang lebih baru.
Kesimpulan
GPT-6 Sol tidak secara teknis usang. Model ini mempertahankan jendela konteks 1,05M, batas output 128K, output terstruktur, input gambar, dan harga Standar $2/$10. Opsi penalaran none juga dapat penting untuk integrasi yang ada. Keputusan upgrade harus bertumpu pada hasil tugas yang terukur dan kompatibilitas, bukan nomor versi semata.
Namun, dokumentasi GPT-6 Sol OpenAI kini mengarahkan pengembang ke GPT-6.1 Sol sebagai model Sol yang lebih baru.
Untuk sebagian besar beban kerja kompleks, pertanyaan kunci karenanya bukan apakah GPT-6.1 Sol memiliki jendela konteks lebih besar atau tarif token lebih tinggi—tidak. Pertanyaannya adalah apakah keberhasilan tugas yang lebih tinggi, pembacaan cache lebih murah, faktualitas yang lebih baik, dan perilaku agen yang lebih kuat membenarkan mengganti pengenal model dan menguji ulang beban kerja.
FAQ
Bagaimana cara migrasi dari GPT-6 Sol ke GPT-6.1 Sol dengan pemanggilan tool?
Tidak. Audit terlebih dahulu endpoint dan field permintaan, lalu pindahkan loop alat ke Responses API dan uji parsing pemanggilan tool, validasi argumen, retry, dan penanganan error. Jalankan canary pada tugas representatif sebelum menaikkan trafik; permintaan teks saja yang berhasil tidak memverifikasi loop alat yang berfungsi.
Apakah GPT-6.1 Sol lebih murah di beban kerja nyata?
Catat token input yang di-cache dan tidak di-cache, penulisan cache, token penalaran dan output, mode pemrosesan, dan biaya tool. Bandingkan biaya per tugas yang diterima alih-alih harga token cache semata. Prefiks yang stabil hanya membantu ketika permintaan benar-benar mengenai cache, dan loop tool yang lebih panjang atau percobaan gagal dapat meniadakan penghematan cache.
Bagaimana seharusnya Anda menguji GPT-6.1 Sol sebelum beralih dari GPT-6 Sol?
Gunakan set tugas mirip produksi yang tetap dan catat penyelesaian yang berhasil, koreksi faktual, pemanggilan tool tidak valid, latensi p50/p95, dan total biaya. Definisikan ambang yang dapat diterima sebelum pengujian. Pertahankan jalur rollback perutean model dan perluas trafik hanya setelah konfigurasi baru memenuhi ambang tersebut.
Bagaimana Anda menguji GPT-6.1 Sol dengan PDF?
Bangun korpus kecil dengan tabel padat, catatan kaki, grafik, dan halaman hasil pindai yang mewakili alur kerja yang dituju. Ajukan pertanyaan dengan jawaban yang dapat diverifikasi dan minta bukti halaman atau tabel. Nilai akurasi perhitungan, catatan yang hilang, dan jawaban yang tidak didukung secara terpisah; pertahankan review manusia untuk output yang kesalahannya berdampak material.