Bangun dengan CometAPIButuh satu API untuk banyak model?Uji alur kerja di Playground, lalu buat API key saat model dan biayanya sesuai dengan use case Anda.
TL;DR: GPT-6.1 Terra adalah titik awal yang lebih kuat ketika kualitas penalaran dan alur kerja visual yang kompleks paling penting; DeepSeek V4.1 Flash menarik ketika biaya token, kecepatan generasi, atau self-hosting menjadi prioritas. Perbandingan ini menggunakan pembaruan DeepSeek tanggal 17 Oktober, Flash-1017.
DeepSeek Flash-1017 memiliki harga token lebih rendah, namun biaya tugas yang selesai juga bergantung pada panjang penalaran, percobaan ulang, dan pemanggilan tool.
Perbandingan di bawah mencakup arsitektur, konteks, penalaran, pengodean, visi, kecepatan, harga, dan deployment. Harga dan halaman evaluasi langsung diperiksa pada 28 Oktober 2026.
Pokok-Pokok Utama
Terra memimpin perbandingan Intelligence Index independen yang dikutip, menjadikannya kandidat pertama yang logis untuk tugas penalaran yang menuntut.
DeepSeek memiliki harga token tercantum yang lebih rendah. Bandingkan latensi end-to-end dan biaya per tugas yang berhasil, termasuk tarif jam sibuk, penggunaan cache, token penalaran, dan percobaan ulang.
Ditinjau untuk kejelasan, atribusi sumber, dan terminologi API terkini.
Evaluasi pengodean berdasarkan patch yang diterima dan alur kerja visual berdasarkan tugas yang diselesaikan. Skor benchmark yang dipublikasikan memberikan bukti berguna, namun pengaturan pengujiannya berbeda.
Terra adalah model proprietary yang di-host. DeepSeek menawarkan bobot yang dapat diunduh berlisensi MIT untuk self-hosting, dengan persyaratan perangkat keras dan biaya operasi yang perlu dipertimbangkan.
CometAPI menyediakan antarmuka teks bersama untuk menguji kedua model. Periksa versi model yang digunakan dan dukungan untuk tools, kontrol penalaran, serta output terstruktur sebelum deployment.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: Tinjauan dan Spesifikasi
Perbedaan spesifikasi utama berkaitan dengan batas output, kontrol penalaran, pemanggilan tool, dan deployment. Tabel di bawah merangkum kedua model.
Arsitektur proprietari; jumlah parameter tidak diungkapkan
552B Causal Encoder–Decoder MoE; sekitar 8B parameter aktif untuk input dan 16B untuk output
Jendela konteks
1,050,000 token
1M token
Output maksimum
128,000 token
384K token
Modalitas input
Teks, gambar
Teks, gambar
Modalitas output
Teks
Teks
Kontrol penalaran
none, low, medium, high, xhigh, max
Thinking toggle; low, high, max in Chat Completions
Pemanggilan tool
Didukung melalui Responses API
Didukung; perilaku bergantung pada endpoint dan thinking mode
Bobot terbuka
Tidak
Ya, lisensi MIT
Arsitektur dan Versi Model
Terra menggunakan arsitektur proprietari dengan jumlah parameter yang tidak diungkapkan. DeepSeek-V4.1-Flash menggunakan arsitektur Causal Encoder–Decoder MoE, dengan anggaran parameter aktif berbeda untuk pemrosesan input dan generasi output.
Rilis V4.1 Flash DeepSeek menjelaskan backbone Causal Encoder–Decoder mixture-of-experts 552B parameter, dengan sekitar 8B parameter aktif saat memproses input dan 16B saat menghasilkan output. Pembaruan 17 Oktober meningkatkan hasil pengodean, agen, dan visi yang dipublikasikan.
Sepanjang artikel ini, Flash-1017 berarti checkpoint Oktober tersebut. Alias API generik dapat diarahkan ke versi lain kemudian, jadi catatan evaluasi harus mencakup versi model yang benar-benar digunakan.
KV Cache dan Persyaratan Deployment
DeepSeek melaporkan jejak global KV-cache sekitar 890 byte per token, sekitar seperempat dari DeepSeek-V4-Flash. Ini meningkatkan efisiensi cache, meskipun self-hosting tetap memerlukan sumber daya besar untuk bobot model. Terra tersedia melalui layanan hosted, sementara bobot yang dapat diunduh dari DeepSeek menyediakan opsi self-hosting tambahan.
Kontrol Penalaran dan Pemanggilan Tool
Kedua model mendukung alur kerja agen, tetapi kontrol penalaran dan persyaratan pemanggilan tool berbeda. Dukungan pemanggilan tool Terra yang didokumentasikan menggunakan Responses API. Model card DeepSeek menjelaskan upaya penalaran numerik dari 1 hingga 100; kontrol API hosted harus diperiksa secara terpisah. Saat berpindah model, sesuaikan parameter penalaran dan definisi tool dengan endpoint yang dipilih.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: Kinerja
Perbandingan di bawah mencakup penalaran, pengodean, visi, dan tugas konteks panjang. Evaluasi independen dan benchmark yang dilaporkan vendor diidentifikasi secara terpisah, dengan hasil diinterpretasikan bersama konfigurasi model dan kerangka kerja agen.
Penalaran dan Pengetahuan
Artificial Analysis melaporkan skor Intelligence Index v5.0 sebesar 51 untuk GPT-6.1 Terra (Max) dan 32 untuk DeepSeek Flash-1017 (Max) dalam konfigurasi yang dikutip, per 28 Oktober 2026. Indeks tersebut menggabungkan sembilan evaluasi.
Skor agregat lebih tinggi Terra mendukung pengujiannya terlebih dahulu untuk tugas penalaran yang menuntut. Untuk beban kerja yang lebih sempit, DeepSeek mungkin tetap menjadi pilihan lebih baik jika memenuhi akurasi yang diperlukan dengan biaya per tugas sukses yang lebih rendah.
Benchmark Resmi Pengodean dan Agen
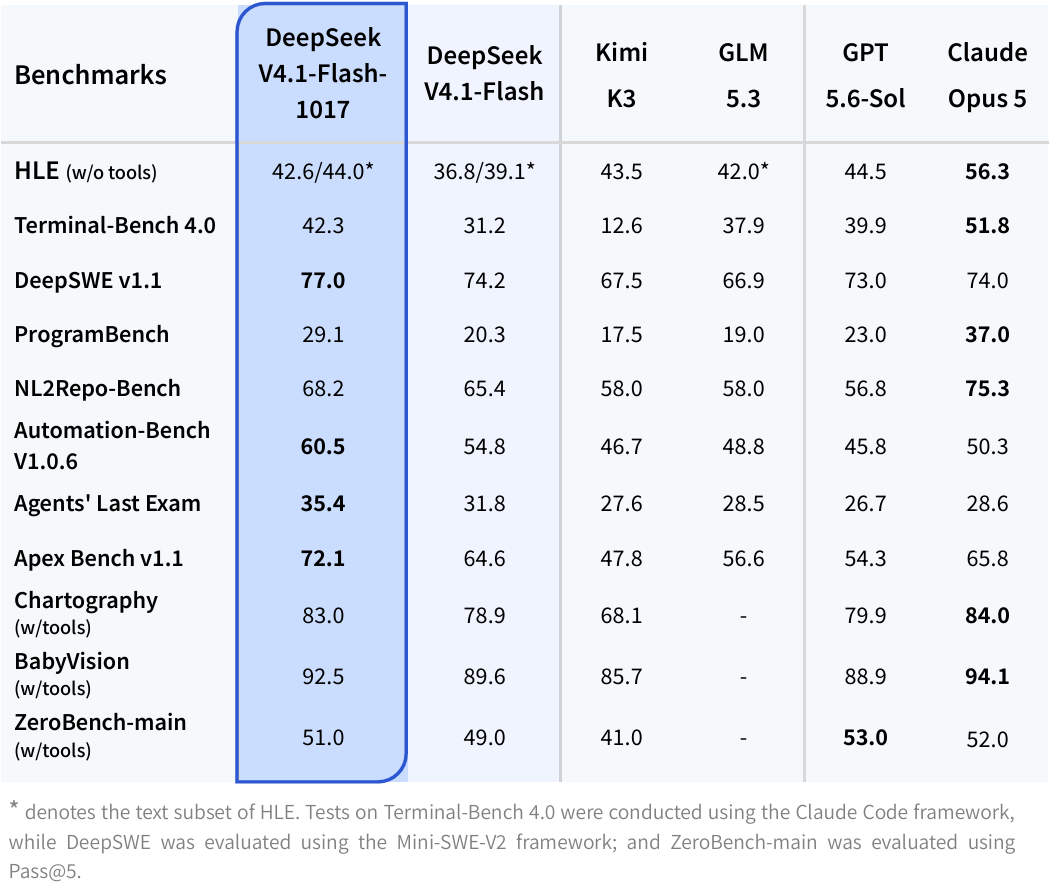
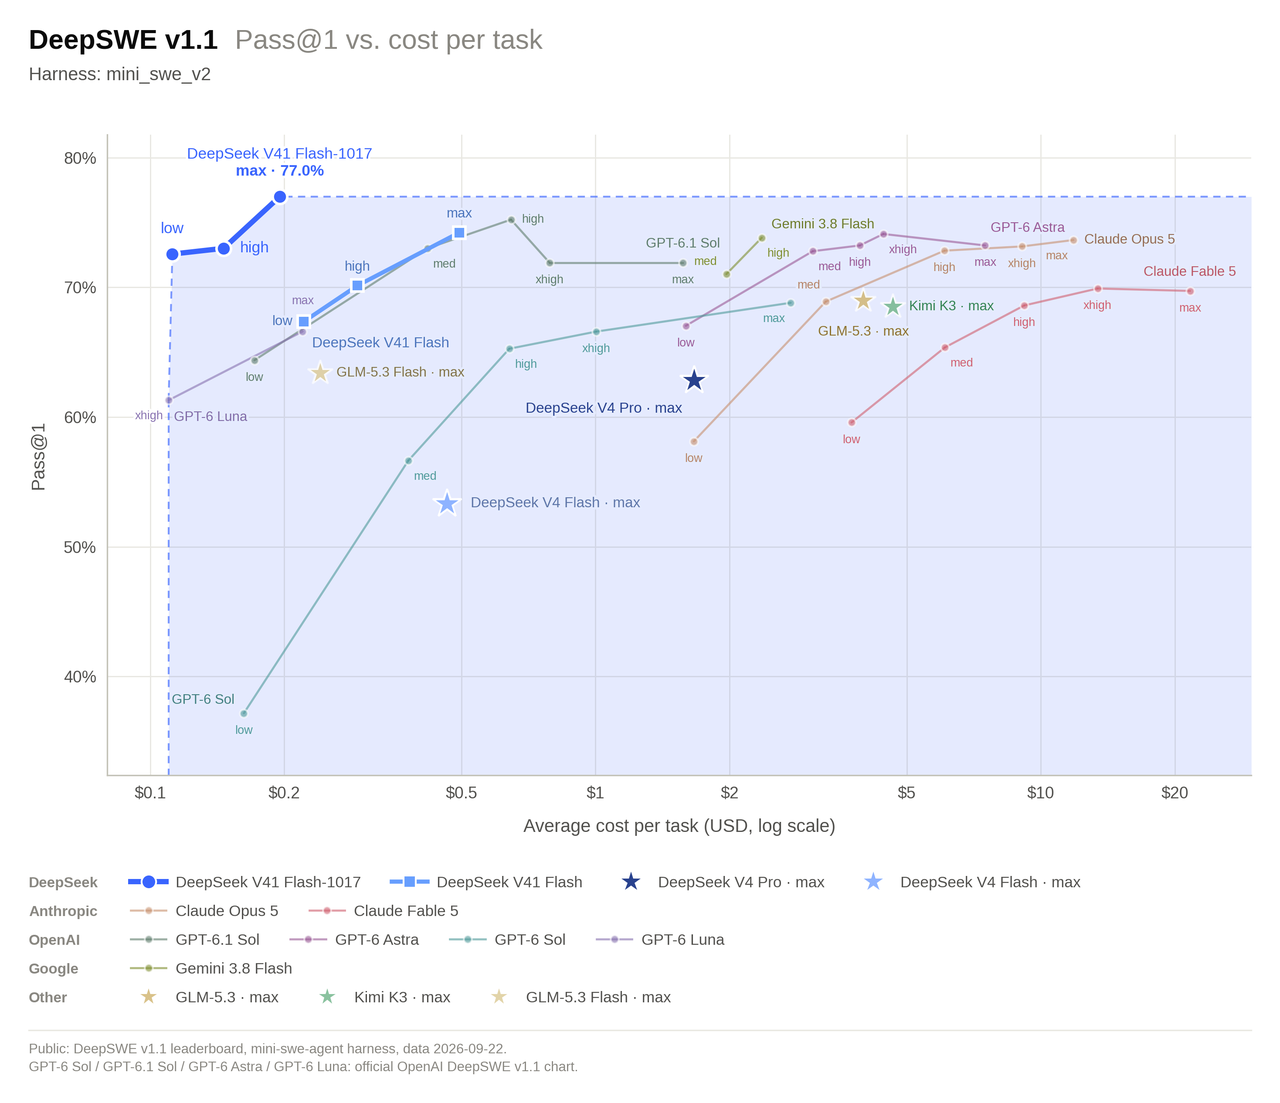
Terminal-Bench 4.0 dan DeepSWE v1.1 memberikan bukti tentang kinerja pengodean dan agen. Saat membandingkan hasil vendor, identifikasi versi model yang tepat, pengaturan penalaran, kerangka kerja agen, dan metrik penilaian; perbedaan pengaturan ini dapat memengaruhi skor secara material.
Untuk pekerjaan pengodean praktis, bandingkan apakah masing-masing model menghasilkan patch yang lolos pengujian yang ada, mempertahankan antarmuka publik, menangani kasus tepi, dan menghindari perubahan yang tidak terkait. Keandalan pemanggilan tool dan pemulihan dari kesalahan eksekusi juga memengaruhi seberapa banyak pekerjaan yang dapat diselesaikan agen.
Harga token tercantum yang lebih rendah pada DeepSeek menjadikannya kandidat berguna untuk pemeliharaan repositori berulang dengan kriteria penerimaan yang jelas. Untuk perubahan yang kompleks, bandingkan kedua model pada patch yang diterima, total biaya tugas, dan waktu koreksi manusia.
Visi dan Penggunaan Komputer
Kedua model menerima input gambar, namun pemahaman gambar dan interaksi desktop memerlukan kapabilitas yang berbeda. Materi peluncuran Terra dari OpenAI membahas MMMU-Pro dan OSWorld 2.1, sementara model card DeepSeek melaporkan tugas visual termasuk Chartography dan BabyVision, dengan pengaturan berbantuan tool.
Untuk ekstraksi dokumen, bandingkan akurasi field, teks yang terlewat, dan struktur tabel. Untuk otomatisasi desktop, bandingkan alur kerja yang diselesaikan, tindakan yang salah, dan pemulihan setelah perubahan antarmuka. Model yang menjelaskan tangkapan layar dengan akurat mungkin tetap kesulitan mengoperasikan aplikasi yang ditampilkan.
Pilih sesuai alur kerja: akurasi ekstraksi paling penting untuk pemrosesan dokumen, sementara tindakan yang andal dan pemulihan lebih penting bagi agen penggunaan komputer. Bandingkan biaya hanya setelah kedua model memenuhi ambang kualitas yang diperlukan.
Penalaran dan Retrieval Konteks Panjang
Kedua model mendukung alur kerja dokumen panjang, namun kapasitas konteks saja tidak menentukan kualitas retrieval. Bandingkan pada koleksi dokumen yang sama, menempatkan bukti penting di awal, tengah, dan akhir.
Evaluasi akurasi jawaban, kutipan pendukung, konsistensi lintas dokumen, dan kelengkapan respons. Untuk riset dan analisis dokumen, pilih model yang andal dalam mengambil dan menghubungkan bukti yang relevan dalam persyaratan latensi dan biaya Anda.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: Kecepatan
Throughput Output dan Waktu Penyelesaian Tugas
Latensi perlu dibahas terpisah dari kualitas penalaran.
Pada halaman Artificial Analysis tanggal 28 Oktober, kecepatan output Flash-1017 (Max) adalah 173,4 token per detik, sementara kecepatan output Terra (Max) adalah 90,9. Pengukuran tersebut menggambarkan konfigurasi yang dilayani evaluator, bukan laju yang dijamin pada setiap penyedia.
Model yang menghasilkan token lebih cepat mungkin tetap membutuhkan waktu lebih lama untuk selesai jika menghasilkan lebih banyak penalaran, menunggu tool, atau melakukan retry. Ukur waktu ke token pertama, total waktu penyelesaian, dan latensi tugas yang diterima secara terpisah.
Latensi Interaktif pada Rute API Anda
Untuk produk interaktif, uji prompt pendek dan panjang pada konkruensi realistis dan catat latensi median dan persentil ke-95. Pertahankan wilayah, rute API, cache prompt, pengaturan penalaran, dan kebijakan retry dalam hasil. Catatan tersebut akan memberi gambaran pengalaman pengguna yang lebih baik daripada satu angka token per detik.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: Biaya
Harga adalah salah satu perbedaan paling jelas antara kedua model ini.
Kartu tarif Terra dan kebijakan harga DeepSeek memberikan tarif pihak pertama berikut sebagaimana diperiksa pada 28 Oktober 2026. Semua harga adalah dolar AS per satu juta token.
Tarif API Resmi
Kategori token
GPT-6.1 Terra Standard
DeepSeek Flash off-peak
DeepSeek Flash peak
Input, cache miss
$1.00
$0.15
$0.30
Input, cache hit
$0.05
$0.003
$0.006
Output
$5.00
$0.60
$1.20
Harga puncak DeepSeek berlaku Senin–Jumat, 01:00–04:00 dan 06:00–10:00 UTC, tidak termasuk hari libur umum Tiongkok. Itu adalah 09:00–12:00 dan 14:00–18:00 dalam Waktu Standar Tiongkok (UTC+8). Periode lain menggunakan tarif off-peak.
Untuk permintaan Terra di atas 272,000 token input, OpenAI menentukan tarif input dan input tercache 2× serta tarif output 1,5× untuk seluruh permintaan. Bandingkan kondisi tersebut dengan ukuran prompt aktual Anda sebelum menganggap harga dasar sebagai harga efektif.
Tarif CometAPI
Tarif dasar CometAPI per 1M token
GPT-6.1 Terra API
DeepSeek V4.1 Flash API
Input tanpa cache
$0.80
$0.12
Output
$4.00
$0.48
Input tercache
Tidak ditentukan secara terpisah
$0.0024
Pengali berbasis waktu
Tidak ditentukan dalam harga dasar
2× selama jendela peak yang tercantum
CometAPI mencantumkan jendela peak DeepSeek sebagai Senin–Jumat, 01:00–04:00 dan 06:00–10:00 UTC. Jadwal yang tercantum tidak menetapkan pengecualian hari libur yang sama seperti kebijakan pihak pertama DeepSeek. Periksa ketentuan penagihan rute yang dipilih untuk waktu eksekusi yang Anda maksudkan.
Contoh Biaya Token Tetap
Pertimbangkan permintaan yang mengonsumsi 100,000 token input tanpa cache dan menghasilkan 10,000 token output.
Jika itu adalah total token yang ditagih secara lengkap, biaya token adalah $0.150 untuk Terra, $0.021 untuk DeepSeek off-peak, atau $0.042 untuk DeepSeek saat peak. Pengurangan off-peak adalah 86%. Contoh ini mengecualikan biaya tool tambahan, infrastruktur, dan retry; token penalaran yang dihitung terpisah juga harus masuk perhitungan.
Dengan tarif dasar CometAPI yang tercantum, 100,000 input dan 10,000 output yang sama berbiaya $0.120 untuk Terra atau $0.0168 untuk Flash. Menerapkan pengali peak 2× yang tercantum menghasilkan $0.0336 untuk Flash. Ini adalah perhitungan token saja menggunakan jumlah yang dinyatakan, bukan pengukuran tugas aktual.
Ketika Output Tambahan Menghapus Keunggulan Harga Token
Tahan input tanpa cache pada 100,000 token dan output Terra yang ditagih total pada 10,000 token. Tagihan token standar Terra menjadi $0.150. Flash mencapai tagihan yang sama pada 225,000 token output yang ditagih saat off-peak, atau 100,000 pada tarif peak. Aritmetika ini mengisolasi volume output; caching, input berulang, biaya tool, dan retry mengubah perbandingan.
Biaya per Tugas yang Berhasil
Evaluasi satu batch tugas tetap dan bagi semua pengeluaran API dan tool yang ditagih dengan jumlah tugas yang lulus pemeriksaan penerimaan Anda. Hitung juga pengeluaran untuk upaya yang gagal. Laporkan tingkat keberhasilan di samping biaya ini agar sebuah model tidak “diuntungkan” hanya karena menyelesaikan pekerjaan yang paling mudah.
Biaya per tugas yang berhasil = Total biaya API dan alat / Tugas yang berhasil diselesaikan
Mana yang Harus Anda Pilih: GPT-6.1 Terra atau DeepSeek-V4.1-Flash?
Pilih sesuai dengan persyaratan kualitas tugas, target biaya, dan kebutuhan deployment. Gunakan hasil benchmark di atas untuk memutuskan model mana yang diuji terlebih dahulu.
Kasus penggunaan
Kandidat awal
Yang seharusnya menentukan pilihan
Penalaran yang menuntut
GPT-6.1 Terra
Akurasi dan pekerjaan korektif pada tugas sulit yang representatif
Agen pengodean
Uji keduanya
Patch yang diterima, pemeriksaan regresi, kegagalan tool, dan total biaya
Alur kerja visual yang kompleks
GPT-6.1 Terra
Alur kerja yang diselesaikan dan pemulihan dari kesalahan antarmuka
Ekstraksi teks atau gambar volume tinggi
DeepSeek Flash-1017
Apakah akurasi ekstraksi memenuhi ambang yang diperlukan
Retrieval dokumen panjang
Uji keduanya
Retrieval bukti dan akurasi jawaban lintas posisi input
Hosting mandiri
DeepSeek Flash-1017
Perangkat keras yang tersedia, biaya operasi, dan kontrol atas bobot
Aplikasi interaktif
Uji keduanya
Latensi median dan ekor pada rute penyedia yang dipilih
Kapan Memilih GPT-6.1 Terra
Prioritaskan Terra untuk evaluasi saat penalaran kompleks menjadi pusat tugas. Untuk alur kerja visual atau penggunaan komputer yang menuntut, sertakan dalam set uji dan ukur tugas yang diselesaikan, kesalahan, dan pemulihan.
Pertanyaan kunci adalah apakah Terra mengurangi upaya gagal dan koreksi manual cukup untuk membenarkan harga token yang lebih tinggi.
Kapan Memilih DeepSeek-V4.1-Flash
Mulai dengan DeepSeek-V4.1-Flash untuk tugas berulang dengan volume tinggi, kriteria penerimaan yang jelas, dan target biaya ketat. Pilih jika output memenuhi persyaratan kualitas Anda dengan biaya per tugas berhasil yang lebih rendah.
Bobot berlisensi MIT dari DeepSeek juga menjadikannya opsi relevan ketika self-hosting diperlukan. Sertakan biaya perangkat keras dan operasi dalam keputusan tersebut.
Kapan Menguji Keduanya
Uji keduanya saat kualitas pengodean, keandalan tool, latensi, atau akurasi dokumen panjang bersifat kritis. Gunakan tugas representatif dengan input, tool, batas eksekusi, dan kriteria penerimaan yang sama.
Bandingkan tingkat penyelesaian yang berhasil, total biaya per tugas yang berhasil, latensi end-to-end, dan waktu koreksi manusia. Catat versi model dan pengaturan penalaran agar hasil dapat direproduksi.
Pengaturan hibrida dapat memulai tugas rutin dengan DeepSeek dan mengeskalasikan kegagalan tertentu ke Terra. Ukur biaya dan tingkat penyelesaian alur kerja penuh untuk memastikan panggilan model tambahan tersebut bermanfaat.
Di Mana Anda Bisa Mengakses GPT-6.1 Terra dan DeepSeek V4.1 Flash?
Gunakan API hosted OpenAI untuk Terra atau API hosted DeepSeek untuk Flash. Konfirmasikan pengenal model saat ini, batas akun, dan endpoint yang didukung sebelum integrasi. Bobot yang dapat diunduh Flash-1017 menyediakan opsi self-hosting terpisah.
Akses Melalui CometAPI
CometAPI menyediakan antarmuka yang kompatibel dengan OpenAI yang dapat menyederhanakan pengembangan aplikasi multi-model.
Untuk mencoba kedua model melalui satu klien teks, gunakan OpenAI Python SDK dengan kunci CometAPI Anda dan endpoint https://api.cometapi.com/v1. Simpan kunci di variabel lingkungan, lalu kirim prompt yang sama ke rute gpt-6.1-terra dan deepseek-v4.1-flash dan bandingkan jawaban yang dikembalikan serta penggunaan token.
Sebagai contoh, mintalah masing-masing model meninjau alur kerja pembayaran yang melakukan retry terhadap permintaan yang timeout tanpa idempotency key dan mencatat tubuh permintaan secara penuh. Bandingkan seberapa jelas jawaban mengidentifikasi risiko keandalan dan privasi serta menjelaskan perbaikan praktis. Prompt bersama membuat respons lebih mudah diperiksa, tetapi permintaan teks default tidak menyamakan anggaran penalaran atau menetapkan peringkat kinerja. Konfirmasikan checkpoint yang dilayani setiap rute sebelum menganggap hasil sebagai bukti tentang Flash-1017.
Kesimpulan
GPT-6.1 Terra menawarkan hasil penalaran agregat yang saat ini lebih kuat, sementara DeepSeek Flash-1017 menggabungkan harga token lebih rendah, kecepatan generasi output yang terukur lebih cepat, dan deployment dengan bobot terbuka. Pilihan yang berguna adalah model yang memenuhi persyaratan kualitas dan latensi Anda dengan total biaya terendah.
Mulailah dengan beban kerja representatif, pertahankan lingkungan tool dan kriteria penerimaan tetap konstan, dan bandingkan biaya penyelesaian yang berhasil. Integrasi teks bersama CometAPI dapat mempermudah evaluasi itu, sementara fitur spesifik model tetap memerlukan konfigurasinya sendiri.
FAQ
Mengapa tugas yang sama dapat menghasilkan tagihan token berbeda dengan Terra dan Flash-1017?
Sebuah prompt teks tidak harus menjadi jumlah token yang sama di dua model. Jawaban yang dihasilkan dan panjang penalaran juga bisa berbeda. Bandingkan penggunaan yang dilaporkan oleh setiap rute untuk tugas identik, termasuk token penalaran yang tercache dan yang ditagih jika dilaporkan, alih-alih menerapkan kedua daftar harga pada satu perkiraan jumlah token.
Bisakah GPT-6.1 Terra dan DeepSeek V4.1 Flash berbagi prompt cache?
Anda dapat menggunakan ulang teks prompt dalam aplikasi Anda, tetapi jangan berasumsi cache yang dibuat untuk satu model atau penyedia mengurangi tagihan yang lain. Kelayakan dan perhitungan cache bersifat spesifik rute. Periksa field penggunaan setiap respons dan uji permintaan berulang sebelum memasukkan penghematan ke dalam perkiraan.
Bagaimana saya harus memvalidasi output terstruktur dari Terra dan Flash-1017?
Definisikan field dan tipe yang diperlukan dalam aplikasi Anda sebelum memilih model. Jika suatu rute menawarkan output JSON atau terikat skema, verifikasi mode tepat yang didukung, lalu parsing respons dan validasi terhadap skema Anda. Perlakukan field yang hilang, nilai tidak valid, output terpotong, dan penolakan sebagai hasil terpisah. JSON yang valid saja tidak membuktikan bahwa fakta yang diekstrak benar.