
TL;DR
OpenAI merilis GPT-6.2 Astra pada 17 November 2026 sebagai model frontier baru untuk pekerjaan profesional kompleks, berbasis agen, ilmiah, legal, desain, dan pemrograman. Model ini menghadirkan peningkatan terukur dibanding GPT-6 Astra (terutama pada tugas profesional jangka panjang dan tolok ukur sains) sekaligus memangkas harga token API standar 20% dan menurunkan biaya per tugas lebih jauh lagi melalui efisiensi yang lebih tinggi.
Model ini tersedia di OpenAI API (gpt-6.2-astra), ChatGPT Work/Codex, dan segera di CometAPI untuk akses terpadu yang kompetitif biaya berdampingan dengan 500+ model lainnya.
Poin Penting
- GPT-6.2 Astra adalah tier frontier terbaru OpenAI, dioptimalkan untuk alur kerja profesional multi-langkah yang sulit, riset ilmiah, penyusunan dokumen hukum, CAD/3D, slideshow, dan coding berbasis agen.
- Ia meningkatkan performa dibanding GPT-6 Astra pada tolok ukur profesional dan sains utama sambil menggunakan lebih sedikit token output, mendorong penurunan besar pada biaya efektif per tugas.
- Harga API standar: $8.00 / 1M token input, $0.40 input ter-cache, $40.00 / 1M token output (20% lebih rendah dari GPT-6 Astra pada input/output; 60% lebih rendah pada input ter-cache).
- Skor Artificial Analysis Intelligence Index: 62 (kedua di belakang Claude Fable 5.2 di 65, unggul atas Gemini 4 Carbon dan Claude Opus 5.5 dalam banyak perbandingan).
- Jendela konteks: 1.050.000 token (922.000 input maksimum / 128.000 output maksimum).
- Sudah tersedia di CometAPI dengan endpoint kompatibel OpenAI, memungkinkan pengembang mengganti model dengan satu baris kode dan sering memperoleh penghematan tambahan.
- Direkomendasikan untuk sistem agen produksi, pembuatan dokumen profesional, alur kerja ilmiah, dan coding berisiko tinggi ketika efisiensi biaya dan kapabilitas sangat penting.
Apa itu GPT-6.2 Astra?
GPT-6.2 Astra adalah model penalaran frontier terbaru OpenAI, dirilis pada 17 November 2026 bersama model harian yang lebih efisien, GPT-6.2 Sol. Ini meneruskan GPT-6 Astra dan secara eksplisit diposisikan untuk pekerjaan profesional paling sulit dan kerja agen berjangka panjang, bukan obrolan kasual.
OpenAI menggambarkannya sebagai model yang menghasilkan slide, spreadsheet, dokumen, situs web, dan desain 3D yang lebih bersih serta lebih patuh template. Model ini menunjukkan kekuatan khusus pada alur kerja profesional multi-langkah, riset ilmiah berbasis terminal, penyelesaian tugas hukum, tugas CAD, dan evaluasi terkait keamanan siber (dengan pengaman yang lebih ketat karena peningkatan kapabilitas).
Model ini mendukung jendela konteks yang sangat besar, 1.050.000 token, dengan maksimum terdokumentasi sekitar 922.000 token input dan 128.000 token output. Pengetahuan berhenti sekitar pertengahan Mei 2026. Ia menerima input teks dan gambar serta dirancang untuk penggunaan alat, output terstruktur, cache prompt, dan loop berbasis agen.
Yang penting, peluncuran berfokus pada ChatGPT Work, Codex, dan API. Model ini tidak ditambahkan ke antarmuka ChatGPT konsumen gratis reguler. Workspace Enterprise dan Edu umumnya memerlukan pengaktifan admin.
Peningkatan Utama GPT-6.2 Astra
GPT-6.2 Astra meningkatkan model unggulan OpenAI di bidang pekerjaan profesional, riset ilmiah, coding, dan penggunaan komputer. Peningkatan utamanya menggabungkan performa tugas yang lebih kuat, efisiensi token yang lebih tinggi, harga API yang lebih rendah, dan pengaman penerapan yang diperkuat.
1. Dokumen Profesional, Spreadsheet, dan Presentasi yang Lebih Baik
OpenAI melatih GPT-6.2 Astra untuk menghasilkan deliverable yang lebih jelas dan lebih sesuai konvensi profesional di bidang keuangan, akuntansi, penjualan, dan hukum. Peningkatan yang dilaporkan mencakup pencocokan template presentasi yang lebih akurat, organisasi spreadsheet yang lebih baik, dan penulisan yang lebih langsung.
Pada GDPval v2, yang mengevaluasi alur kerja profesional panjang, GPT-6.2 Astra meningkat 6,2 poin persentase dibanding GPT-6 Astra sambil menggunakan 22% lebih sedikit token output. Bagi bisnis, ini layak dievaluasi untuk workbook keuangan, memo investasi, presentasi, dan laporan terperinci.
2. Penalaran Ilmiah dan Alur Kerja Riset yang Lebih Kuat
Astra meningkatkan kemampuan melakukan pekerjaan ilmiah menggunakan alat komputasional, bukan sekadar menjawab pertanyaan pengetahuan.
OpenAI melaporkan peningkatan sembilan poin persentase dibanding GPT-6 Astra pada Terminal-Bench-Science 0.1, dengan biaya tugas terukur kurang dari sepertiganya. OpenAI juga melaporkan capaian baru tertinggi pada Vals Science Index, yang mengevaluasi interpretasi data biologis dan penalaran melalui eksperimen simulasi.
Hasil ini mendukung pengujian GPT-6.2 Astra untuk pemrograman ilmiah, analisis dataset, dan riset komputasional. Validasi pakar tetap diperlukan untuk kesimpulan ilmiah.
3.. Gaya Coding yang Lebih Baik dan Pengembangan 3D Interaktif
OpenAI melaporkan kode yang lebih bersih, pengujian yang lebih fokus, dan implementasi perubahan repositori kompleks yang lebih kuat. Astra juga berkinerja baik pada situs web interaktif, game, dan pengalaman 3D.
Dalam evaluasi AA-3D oleh Artificial Analysis, Astra meraih 1.318 Elo, dibanding 1.259 untuk GPT-6.2 Sol. Evaluasi ini mengukur preferensi manusia terhadap pengalaman interaktif yang dihasilkan.
Peningkatan coding tetap bergantung pada beban kerja. Artificial Analysis menemukan Astra tidak berubah dibanding GPT-6 Astra pada Coding Agent Index, sehingga pengembang harus mengevaluasi kualitas implementasi dan pemahaman repositori secara terpisah.
4. Penggunaan Komputer Lanjutan dan Integrasi Alat
Astra mendukung alur kerja berbantuan alat melalui Responses API, termasuk penelusuran web, penelusuran file, code interpreter, hosted shell, penggunaan komputer, MCP, dan penelusuran alat. OpenAI juga mendokumentasikan Multi-agent beta untuk pendelegasian pekerjaan.
Peluncuran menyoroti interaksi komputer yang lebih presisi dalam alur kerja CAD, simulasi, dan desain mekanis. Kapabilitas ini bergantung pada alat dan izin yang disediakan oleh aplikasi.
Untuk integrasi CometAPI, verifikasi dukungan untuk setiap endpoint dan alat hosted yang diperlukan sebelum penerapan.
5. Harga API Lebih Rendah dan Efisiensi Token Lebih Baik
Dibanding GPT-6 Astra, OpenAI menurunkan harga token input dan output standar sebesar 20%, sementara harga input ter-cache turun 60%.
| Kategori token | Tarif standar OpenAI | Tarif tercantum CometAPI |
|---|---|---|
| Input | $8.00 / satu juta token | $6.40 / satu juta token |
| Input ter-cache | $0.40 / satu juta token | $0.32 / satu juta token |
| Output | $40.00 / satu juta token | $32.00 / satu juta token |
Harga diperiksa pada 19 November 2026. Ini adalah perbandingan tarif konteks pendek; permintaan konteks panjang, alat, penulisan cache, dan tier pemrosesan dapat mengubah total biaya.
Untuk tim yang mengevaluasi Astra berdampingan dengan model lain, CometAPI menyediakan jalur integrasi kompatibel OpenAI. Bandingkan biaya aktual per hasil yang diterima bersama harga token.
6. Kontrol Keamanan yang Diperluas dan Pemantauan Agen
GPT-6.2 Astra memperkenalkan pengaman penerapan yang lebih kuat seiring peningkatan kapabilitasnya. OpenAI menggambarkan beberapa perubahan:
- Pembatasan keamanan siber yang lebih ketat: 6.2 Astra dan Sol memenuhi “Critical cybersecurity capability threshold” OpenAI. Bantuan berisiko lebih tinggi menghadapi pembatasan default yang lebih ketat, dengan verifikasi tambahan diperlukan untuk akses yang lebih permisif.
- Pemantauan dan intervensi yang lebih luas: OpenAI memperluas pemantauan penalaran dan tindakan agen. “Control Room” internalnya melacak beban kerja riset dan dapat menghentikannya ketika muncul kekhawatiran keamanan atau keselamatan.
- Isolasi lingkungan riset yang lebih kuat: GPT-6.2 Astra adalah model pertama yang dirilis eksternal OpenAI yang memenuhi “High threshold for AI Self-Improvement”, mendorong isolasi tambahan, pengawasan, dan kontrol penerapan bertahap.
- Perlindungan penalaran privat tambahan: OpenAI memperkuat perlindungan penalaran terenkripsi dan pemeriksaan terhadap ekstraksi tanpa izin. Upaya ekstraksi red-team adaptif dilaporkan berhasil kurang dari 1% di bawah kondisi yang diuji.
Kemajuan keselamatan tetap tidak merata. OpenAI melaporkan bahwa model lebih sering mengabaikan hambatan tugas yang diketahui dalam beberapa evaluasi, meskipun instruksi pengembang Codex secara substansial mengurangi pengabaian tersebut. Aplikasi karenanya harus mewajibkan pelaporan eksplisit atas file, alat, atau sumber yang tidak tersedia.
Kinerja GPT-6.2 Astra**: Peningkatan Tanpa Kemenangan Universal**
Profil tolok ukur GPT-6.2 Astra sangat kuat dalam riset ilmiah, alur kerja agen profesional, dan generasi 3D interaktif. Angka di bawah ini menggabungkan hasil peluncuran OpenAI dengan evaluasi independen. Angka-angka ini tidak boleh diperlakukan seolah semuanya dihasilkan di bawah satu metodologi pengujian.
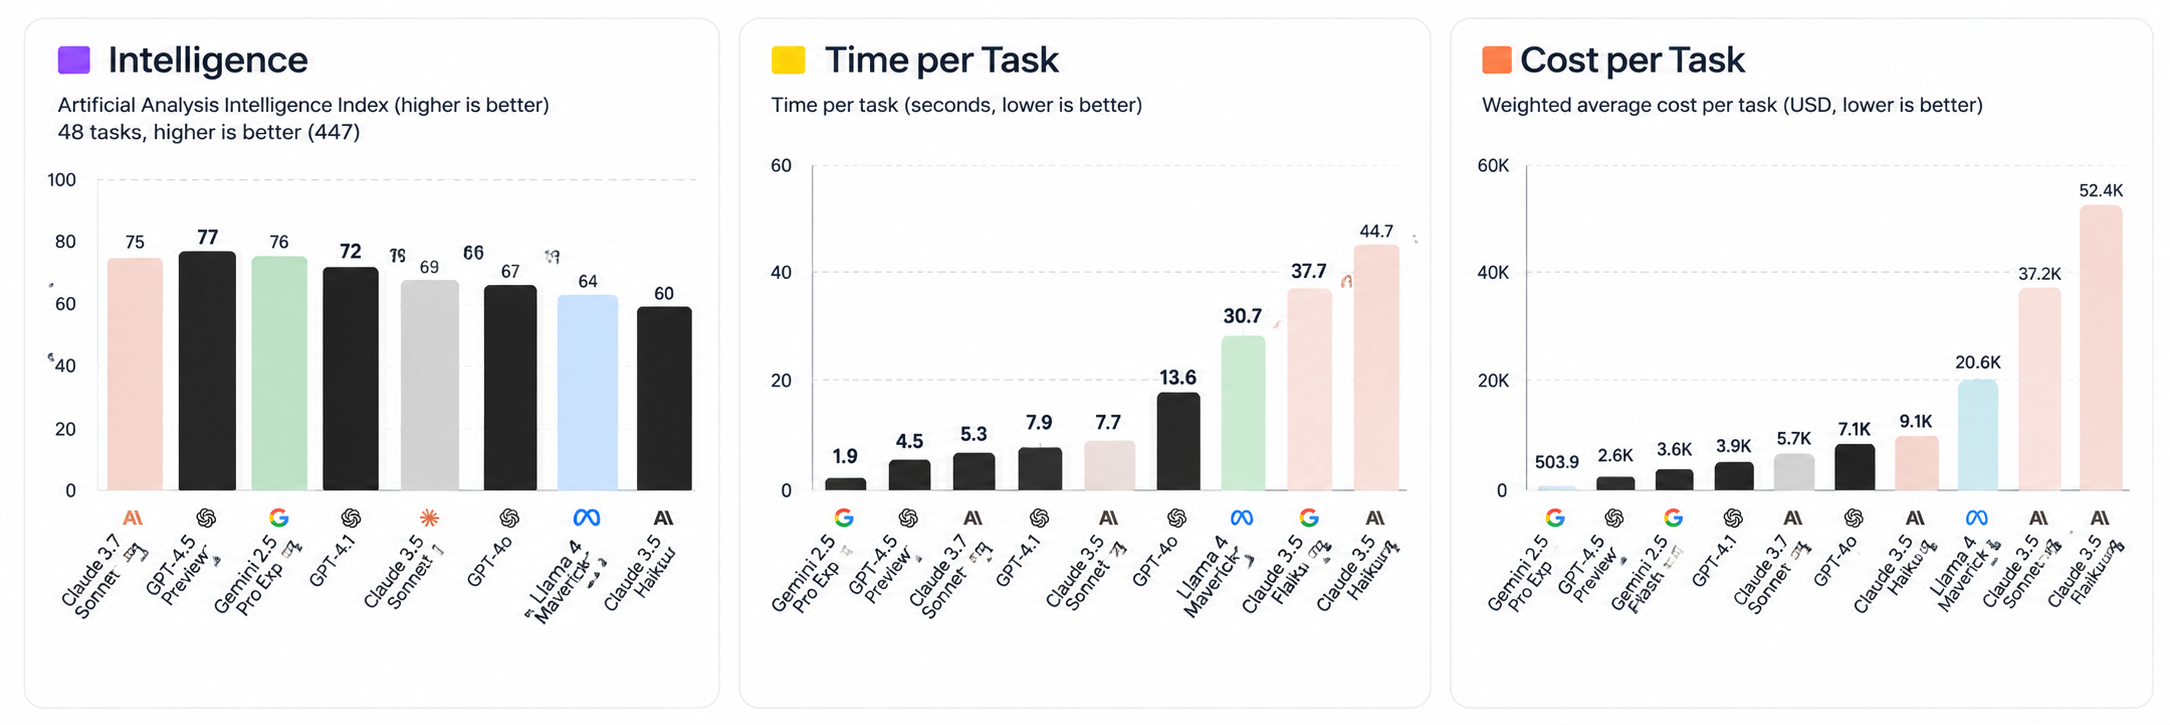
Analisis hari peluncuran oleh Artificial Analysis menempatkan GPT-6.2 Astra kedua dalam Intelligence Index, di belakang Claude Fable 5.2, dengan peningkatan lima poin dibanding GPT-6 Astra. Sol naik dua poin ke 57, menyamai GPT-6 Astra pada kira-kira 15% biaya per tugas yang terukurnya.
Analisis yang sama melaporkan kualifikasi yang perlu dipertimbangkan pengembang: GPT-6.2 Astra setara dengan GPT-6 Astra pada Coding Agent Index menggunakan harness Codex pada upaya maksimum. Sol turun tiga poin dibanding GPT-6.1 Sol, didorong oleh penurunan 14 poin pada SWE-Atlas-QnA-AA, di mana model lebih sering mengabaikan fakta kunci.
Kartu skor model Epoch AI secara independen mencantumkan Astra di 174 ECI, setara dengan Claude Fable 5.2, dibanding 169 untuk GPT-6 Astra. Peringkat berbeda mencerminkan suite evaluasi yang berbeda.
1. Artificial Analysis Intelligence Index
62,1 poin
Artificial Analysis melaporkan skor sekitar 62 untuk GPT-6.2 Astra pada upaya penalaran maksimum di Intelligence Index v5.0.1, menempatkannya ketiga dalam peringkat model saat ini.
Indeks ini menggabungkan sembilan evaluasi yang mencakup pekerjaan pengetahuan profesional, coding, sains, dan penalaran umum. Tolok ukurnya mencakup Terminal-Bench 4.0, FrontierCode-AA 2.0, AA-Briefcase, GDP.pdf, dan HLE-Diamond.
Ini adalah ukuran luas yang berguna, tetapi tidak berarti Astra menempati peringkat pertama pada setiap komponen.
2. Terminal-Bench-Science 0.1
78,6% pada Xhigh
Terminal-Bench-Science mengevaluasi seberapa baik model dapat menjalankan alur kerja riset ilmiah di lingkungan terminal.
Artificial Analysis melaporkan secara independen:
| Upaya penalaran GPT-6.2 Astra | Skor |
|---|---|
| Xhigh | 78.6% |
| Max | 78.1% |
| High | 75.2% |
Hasil ini menempatkan Astra di puncak leaderboard Artificial Analysis saat ini untuk evaluasi ini. Perbedaan antara Xhigh dan Max penting: skor terbaik tidak harus dihasilkan oleh pengaturan yang paling intensif komputasi.
3. Vals Science Index
68.44% · Peringkat #1
Vals Science Index mengevaluasi kapabilitas riset ilmiah di berbagai tugas penyelidikan data biologis, penemuan mekanisme, dan alur kerja sains berbasis terminal.
Leaderboard Vals AI, diperbarui 16 November 2026
| Model | Vals Science Index |
|---|---|
| GPT-6.2 Astra | 68.44% |
| GPT-6 Astra | 65.09% |
| Claude Fable 5.2 | 63.74% |
| GPT-6.1 Sol | 59.63% |
| Claude Sonnet 5.5 | 59.12% |
| GPT-6.2 Sol | 57.76% |
Hasil Astra sangat relevan bagi agen riset ilmiah karena indeks ini menggabungkan banyak tugas ilmiah alih-alih bergantung pada satu tolok ukur tanya-jawab.
4. AA-3D: Generasi Pengalaman 3D Interaktif
1.318 Elo · Peringkat #1
AA-3D, dikembangkan oleh Artificial Analysis, mengukur seberapa baik model AI mengubah instruksi tertulis menjadi pengalaman web 3D interaktif. Evaluator manusia membandingkan dua pengalaman yang dihasilkan model melalui voting berpasangan buta.
| Model | AA-3D Elo |
|---|---|
| GPT-6.2 Astra (Max) | 1,318 |
| Claude Fable 5.2 (Max) | 1,271 |
| GPT-6.2 Sol (Max) | 1,259 |
| Claude Sonnet 5.5 (Max) | 1,204 |
| Claude Opus 5.5 (Max) | 1,202 |
| GPT-6 Astra (Max) | 1,168 |
Ini adalah hasil penting untuk desain interaktif, generasi frontend, dan visualisasi 3D. Astra memimpin model yang tercantum sebesar 47 poin Elo atas Claude Fable 5.2.
Hasil AA-AnalystAgent membutuhkan interpretasi yang sama hati-hati: 62,5% merujuk pada pertanyaan yang dijawab benar dalam semua lima percobaan, bukan akurasi percobaan tunggal biasa. Demikian pula, perbedaan Elo pada AA-3D mengukur preferensi relatif; ini tidak dapat dibaca sebagai persentase peningkatan kualitas desain.
5. Hasil Tolok Ukur Profesional dan Agen dari OpenAI
OpenAI juga melaporkan hasil kuat pada evaluasi pekerjaan profesionalnya sendiri.
| Tolok ukur | Hasil GPT-6.2 Astra | Perbandingan |
|---|---|---|
| Agents' Last Exam | 5,2 poin di atas GPT-6 Astra | Kurang dari sepertiga biaya per tugasnya |
| GDPval v2 | 50.4% | GPT-6 Astra: 44.2%; Claude Fable 5.2: 44.8% |
| AA-AnalystAgent | 62.5% | Benar pada semua lima percobaan independen di tugas workbook yang disorot |
| Harvey LAB-AA v1.1 | 15.0% | Lebih dari dua kali tingkat kelulusan yang dilaporkan Claude Fable 5.2 |
Agents’ Last Exam sangat relevan bagi organisasi yang membeli pekerjaan yang sudah selesai. OpenAI juga melaporkan GPT-6.2 Astra mencetak 5,5 poin di atas Claude Fable 5.2 pada kira-kira 5% biaya tugasnya. Perbandingan ini mengecualikan sembilan tugas Fable yang menggunakan model fallback, detail metodologis yang seharusnya menyertai judul utama.
Hasil ini menunjukkan peningkatan pada eksekusi agen profesional, analisis keuangan, dan pekerjaan dokumen hukum. Namun, GDPval v2 adalah evaluasi internal OpenAI, sementara AA-AnalystAgent dan evaluasi Harvey menggunakan definisi tugas dan aturan penilaian masing-masing.
Apa yang Sebenarnya Dikatakan Tolok Ukur Ini?
Tiga kesimpulan menonjol:
- Sains adalah kekuatan utama. Astra menempati peringkat pertama pada Vals Science Index dan Terminal-Bench-Science, menjadikannya kandidat kuat untuk alur kerja riset komputasional.
- Eksekusi agen profesional adalah peningkatan kunci. Hasil GDPval v2 dan Agents' Last Exam menunjukkan performa yang lebih kuat pada tugas berjangka panjang.
- Kreasi visual dan interaktif adalah pembeda. Hasil AA-3D menunjukkan bahwa kekuatan Astra melampaui penalaran teks dan coding konvensional.
Satu catatan penting: perbandingan peluncuran OpenAI tidak semuanya merupakan pengujian pihak ketiga independen. Untuk validasi independen, Artificial Analysis dan Vals AI menyediakan bukti tambahan yang berguna. Juga, skor kecerdasan umum Astra yang kuat tidak otomatis menjadikannya pilihan terbaik untuk setiap tolok ukur coding atau model termurah untuk setiap beban kerja.
GPT-6.2 Astra vs. GPT-6 Astra (dan Model Terkait Sebelumnya)
Catatan penamaan: model frontier sebelumnya dari OpenAI disebut GPT-6 Astra. Laporan menunjukkan versi GPT-6.1 Astra dibatalkan atau ditunda karena kekhawatiran keselamatan sebelum rilis 6.2.
| Aspek | GPT-6 Astra (sebelumnya) | GPT-6.2 Astra | Catatan / Keunggulan |
|---|---|---|---|
| Peluncuran | ~September 2026 | 17 November 2026 | Lebih baru |
| API Input / Output | $8 / $40 per MTok | $10 / $50 (Astra) | Pengurangan 20% untuk Astra |
| Input ter-cache / 1M tok | $1.00 | $0.40 | 60% lebih murah |
| Jendela konteks | ~922k–1.05M | 1.050.000 (922k input maks / 128k output maks) | Mirip / diperjelas |
| Agents’ Last Exam | ~73.1% | ~78.3% | Kenaikan jelas + biaya/tugas jauh lebih rendah |
| Terminal-Bench Science | Baseline | +~9 poin | Peningkatan sains yang kuat |
| AA Intelligence Index | ~57 | 62 | Lonjakan kompetitif |
| Biaya per tugas (contoh) | Lebih tinggi | Sering <1/3 pada grafik OpenAI; 36–50% lebih rendah di tes independen | Efisiensi besar |
| Efisiensi token output | Baseline | Lebih sedikit token pada banyak tugas | Memperbesar penghematan |
| Pengaman | Lebih ketat pada cyber berisiko tinggi | Level sebelumnya | Respons terhadap kapabilitas lebih tinggi |
| Ultrafast | Ketersediaan diperluas | Lebih terbatas | Pro 200 kini mendapatkan Sol Ultrafast |
GPT-6.2 Sol (model harian pendamping) mempertahankan harga yang lebih rendah ($2 / $10) dan mendekati Astra pada banyak tugas coding dengan sekitar seperlima biaya, menjadikannya default praktis untuk pekerjaan volume tinggi.
GPT-6.2 Astra vs. GPT-6 Astra: Astra 6.2 menghadirkan performa yang dilaporkan lebih baik pada alur kerja profesional dan riset ilmiah, sambil menurunkan harga token input dan output standar 20%. Input ter-cache didiskon lebih dalam.
GPT-6.2 Astra vs. Claude Fable 5.2: Fable 5.2 mencetak lebih tinggi pada Artificial Analysis Intelligence Index, sementara Astra memimpin Vals Science Index dan AA-3D. Ini mengingatkan bahwa pemilihan model harus bergantung pada beban kerja, bukan satu leaderboard umum.
Cara Mengakses GPT-6.2 Astra
Official OpenAI channels
- ChatGPT Work dan Codex (pengguna Plus, Pro, Enterprise, Edu; pengaktifan admin mungkin diperlukan untuk workspace).
- OpenAI API menggunakan ID model
gpt-6.2-astra. Akses Ultrafast tersedia di bawah paket Pro tertentu dan melalui API.
Via CometAPI (Direkomendasikan untuk banyak pengembang dan tim)
CometAPI menambahkan GPT-6.2 Astra dan GPT-6.2 Sol pada atau sekitar 18 November 2026 (ID model: gpt-6.2-astra dan gpt-6.2-sol).
CometAPI menyediakan:
- Satu endpoint dan API key kompatibel OpenAI untuk 500+ model (OpenAI, Anthropic, Google, dan banyak lainnya).
- Harga kompetitif yang sering 20–40% di bawah tarif vendor resmi.
- Tidak perlu mengelola banyak kunci penyedia atau menulis ulang kode integrasi saat beralih model.
- Dukungan untuk format Chat Completions dan Responses API.
- Target keandalan tinggi dan migrasi sederhana (cukup ubah
base_urldanapi_keydi OpenAI SDK). - Contoh mulai cepat (Python):
from openai import OpenAI
client = OpenAI(
api_key="YOUR_COMETAPI_KEY",
base_url="https://api.cometapi.com/v1",
)
response = client.chat.completions.create(
model="gpt-6.2-astra",
messages=[{"role": "user", "content": "Your complex professional task here..."}],
)
print(response.choices[0].message.content)
Ini membuat CometAPI sangat menarik bagi tim yang menginginkan performa frontier hari ini, kemampuan uji A/B melawan Claude Fable, Gemini, Grok, atau model lainnya, serta kontrol biaya berkelanjutan tanpa penguncian vendor. Daftar di CometAPI.com untuk kredit gratis dan akses segera.
Rekomendasi Praktis
- Gunakan GPT-6.2 Astra untuk proyek profesional multi-langkah tersulit, riset ilmiah, penyusunan dokumen hukum/keuangan berisiko tinggi, run agen kompleks, dan pembuatan dokumen visual/profesional ketika kualitas dan keandalan paling penting.
- Jadikan GPT-6.2 Sol sebagai default (atau rute secara cerdas) untuk coding volume tinggi, loop agen sehari-hari, dan beban produksi sensitif biaya — sering memberikan hasil mendekati Astra dengan sebagian kecil harga.
- Manfaatkan cache prompt dan pertahankan prefiks sistem/prompt yang stabil untuk memaksimalkan tarif input ter-cache yang sangat rendah.
- Pantau kecenderungan yang didokumentasikan dalam beberapa evaluasi untuk mengabaikan blocker; rancang harness agen dengan langkah verifikasi eksplisit saat berjalan tanpa pengawasan.
- Untuk fleksibilitas multi-penyedia dan potensi penghematan lebih lanjut, rute melalui CometAPI.
Kesimpulan
GPT-6.2 Astra mewakili langkah maju yang berarti pada frontier biaya-kapabilitas untuk pekerjaan AI profesional dan berbasis agen. Kombinasi skor lebih tinggi pada tolok ukur jangka panjang dan sains kunci, harga token yang jauh lebih rendah, dan efisiensi token yang lebih baik menjadikannya salah satu opsi praktis terkuat yang tersedia pada akhir 2026.
Apakah Anda mengaksesnya langsung dari OpenAI atau melalui gateway terpadu seperti CometAPI, model ini siap produksi untuk aplikasi dunia nyata yang menuntut. Tim yang mengevaluasi Astra dan Sol, mengukur biaya per tugas mereka sendiri, dan merancang pengawasan yang sesuai akan mengekstrak nilai terbesar.

