
Ringkasan
GPT-6 Astra mencatat skor utama yang luar biasa. Kenaikan terbesar tampak ketika penalaran harus diubah menjadi tindakan: operasi terminal, penggunaan perangkat lunak, otomasi, pengambilan kembali konteks panjang, alur kerja ilmiah, dan keamanan siber. Pada uji akademik yang sudah mendekati saturasi, peningkatannya atas generasi OpenAI sebelumnya sering jauh lebih kecil.
Model ini menggabungkan jendela konteks 1,050,000 token dengan dukungan alat yang luas. Benchmark eksekusi yang dipublikasikan OpenAI menunjukkan bahwa peningkatan praktis paling kuat pada pekerjaan berjangka panjang, namun desain harness, tingkat usaha penalaran, latensi, dan akses alat secara material memengaruhi hasil.
Pokok-Pokok Utama
- Peningkatan paling jelas Astra ada pada eksekusi bersifat agen, bukan pada semua bentuk tanya-jawab.
- Hasil Terminal-Bench, AutomationBench, penggunaan komputer, dan migrasi basis data menunjukkan pergerakan yang jauh lebih besar dibandingkan GPQA atau DeepSWE.
- Hasil ARC-AGI-3 menunjukkan bahwa keadaan model, manajemen konteks, dan harness evaluasi dapat mendominasi skor akhir.
- Jendela konteks besar hanya penting bila informasi tetap dapat diambil kembali dekat batasnya; MRCR lebih informatif daripada kapasitas yang diiklankan semata.
- Harga token yang lebih tinggi tidak otomatis berarti biaya tugas lebih tinggi jika model membutuhkan lebih sedikit token, giliran, percobaan ulang, atau koreksi manusia.
- Keputusan produksi sebaiknya membandingkan tingkat keberhasilan, waktu berlalu, total biaya, keandalan alat, dan beban koreksi secara bersama-sama.
Sekilas tentang GPT-6 Astra
OpenAI menetapkan hingga 128,000 token output, input teks dan gambar, output teks, serta tingkat usaha penalaran dari rendah hingga maksimum. Spesifikasi ini memungkinkan alur kerja besar dan multilangkah, tetapi tidak membuktikan bahwa model akan mengambil bukti yang tepat atau menyelesaikan tugas secara andal.
| Spesifikasi resmi | GPT-6 Astra di CometAPI | Signifikansi praktis |
|---|---|---|
| Model ID | gpt-6-astra | Pengenal stabil untuk perutean API |
| Jendela konteks | 1,050,000 token | Mendukung repositori besar, arsip, dan riwayat agen |
| Output maksimum | 128,000 token | Memungkinkan laporan besar, patch, dan artefak terstruktur |
| Batas pengetahuan | 30 April 2026 | Fakta yang lebih baru membutuhkan alat atau sumber yang diberikan |
| Input | Teks dan gambar | Mendukung dokumen, tangkapan layar, diagram, dan bukti campuran |
| Output | Teks | Menghasilkan prosa, kode, dan teks terstruktur |
| Usaha penalaran | low, medium, high, xhigh, max | Menukar latensi dan biaya untuk pencarian lebih dalam |
| Kapabilitas agen | Function calling, structured outputs, penggunaan komputer, pencarian web/berkas, hosted shell, Apply Patch, MCP | Memungkinkan alur kerja ujung-ke-ujung alih-alih jawaban terisolasi |
| OpenAI Standard input | $10 per juta token | Ukuran input dan penggunaan cache memengaruhi total biaya |
| OpenAI cached input | $1 per juta token | Berlaku saat awalan prompt digunakan kembali dari cache |
| OpenAI cache writes | $12.50 per juta token | Ditagih 1,25× dari tarif input tanpa cache |
| OpenAI Standard output | $50 per juta token | Output yang verbose dapat mendominasi biaya tugas |
| Permintaan di atas 272K token input | Tarif input dan cache ×2; tarif output ×1.5 | Tarif lebih tinggi berlaku untuk seluruh permintaan |
Batas konteks mengukur kapasitas, bukan ingatan yang dapat digunakan. Daftar alat mengukur ketersediaan, bukan eksekusi yang berhasil. Benchmark diperlukan untuk menguji apakah spesifikasi tersebut berlanjut menjadi pekerjaan yang terselesaikan.
Apa yang Ditunjukkan Hasil Benchmark GPT-6 Astra?
Portofolio menunjukkan pola yang tidak merata. Astra nyaris tidak melampaui Sol pada sebagian uji akademik dan penalaran perangkat lunak, namun menghasilkan kenaikan dua digit pada pekerjaan terminal, otomasi, migrasi basis data, interaksi visual, pengambilan kembali konteks panjang, dan matematika lanjutan.
| Benchmark yang dipublikasikan | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Astra vs. Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 57.9% | 37.3% | 55.8% | +20.6 pp |
| DeepSWE v1.1 | 74.1% | 72.7% | 67.4% | +1.4 pp |
| Database Migration Tasks | 63.9% | 42.7% | 57.8% | +21.2 pp |
| OSWorld 2.0 | 72.6% | 65.7% | — | +6.9 pp |
| ScreenSpot-Pro | 92.7% | 76.9% | — | +15.8 pp |
| AutomationBench | 41.4% | 18.1% | 31.4% | +23.3 pp |
| BenchCAD | 95.9% | 83.3% | 84.3% | +12.6 pp |
| FrontierMath Tier 4 v2 | 97.6% | 83.0% | 87.8% | +14.6 pp |
| GPQA Diamond | 96.0% | 94.6% | 93.7% | +1.4 pp |
| MRCR v2, 512K–1M | 96.3% | 73.8% | — | +22.5 pp |
| AA Intelligence Index v4.1.1 | 61.2 | 60.9 | 65.7 | +0.3 |
| ARC-AGI-3, Provider Adapter | 99.9% | 7.8% | — | +92.1 pp |
Tiga klaster muncul. Pertama, selisih 1,4 poin pada DeepSWE dan GPQA menunjukkan pergerakan tambahan yang terbatas pada tugas di mana model kuat sudah tampil baik. Kedua, kenaikan di atas 20 poin pada Terminal-Bench, AutomationBench, migrasi basis data, dan pengambilan kembali sejuta token menunjukkan perubahan eksekusi yang jauh lebih besar. Ketiga, ARC-AGI-3 adalah outlier yang interpretasinya bergantung pada harness.
Hasil Pengujian Independen
Artificial Analysis melaporkan Astra dan Sol sekitar 61 pada Intelligence Index, sambil menunjukkan kenaikan yang jauh lebih jelas pada Coding Agent Index. Ini secara independen menguatkan pola dalam data OpenAI: peningkatan terbesar terkonsentrasi pada eksekusi agenik.
Pada usaha maksimum dalam harness Codex, Astra dilaporkan menggunakan sekitar sepertiga jumlah token dibanding Sol pada Coding Agent Index. Penggunaan token Intelligence Index Astra hanya turun sekitar 10%. Karena tarif per token Astra lebih tinggi, dua profil efisiensi ini menciptakan ekonomi yang berbeda.
| Evaluasi independen | Hasil yang diamati | Interpretasi produksi |
|---|---|---|
| Intelligence Index | Sedikit pemisahan dari Sol | Penalaran luas mungkin tidak membenarkan premi harga besar |
| Coding Agent Index | Peningkatan agenik yang jelas | Token yang lebih sedikit dapat menutup tarif token yang lebih tinggi |
| AA-Omniscience | Laju halusinasi turun dari 92% ke 51% pada usaha maksimum | Abstain yang lebih baik dapat penting untuk sistem riset dan retrieval |
| Pekerjaan pengetahuan berjangka panjang | Kemajuan campuran di berbagai tugas | Evaluasi lokal tetap diperlukan |
Tidak ada benchmark independen yang mengesahkan faktualitas atau keselamatan produksi. Tim harus secara terpisah menilai jawaban benar, ketidakpastian yang dibenarkan, klaim tanpa dukungan, dan kegagalan mengikuti batasan sumber.
Mengapa Astra Lebih Cocok untuk Pekerjaan Agenik Jangka Panjang?
GPT-6 Astra menambahkan tiga kontrol yang dirancang untuk pekerjaan yang berubah saat dijalankan. Keandalan jangka panjang juga bergantung pada seluruh sistem konteks: jendela konteks menetapkan kapasitas; pemadatan mengendalikan bagaimana materi lama diringkas; penalaran yang dipertahankan membawa keadaan model yang relevan; pengambilan kembali menjaga bukti sebelumnya tetap dapat dicari; dan aplikasi harus memelihara keluaran alat penting, hasil uji, pendekatan yang gagal, serta kebutuhan pengguna. Mekanisme ini sebaiknya diuji bersama harness agen.
- Pemanggilan alat asinkron: Astra dapat melanjutkan penalaran independen atau memanggil alat lain saat aplikasi menjalankan alat berdurasi lama.
- Steering di tengah giliran: aplikasi dapat mengirim koreksi atau persyaratan baru melalui WebSocket tanpa membuang pekerjaan yang sudah selesai.
- Penyesuaian penalaran di tengah percakapan: pembaruan konfigurasi dapat menaikkan atau menurunkan usaha penalaran sambil mempertahankan awalan prompt yang di-cache.
Di Mana GPT-6 Astra Sebenarnya Meningkat
Pengodean Agenik: Pekerjaan Terminal Merupakan Peningkatan yang Lebih Besar
Terminal-Bench 4.0 mengevaluasi apakah agen dapat menuntaskan tugas terminal yang sulit alih-alih sekadar menghasilkan jawaban kode terisolasi. Astra mencapai 57.9%, naik 20.6 poin persentase di atas Sol dan 2.1 poin di atas Fable. Itu merupakan peningkatan antargenerasi yang substansial bagi OpenAI, tetapi keunggulan yang lebih sempit dibanding sistem agenik frontier lainnya.
DeepSWE menceritakan kisah berbeda: 74.1% untuk Astra dan 72.7% untuk Sol. Selisih 1,4 poin mengingatkan untuk tidak menggeneralisasi dari satu benchmark pengodean. Astra tampak memperoleh paling banyak ketika pengodean memerlukan interaksi lingkungan, iterasi, pelestarian state, dan verifikasi.
Database Migration Tasks memperkuat interpretasi tersebut. Hasil 63.9% berada 21.2 poin di atas Sol dan 6.1 poin di atas Fable. Pekerjaan migrasi menggabungkan pemahaman kode, penggunaan alat, pengurutan, dan penilaian operasional—jenis alur kerja gabungan di mana peningkatan penalaran kecil dapat terakumulasi menjadi kenaikan penyelesaian yang jauh lebih besar.
Untuk agen pengodean, evaluasi model dan harness bersama-sama. Instruksi repositori, alat terminal, perilaku retry, pelestarian konteks, dan eksekusi uji semuanya berkontribusi pada hasil yang diukur.
Penggunaan Komputer: Tingkat Keberhasilan dan Waktu Jalan Keduanya Penting
Pada Agents’ Last Exam, GPT-6 Astra mencetak 59.3%, dibandingkan 53.6% untuk GPT-5.6 Sol: kenaikan 5.7 poin persentase. Ini menambahkan hasil tugas agen yang lebih luas ke skor OSWorld 2.0 dan ScreenSpot-Pro dalam ringkasan benchmark di atas.
Di luar akurasi, perbandingan runtime OSWorld menambahkan dimensi praktis lain: OpenAI melaporkan sekitar 40 menit per tugas untuk Astra versus sekitar 75 menit untuk Sol, atau sekitar 47% lebih sedikit waktu berlalu sambil juga meningkatkan keberhasilan tugas.
Agen yang sedikit lebih sering berhasil dan jauh lebih cepat selesai dapat memberikan peningkatan throughput yang besar. Oleh karena itu, uji pengadaan perlu melaporkan tingkat keberhasilan, waktu berlalu, panggilan alat, percobaan ulang, dan intervensi manusia—bukan akurasi saja.
Otomasi dan Pekerjaan Profesional
AutomationBench naik dari 18.1% ke 41.4%, kenaikan 23.3 poin. Skor absolutnya masih jauh dari sempurna, tetapi perubahan profil kegagalan lebih bermakna daripada pergerakan satu poin dekat saturasi. Pada BenchCAD, Astra mencapai 95.9%, unggul 12.6 poin atas Sol dan 11.6 poin atas Fable.
Hasil ini mendukung klaim spesifik: Astra lebih baik dalam mengonversi instruksi menjadi rangkaian tindakan tervalidasi. Mereka tidak membuktikan kenaikan yang sama untuk setiap alur kerja bisnis. Proses produksi dapat memperkenalkan langkah autentikasi, antarmuka proprietari, kebijakan yang ambigu, atau format data yang tidak ada dalam benchmark.
Sains
Sains adalah salah satu kenaikan kemampuan paling jelas Astra. Pada FrontierMath Tier 4 v2, Astra mencapai 97.6%, dibandingkan 83.0% untuk Sol dan 87.8% untuk Fable. Keunggulan 14.6 poin atas Sol signifikan, meski benchmark mencakup distribusi tugas terpilih alih-alih seluruh alur kerja ilmiah.
Keamanan Siber
Keamanan siber adalah kenaikan besar kedua, dengan taruhannya lebih tinggi daripada pergerakan leaderboard biasa. Pada ExploitBench yang mencakup Juni hingga Agustus 2026, Astra mencetak 39.0% versus 5.5% Sol. OpenAI melaporkan bahwa set yang lebih baru ini menargetkan kerentanan dari tiga bulan sebelumnya untuk mengurangi paparan historis. Dalam evaluasi keamanan siber OpenAI, Astra menunjukkan kemampuan menemukan dan mengeksploitasi dua kerentanan zero-day yang sebelumnya tidak diketahui selama pengujian terkontrol. Hasil ini penting karena evaluasi dirancang di sekitar kerentanan yang baru diungkapkan alih-alih masalah keamanan yang telah lama diketahui, mengurangi kemungkinan bahwa performa benchmark semata disebabkan oleh contoh yang dihafal. Hasil tersebut berkontribusi pada Astra mencapai ambang kapabilitas keamanan siber Kritis OpenAI dan karenanya mengubah pengaman yang diperlukan untuk penerapan. Signifikansinya bukan bahwa Astra dapat melakukan operasi siber tanpa batas secara otonom, melainkan bahwa tingkat kapabilitasnya mengubah persyaratan pengaman penerapan. Sistem dengan kemampuan penemuan dan eksploitasi kerentanan yang lebih kuat memerlukan kontrol akses yang lebih ketat, pemantauan, sandboxing, dan mekanisme tinjauan manusia.
Tugas Jangka Panjang: Jendela Konteks Bukan Seluruh Cerita
Jendela konteks 1,050,000 token Astra menggambarkan kapasitas, bukan kontinuitas. Kinerja jangka panjang juga bergantung pada pemadatan, state yang dipertahankan, konteks awal yang dapat dicari, penalaran yang disimpan, dan pelestarian keluaran alat. Dalam MRCR v2, Astra mencetak 100.0% pada 256K–512K dan 96.3% pada 512K–1M, sementara Sol mencatat 91.5% dan 73.8%. Kesenjangan 22.5 poin pada rentang terpanjang menunjukkan bahwa pengambilan kembali yang dapat digunakan dekat batas lebih penting daripada kapasitas yang diiklankan semata.
MRCR tetap uji retrieval sintetis, jadi evaluasi produksi harus memelihara bukti yang sering hilang saat diringkas: mengapa perbaikan sebelumnya gagal, perilaku komponen tertentu, hasil uji, persyaratan historis, dan detail yang terkubur dalam keluaran alat. Repositori dan arsip riset juga sebaiknya diuji dengan nama duplikat, referensi silang, kebijakan usang, sumber yang kontradiktif, dan rentang distraktor panjang. Ini memisahkan kapasitas konteks mentah dari perilaku pelestarian konteks dan pengambilan kembali yang benar-benar dibutuhkan agen berjangka panjang.
Pelestarian konteks: mengapa Astra berbeda dari sistem konteks panjang tradisional
Alur konteks panjang tradisional biasanya mengikuti pola:
context → compaction → summary → continue
Pendekatan ini mengurangi penggunaan token, tetapi memperkenalkan risiko kritis: informasi perantara penting dapat hilang saat diringkas.
Informasi yang hilang sering bukan jawaban akhir itu sendiri, melainkan detail operasional yang diperlukan untuk keputusan di masa depan:
- mengapa perbaikan sebelumnya gagal;
- komponen mana yang menunjukkan perilaku abnormal;
- hasil uji mana yang mengubah arah implementasi;
- persyaratan pengguna mana yang ditambahkan kemudian;
- keluaran alat mana yang memuat bukti penting.
GPT-6 Astra mengatasi keterbatasan ini dengan menggabungkan mekanisme pelestarian konteks dan pengambilan kembali di dalam alur kerja agen yang berjalan lama.
Alih-alih hanya mengandalkan ringkasan terkompresi, sistem dapat memelihara catatan penting, mengambil informasi sebelumnya saat diperlukan, dan menjaga kontinuitas antara banyak interaksi alat.
Untuk agen pengodean seperti Codex, ini berarti tugas debugging panjang dapat mempertahankan:
- eksperimen gagal sebelumnya;
- perubahan repositori;
- keluaran uji;
- keputusan arsitektur;
- isu yang belum terselesaikan.
Oleh karena itu, nilai jendela konteks 1M token Astra bukan hanya jumlah informasi yang dapat diterima, tetapi apakah sistem dapat melestarikan dan memulihkan informasi yang tepat setelah berjam-jam interaksi.
Penalaran dan Interpretasi
ARC-AGI-3: Harness Adalah Bagian dari Hasil
ARC-AGI-3 memberikan demonstrasi paling jelas bahwa benchmark frontier dapat mengukur sistem alih-alih model terisolasi. ARC Prize melaporkan 62.7% dengan harness Standard pada usaha maksimum dan 99.9% dengan Provider Adapter pada usaha tinggi.
| Evaluasi ARC Prize | Harness Standard | Provider Adapter | Kenaikan Adapter |
|---|---|---|---|
| max | 62.7% | 98.6% | +35.9 pp |
| xhigh | 59.3% | 98.4% | +39.1 pp |
| high | 54.8% | 99.9% | +45.1 pp |
| medium | 38.6% | 98.4% | +59.8 pp |
| low | 17.5% | 98.0% | +80.5 pp |
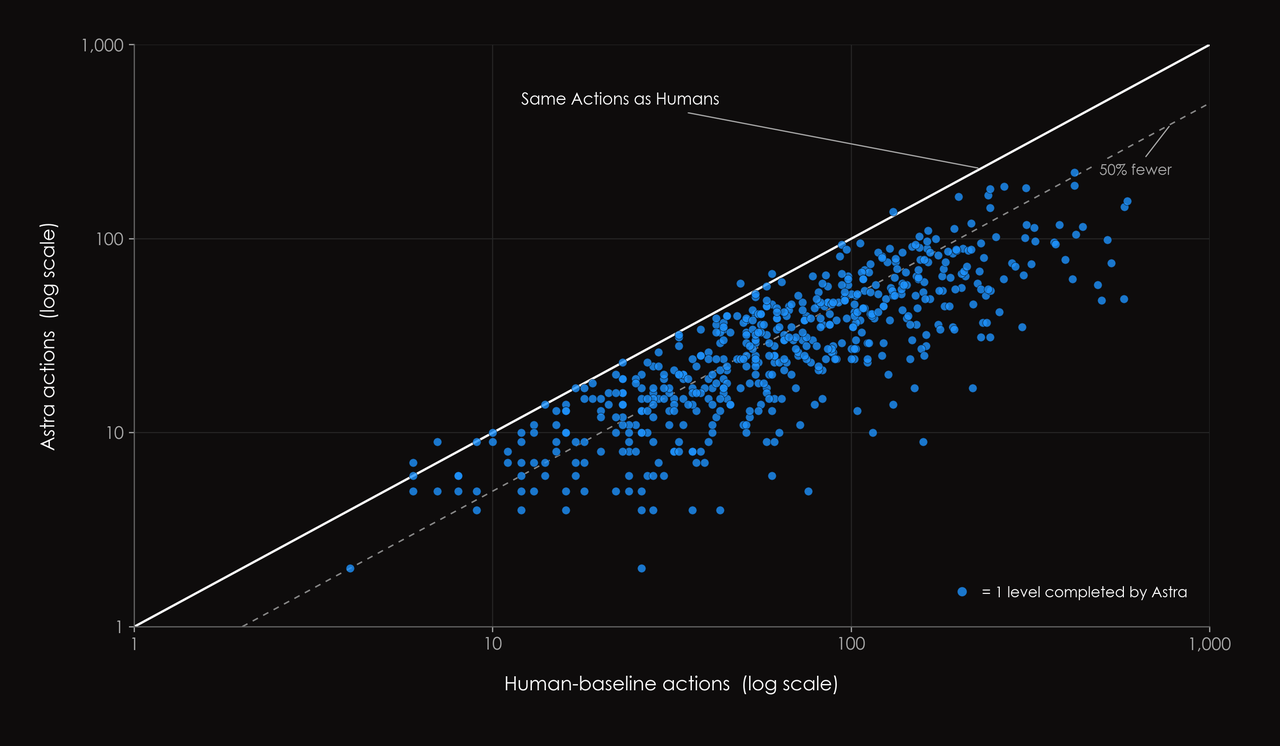
Perbandingan ARC Prize tentang efisiensi tindakan Astra di berbagai harness evaluasi
Kebijakan harness netral penyedia mengharuskan model memelihara informasi penting dalam state yang terlihat. Provider Adapter mempertahankan state penalaran tambahan dan menggunakan manajemen konteks spesifik penyedia. Di seluruh pasangan game-reasoning yang sama-sama terpecahkan, ARC Prize melaporkan eksekusi 3.66× lebih cepat dan 49% lebih sedikit total token dengan adapter.
Hasil 99.9% mengukur sistem model–provider-adapter spesifik dan tidak boleh diperlakukan sebagai ukuran independen-harness atas kecerdasan mentah model. Arsitektur konteks adalah bagian dari sistem yang di-benchmark.
Usaha Penalaran Tidak Diskalakan Secara Linear
Tabel ARC juga menunjukkan bahwa usaha maksimum tidak selalu menghasilkan skor tertinggi. Usaha tinggi mencapai 99.9% dengan Provider Adapter, sementara max mencapai 98.6%. Dalam harness Standard, max berkinerja terbaik.
OpenAI mencatat bahwa angka tabel peluncuran umumnya menggunakan pengaturan penalaran terbaik yang teramati. Pendekatan itu memperkirakan langit-langit performa, tetapi tidak mengidentifikasi konfigurasi produksi terbaik. Tim harus menguji beberapa tingkat usaha dan menghitung kualitas marjinal yang diperoleh per tambahan detik dan dolar.
Matematika dan Penalaran Akademik
FrontierMath Tier 4 v2 naik dari 83.0% ke 97.6%, kenaikan 14.6 poin. Itu peningkatan benchmark besar, tetapi bukan bukti bahwa matematika frontier telah terselesaikan. Evaluasi mencakup distribusi tugas terpilih dan tidak mengukur setiap tahap riset matematika, termasuk pemilihan masalah, verifikasi bukti formal, pengembangan program jangka panjang, atau tinjauan sejawat adversarial.
GPQA Diamond memberikan pola sebaliknya: 96.0% untuk Astra, 94.6% untuk Sol, 93.7% untuk Fable, dan 95.3% untuk Gemini 3.8 Flash. Model mengelompok erat dekat langit-langit. Melaporkan selisih 1.4 poin Astra–Sol akurat, tetapi menyebutnya revolusi kecerdasan luas akan melebihkan bukti.
Kemampuan kritis + pengaman
| Evaluasi keamanan siber | Astra | Sol | Kenaikan absolut |
|---|---|---|---|
| ExploitBench | 100.0% | 78.5% | +21.5 pp |
| ExploitGym | 42.4% | 30.3% | +12.1 pp |
| ExploitBench, Juni–Agustus 2026 | 39.0% | 5.5% | +33.5 pp |
| SRE-Bench | 88.0% | 55.9% | +32.1 pp |
| SEC-Bench Pro | 85.4% | 79.1% | +6.3 pp |
OpenAI membuat ExploitBench (Juni–Agustus 2026) dari kerentanan yang diungkap dalam tiga bulan sebelumnya, mengurangi peluang bahwa paparan kerentanan historis menggelembungkan hasil. Astra mencetak 39.0% pada set ini dibanding 5.5% Sol, dan OpenAI melaporkan bahwa Astra menemukan dan mengeksploitasi dua kerentanan zero-day yang sebelumnya tidak diketahui. Hasil ini berkontribusi pada Astra menjadi model pertama OpenAI yang diterapkan secara luas yang mencapai ambang kapabilitas keamanan siber Kritis, yang secara langsung memengaruhi pengaman dan kebijakan akses.
Cara Membaca Skor di Dekat Saturasi
Skor di atas 90% memerlukan bahasa yang lebih hati-hati daripada hasil kisaran tengah. Beralih dari 50% ke 60% menyelesaikan sepuluh tugas tambahan per seratus. Beralih dari 95% ke 96% hanya menyelesaikan satu tugas tambahan per seratus, meskipun mengurangi jumlah kesalahan yang tersisa dari lima menjadi empat—pengurangan 20% dalam kesalahan. Kedua deskripsi secara matematis benar, tetapi mendukung tajuk yang sangat berbeda.
Kewaspadaan yang berlawanan berlaku untuk benchmark berskor rendah. Kenaikan dari 18.1% ke 41.4% tetap jauh di bawah operasi otonom yang andal, tetapi lebih dari dua kali lipat jumlah kasus yang berhasil dan dapat mentransformasi alur kerja yang diawasi. Skor absolut menentukan apakah sistem siap; ukuran peningkatan menunjukkan seberapa cepat kemampuan berubah. Keputusan produksi membutuhkan keduanya.
Perbandingan Multidimensi
| Dimensi | Astra | Sol | Fable | Sinyal Keputusan |
|---|---|---|---|---|
| Penalaran akademik umum | Sangat baik; sering dekat saturasi | Tepat di belakang | Kompetitif | Celah kecil jarang menentukan penerapan |
| Eksekusi terminal | Kelas teratas | Kesenjangan generasional besar | Pesaing dekat | Uji seluruh harness pengodean |
| Penggunaan komputer | Keberhasilan lebih tinggi dan runtime lebih rendah | Lebih lambat dan kurang akurat | Data yang setara tidak cukup dalam tabel peluncuran | Ukur keberhasilan per jam |
| Retrieval konteks panjang | Kuat dekat 1M token | Degradasi material dekat batas | Data yang sebanding langsung tidak cukup | Gunakan uji retrieval berbentuk produksi |
| Kontrol penalaran | low hingga max | Envelope usaha berbeda | Pendekatan berpikir adaptif | Tuning konfigurasi, bukan hanya nama model |
| Kapabilitas siber | Tingkat risiko kualitatif lebih tinggi | Hasil terpublikasi lebih rendah | Tidak dibandingkan di sini | Pengaman dan kebijakan akses penting |
| Ekonomi token | Tarif lebih tinggi; kadang lebih sedikit token | Tarif lebih rendah | Bergantung pada beban kerja | Bandingkan biaya per tugas berhasil |
Hasilnya bergantung pada beban kerja. Astra paling menarik saat tugas memerlukan interaksi berkelanjutan dengan alat dan lingkungan, pemulihan setelah kegagalan, atau retrieval yang andal di konteks sangat besar. Sol mungkin tetap lebih ekonomis untuk pekerjaan terbatas dengan konteks moderat dan iterasi terbatas. Fable adalah pesaing dekat pada pekerjaan terminal dan memimpin sebagian evaluasi akademik eksternal, jadi benchmark tingkat aplikasi lebih berguna daripada kesimpulan tingkat penyedia.
Siapa yang Sebaiknya Menggunakan GPT-6 Astra?
| Kasus penggunaan | Rekomendasi |
|---|---|
| Klasifikasi sederhana | Tidak selalu layak menggunakan Astra |
| Ringkasan sederhana | Tidak selalu layak menggunakan Astra |
| RAG standar | Benchmark biaya vs performa terlebih dahulu |
| Sintesis & analisis dokumen panjang | Layak menguji Astra |
| Pengodean agenik | Sangat disarankan untuk diuji |
| Penggunaan komputer | Sangat disarankan untuk diuji |
| Otomasi multilangkah | Sangat disarankan untuk diuji |
| Riset kompleks | Layak diuji |
| Komputasi ilmiah / perangkat lunak khusus | Layak diuji |
| Keamanan siber | Kemampuan kuat, tetapi memerlukan pengaman yang tepat |
| Tugas sederhana ber-throughput tinggi | Model berbiaya lebih rendah bisa lebih hemat biaya |
Apakah Peningkatan Kinerja GPT-6 Astra Membenarkan Harga yang Lebih Tinggi?
GPT-6 Astra secara signifikan lebih mahal daripada GPT-5.6 Sol, tetapi peningkatan benchmark tidak terdistribusi merata di seluruh beban kerja. Pertanyaan harga karena itu tidak bisa dijawab dengan membandingkan tarif token saja.
| Skenario | Kenaikan performa | Justifikasi biaya |
|---|---|---|
| Q&A sederhana | Peningkatan kecil | Biasanya tidak layak premium |
| Agen pengodean | Peningkatan besar | Premium bisa dibenarkan |
| Analisis konteks panjang | Peningkatan signifikan | Bergantung pada kebutuhan retrieval |
| Otomasi komputer | Peningkatan kuat | Sering layak diuji |
| Penalaran umum | Peningkatan terbatas | Bandingkan biaya dengan saksama |
Pada tarif OpenAI Standard, GPT-6 Astra berharga $10 per juta token input, $1 per juta token input yang di-cache, $12.50 per juta token penulisan cache, dan $50 per juta token output. Input dan output Standard adalah 2.5× dari tarif $4 dan $20 untuk GPT-5.6 Sol. Saat sebuah permintaan melebihi 272K token input, tarif input dan cache Astra menjadi dua kali lipat dan tarif output naik 1.5× untuk seluruh permintaan.
Premi harga paling selaras dengan pekerjaan agenik. Astra naik lebih dari 20 poin persentase pada Terminal-Bench, AutomationBench, migrasi basis data, dan MRCR rentang terpanjang; pengujian independen juga melaporkan sekitar sepertiga penggunaan token Sol pada Coding Agent Index. Kesesuaiannya lebih lemah pada penalaran luas, di mana Intelligence Index nyaris seri dan penggunaan token hanya turun sekitar 10%. Keputusan pembelian karena itu harus membandingkan biaya per tugas berhasil, termasuk output, aktivitas cache, penggunaan alat, waktu berlalu, percobaan ulang, kegagalan, dan koreksi manusia.
Biaya per tugas berhasil
Biaya per tugas berhasil = (Biaya input + Biaya output + Biaya alat + Biaya percobaan ulang + Biaya tinjauan manusia) / Tugas yang berhasil
Biaya bisnis yang diharapkan
Biaya bisnis yang diharapkan = Biaya API + Biaya alat + Biaya percobaan ulang + Biaya tinjauan manusia + Biaya kegagalan
Metrik keputusan sebaiknya total biaya dibagi tugas yang berhasil, dievaluasi pada ambang kualitas yang dapat diterima—bukan harga per juta token semata.
Bagaimana Pengembang Seharusnya Membenchmark Astra
Leaderboard publik seharusnya menentukan apa yang layak diuji, bukan membuat keputusan penerapan akhir. Bangun set tugas representatif dengan kasus rutin, kasus sulit, kasus konteks hilang, kegagalan alat, dan instruksi adversarial. Gunakan prompt produksi yang sama, izin, berkas sumber, anggaran waktu, dan kriteria penyelesaian untuk setiap model.
| Dimensi evaluasi | Ukuran | Mengapa pentIng |
|---|---|---|
| Keberhasilan tugas | Kriteria penerimaan terpenuhi | Mencegah jawaban yang persuasif namun tidak lengkap dihitung sukses |
| Keandalan | Distribusi keberhasilan di lintas ulangan | Mengekspos kemenangan sekali jalan yang tidak stabil |
| Eksekusi alat | Tindakan berhasil yang terverifikasi | Memisahkan panggilan alat dari hasil yang benar |
| Faktualitas | Klaim faktual yang didukung | Mengukur kualitas bukti dan abstain |
| Latensi | Waktu penyelesaian median dan ekor | Menangkap throughput operasional |
| Biaya | Total biaya per tugas berhasil | Termasuk percobaan ulang dan upaya yang gagal |
| Usaha manusia | Menit koreksi dan tinjauan | Sering mendominasi biaya penerapan nyata |
| Keterarahan | Pemulihan setelah persyaratan berubah | Menguji perilaku agen yang berjalan lama |
API Astra di CometAPI menggunakan ID model gpt-6-astra. API multi-model membuat praktis menjalankan evaluasi yang sama di Astra, Sol, Fable, dan Gemini tanpa mendesain ulang benchmark mengelilingi chart tajuk satu penyedia. Rute tugas agenik yang menuntut ke model yang pantas atas premi, dan gunakan model berbiaya lebih rendah di mana keunggulan terukur menghilang.
Kesimpulan
Lembar benchmark Astra mengesankan, tetapi skor paling spektakuler tidak otomatis paling berguna. ARC-AGI-3 menunjukkan potensi harness agen spesifik penyedia; skor harness Standard menunjukkan betapa kuatnya kontribusi infrastruktur. GPQA dan Intelligence Index independen menunjukkan bahwa kenaikan penalaran biasa bisa moderat. Pekerjaan terminal, otomasi, penggunaan komputer, pengambilan kembali konteks panjang, alur kerja ilmiah, dan keamanan siber menceritakan kisah yang lebih penting.
Rilis ini kurang tentang chatbot yang menjadi proporsional lebih pintar pada setiap pertanyaan dan lebih tentang kecerdasan frontier yang menjadi lebih baik dalam menyelesaikan pekerjaan. Apakah peningkatan itu layak dibayar bergantung pada seluruh konfigurasi sistem-model dan ekonomi tugas produksi yang berhasil.