
TL;DR
Grok 4.7 dan Xiaomi MiMo-V2.6 hadir hanya selang satu hari, tetapi keduanya merepresentasikan dua pendekatan berbeda terhadap AI frontier. Grok 4.7 menekankan stack agen proprietari yang terintegrasi erat untuk pengodean dan pekerjaan pengetahuan profesional, sementara MiMo-V2.6-Pro menggabungkan bobot terbuka, jendela konteks yang lebih besar, pemahaman multimodal native, dan harga API yang agresif.
SpaceXAI memposisikan Grok 4.7 sebagai model frontier mereka untuk pengodean, tugas agen, dan pekerjaan pengetahuan dengan jendela konteks 500K token dan upaya penalaran yang dapat dikonfigurasi.
Xiaomi memposisikan MiMo-V2.6-Pro sebagai flagship multimodal dengan konteks 1M dengan bobot terbuka serta dukungan untuk pemahaman teks, gambar, audio, dan video.
Singkatnya: Grok 4.7 adalah produk agen terkelola yang lebih terintegrasi secara vertikal; MiMo-V2.6-Pro memberi pengembang kontrol penerapan yang lebih besar dan harga token mentah yang jauh lebih rendah. Kecocokan terbaik bergantung pada beban kerja alih-alih satu skor tolok ukur.
Pokok Penting
- Grok 4.7 dibangun untuk pengodean berjangka panjang dan agen profesional. Dalam evaluasi yang diterbitkan vendor oleh SpaceXAI, model ini mencetak 46,3% pada CursorBench 4.0, 71,0% pada DeepSWE v1.1 pada upaya tinggi, dan 1.657 pada AA Briefcase v1.1.
- MiMo-V2.6-Pro luar biasa kompetitif untuk model terbuka. Xiaomi merilis bobot model dan melaporkan hasil yang mendekati sistem frontier proprietari pada beberapa tolok ukur pengodean dan agen, namun skor lintas-vendor tidak dapat dipertukarkan secara langsung.
- MiMo memiliki keunggulan konteks dan multimodal. MiMo-V2.6-Pro mendukung jendela konteks 1M token serta pemahaman teks, gambar, audio, dan video, dibandingkan Grok 4.7 yang memiliki konteks 500K dengan input teks dan gambar.
- MiMo jauh lebih murah pada token API mentah. Harga standar resmi adalah $0.435/$0.87 per juta token input/output yang tidak di-cache untuk MiMo-V2.6-Pro dibandingkan $2/$6 untuk Grok 4.7.
- Arsitektur penerapan adalah trade-off yang menentukan. Grok menawarkan stack alat pihak pertama yang lebih kuat; bobot terbuka MiMo memungkinkan penerapan privat, serving kustom, dan kontrol infrastruktur yang lebih dalam.
Grok 4.7 vs MiMo-V2.6-Pro Sekilas
| Dimensi | Grok 4.7 | MiMo-V2.6-Pro |
|---|---|---|
| Rilis | 21 September 2026 | 22 September 2026 |
| Akses dan kontrol | API proprietari dan ekosistem agen terkelola | Bobot terbuka, opsi self-hosting, dan akses API |
| Bukti kinerja | Kekuatan dalam pengodean dan tugas agen jangka panjang menurut penyedia; validasi pada harness yang sama | Kekuatan lintas penalaran, pengodean, dan multimodal menurut penyedia; validasi pada harness yang sama |
| Kekuatan khas | Alat pihak pertama, alur kerja terkelola, dan agen yang terhubung web/X | Kontrol penerapan, konteks 1M token, dan pemahaman teks/gambar/audio/video |
| Jendela konteks | 500K token | 1M token |
| Modalitas input | Teks dan gambar | Teks, gambar, audio, dan video |
| Input/output standar resmi yang tidak di-cache per 1M token | $2 / $6 | $0.435 / $0.87 |
| Penalaran | Low hingga xHigh | Penalaran mendalam |
| Bobot terbuka | Tidak | Tidak |
| Kecocokan terbaik | Alur kerja pengodean dan agen terkelola | Penerapan privat, input multimodal, dan biaya token mentah lebih rendah |
Apa itu Grok 4.7?
SpaceXAI secara resmi merilis Grok 4.7 pada 21 September 2026 sebagai model paling andal mereka untuk pengodean dan pekerjaan pengetahuan. Peluncuran ini penting karena laporan pra-rilis mencampur fakta yang terkonfirmasi dengan klaim arsitektural yang bocor. Dokumentasi peluncuran final tidak memublikasikan jumlah parameter total atau aktif, sehingga estimasi parameter pra-rilis tidak boleh dianggap sebagai spesifikasi resmi.
Menurut posting peluncuran resmi, Grok 4.7 menggunakan model dasar baru yang lebih besar daripada Grok 4.6 dan dilatih dengan putaran pembelajaran penguatan (RL) yang lebih panjang, diberi bobot ke arah masalah yang membutuhkan waktu penyelesaian berjam-jam.
Kedua model mengoptimalkan lapisan stack yang berbeda. Grok 4.7 menyediakan lingkungan terkelola yang lebih kaya di sekitar model; MiMo-V2.6-Pro mengekspos lebih banyak aspek model dan lapisan penerapan kepada pengembang.
Untuk prompt di atas 200K token, SpaceXAI menerapkan harga konteks tinggi. Tier yang dipublikasikan adalah $4 per juta token input, $1 per juta token input yang di-cache, dan $12 per juta token output.
Perubahan di Grok 4.7
Perubahan paling bermakna adalah tujuan pelatihan, bukan sekadar angka tolok ukur yang lebih tinggi. SpaceXAI menyatakan campuran RL bergeser ke tugas yang lebih panjang, berdurasi berjam-jam, sementara model dilatih untuk memverifikasi pekerjaannya sendiri dengan lebih cermat dan memahami harness Grok Bot secara native. Kombinasi itu menargetkan eksekusi agen nyata: mempertahankan state, menggunakan tool, memeriksa pekerjaan intermediate, dan tetap koheren sepanjang trajektori tugas yang panjang.
Kinerja Grok 4.7
| Tolok ukur yang dipublikasikan SpaceXAI | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| CursorBench 4.0 | 46.3% | 40.4% | 41.7% | 51.8% |
| DeepSWE v1.1 | 71.0%* | 65.2% | 72.7% | 70.0% |
| EEBench | 64.0% | 53.0% | 39.4% | 56.4% |
| AA Briefcase v1.1 | 1,657 | 1,546 | 1,487 | 1,678 |
| Terminal-Bench 4.0 | 38.0% | 20.3% | 37.3% | 57.9% |
| Harvey Legal Agent Benchmark | 19.6% | 15.8% | 2.5% | 6.7% |
| HealthBench Professional | 56.7% | 48.5% | 60.5% | 62.1% |
* SpaceXAI menandai DeepSWE Grok 4.7 sebagai upaya tinggi. Ini adalah evaluasi yang diterbitkan vendor dan harus ditafsirkan sesuai harness dan pengaturan penalaran yang terdokumentasi.
SpaceXAI menyajikan grafik peluncuran sebagai konten web-native di halaman pengumuman resmi; tabel yang bersumber di atas mempertahankan nilai tolok ukur yang diungkap tanpa menggambar ulang grafik.
Apa itu Xiaomi MiMo-V2.6?
Xiaomi secara resmi merilis dan membuka MiMo-V2.6 pada 22 September 2026. Keluarga ini mencakup MiMo-V2.6-Pro dan MiMo-V2.6-Flash, dengan opsi Pro-UltraSpeed untuk beban kerja sensitif latensi. Untuk perbandingan langsung dengan Grok 4.7, MiMo-V2.6-Pro adalah flagship yang setara.
Materi resmi Xiaomi secara terpisah mendokumentasikan bobot terbuka, input multimodal native, dan harga API. Kombinasi ini membuat MiMo-V2.6 relevan melampaui papan peringkat tolok ukur.
MiMo-V2.6 vs MiMo-V2.5: Apa yang ditingkatkan?
Judul arsitekturalnya bukan sekadar checkpoint yang lebih besar. Rilis publik Xiaomi sangat menekankan pascapelatihan dan Live RL. Menurut catatan rilis resmi, Pro dan Flash masing-masing menyelesaikan 30 langkah RL dan secara bersama menghasilkan sekitar 750.000 trajektori; biaya tahap RL yang diungkap kira-kira $2.62 juta untuk Pro dan $850.000 untuk Flash.
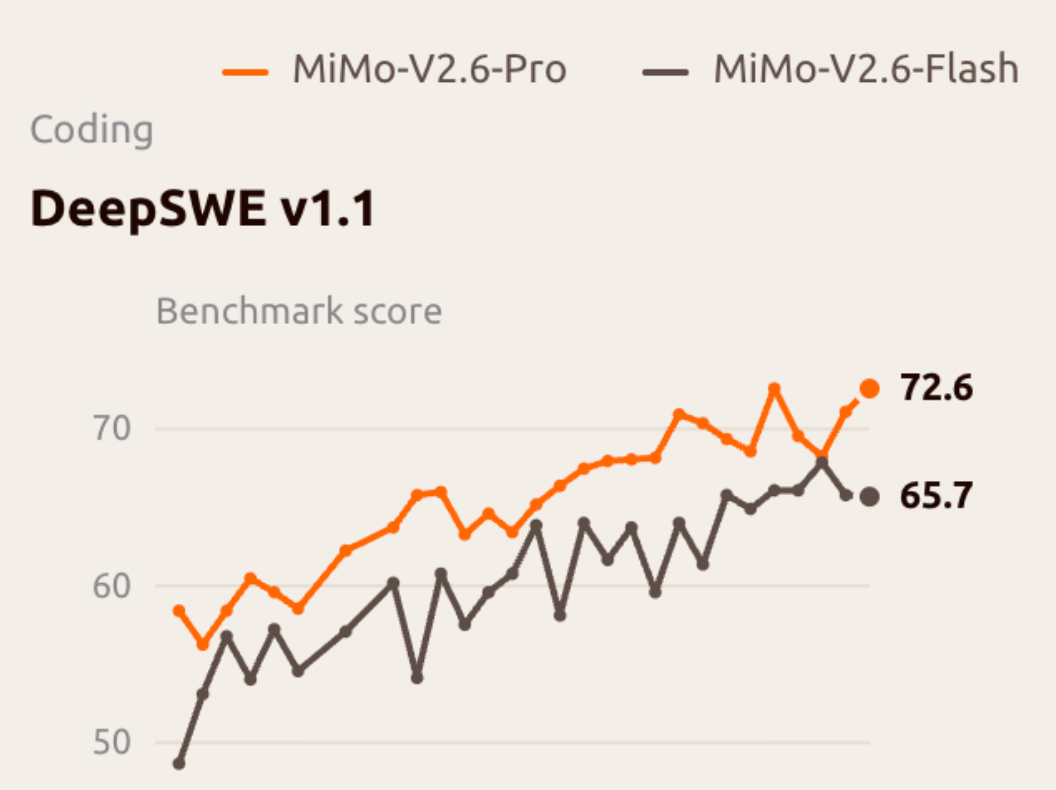
Satu detail tolok ukur perlu ditangani hati-hati: kurva Live RL Xiaomi menunjukkan MiMo-V2.6-Pro mencapai sekitar 72,6 pada DeepSWE v1.1 selama run pelatihan, sementara tabel perbandingan final melaporkan 71,9. Angka-angka ini merujuk konteks evaluasi yang berbeda dan tidak boleh digabungkan tanpa penjelasan.
Grok 4.7 vs MiMo-V2.6-Pro: Perbandingan Tolok Ukur
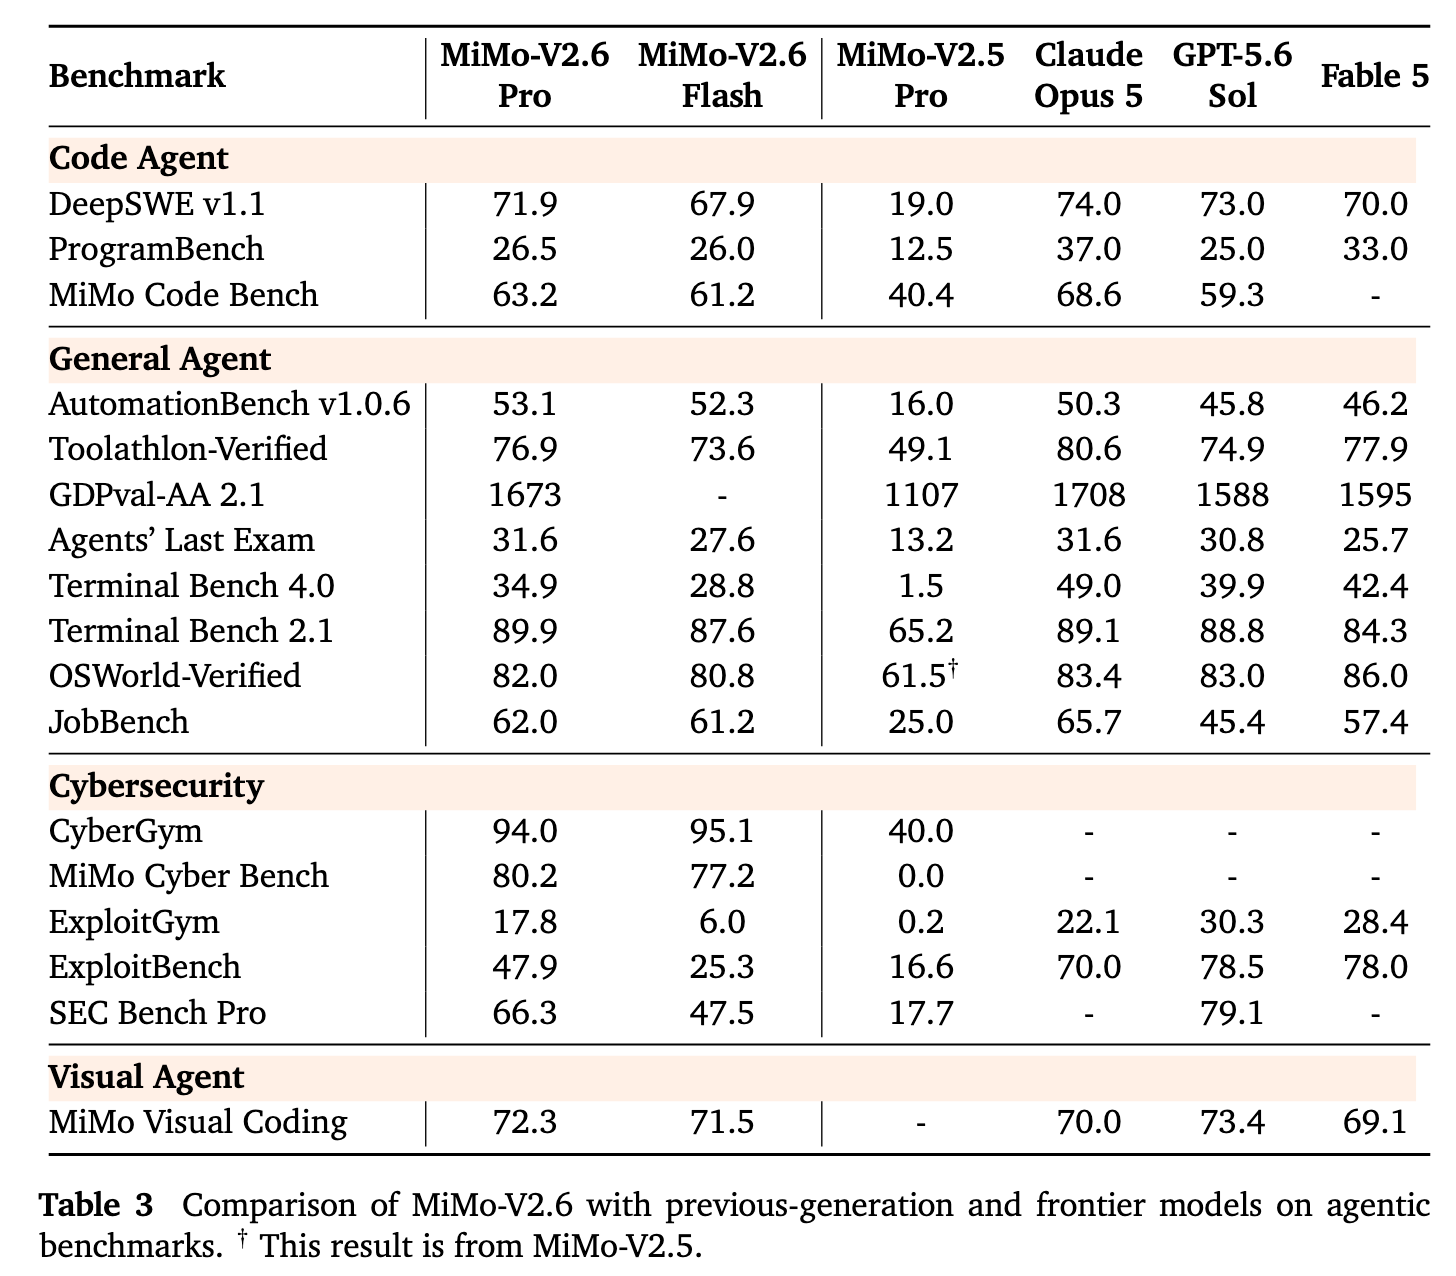
Perbandingan tolok ukur langsung memerlukan kehati-hatian. Vendor tidak selalu menggunakan harness, anggaran penalaran, checkpoint, atau konfigurasi tool yang identik. Bahkan saat nama tolok ukur sama, perbedaan skor kecil bisa kurang bermakna daripada kelihatannya. Perbandingan paling aman adalah memisahkan pengukuran yang benar-benar selaras dari bukti arah.
Artificial Analysis Intelligence Index
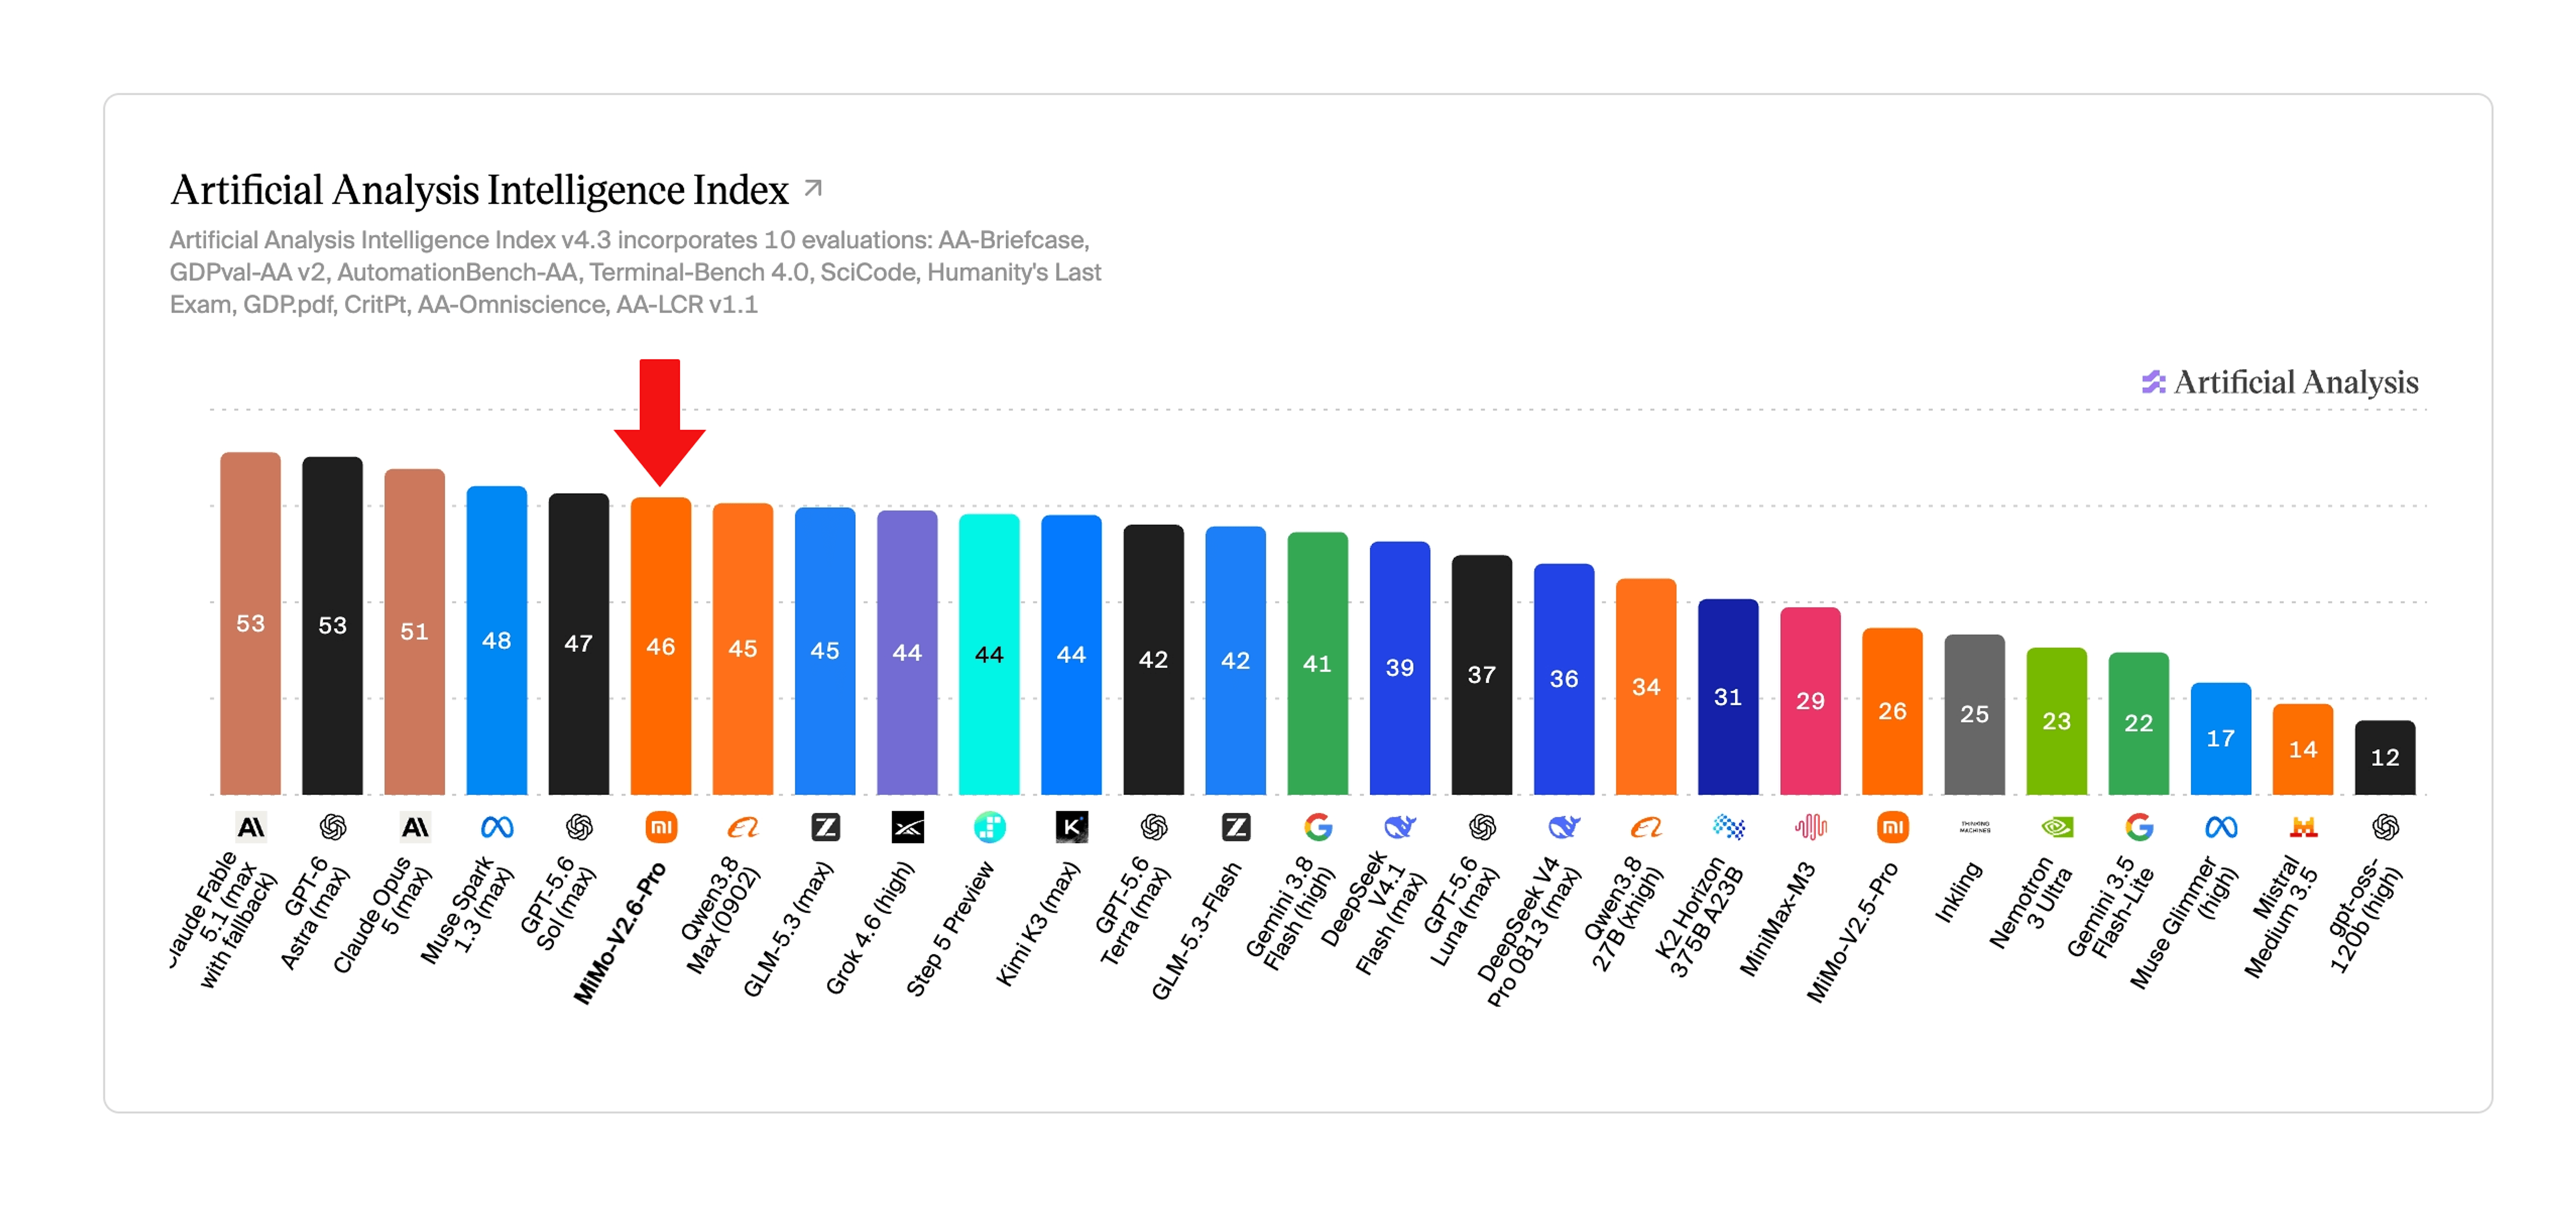
Xiaomi melaporkan 46.32 untuk MiMo-V2.6-Pro pada indeks komposit Artificial Analysis. Perbandingan apa pun dengan Grok harus ditautkan ke snapshot Artificial Analysis dan konfigurasi model yang persis digunakan; klaim kesetaraan yang dibulatkan tidak boleh disajikan tanpa sumber tersebut.
Kinerja Pengodean dan Agen
| Tolok ukur | Grok 4.7 — SpaceXAI | MiMo-V2.6-Pro — Xiaomi | Interpretasi |
|---|---|---|---|
| DeepSWE v1.1 | 71.0* | 71.9** | Dekat secara angka; run dan pengaturan yang dipublikasikan berbeda |
| GDPval-AA | Lihat grafik SpaceXAI | 1,673 | Hanya indikatif kecuali harness selaras |
| AA Briefcase | 1,657 | Lihat grafik Xiaomi | Gunakan nilai dari vendor dengan konteks sumber |
| Terminal-Bench 4.0 | 38.0 | 34.9 | Arah serupa; konfigurasi harness berpengaruh |
| Jendela konteks | 500K | 1M | MiMo mendukung konteks kerja yang lebih besar |
* SpaceXAI melaporkan DeepSWE Grok 4.7 pada upaya tinggi. ** Tabel perbandingan final Xiaomi melaporkan 71,9; kurva pelatihan Live RL mencapai sekitar 72,6. Angka-angka ini berasal dari konteks evaluasi yang berbeda.
Kecocokan Alur Kerja Pengodean
Untuk pengodean, perbedaannya bergantung pada apakah “pengodean” berarti pemecahan masalah repositori mentah atau pengalaman agen pengodean terkelola yang lengkap. Pada DeepSWE v1.1, angka yang dipublikasikan cukup berdekatan sehingga selisih di bawah satu poin tidak seharusnya menentukan pemilihan produksi sendirian.
Keunggulan Grok 4.7 lebih tinggi pada stack. Terintegrasi dengan Grok Build, tersedia di Cursor, dirancang untuk memahami harness Grok Bot, dan dipasangkan dengan tool eksekusi kode serta pencarian pihak pertama.
Keunggulan MiMo-V2.6-Pro lebih rendah pada stack. Bobot terbuka membuatnya praktis untuk membangun asisten pengodean privat, menyesuaikan serving, menegakkan kontrol residensi data, atau bereksperimen dengan harness agen proprietari.
Bagi tim yang memilih di antara keduanya, uji A/B produksi pada repositori yang representatif akan lebih informatif daripada satu tolok ukur pengodean publik.
Grok 4.7 vs MiMo-V2.6-Pro: Perbedaan Kapabilitas Multimodal
Ini adalah salah satu perbedaan paling jelas. Grok 4.7 menerima input teks dan gambar serta menghasilkan teks. Platform Grok yang lebih luas menawarkan produk media terpisah, tetapi itu tidak boleh disamakan dengan cakupan modalitas model grok-4.7 itu sendiri.
MiMo-V2.6-Pro mendukung pemahaman teks, gambar, audio, dan video. Dikombinasikan dengan jendela konteks 1M token, ini memperluas jangkauan alur kerja yang dapat ditangani dalam satu konteks model.
- Analisis tangkapan layar dan kode dalam tugas yang sama
- Pemahaman video dengan instruksi pendamping
- Pemrosesan audio panjang
- Agen penggunaan komputer dengan umpan balik visual
- Asisten riset multimodal
- Ekstraksi dan QA multimodal berskala besar
Grok 4.7 vs MiMo-V2.6-Pro: Perbandingan Harga API
| Harga API resmi | Grok 4.7 | MiMo-V2.6-Pro |
|---|---|---|
| Input / 1M token | $2.00 | $0.435 |
| Input yang di-cache / 1M | $0.50 | $0.0036 |
| Output / 1M | $6.00 | $0.87 |
| Biaya tambahan konteks panjang | Ya, di atas 200K token prompt | Tidak ada tier standar sebanding yang dipublikasikan |
| Opsi bobot terbuka/self-host | Tidak | Ya |
Pada harga daftar, MiMo-V2.6-Pro beberapa kali lebih murah pada input normal maupun output yang dihasilkan, dengan perbedaan yang sangat besar untuk konteks yang di-cache. Itu dapat secara material memengaruhi ekonomi agen yang berulang kali memroses repositori, dokumen panjang, atau konteks persisten.
Catatan harga penting: Jendela konteks 500K Grok 4.7 tidak berarti seluruh konteks ditagih pada tarif standar. Permintaan di atas 200K token prompt dikenai biaya di tier konteks panjang.
Per 24 September 2026, CometAPI mencantumkan Grok 4.7 pada $1.60 input dan $4.80 output per 1M token, dibandingkan $2.00 dan $6.00 resmi. MiMo-V2.6-Pro dicantumkan $0.348 input dan $0.696 output, dibandingkan $0.435 dan $0.87 resmi. Tarif standar yang tercantum itu 20% di bawah tarif resmi terkait. Harga dan kelayakan dapat berubah; konfirmasikan halaman model live sebelum membuat anggaran.
Harga token tidak identik dengan biaya per tugas yang diselesaikan. Model penalaran dapat mengonsumsi volume token berbeda, menggunakan jumlah panggilan tool berbeda, dan membutuhkan tingkat retry yang berbeda. Evaluasi produksi karena itu sebaiknya melacak biaya per tugas selesai, latensi, dan tingkat keberhasilan bersama-sama.
Grok 4.7 vs MiMo-V2.6-Pro: Akses dan Ketersediaan
Perbedaannya jelas: Grok 4.7 tersedia melalui API dan alur kerja Grok terkelola, sementara bobot modelnya tidak ditawarkan untuk self-hosting. MiMo-V2.6-Pro tersedia melalui API dan sebagai bobot terbuka, memberi tim jalur self-host tambahan.
Ketersediaan terpisah dari fleksibilitas lisensi atau penerapan. Per 24 September 2026, kedua model juga memiliki halaman katalog CometAPI yang live. Tim harus mengonfirmasi endpoint, region, batas laju, dan kelayakan akun sebelum peluncuran produksi; model yang terdaftar tidak menjamin ketersediaan atau tingkat layanan yang identik untuk setiap akun.
| Pertanyaan ketersediaan | Grok 4.7 | MiMo-V2.6-Pro |
|---|---|---|
| API resmi | Tersedia melalui xAI | Tersedia melalui Xiaomi MiMo |
| Katalog CometAPI | Tercantum sebagai tersedia | Tercantum sebagai tersedia |
| Bobot self-hosted | Tidak tersedia | Opsi bobot terbuka |
| Pemeriksaan operasional | Konfirmasi akses akun, region, batas laju, dan ketersediaan tool | Konfirmasi akses akun, kesiapan endpoint, dan persyaratan self-hosting |
Bobot Terbuka dan Akses Proprietari
MiMo-V2.6-Pro yang berbobot terbuka mengubah perbandingan lebih besar daripada selisih satu poin tolok ukur. Ini menciptakan opsi untuk penerapan privat, penyetelan mesin inferensi, pascapelatihan kustom, kontrol residensi data, dan integrasi infrastruktur yang lebih dalam.
Grok 4.7 mengambil trade-off sebaliknya: kontrol lebih kecil terhadap internal model sebagai imbalan layanan terkelola yang dioperasikan secara berkelanjutan dan ekosistem pihak pertama yang terintegrasi erat. Bagi banyak organisasi, persyaratan tata kelola dan infrastruktur akan menentukan daftar pendek sebelum kinerja tolok ukur melakukannya.
Cara Menggunakan API Grok 4.7 dan MiMo V2.6 di CometAPI
Pengembang dapat mengakses API Grok 4.7 di CometAPI melalui alur kerja API terpadu, mengurangi kebutuhan untuk memelihara integrasi spesifik penyedia yang terpisah.
Untuk tim yang membandingkan beberapa model frontier, lapisan API terpadu sangat berguna karena prompt produksi yang sama, harness uji, perhitungan token, dan kode aplikasi dapat dijalankan ulang di berbagai model dengan variabel integrasi yang lebih sedikit.
CometAPI kini mencantumkan MiMo-V2.6-Pro sebagai tersedia, dengan ketersediaan API terkonfirmasi pada 22 September 2026. Periksa katalog live dan akses akun sebelum penggunaan produksi.
Dengan kedua halaman model kini tercantum sebagai tersedia, uji A/B di level aplikasi dapat menjaga prompt, tool, pengaturan penalaran, dan kriteria keberhasilan tetap konsisten, lalu membandingkan penyelesaian tugas, latensi, penggunaan token, dan mode kegagalan.
Grok 4.7 vs MiMo-V2.6-Pro: Kecocokan Model berdasarkan Kasus Penggunaan
| Kebutuhan | Kecocokan model / panduan evaluasi |
|---|---|
| Pencarian web dan X pihak pertama | Grok 4.7 |
| Agen berjalan lama yang terkelola | Grok 4.7 |
| Alur kerja Grok Build / Cursor | Grok 4.7 |
| Jendela konteks 1M | MiMo-V2.6-Pro |
| Pemahaman audio/video native | MiMo-V2.6-Pro |
| Bobot terbuka, self-hosting, dan kontrol model | MiMo-V2.6-Pro |
| Biaya token API mentah terendah | MiMo-V2.6-Pro |
| Pengodean repositori | Benchmark keduanya pada repositori yang representatif |
| Agen pengetahuan profesional | Benchmark keduanya pada tugas produksi |
Keputusan karena itu perlu dibingkai berdasarkan arsitektur beban kerja. Grok 4.7 dirancang untuk membuat stack agen terkelola lebih kapabel; MiMo-V2.6-Pro dirancang untuk membuat kecerdasan kelas atas lebih murah, lebih multimodal, dan lebih dapat dikendalikan.
Mana yang sebaiknya Anda pilih?
Pilih Grok 4.7 jika Anda menginginkan pengalaman agen terkelola dengan pencarian web dan X pihak pertama, eksekusi kode native, dan lebih sedikit infrastruktur untuk dioperasikan. Ini merupakan opsi yang lebih praktis bagi tim yang menghargai stack alat terintegrasi dan alur kerja profesional atau pengodean yang berjalan lama.
Pilih MiMo-V2.6-Pro jika Anda memerlukan bobot terbuka, penerapan privat, jendela konteks 1M token, pemahaman audio dan video native, atau harga API mentah yang secara substansial lebih rendah. Ini adalah opsi yang lebih kuat saat kontrol penerapan, cakupan multimodal, dan efisiensi biaya menjadi kendala utama.
Jika pilihan masih belum jelas, jalankan kedua model pada tugas representatif yang sama dengan prompt, tool, anggaran penalaran, batas waktu, dan kebijakan retry yang identik. Pilih model yang memberikan kombinasi terbaik antara tingkat penyelesaian, latensi, total biaya per tugas yang berhasil, dan upaya tinjauan manusia.
Kesimpulan
Grok 4.7 vs MiMo V2.6 mengungkap bahwa kecerdasan mentah bukan lagi satu-satunya pembedaan bermakna. Kedua model menempati pita kapabilitas tinggi yang serupa dalam evaluasi publik saat ini, namun strategi produk mereka berpisah tajam.
Grok 4.7 menggabungkan jendela konteks 500K, penalaran yang dapat dikonfigurasi, pelatihan agen jangka panjang yang kuat, serta stack pencarian dan eksekusi pihak pertama yang matang. MiMo-V2.6-Pro menggabungkan jendela konteks 1M, input multimodal native, bobot terbuka, dan harga API jauh di bawah banyak sistem frontier proprietari.
Bagi pengembang, pertanyaan praktisnya kurang “skor tolok ukur mana yang lebih tinggi?” dan lebih “di mana kecerdasan sebaiknya ditempatkan?” Ekosistem agen terkelola dan stack model terbuka yang dapat dikustomisasi menyelesaikan masalah operasional yang berbeda. Pilihan yang tepat adalah yang paling cocok dengan beban kerja produksi, kendala infrastruktur, dan model biaya.
Tanya Jawab
Apakah Grok 4.7 adalah model 2,1 triliun parameter?
Angka sekitar 2,1T beredar sebelum rilis, tetapi dokumentasi Grok 4.7 SpaceXAI final tidak memublikasikan jumlah parameter total atau aktif. Pernyataan yang dikonfirmasi adalah bahwa Grok 4.7 menggunakan model dasar yang lebih besar daripada Grok 4.6.
Apakah MiMo-V2.6 bersifat open source?
Xiaomi merilis MiMo-V2.6 sebagai keluarga model terbuka dengan bobot yang dapat diunduh dan sumber daya riset terkait. Dalam perencanaan produksi, tim tetap harus meninjau lisensi model dan syarat redistribusi yang tepat untuk penggunaan yang dimaksudkan.
Berapa biaya Grok 4.7 vs MiMo-V2.6-Pro per tugas agen yang diselesaikan?
Normalisasikan set tugas, prompt, izin tool, kebijakan retry, dan kriteria keberhasilan. Lacak total token input, input yang di-cache, penalaran dan output, panggilan tool, latensi, retry, dan waktu tinjauan manusia. Harga token mentah hanyalah satu komponen biaya per tugas selesai.
Seberapa andal perbandingan tolok ukur Grok 4.7 vs MiMo-V2.6-Pro?
Gunakan repositori atau set tugas yang sama, harness agen, tool, anggaran penalaran, batas waktu, kebijakan retry, dan rubrik penilaian yang sama. Laporkan interval kepercayaan atau variasi run berulang, dan pisahkan angka yang dipublikasikan vendor dari hasil internal.
Apakah Grok 4.7 mengenakan biaya lebih tinggi untuk prompt konteks panjang?
SpaceXAI mendokumentasikan tarif yang lebih tinggi ketika token prompt melebihi 200K. Karena tier yang lebih tinggi berlaku untuk permintaan tersebut, tim yang menggunakan repositori besar atau konteks agen persisten sebaiknya memodelkan ambang itu secara eksplisit.