
Menjalankan Qwen3.8-Max secara lokal kini memungkinkan, tetapi frasa “Qwen 3.8 Max locally” membutuhkan satu klarifikasi penting. Produk Max yang dihosting oleh Alibaba dan checkpoint yang dapat diunduh saling terkait erat, namun bukan produk yang identik.
Qwen pertama kali meluncurkan layanan Max yang dihosting pada awal Agustus 2026 dan merilis Qwen3.8-2.4T-A95B sebagai open weights pada 12 Agustus 2026. Checkpoint itulah yang benar-benar Anda deploy di infrastruktur Anda sendiri.
Ini bukan tutorial Ollama-di-PC-gaming yang biasa. Checkpoint non-kuantisasi adalah model Mixture-of-Experts dengan 2,4 triliun parameter, dan resep vLLM saat ini memperkirakan bobot BF16-nya sebesar 4,45 TiB. Bahkan varian floating-point 4-bit berorientasi produksi tetap memakan ruang sekitar 1,3–1,5 TiB untuk bobot.
Jawaban singkat: self-hosting penuh kelas Qwen 3.8 Max adalah deployment pusat data. Titik awal produksi yang praktis adalah checkpoint FP4 pada 8× B300 atau 8× MI355X GPU; deployment H200 membutuhkan lebih banyak GPU. Untuk workstation normal, gunakan Qwen3.8-27B.
Qwen 3.8 Max vs. Model Terbuka yang Sebenarnya Anda Deploy
Checkpoint Qwen3.8-2.4T-A95B yang dapat diunduh secara resmi dideskripsikan sebagai model bahasa kausal 2,4T-parameter dengan sekitar 95B parameter yang aktif per token. Layanan Max yang dihosting menambahkan kapabilitas lapisan produk yang tidak terdapat dalam checkpoint terbuka saat ini.
| Spesifikasi | Layanan hosted Qwen3.8-Max | Checkpoint terbuka Qwen3.8-2.4T-A95B |
|---|---|---|
| Total parameter | 2.4T | 2.4T |
| Parameter aktif | ~95B | ~95B |
| Arsitektur | Sparse MoE | Sparse MoE |
| Input | Teks, gambar, video | Teks |
| Konteks | Konteks terkelola 1M | 262.144 native; dapat diperluas hingga ~1,01M |
| Perilaku thinking | Opsi thinking terkelola/non-thinking | Thinking diwajibkan; upaya reasoning dapat diatur |
| Alat bawaan | Tersedia pada layanan terkelola | Aplikasi harus menyediakan alat |
| Self-hosting | Tanpa manajemen bobot | Ya; checkpoint terbuka |
Produk hosted mengekspos input teks, gambar, dan video dengan konteks 1.000.000 token. Sebaliknya, checkpoint terbuka hanya teks dan memiliki konteks native 262.144 token. Perbedaan ini penting jika aplikasi Anda bergantung pada input multimodal atau alat bawaan yang terkelola.
Arsitektur dan Spesifikasi Qwen 3.8
CometAPI telah membahas latar belakang model di What is Qwen3.8 Max, jadi panduan deployment ini memfokuskan arsitektur pada detail yang memengaruhi memori, paralelisme, dan penyajian.
| Spesifikasi relevan untuk deployment | Qwen3.8-2.4T-A95B |
|---|---|
| Total / parameter aktif | 2,4T / ~95B per token |
| Tata letak layer | 92 layer: 69 Gated DeltaNet + 23 full attention |
| MoE routing | 512 routed experts; 10 routed + 1 shared aktif |
| Full-attention heads | 64 query / 4 key-value heads |
| Konteks native | 262.144 token |
| Konteks diperpanjang | Hingga kira-kira 1.010.000 token |
| Multi-Token Prediction | Didukung |
| Modality checkpoint terbuka | Hanya teks |

Arsitektur model hybrid Qwen resmi yang digunakan dalam panduan deployment SGLang Qwen3.8.
Jangan menafsirkan “95B parameter aktif” sebagai jejak memori model 95B. Aktivasi spars mengurangi komputasi per token, tetapi sistem serving tetap membutuhkan akses ke seluruh set bobot expert.
Snapshot Benchmark Qwen 3.8 Max
Karena ulasan Qwen3.8 Max di CometAPI sudah membahas benchmark secara rinci, artikel ini hanya menggunakan subset yang relevan untuk deployment dari tabel benchmark kartu model resmi Qwen.
| Benchmark | Qwen3.8-Max | Qwen3.7-Max | GPT-5.6 Sol (max) |
|---|---|---|---|
| Terminal Bench 2.1 | 86.6 | 74.5 | 88.8 |
| SWE-bench Pro | 67.7 | 60.6 | 64.6 |
| PaperBench | 93.0 | 64.8 | 90.5 |
| FrontierSWE | 73.5 | 40.7 | — |
| CoWorkBench | 74.8 | 64.6 | 71.5 |
| GPQA Diamond | 92.6 | 92.4 | 94.1 |
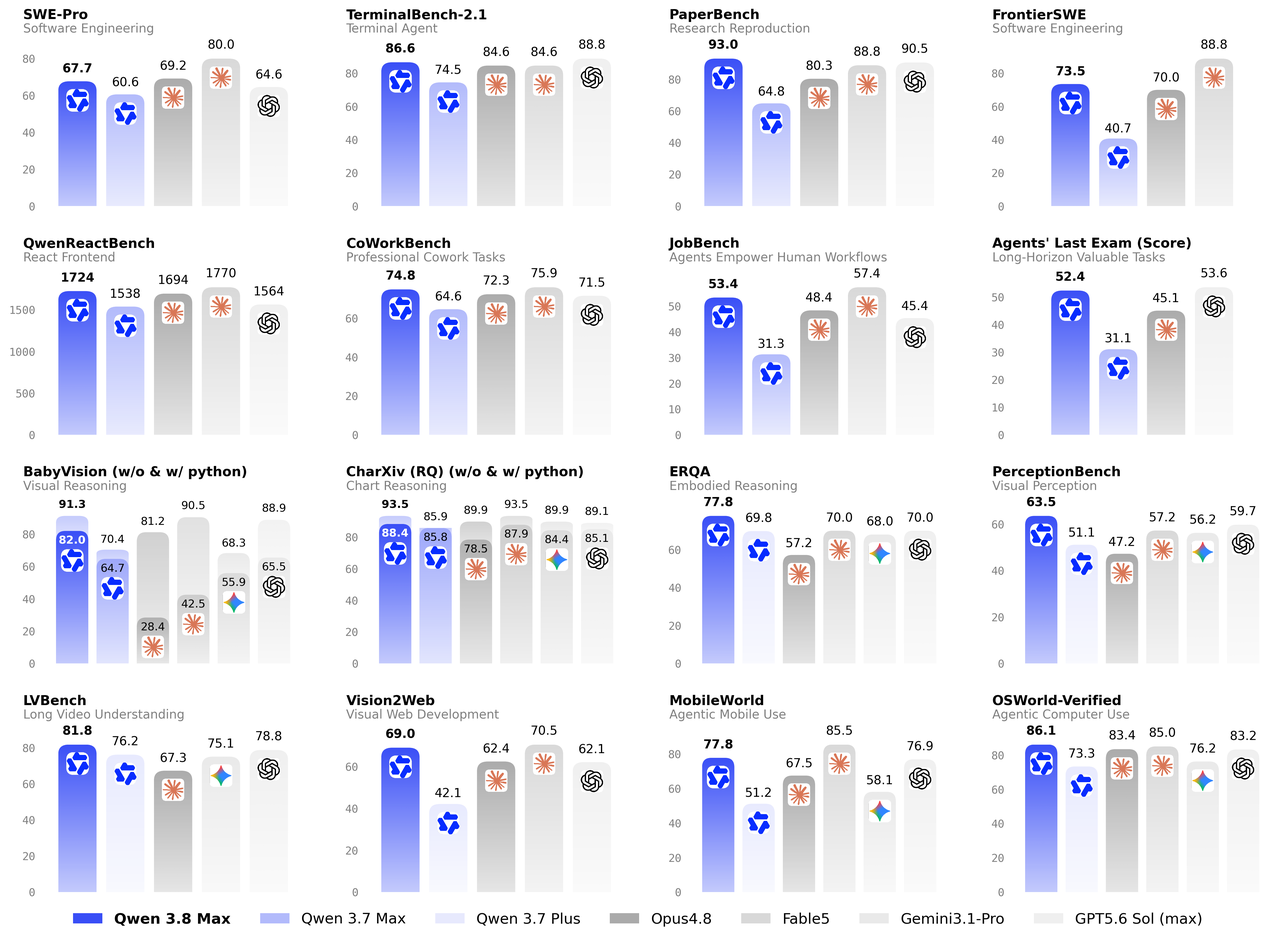
Grafik performa Qwen3.8 resmi yang dipublikasikan oleh tim Qwen.
Kenaikan terbesar yang dilaporkan dibanding Qwen3.7-Max pada subset ini adalah PaperBench dan FrontierSWE. Qwen3.8-Max juga melampaui GPT-5.6 Sol pada SWE-bench Pro dan PaperBench, sementara GPT-5.6 Sol tetap unggul pada Terminal Bench 2.1. Untuk keputusan deployment, perlakukan ini sebagai konteks kapabilitas; pengukuran memori dan throughput serving di bawah ini lebih relevan secara operasional.
Tabel benchmark bukan peringkat universal. Harness, batas waktu, batas konteks, akses alat, dan kuantisasi dapat mengubah hasil. Lakukan benchmark pada checkpoint, presisi, mesin serving, dan distribusi prompt yang persis Anda rencanakan untuk digunakan.
Perangkat Keras Apa yang Dibutuhkan Qwen3.8 untuk Deployment Lokal?
Persyaratan GPU untuk Qwen3.8-2.4T-A95B
Ini adalah pertanyaan deployment kunci. Resep vLLM Qwen3.8 saat ini mempublikasikan jejak checkpoint dan jumlah GPU realistis dengan headroom runtime, yang lebih berguna dibanding mengestimasi VRAM hanya dari jumlah parameter.
| Presisi | Jejak bobot | B300 (268 GB) | MI355X (288 GB) | H200 (141 GB) | Best fit |
|---|---|---|---|---|---|
| BF16 | 4,45 TiB | 24 GPU | 24 GPU | 48 GPU | Fidelitas maksimum/riset |
| FP8 | 2,27 TiB | 16 GPU | 16 GPU | 32 GPU | Produksi fidelitas tinggi |
| MXFP4 | 1,45 TiB | — | 8 GPU | 16 GPU | Deployment AMD yang praktis |
| NVFP4 W4A4 | 1,32 TiB | 8 GPU | — | 16 GPU | Deployment NVIDIA yang praktis |
Bagi sebagian besar organisasi yang benar-benar membutuhkan self-hosting Qwen3.8, FP4 adalah titik awal yang praktis. Konfigurasi NVIDIA yang menonjol adalah NVFP4 W4A4 pada 8× B300; rute AMD yang sesuai adalah MXFP4 pada 8× MI355X.
Server 8× H200 tidak cukup untuk deployment model penuh yang direkomendasikan ini. Resep resmi memperkirakan H200 pada 16 GPU untuk FP4, 32 untuk FP8, dan 48 untuk BF16.
Persyaratan VRAM untuk Qwen3.8-27B
Qwen3.8-27B adalah alternatif kelas workstation yang praktis. Memori bobot mentah kira-kira 54 GB pada BF16, 27 GB pada FP8, dan 13,5 GB pada presisi 4-bit. Overhead runtime dan KV cache meningkatkan kebutuhan aktual, terutama pada panjang konteks yang tinggi.
| Presisi | Perkiraan memori bobot | Panduan deployment praktis |
|---|---|---|
| BF16 | ~54 GB | Gunakan GPU 64–80 GB, tergantung konteks dan overhead. |
| FP8 / INT8 | ~27 GB | GPU 40–48 GB memberi headroom runtime yang lebih praktis. |
| 4-bit | ~13,5 GB | GPU konsumen 20–24 GB dapat layak pada panjang konteks moderat. |
Angka-angka ini adalah estimasi perencanaan yang diturunkan dari jumlah parameter. Konfirmasikan checkpoint, format kuantisasi, mesin serving, panjang konteks, dan pengaturan KV-cache yang tepat sebelum menentukan ukuran perangkat keras produksi.
Apakah Qwen3.8 Dapat Berjalan pada GPU Konsumen?
Model penuh Qwen3.8-2.4T-A95B tidak praktis pada GPU konsumen biasa, bahkan dengan kuantisasi agresif. Sebuah proyek komunitas telah mendemonstrasikan build UD-Q1_0 terkompresi agresif 397 GB di empat sistem DGX Spark, tetapi rute tersebut merupakan kuantisasi ekstrem eksperimental alih-alih baseline untuk serving yang sensitif terhadap kualitas.
Untuk workstation atau home lab, model yang lebih tepat adalah Qwen3.8-27B, yang open weights-nya dirilis pada 14 Agustus 2026. Model ini jauh lebih mudah untuk di-host dan merupakan pilihan yang tepat jika “lokal” berarti satu workstation alih-alih klaster GPU.
Sebelum Anda Menginstal Qwen 3.8 Max
Rencanakan infrastruktur sebelum menjalankan perintah install. Anda memerlukan Linux, stack akselerator yang kompatibel, cukup penyimpanan lokal atau bersama untuk checkpoint, interkoneksi GPU berbandwidth tinggi, dan—ketika lintas node—jaringan yang dirancang untuk inferensi terdistribusi. Resep vLLM saat ini merekomendasikan vLLM nightly dan Transformers 5.4.0 atau lebih baru.
bash
uv venv
source .venv/bin/activate

uv pip install -U vllm \
  --extra-index-url https://wheels.vllm.ai/nightly

uv pip install -U "transformers>=5.4.0"
Cara Deploy Qwen 3.8 FP8 dengan vLLM
FP8 adalah pilihan masuk akal ketika Anda menginginkan checkpoint yang disediakan Qwen dan dapat menanggung infrastruktur multi-node. Checkpoint resmi adalah Qwen/Qwen3.8-2.4T-A95B-FP8.
Untuk deployment dua node, 16-GPU kelas B300, jalankan node head dengan:
bash
export HEAD_ADDR="10.0.0.10"

vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --tensor-parallel-size 16 \
  --nnodes 2 \
  --node-rank 0 \
  --master-addr "$HEAD_ADDR" \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3
On the worker node, use the same topology with a different node rank and no API server:
bash
export HEAD_ADDR="10.0.0.10"

vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --tensor-parallel-size 16 \
  --nnodes 2 \
  --node-rank 1 \
  --master-addr "$HEAD_ADDR" \
  --headless \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3
Jangan menyalin contoh 16-GPU ini ke server H200 tanpa mengubah ukuran topologi. Varian FP8 yang sama saat ini diperkirakan 32× H200 dalam resep vLLM.
Cara Menjalankan Qwen 3.8 pada Satu Server 8× B300
Untuk NVIDIA Blackwell, konfigurasi model penuh yang paling praktis adalah NVFP4. vLLM saat ini memvalidasi NVFP4 W4A4 dengan tensor parallelism pada delapan GPU B300.
bash
vllm serve Inferact/Qwen3.8-2.4T-A95B-NVFP4 \
  --tensor-parallel-size 8 \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3 \
  --enable-auto-tool-choice \
  --tool-call-parser qwen3_coder
Build NVFP4 dari Inferact adalah checkpoint terkuantisasi, bukan artefak BF16 Qwen asli. Validasi kualitas model pada set penerimaan Anda sendiri sebelum memperlakukannya sebagai pengganti drop-in untuk BF16 atau FP8.
Cara Deploy Qwen 3.8 dengan SGLang
SGLang menambahkan dukungan Day-0 untuk Qwen3.8 pada 12 Agustus dan sangat menarik untuk serving throughput tinggi, prefix caching, expert parallelism, speculative decoding, serta disaggregasi prefill/decode.
bash
SGLANG_ENABLE_MOE_DEFERRED_FINALIZE=1 \
SGLANG_FLASHINFER_MNNVL_CUTEDSL_AR_FUSION=1 \
sglang serve \
  --trust-remote-code \
  --model-path RadixArk/Qwen3.8-2.4T-A95B-NVFP4 \
  --tp-size 8 \
  --context-length 200000 \
  --preferred-sampling-params '{"top_k": 20}' \
  --attention-backend trtllm_mha \
  --linear-attn-prefill-backend flashinfer \
  --linear-attn-decode-backend flashinfer \
  --reasoning-parser qwen3 \
  --tool-call-parser qwen3_coder \
  --host 0.0.0.0 \
  --port 30000
SGLang melaporkan 346 token keluaran/detik pada batch size 1 di TP8 B300 dengan MTP, dan throughput agregat yang jauh lebih tinggi pada layout serving yang didisagregasi. Perlakukan angka-angka tersebut sebagai pengukuran stack serving, bukan benchmark kualitas model.
Uji Endpoint Lokal yang Kompatibel dengan OpenAI
Baik vLLM maupun SGLang mengekspos API yang kompatibel dengan OpenAI, yang membuat integrasi aplikasi menjadi sederhana.
python
from openai import OpenAI

client = OpenAI(
    api_key="EMPTY",
    base_url="http://localhost:8000/v1",
    timeout=3600,
)

response = client.chat.completions.create(
    model="Qwen/Qwen3.8-2.4T-A95B-FP8",
    messages=[
        {
            "role": "user",
            "content": "Design a fault-tolerant Redis architecture for three regions."
        }
    ],
    temperature=1.0,
    top_p=0.95,
    max_tokens=8192,
)

print(response.choices[0].message.content)
Kartu model resmi merekomendasikan temperature=1.0, top_p=0,95, dan top_k=20 sebagai parameter sampling baseline. Untuk pekerjaan agentic, sisakan cukup anggaran output untuk reasoning alih-alih mengatur max_tokens hanya untuk jawaban akhir yang terlihat.
Aktifkan Jendela Konteks 1M
Checkpoint Qwen3.8-2.4T-A95B terbuka memiliki konteks native 262.144 token dan dapat diperluas hingga kira-kira 1,01M. Resep vLLM mendokumentasikan pola berikut:
bash
VLLM_ALLOW_LONG_MAX_MODEL_LEN=1 \
vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --max-model-len 1010000 \
  --hf-overrides '{"max_position_embeddings": 1010000}' \
  --reasoning-parser qwen3 \
  ...
Jangan menjadikan 1M sebagai default hanya karena didukung. Konteks maksimum yang lebih besar memesan lebih banyak kapasitas cache dan dapat secara tajam mengurangi konkurensi. Atur --max-model-len sesuai beban kerja yang nyata.
Bagaimana Meningkatkan Performa Inferensi Qwen3.8?
Gunakan MTP-3 untuk Mengurangi Latensi Pengguna Tunggal
Qwen3.8 menyertakan Multi-Token Prediction. Dalam pengukuran yang dipublikasikan vLLM, MTP-3 memindahkan output per pengguna dari 130 menjadi 307 tok/s untuk FP8 TP16 dan dari 133 menjadi 304 tok/s untuk NVFP4 TP8.
bash
--speculative-config '{"method":"mtp","num_speculative_tokens":3}'
Gunakan fastsafetensors untuk Startup yang Lebih Cepat
Untuk model skala terabita, waktu startup penting. Dalam satu pengukuran vLLM, pemuatan bobot turun dari 545 s menjadi 306 s dengan fastsafetensors dan lazy loading.
bash
--load-format fastsafetensors \
--safetensors-load-strategy lazy
Gunakan Expert Parallelism untuk Meningkatkan Throughput Konkuren
Untuk konkurensi tinggi, Qwen3.8 mendapatkan manfaat dari layout expert-parallel karena memiliki 512 routed experts. vLLM melaporkan hingga 3.200 total tok/s/GPU untuk FP8 EP dan hingga 4.300 total tok/s/GPU untuk konfigurasi NVFP4 DEP16 yang dioptimalkan.
Set --max-model-len untuk Menyeimbangkan VRAM dan Konkurensi
Setel --max-model-len ke urutan terpanjang yang benar-benar dibutuhkan beban kerja. Nilai yang lebih besar memesan lebih banyak kapasitas KV-cache, meningkatkan tekanan memori, dan dapat mengurangi jumlah permintaan konkuren bahkan ketika bobot model sudah muat.
Mulailah dengan persentil produksi yang representatif alih-alih konteks maksimum yang diiklankan model. Uji beban batas yang dipilih dengan presisi, pola batch, dan mesin serving yang sama yang digunakan di produksi, lalu naikkan hanya ketika permintaan nyata membutuhkan konteks lebih.
Deployment Lokal Qwen 3.8 Max vs. API
Open weights tidak otomatis membuat inferensi lokal ekonomis. Keputusan yang tepat bergantung pada utilisasi, residensi data, staffing, target ketersediaan, dan apakah Anda benar-benar membutuhkan fitur multimodal model terkelola.
| Dimensi | Self-hosted Qwen3.8-2.4T-A95B | Qwen3.8-Max via CometAPI |
|---|---|---|
| Infrastruktur | Server multi-GPU atau klaster | Tanpa infrastruktur GPU |
| Modality input | Teks | Teks, gambar, video |
| Konteks | 262K native; ~1,01M diperluas | 1M terkelola |
| Kontrol data | Maksimum | API cloud |
| Operasi | Anda memiliki monitoring, upgrade, dan HA | Dikelola oleh penyedia |
| Kesesuaian | Residensi data, utilisasi berkelanjutan, tim infra | Sebagian besar tim aplikasi dan beban variabel |
Jika Anda sudah memiliki akselerator yang sesuai dan utilisasi konsisten tinggi, self-hosting bisa dibenarkan. Jika Anda akan membeli klaster hanya untuk model ini, Qwen3.8-Max di CometAPI biasanya rute dengan friksi lebih rendah. Panduan API yang ada mencakup integrasi hosted, sementara panduan harga mencakup pemodelan biaya; karena itu artikel ini tetap fokus pada deployment lokal.
Masalah Umum Deployment Lokal Qwen 3.8
Server Kehabisan Memori GPU Saat Startup
Pertama kurangi --max-model-len jika cache yang menjadi masalah. Jika bobot itu sendiri tidak muat, pengurangan konteks tidak akan menyelesaikan akar masalah; beralih ke checkpoint presisi lebih rendah yang divalidasi atau tambahkan GPU.
Tensor Parallelism Gagal dengan Ukuran Tidak Valid
Qwen3.8 memiliki 64 attention head pada layer full attention-nya, jadi vLLM mewajibkan TP membagi 64. Ukuran TP yang langsung adalah 1, 2, 4, 8, 16, dan 32. VRAM agregat mentah saja tidak cukup untuk memilih topologi.
Server Membutuhkan Waktu Lama untuk Mulai
Memuat bobot satu hingga beberapa terabita plus kernel JIT dapat memakan waktu menit. Tingkatkan VLLM_ENGINE_READY_TIMEOUT_S dan probe endpoint inferensi nyata alih-alih mengasumsikan jendela startup pendek.
Model Lokal Tidak Dapat Memproses Gambar
Hal itu diharapkan. Yang checkpoint terbuka 2.4T bersifat teks saja
Qwen3.8-2.4T-A95B open checkpoint bersifat teks saja. Keterbatasan ini spesifik untuk Qwen3.8-2.4T-A95B. Qwen3.8-27B mendukung input visual ketika file proyeksi vision terpisahnya dimuat.
Konteks 1M Secara Dramatis Mengurangi Throughput
Kurangi --max-model-len ke urutan terpanjang yang benar-benar dibutuhkan beban kerja Anda. Jendela konteks terbesar yang didukung tidak selalu pengaturan produksi terbaik; pilih batas konteks yang menyeimbangkan kebutuhan beban kerja, penggunaan KV-cache, dan konkurensi.
Apakah Ollama atau LM Studio Dapat Menjalankan Qwen 3.8 Max?
Ekosistem dapat mengemas bobot Qwen3.8 yang sangat terkuantisasi untuk inferensi gaya llama.cpp, tetapi itu tidak boleh disamakan dengan workflow Ollama desktop normal. Build terkuantisasi yang memakan ratusan gigabita tetap membutuhkan ratusan gigabita memori yang dapat diakses dan melibatkan trade-off signifikan dalam kualitas dan performa.
Untuk pengembangan lokal biasa, Qwen3.8-27B adalah target yang tepat. Model 2,4T penuh harus diperlakukan sebagai model server/klaster bahkan ketika kuantisasi komunitas ekstrem membuatnya secara teknis bisa dijalankan pada perangkat keras yang tidak lazim.
Metode Deployment Mana yang Harus Anda Pilih?
Untuk NVIDIA Blackwell, deployment 8× B300 NVFP4 saat ini merupakan titik awal model penuh yang paling bersih. Untuk AMD, 8× MI355X dengan MXFP4 adalah konfigurasi praktis yang sesuai. Gunakan FP8 ketika Anda memprioritaskan provenance checkpoint dan kualitas dibanding ukuran infrastruktur, dan BF16 hanya ketika fidelitas maksimum membenarkan persyaratan memori skala multi-rack.
Untuk workstation, gunakan Qwen3.8-27B. Untuk tim aplikasi yang membutuhkan kapabilitas Max tanpa operasi klaster GPU, gunakan model Qwen3.8-Max yang dihosting di CometAPI.
Kesimpulan
Qwen3.8-Max telah melewati batas penting sejak peluncuran API awalnya: keluarga Qwen kelas Max kini memiliki checkpoint 2,4T terbuka yang dapat dioperasikan organisasi sepenuhnya di infrastruktur mereka sendiri.
Namun open weights tidak berarti perangkat keras konsumen. Jejak BF16 4,45 TiB, checkpoint FP8 2,27 TiB, dan varian FP4 1,3–1,5 TiB membuat Qwen3.8-2.4T-A95B menjadi salah satu model terbuka paling intensif infrastruktur yang tersedia. Sisi praktisnya adalah vLLM dan SGLang sudah mendukung arsitektur tersebut, dan FP4 membuat deployment satu node 8× B300 atau 8× MI355X menjadi layak.
Lakukan self-host ketika kontrol data, utilisasi berkelanjutan, dan kepemilikan infrastruktur membenarkan klaster. Jika tidak, gunakan Max API terkelola—atau Qwen3.8-27B ketika yang Anda inginkan sebenarnya adalah model Qwen yang kuat pada satu workstation.