
TL;DR
DeepSeek-V4.1-Flash bersifat open-weight dan dapat di-host sendiri, tetapi “lokal” tidak berarti “di PC gaming.” DeepSeek mendeskripsikannya sebagai kerangka Mixture-of-Experts 552B parameter dengan arsitektur Causal Encoder-Decoder, hanya 8B parameter aktif saat pemrosesan prompt dan 16B saat generasi. Model lengkap tetap menargetkan penerapan skala frontier.
Resep penyajian vLLM saat ini menempatkan checkpoint sekitar 511 GB di disk dan sekitar 614 GB VRAM minimum, sehingga server kelas 8×H200 atau sistem memori-tinggi sebanding jauh lebih realistis daripada workstation konsumen.
Untuk tim yang hanya membutuhkan akses alih-alih kontrol level bobot, DeepSeek V4.1 Flash API di CometAPI jauh lebih sederhana dibandingkan mengelola server inferensi multi-GPU.
Poin Utama
- DeepSeek-V4.1-Flash menggunakan backbone MoE 552B dengan 8B parameter aktif saat prefill dan 16B saat decode; parameter aktif tidak mewakili kebutuhan memori residen.
- Jendela konteks 1,048,576 token dan cache KV global 890 byte per token mengurangi tekanan cache, tetapi bobot model tetap mendominasi perencanaan kapasitas.
- Checkpoint resmi sekitar 511 GB di disk. Resep vLLM memperkirakan sekitar 614 GB VRAM agregat yang dapat digunakan sebagai anggaran minimum untuk memuat model dan overhead runtime; ini adalah perkiraan dasar, bukan jaminan untuk setiap ukuran batch, panjang konteks, atau konfigurasi multimodal.
- vLLM adalah jalur penyajian produksi paling jelas, sementara SGLang menargetkan inferensi terdistribusi tingkat lanjut; rute Ollama saat ini berbasis cloud alih-alih inferensi lokal penuh.
- Self-hosting paling menarik untuk privasi, operasi air-gapped, riset pada level bobot, atau utilisasi klaster berkelanjutan; sebagian besar pengembang akan menemukan API hosted lebih sederhana.
Apa itu DeepSeek-V4.1-Flash? Arsitektur, Parameter, dan Ukuran Model
DeepSeek secara resmi merilis V4.1-Flash pada 10 September 2026 sebagai model terkecil dalam keluarga arsitektur barunya, dengan pemahaman visual native. Terlepas dari nama “Flash”, ini bukan model dense kecil.
Perubahan arsitektural utamanya adalah desain Causal Encoder-Decoder (CED). Model membagi komputasi secara asimetris antara pemasukan prompt dan generasi token, mengurangi komputasi aktif sembari mempertahankan kumpulan pakar yang sangat besar.
| Specification | DeepSeek-V4.1-Flash |
|---|---|
| Architecture | MoE multimodal dengan Causal Encoder-Decoder |
| Backbone parameters | 552B |
| Active parameters, input | 8B |
| Active parameters, output | 16B |
| Transformer layers | 40: 20 encoder + 20 decoder |
| Context window | 1,048,576 tokens |
| Global KV cache | 890 bytes/token |
| Modalities | Input teks + gambar, output teks |
| Weight license | MIT |
| Recommended sampling | Temperatur 1.0; top_p 0.95 atau 1.0 |
| Official weights | Hugging Face |
| Primary local serving options | vLLM, SGLang, DeepSeek reference inference |
Pembedaan antara parameter aktif dan parameter residen sangat penting. Perutean MoE mengurangi jumlah komputasi yang digunakan untuk setiap token, tetapi server tetap perlu mengakses bobot pakar yang bisa dipilih. Itulah sebabnya model “8B aktif” masih dapat memerlukan ratusan gigabita penyimpanan dan memori akselerator.
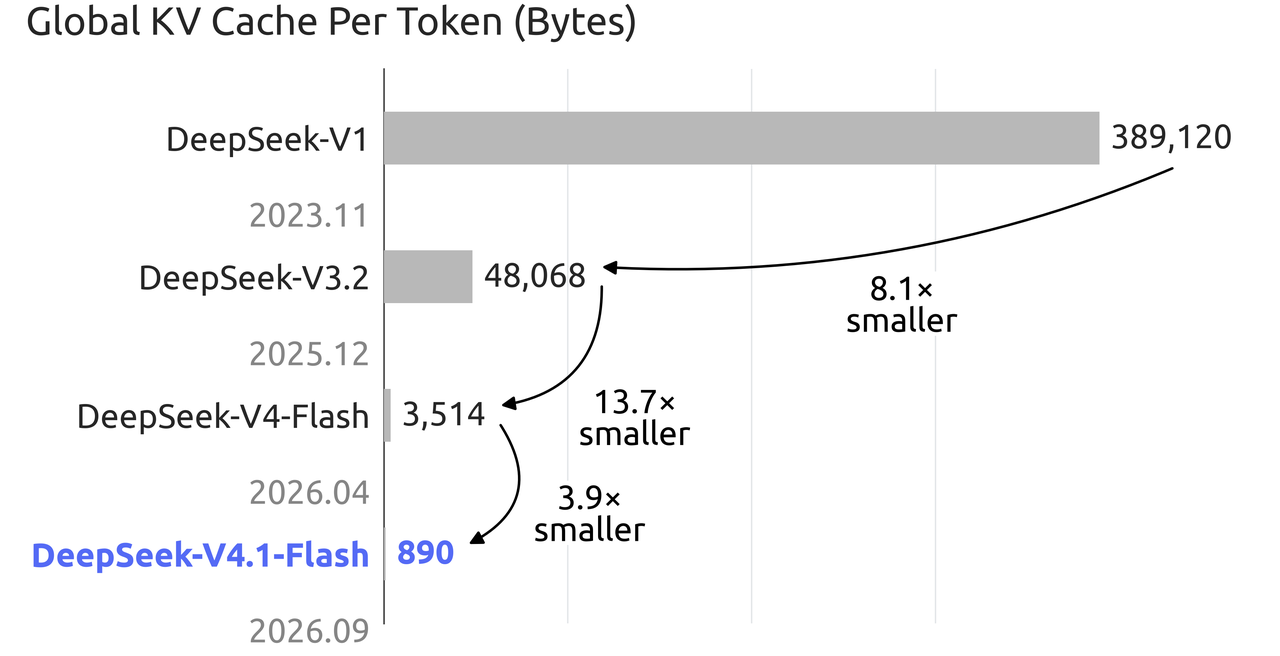
Bagan cache KV resmi DeepSeek menunjukkan cache global turun dari 3,514 byte per token pada V4 Flash menjadi 890 byte per token pada V4.1 Flash, pengurangan sekitar 3,9×. Itu penting untuk inferensi sejuta token, tetapi tidak menghilangkan kebutuhan memori yang jauh lebih besar yang diciptakan oleh bobot model itu sendiri.
Seberapa Baik DeepSeek-V4.1-Flash Sebelum Anda Menerapkannya?
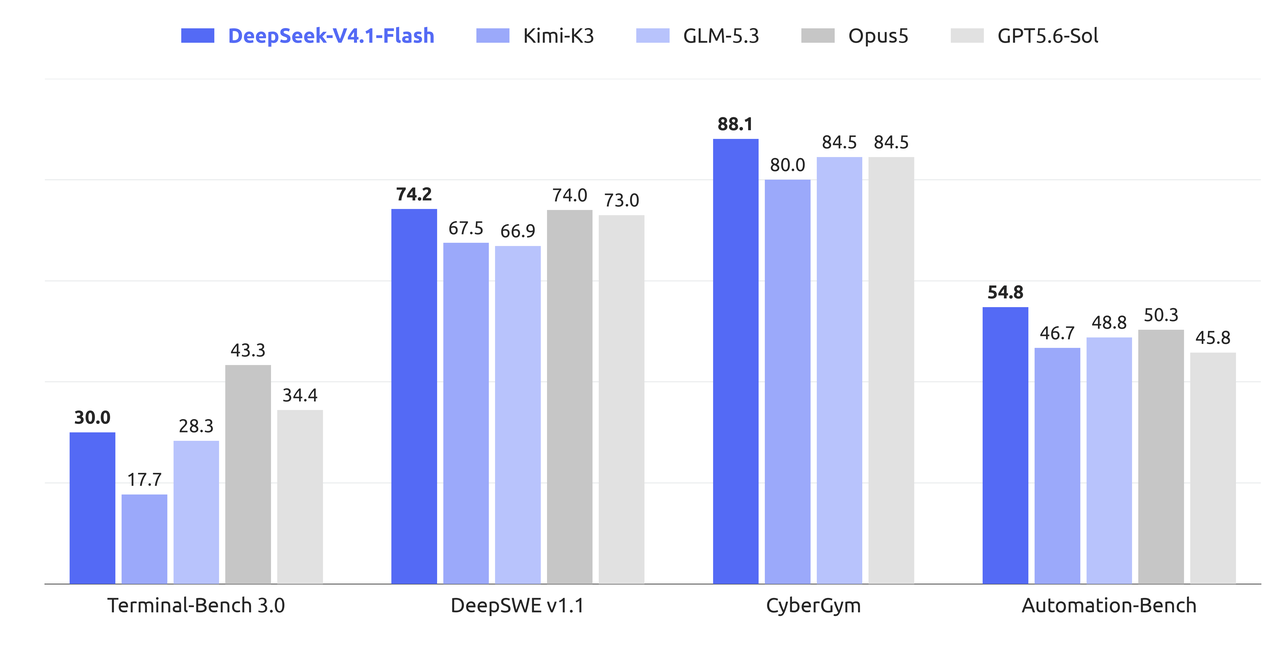
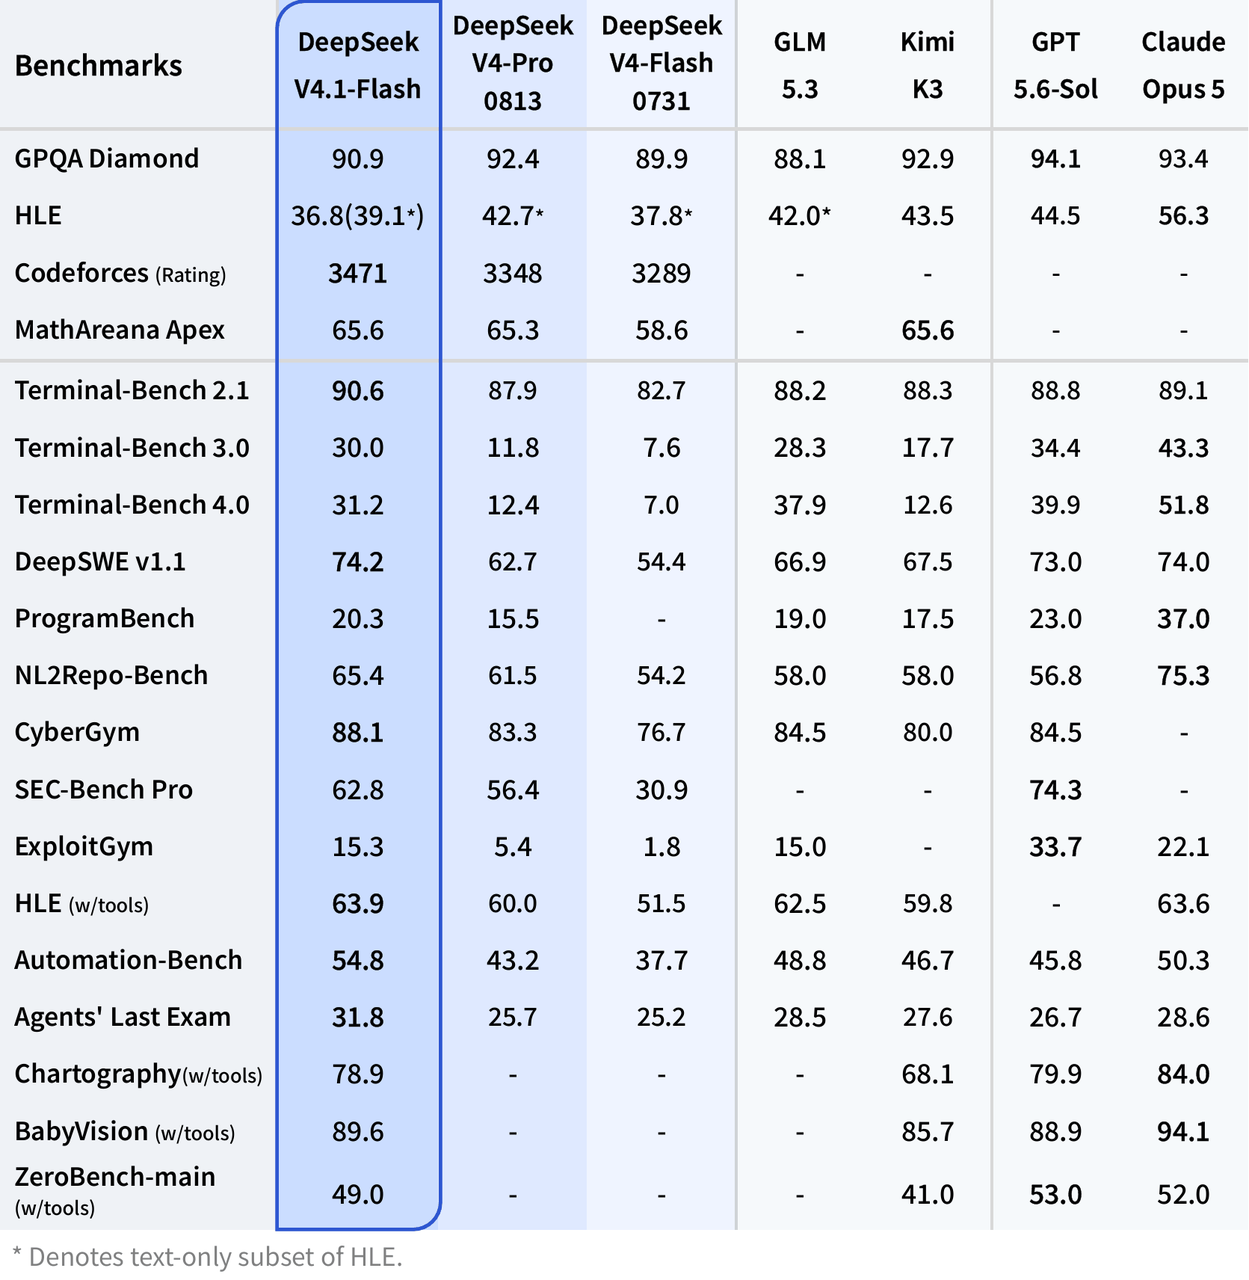
Tabel benchmark yang dipublikasikan DeepSeek memposisikan V4.1-Flash terutama sebagai peningkatan besar dalam coding agen, operasi terminal, otomatisasi, dan beban kerja rekayasa perangkat lunak. Ini adalah hasil benchmark yang dilaporkan vendor, jadi harus diperlakukan sebagai pengukuran referensi, bukan kinerja aplikasi yang dijamin.
Untuk reprodusibilitas, kartu model resmi merekomendasikan temperatur 1.0 dan top_p 0.95, sementara upaya penalaran dan anggaran token bervariasi menurut evaluasi. Angka-angka di bawah ini adalah hasil referensi yang dijalankan vendor, bukan jaminan kinerja netral perangkat keras; detail harness khusus benchmark harus dirujuk sebelum mereproduksinya.
| Benchmark | DeepSeek V4.1 Flash | DeepSeek V4 Pro 0813 | DeepSeek V4 Flash 0731 |
|---|---|---|---|
| GPQA Diamond | 90.9 | 92.4 | 89.9 |
| Codeforces Rating | 3471 | 3348 | 3289 |
| MathArena Apex | 65.6 | 65.3 | 58.6 |
| Terminal-Bench 2.1 | 90.6 | 87.9 | 82.7 |
| Terminal-Bench 3.0 | 30.0 | 11.8 | 7.6 |
| Terminal-Bench 4.0 | 31.2 | 12.4 | 7.0 |
| DeepSWE v1.1 | 74.2 | 62.7 | 54.4 |
| NL2Repo-Bench | 65.4 | 61.5 | 54.2 |
| CyberGym | 88.1 | 83.3 | 76.7 |
| Automation-Bench | 54.8 | 43.2 | 37.7 |
| Agents' Last Exam | 31.8 | 25.7 | 25.2 |
Pola lebih penting daripada skor tunggal mana pun. V4.1-Flash tidak memimpin setiap benchmark, tetapi lonjakan dari V4 Flash 0731 sangat besar pada Terminal-Bench, DeepSWE, otomatisasi, dan beban kerja keamanan siber. Ini membuat penerapan lokal sangat relevan untuk agen coding privat, analisis berskala repositori, otomatisasi internal, dan infrastruktur agen air-gapped.
Bisakah Anda Benar-benar Menjalankan DeepSeek-V4.1-Flash Secara Lokal?
Ya, tetapi kata “lokal” perlu kualifikasi. Resep DeepSeek-V4.1-Flash vLLM terbaru mengurai checkpoint sekitar setengah terabita dan merekomendasikan anggaran VRAM yang jauh lebih besar setelah memasukkan overhead runtime.
| Component | Approximate stored size |
|---|---|
| Routed + DSpark experts | 259.5 GiB |
| Engram tables | 183.1 GiB |
| Attention, dense projections and routers | 6.9 GiB |
| Embeddings, LM head and norms | 3.9 GiB |
| UE8M0 block scales | 21.9 GiB |
| Full checkpoint | ~476 GiB / ~511 GB |
| vLLM recommended minimum VRAM budget | ~614 GB |
Kejutan utamanya adalah V4.1-Flash sudah sangat terkompresi secara internal. Bobot pakar yang dirouting menggunakan format presisi rendah, sehingga checkpoint resmi bukan sekadar model BF16 besar yang menunggu konversi 4-bit yang mudah.
Persyaratan Perangkat Keras DeepSeek-V4.1-Flash
| Konfigurasi perangkat keras | Status praktis | Komentar |
|---|---|---|
| 1× RTX 4090 / 5090 | Tidak | Jauh di bawah jejak memori model |
| 2–4 GPU konsumen | Tidak untuk checkpoint penuh resmi | VRAM agregat tetap tidak mencukupi |
| Workstation 128 GB | Tidak | Parameter aktif tidak menentukan memori bobot residen |
| Workstation 256 GB | Tidak untuk jalur penyajian resmi | Masih jauh di bawah jejak checkpoint resmi |
| RAM 512 GB + offload ke GPU | Eksperimental | Wilayah komunitas/offload, tidak setara dengan penyajian produksi terverifikasi |
| 4× GPU pusat data memori-tinggi | Bergantung pada perangkat keras | Mungkin dengan akselerator modern yang cukup besar; cek resep runtime |
| 8× H200 | Ya, kelas yang terdokumentasi | Sekitar 1,128 GB HBM agregat |
| Sistem kelas GB200 NVL4 | Ya | vLLM menyebut baki 768 GB sebagai muat untuk model |
Penting: 8B parameter aktif bukan berarti 8 GB VRAM. “Aktif” menggambarkan seberapa banyak jaringan MoE berpartisipasi dalam komputasi token. Seluruh set pakar tetap harus disimpan di tempat yang dapat diakses mesin inferensi.
Runtime Mana yang Sebaiknya Anda Gunakan untuk DeepSeek-V4.1-Flash?
| Runtime | Status V4.1-Flash saat ini | Penggunaan terbaik |
|---|---|---|
| vLLM | Resep penerapan saat ini tersedia; image terbaru diperlukan | Penyajian produksi kompatibel OpenAI |
| SGLang | Didukung melalui build penerapan DeepSeek-V4.1 saat ini | Inferensi terdistribusi berkinerja tinggi |
| DeepSeek reference inference | Implementasi referensi TP8 resmi | Riset arsitektur dan validasi |
| Transformers | Integrasi model tersedia di Hugging Face | Pengembangan dan eksperimen; perangkat keras tetap diperlukan |
| Ollama | Rute pustaka resmi saat ini menggunakan :cloud | Pemanggilan cloud yang praktis, tidak setara dengan self-hosting |
Untuk self-hosting produksi, vLLM saat ini merupakan titik awal paling jelas. Panduan penerapan SGLang menyediakan jalur lain yang didukung untuk inferensi terdistribusi tingkat lanjut.
Cara Menjalankan DeepSeek-V4.1-Flash Secara Lokal dengan vLLM
Ini adalah rute praktis untuk server Linux multi-GPU.
Semua contoh perintah di bawah ini diformat ulang sebagai blok kode spesifik bahasa dengan deskripsi singkat dalam bahasa Inggris.
Langkah 1: Periksa Lingkungan Anda
- Linux.
- Docker.
- NVIDIA Container Toolkit.
- Beberapa ratus gigabita ruang SSD kosong.
- Konfigurasi multi-GPU yang didukung.
- Sekitar 614 GB memori akselerator agregat yang dapat digunakan untuk profil penyajian bobot resmi saat ini.
- Jaringan cepat jika model belum di-cache secara lokal.
Langkah 2: Unduh Bobot DeepSeek-V4.1-Flash
Bobot resmi dihosting di repositori Hugging Face DeepSeek-V4.1-Flash di bawah lisensi MIT.
python -m pip install -U huggingface_hub
hf download deepseek-ai/DeepSeek-V4.1-Flash
Pastikan sistem berkas yang menampung ~/.cache/huggingface memiliki ruang kosong jauh lebih dari 511 GB. Berkas sementara dan artefak mesin tambahan dapat meningkatkan penggunaan puncak disk.
Langkah 3: Mulai DeepSeek-V4.1-Flash dengan vLLM
Menurut resep vLLM saat ini, dukungan DeepSeek-V4.1 memerlukan image vLLM yang cukup baru. Konfigurasi awal delapan GPU khusus teks dapat terlihat seperti ini:
docker run --rm \
  --gpus all \
  --ipc=host \
  -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -e VLLM_ENGINE_READY_TIMEOUT_S=3600 \
  vllm/vllm-openai:nightly \
  deepseek-ai/DeepSeek-V4.1-Flash \
  --host 0.0.0.0 \
  --port 8000 \
  --tensor-parallel-size 8 \
  --language-model-only \
  --tokenizer-mode deepseek_v41 \
  --tool-call-parser deepseek_v41 \
  --reasoning-parser deepseek_v41 \
  --enable-auto-tool-choice \
  --gpu-memory-utilization 0.90 \
  --max-model-len 131072
Ada dua pilihan yang disengaja di sini. Pertama, --language-model-only menonaktifkan encoder visi untuk beban kerja khusus teks. Kedua, memulai pada 131,072 token lebih aman daripada langsung mengaktifkan jendela konteks satu juta token penuh. Setelah server stabil, Anda dapat meningkatkannya:
--max-model-len 1048576
Pengaturan tensor-parallel yang tepat bergantung pada topologi akselerator, jadi jangan menyalin --tensor-parallel-size 8 begitu saja ke setiap server.
Langkah 4: Uji Endpoint DeepSeek-V4.1-Flash Lokal
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4.1-Flash",
    "messages": [
      {
        "role": "user",
        "content": "What is 17 * 19? Return only the integer."
      }
    ]
  }'
323
Langkah 5: Panggil Server DeepSeek-V4.1-Flash Lokal Anda dengan Python
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local"
)

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4.1-Flash",
    messages=[
        {
            "role": "user",
            "content": "Explain the difference between TCP and UDP in three bullets."
        }
    ],
    temperature=1.0,
    top_p=0.95
)

print(response.choices[0].message.content)
Bagaimana Mengaktifkan Mode Berpikir DeepSeek-V4.1-Flash Secara Lokal?
V4.1-Flash mendukung kontrol penalaran eksplisit melalui chat template-nya. Salah satu contohnya:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local"
)

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4.1-Flash",
    messages=[
        {
            "role": "user",
            "content": "Find the most efficient algorithm for this scheduling problem."
        }
    ],
    extra_body={
        "chat_template_kwargs": {
            "thinking": True,
            "reasoning_effort": 50
        }
    }
)

print(response.choices[0].message.content)
Jika model tampak mengembalikan sedikit atau tidak ada konten final dengan nilai max_tokens kecil, periksa apakah mode berpikir menghabiskan anggaran generasi sebelum menganggap penerapan rusak.
Bagaimana Menjalankan DeepSeek-V4.1-Flash dengan Kode Referensi?
DeepSeek juga menyertakan implementasi inferensi TP8 minimal di dalam repositori model. Ini terutama dimaksudkan sebagai kode referensi yang mudah dibaca, bukan server produksi throughput tinggi.
cd inference
python -m pip install -r requirements.txt
export HF_CKPT_PATH=/path/to/DeepSeek-V4.1-Flash-HF
export SAVE_PATH=/path/to/DeepSeek-V4.1-Flash-TP8
export MP=8

python convert.py \
  --hf-ckpt-path "${HF_CKPT_PATH}" \
  --save-path "${SAVE_PATH}" \
  --model-parallel "${MP}" \
  --expert-dtype fp4 \
  --tokenizer-path "${HF_CKPT_PATH}"
export CKPT_PATH=/path/to/DeepSeek-V4.1-Flash-TP8
export MP=8

torchrun --nproc-per-node "${MP}" generate.py \
  --ckpt-path "${CKPT_PATH}" \
  --config config.json \
  --interactive \
  --temperature 0.6
Rute ini berguna untuk menelaah CED, perutean MoE, memori Engram, speculative decoding, dan detail implementasi terkait. Untuk penyajian produksi normal, vLLM atau SGLang lebih mudah dioperasikan.
Bisakah Anda Menjalankan DeepSeek-V4.1-Flash Secara Lokal dengan Ollama?
Tidak dalam arti yang sama seperti menjalankan model Ollama 7B atau 32B biasa. Ollama saat ini mengekspos V4.1-Flash melalui:
ollama run deepseek-v4.1-flash:cloud
Bagian pentingnya adalah :cloud. Entri pustaka Ollama saat ini menggunakan rute cloud, sehingga perintah ini tidak setara dengan mengunduh model lengkap dan melakukan inferensi sepenuhnya di mesin Anda.
Penempatan Lokal DeepSeek-V4.1-Flash vs API: Mana yang Lebih Masuk Akal?
| Dimension | Local DeepSeek-V4.1-Flash | Hosted API |
|---|---|---|
| Up-front hardware | Sangat tinggi | Tidak ada |
| Accelerator memory | ~614 GB target resmi yang praktis | Dikelola oleh penyedia |
| Model control | Penuh | Terbatas |
| Data stays on premises | Ya | Tidak |
| Weight modification | Ya | Tidak |
| Maintenance | Tanggung jawab Anda | Dikelola penyedia |
| Setup complexity | Tinggi | Rendah |
| Scaling | Memerlukan infrastruktur | Berbasis API |
| Best for | Air-gapped, privat, riset, klaster berutilisasi tinggi | Sebagian besar pengembang dan aplikasi produksi |
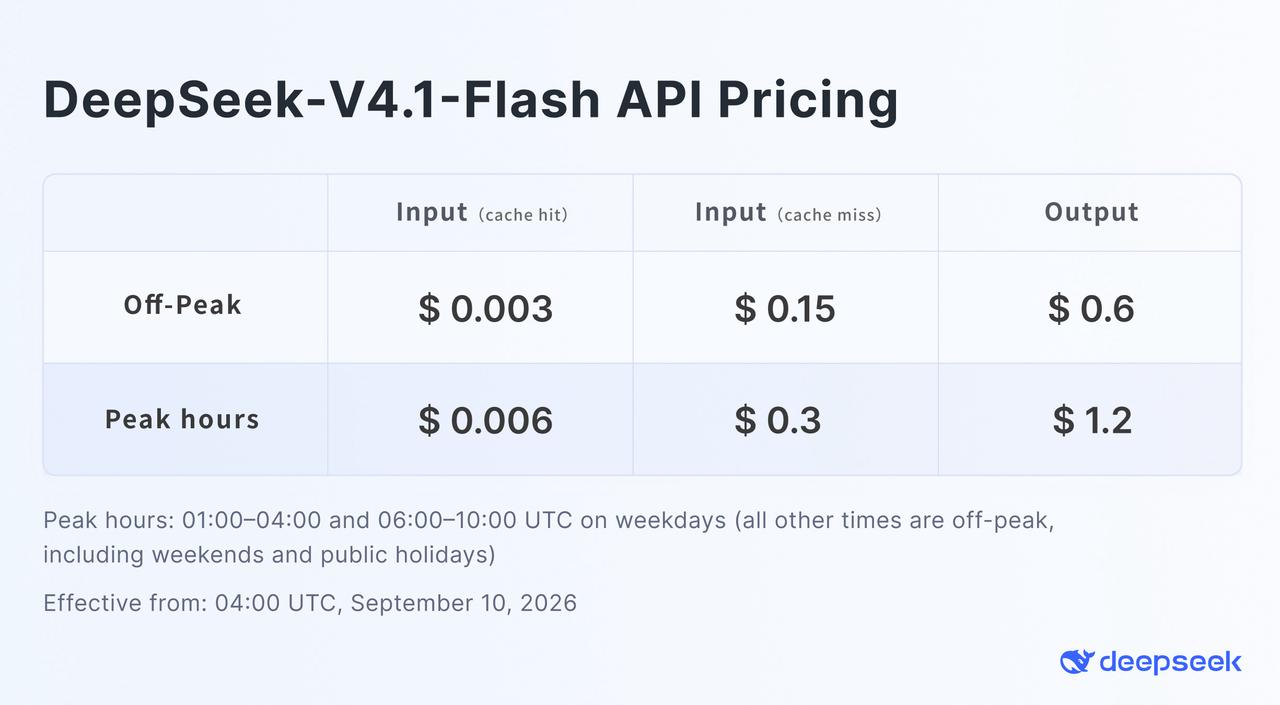
Harga off-peak resmi DeepSeek ditampilkan dalam grafik harga V4.1-Flash. Bagi pengembang yang tidak membutuhkan kepemilikan fisik bobot, DeepSeek V4.1 Flash API di CometAPI menyediakan alternatif yang kompatibel dengan OpenAI. Contoh berikut menggunakan pengenal model CometAPI. Ini bukan pengenal yang digunakan oleh API resmi DeepSeek.
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1"
)

response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Review this Python function and identify possible race conditions."
        }
    ]
)

print(response.choices[0].message.content)
Keputusan praktisnya jelas: penerapan lokal menjadi menarik ketika privasi, operasi air-gapped, eksperimen level bobot, utilisasi berat yang dapat diprediksi, atau persyaratan regulasi melebihi biaya infrastruktur. Untuk pengembangan aplikasi biasa, endpoint hosted menghindari ratusan gigabita manajemen model dan orkestrasi multi-GPU.
Masalah Apa yang Dapat Anda Temui Saat Menjalankan DeepSeek-V4.1-Flash Secara Lokal?
Server kehabisan memori sebelum generasi dimulai
Checkpoint penuh, bukan angka 8B/16B parameter aktif, yang menentukan sebagian besar kebutuhan memori. Periksa tensor parallelism, pemanfaatan memori GPU, pemuatan visi, dan HBM yang tersedia.
DeepSeek-V4.1-Flash membutuhkan waktu lama untuk mulai
Checkpoint setengah terabita memerlukan waktu untuk diunduh, dipetakan, diinisialisasi, dan dipecah (shard). Waktu tunggu kesiapan mesin yang lama adalah hal normal untuk kelas model ini.
Respons kosong atau berakhir dengan finish_reason=length
Mode berpikir mungkin menghabiskan anggaran generasi. Tingkatkan max_tokens, turunkan upaya penalaran, atau nonaktifkan mode berpikir untuk permintaan sederhana.
Panggilan alat tidak terurai dengan benar
Pastikan server menggunakan tokenizer DeepSeek V4.1, parser tool-call, parser penalaran, dan flag auto-tool-choice.
Input visi tidak berfungsi
Jika Anda meluncurkan dengan --language-model-only, Anda sengaja menonaktifkan encoder visual. Mulai ulang dengan dukungan multimodal diaktifkan sebelum menguji gambar.
Haruskah Anda Menjalankan DeepSeek-V4.1-Flash Secara Lokal?
DeepSeek-V4.1-Flash sangat menarik dari perspektif self-hosting karena arsitekturnya secara substansial mengurangi komputasi per token dan biaya cache KV, tetapi tidak mengubah model open-weight skala frontier menjadi model desktop.
Untuk laboratorium riset, platform AI perusahaan, tumpukan agen coding privat, atau lingkungan air-gapped, vLLM dan SGLang membuat self-hosting secara teknis realistis. Bagi pengembang dengan satu atau dua GPU, ini bukan target penerapan model penuh yang praktis. Dalam kasus tersebut, menggunakan DeepSeek V4.1 Flash melalui CometAPI memberikan akses ke model tanpa menjadikan penyajian sebagai proyek infrastruktur besar.
FAQ
Apakah DeepSeek-V4.1-Flash bersifat open source?
Bobot model dan repositorinya dirilis di bawah lisensi MIT, yang memungkinkan penggunaan, modifikasi, dan redistribusi luas sesuai ketentuan lisensi.
Bisakah saya menjalankan DeepSeek-V4.1-Flash di RTX 4090 atau RTX 5090?
Tidak untuk model penuh resmi. Satu GPU konsumen hanya memiliki sebagian kecil dari memori yang dibutuhkan oleh checkpoint penuh.
Apakah 8B parameter aktif berarti DeepSeek-V4.1-Flash hanya membutuhkan 8 GB VRAM?
Tidak. Angka 8B menggambarkan parameter yang berpartisipasi selama pemrosesan prompt. Jaringan pakar lengkap dan state pendukung tetap harus disimpan dan dapat diakses.
Berapa banyak VRAM yang dibutuhkan DeepSeek-V4.1-Flash?
Resep vLLM saat ini menggunakan sekitar 614 GB sebagai angka perencanaan untuk checkpoint resmi plus overhead runtime. Kebutuhan aktual bervariasi dengan perangkat keras, ukuran batch, konteks, dukungan visi, dan konfigurasi penyajian.
Seberapa besar DeepSeek-V4.1-Flash di disk?
Uraian vLLM saat ini menempatkan checkpoint sekitar 476 GiB, atau sekitar 511 GB.
Bisakah DeepSeek-V4.1-Flash menjalankan konteks 1M-token secara lokal?
Arsitektur mendukung hingga 1,048,576 token, tetapi penggunaan memori praktis juga bergantung pada ukuran batch, buffer runtime, state visi, dan overhead lainnya.
Bisakah saya menjalankan DeepSeek-V4.1-Flash secara lokal dengan Ollama?
Entri Ollama saat ini menggunakan rute :cloud, yang tidak sama dengan menjalankan bobot lengkap sepenuhnya di mesin Anda sendiri.
Apakah vLLM atau SGLang lebih baik untuk DeepSeek-V4.1-Flash?
Keduanya menargetkan penyajian berkinerja tinggi. vLLM saat ini memiliki resep khusus V4.1 yang sangat terperinci, sementara SGLang juga cocok untuk penerapan terdistribusi tingkat lanjut.
Apa cara termudah menggunakan DeepSeek-V4.1-Flash tanpa perangkat keras lokal?
Gunakan API hosted. DeepSeek menyediakan API-nya sendiri, sementara CometAPI menyediakan endpoint DeepSeek-V4.1-Flash yang kompatibel dengan OpenAI bersama model AI lainnya.