Bangun dengan CometAPIButuh satu API untuk banyak model?Uji alur kerja di Playground, lalu buat API key saat model dan biayanya sesuai dengan use case Anda.
Cara Meng-deploy Kimi K3.1 Pro Secara Lokal: Persyaratan Perangkat Keras, Penyiapan vLLM
Pelajari cara melakukan hosting mandiri Kimi K3.1 Pro dengan vLLM, memeriksa persyaratan GPU, mengunduh bobot model, menguji inferensi, dan membandingkan penyebaran lokal dengan akses API.
Sebarkan Kimi K3.1 Pro pada server GPU Linux, lalu hubungkan aplikasi lokal ke endpoint inferensinya. Panduan ini menggunakan satu node NVIDIA B300 delapan-GPU dengan vLLM. Anda memerlukan akses shell ke server, driver yang kompatibel, dan penyimpanan untuk checkpoint lengkap. Mulailah dengan menyelesaikan satu permintaan teks pendek sebelum menguji input yang lebih panjang atau alur kerja agen.
Tanpa GPU yang sesuai, Anda dapat menjalankan aplikasi secara lokal dan menghubungkannya ke Kimi API resmi atau penyedia pihak ketiga seperti CometAPI.
Poin Utama
104B parameter aktif model tidak mencerminkan keseluruhan kebutuhan penyimpanannya.
Kompatibilitas perangkat keras mencakup memori GPU, interkoneksi, dukungan kuantisasi, dan kernel inferensi.
Ditinjau untuk kejelasan, atribusi sumber, dan terminologi API terkini.
Hasil benchmark yang kuat membuat model layak diuji, namun tidak menjamin performa setara dalam aplikasi Anda.
Endpoint inferensi yang berfungsi tidak otomatis menyertakan peramban, sandbox kode, atau runtime agen yang lengkap.
Bandingkan self-hosting dan akses API berdasarkan biaya per tugas yang berhasil, termasuk percobaan ulang dan pemeliharaan.
Apa itu Kimi K3.1 Pro?
Kimi K3.1 Pro adalah model multimodal open-weight dari Moonshot AI untuk pengodean, analisis dokumen, dan penggunaan alat. Spesifikasi utamanya tercantum di bawah, berdasarkan model card resmi .
Model mengaktifkan 104B parameter per token, tetapi penyebaran tetap membutuhkan checkpoint penuh 2.8T parameter. Mesin inferensi juga harus mendukung lapisan KDA dan Gated DSA serta kuantisasi MXFP4.
Perangkat keras apa yang Anda perlukan untuk menjalankan Kimi K3.1 Pro secara lokal?
Tabel di bawah merangkum konfigurasi vLLM yang relevan untuk panduan ini. Panduan ini menggunakan satu node B300 delapan-GPU; penyebaran GB300 dan AMD memerlukan konfigurasi masing-masing.
Perangkat keras
Rute terdokumentasi
Catatan perencanaan
NVIDIA B300
Satu node delapan GPU, TP8
Dasar untuk panduan di bawah
NVIDIA GB300
Delapan GPU di dua tray, TP8
Memerlukan konfigurasi multi-node dan penyiapan interkoneksi
AMD MI355X
Node delapan GPU dengan konfigurasi khusus AMD
Gunakan jalur ROCm/AITER; jangan gunakan ulang pengaturan lingkungan NVIDIA
Satu GPU konsumen 24–32 GB
Tidak cukup untuk memuat checkpoint penuh secara langsung
Bukan target yang praktis untuk tutorial ini
Untuk skala saja, 2.8T parameter akan menempati sekitar 5,6 TB pada BF16, 2,8 TB pada delapan bit, atau 1,4 TB pada empat bit yang diidealkan. Ini adalah perhitungan penyimpanan parameter mentah, bukan ukuran checkpoint aktual atau minimum VRAM runtime. Presisi campuran dan metadata mengubah ukuran file; cache dan alokasi runtime meningkatkan kebutuhan penyajian.
Cadangkan kapasitas NVMe untuk unduhan lengkap, file sementara, dan salinan rollback. Pada sistem multi-node, validasi komunikasi sebelum memuat model.
Cara menyebarkan Kimi K3.1 Pro
Gunakan self-hosting jika Anda memiliki perangkat keras yang sesuai; jika tidak, mulai dengan API ter-host. Langkah-langkah di bawah menggunakan vLLM, dengan SGLang sebagai alternatif di akhir bagian ini. Bandingkan biaya hosting setelah Anda memiliki permintaan yang berfungsi.
Jalankan perintah penyiapan, unduhan, peluncuran, dan verifikasi awal di shell Bash pada server GPU. Jika Anda bekerja dari laptop, sambungkan ke server tersebut dengan SSH terlebih dahulu. Klien Python nantinya dapat berjalan di salah satu mesin menggunakan instruksi koneksi di bawah.
Panduan ini mengikuti resep penyebaran resmi; belum diuji secara independen untuk artikel ini.
1. Periksa visibilitas GPU, penyimpanan, dan konektivitas
Mulai dengan pemeriksaan infrastruktur dasar:
nvidia-smi
nvidia-smi topo -m
df -h
Konfirmasikan bahwa semua GPU target terlihat dan direktori model memiliki ruang yang cukup. Anggarkan penyimpanan tambahan untuk cache unduhan, log, dan versi checkpoint di masa mendatang.
Untuk penyebaran multi-node, verifikasi komunikasi antar node sebelum mencoba memulai model.
Pertahankan tonggak pertama tetap sempit: muat checkpoint dan selesaikan satu permintaan teks pendek. Ini membuat kegagalan lebih mudah didiagnosis.
2. Siapkan lingkungan penyajian
Gunakan host Linux dengan delapan GPU B300 untuk contoh node tunggal ini. Dalam lingkungan CUDA yang kompatibel dengan resep yang dipublikasikan, buat lingkungan terisolasi dan instal alat penyajian:
Batas minimal versi tidak menjamin kompatibilitas dengan setiap driver atau wheel. Jika resep perangkat keras memerlukan container atau build khusus, gunakan lingkungan tersebut. Pin versi yang berhasil diuji sebelum produksi.
3. Unduh checkpoint lengkap
Instal CLI Hugging Face dan unduh repositori model:
Simpan file konfigurasi, tokenizer, processor, dan indeks bobot bersama pecahan bobot. Menyalin hanya file tensor tertentu dapat membuat penyebaran tidak lengkap.
Untuk penyebaran produksi yang dapat direplikasi, catat dan pin revisi repositori yang Anda validasi. Tinjau lisensi khusus repositori sebelum penggunaan komersial.
Setelah menyiapkan lingkungan, gunakan perintah dasar berikut. Ini memulai paralelisme tensor delapan arah dan membatasi jendela konteks awal ke 32.768 token:
Nama kimi-local adalah alias yang menghadap aplikasi. Gunakan nama yang sama dalam permintaan berikutnya.
Pengaturan 32.768 token adalah titik awal konservatif untuk panduan ini, bukan konteks maksimum yang didukung model.
Opsi --trust-remote-code mengizinkan kode repositori khusus untuk dimuat. Pasangkan dengan revisi checkpoint yang ditinjau dan dipin.
Di sini, 127.0.0.1 mengacu pada mesin yang menjalankan klien. Pemeriksaan curl di bawah berjalan pada server GPU, di mana mereka mencapai proses inferensinya. Untuk menggunakan klien Python dari laptop Anda, buka tunnel SSH di terminal laptop terpisah dan biarkan berjalan:
ssh -N -L 8000:127.0.0.1:8000 user@gpu-server
Ganti user@gpu-server dengan login SSH dan alamat server Anda. Dengan tunnel ini terbuka, klien laptop dapat menggunakan http://127.0.0.1:8000/v1. Jika port 8000 sudah digunakan di laptop, pilih port lokal lain dan perbarui URL klien.
finish_reason yang menunjukkan apakah generasi selesai atau mencapai batasnya.
Kesalahan memori GPU atau operasi yang tidak didukung.
Penalaran dapat mengonsumsi sebagian dari anggaran generasi. Jika permintaan mencapai batasnya sebelum menghasilkan jawaban akhir, tingkatkan anggaran dan coba lagi sebelum menyimpulkan bahwa server rusak.
6. Hubungkan aplikasi Python lokal
python -m pip install openai
from openai import OpenAI

client = OpenAI(
    base_url="http://127.0.0.1:8000/v1",
    api_key="EMPTY",
    timeout=300.0,
    max_retries=1,
)
response = client.chat.completions.create(
    model="kimi-local",
    messages=[{"role": "user", "content": "Write a Python function that removes duplicate filenames while preserving order."}],
    reasoning_effort="low",
    max_tokens=2048,
)
print(response.choices[0].message.content)
print(response.choices[0].finish_reason)
EMPTY adalah placeholder untuk server loopback saja tanpa autentikasi API-key. Gunakan kredensial yang Anda konfigurasi untuk endpoint yang diautentikasi. Validasi input gambar dan eksekusi alat secara terpisah sebelum menghubungkan agen.
Alternatif SGLang
Untuk SGLang, gunakan cookbook spesifik perangkat keras resmi. Pilih B300, Unified, dan Low-Latency (TP8) untuk kecocokan terdekat dengan panduan node tunggal ini. Periksa status verifikasi yang ditampilkan; konfigurasi yang dihasilkan tidak selalu konfigurasi yang telah diuji.
Di server GPU, instal Docker dan konfigurasikan NVIDIA Container Toolkit, lalu buat container dengan checkpoint yang diunduh dipasang di /models/Kimi-K3.1-Pro. Hentikan vLLM terlebih dahulu agar kedua mesin tidak bersaing untuk GPU yang sama.
Di dalam container, tempel perintah peluncuran lengkap yang dihasilkan oleh cookbook untuk konfigurasi yang Anda pilih. Ganti path modelnya dengan /models/Kimi-K3.1-Pro, set host layanan ke 0.0.0.0 dan port ke 30000, serta pertahankan flag spesifik perangkat kerasnya. Container harus mendengarkan antarmuka jaringannya agar penerusan port Docker berfungsi; port sisi host di atas tetap terikat ke loopback. Tunggu pesan service-ready sebelum pengujian.
Di shell kedua pada server GPU, daftar model yang disajikan, lalu kirim permintaan menggunakan ID model yang dikembalikan:
curl http://127.0.0.1:30000/v1/models

MODEL_ID="replace-with-id-from-models-response"
curl http://127.0.0.1:30000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d "{\"model\":\"$MODEL_ID\",\"messages\":[{\"role\":\"user\",\"content\":\"Explain database indexes in three sentences.\"}],\"reasoning_effort\":\"low\",\"max_tokens\":2048}"
Respons yang berhasil harus berisi jawaban akhir. Jika startup gagal, periksa log container dan konfirmasikan bahwa resep perangkat keras yang dipilih serta image cocok. Untuk akses laptop, gunakan pola tunnel SSH yang sama dengan port 30000. Lihat panduan instalasi Docker SGLang untuk prasyarat container.
Bagaimana performa Kimi K3.1 Pro di berbagai benchmark?
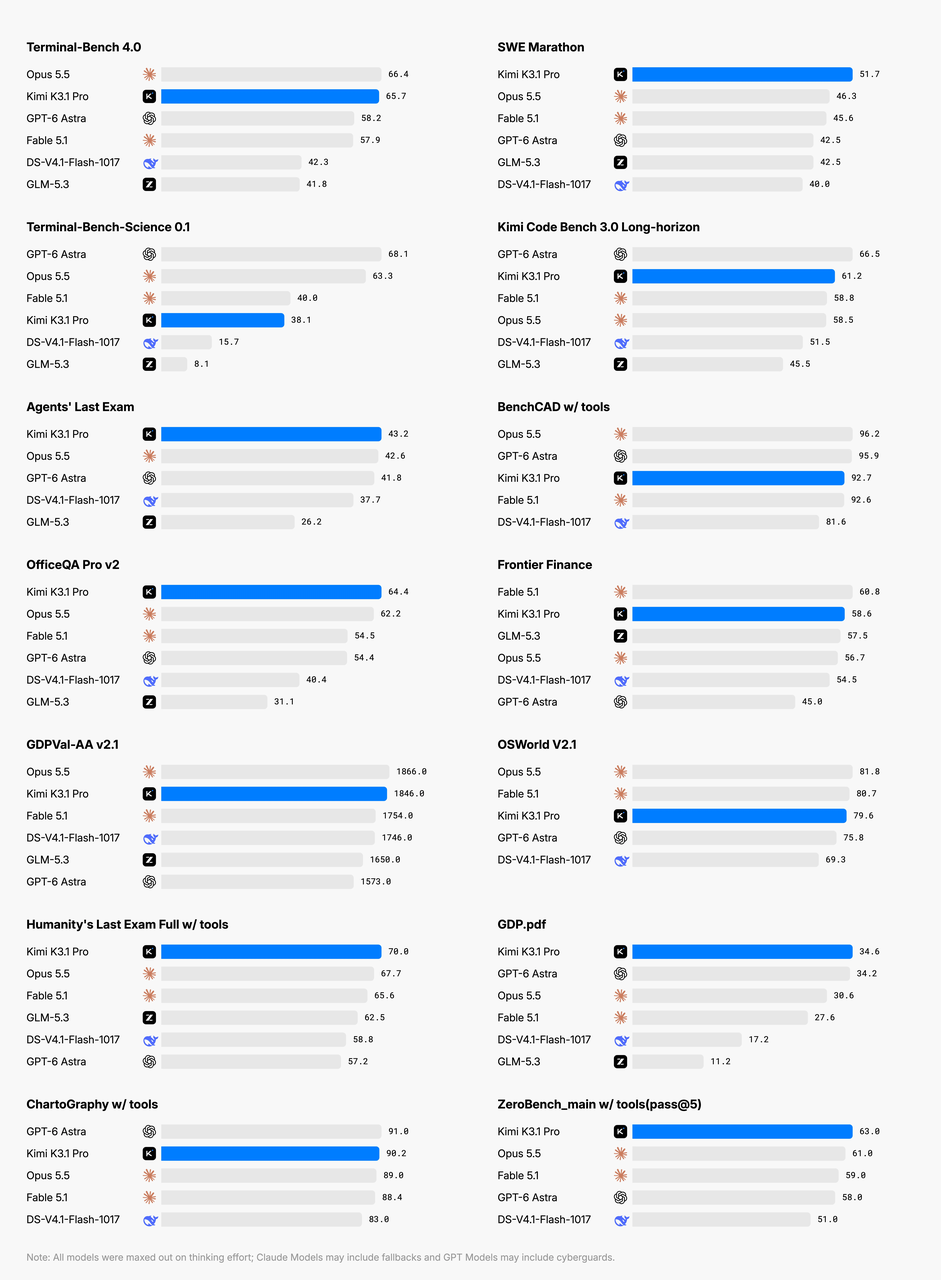
Gunakan hasil evaluasi resmi di bawah untuk memilih tugas uji penyebaran Anda. Skor ini menggambarkan pengaturan evaluasi yang dipublikasikan; mereka tidak mengukur server lokal yang dikonfigurasi dalam panduan ini.
Tabel berikut menunjukkan hasil terpilih dan posisinya dalam set perbandingan yang dipublikasikan di model card.
Benchmark dan hasil resmi
Skor model
Posisi dalam perbandingan tersebut
Terminal-Bench 4.0
65.7
Kedua
SWE Marathon v1.1
51.7
Pertama
Program Bench
31.5
Keempat
OfficeQA Pro v2
64.4
Pertama di antara hasil yang dilaporkan
Frontier Finance
58.6
Kedua
Hasil ini mendukung pengujian model untuk tugas rekayasa yang diperluas dan alur kerja dokumen. Kimi K3.1 Pro memimpin perbandingan ini pada SWE Marathon tetapi berada di peringkat keempat pada ProgramBench, menjadikan keduanya kandidat yang berguna untuk pengujian spesifik aplikasi.
Posisi ini dihitung dalam tabel perbandingan resmi, bukan leaderboard global langsung. Kerangka evaluasi, alat, anggaran penalaran, dan pemilihan sampel berbeda antar benchmark.
Untuk keputusan penyebaran, bangun set evaluasi kecil dari pekerjaan nyata: perbaikan repositori, pertanyaan lintas dokumen, dan tugas alat multi-langkah. Ukur kualitas penyelesaian, koreksi manusia, dan waktu yang berlalu. Skor yang dipublikasikan berguna untuk daftar pendek; pengujian aplikasi menentukan apakah penyebaran layak.
Bagaimana cara mengoptimalkan inferensi lokal Kimi K3.1 Pro?
Kendalikan konteks dan konkurensi
Setelah permintaan pendek berfungsi, uji dokumen lebih panjang, gambar, percakapan multi-giliran, dan panggilan alat secara terpisah.
Lacak latensi token pertama, token keluaran per detik, dan puncak memori GPU pada panjang konteks dan konkurensi yang Anda maksud. Catat juga keberhasilan tugas dan biaya per tugas yang berhasil, agar keluaran yang lebih cepat tidak menyembunyikan lebih banyak percobaan ulang atau koreksi manusia.
Ubah satu variabel besar pada satu waktu. Meningkatkan panjang konteks, konkurensi, dan pengaturan optimisasi secara simultan membuat regresi performa sulit dijelaskan.
Pilih tingkat penalaran dan pengaturan cache secara hati-hati
Gunakan tingkat penalaran rendah, tinggi, atau maksimum sesuai tugas. Mulailah dengan rendah untuk pemeriksaan antarmuka, lalu bandingkan tinggi dan maksimum pada tugas sulit dengan menggunakan kualitas penyelesaian dan waktu yang berlalu. Jejak penalaran yang lebih panjang bukanlah bukti tersendiri dari hasil yang lebih baik.
Untuk sesi panjang, evaluasi kapasitas cache dan penggunaan kembali prefix sebelum menambahkan decoding spekulatif atau lebih banyak konkurensi. Pertahankan baseline yang diketahui baik dan ubah satu pengaturan pada satu waktu.
Mengapa pemanggilan alat Kimi K3.1 Pro dapat gagal setelah penyebaran?
Aplikasi Anda mengeksekusi panggilan alat, mengembalikan hasilnya, dan melanjutkan percakapan. Pertahankan pesan asisten lengkap—termasuk reasoning_content dan tool_calls—dan kembalikan setiap hasil alat dengan tool_call_id yang cocok.
Penanganan multi-giliran juga penting. Panduan penggunaan model mengharuskan mempertahankan pesan asisten lengkap, termasuk bidang penalaran dan panggilan alat, alih-alih hanya mempertahankan teks final.
Gejala
Pemeriksaan awal
Arsitektur model tidak dikenali
Versi runtime, kode khusus, dan konfigurasi
Kehabisan memori saat memuat
Kapasitas GPU, paralelisme, dan proses yang bersaing
Permintaan pendek berfungsi tapi panjang gagal
Batas konteks, kapasitas cache, dan konkurensi
Panggilan alat tidak dapat diurai
Pengaturan parser dan skema alat
Agen berhenti setelah meminta alat
Eksekusi aplikasi dan penanganan hasil alat
Jawaban multi-giliran menjadi tidak konsisten
Bidang pesan asisten yang hilang
Gunakan permintaan yang dapat direproduksi minimal untuk mengisolasi setiap kegagalan. Setelah berfungsi, perkenalkan kembali pengaturan tambahan aplikasi satu per satu.
Haruskah Anda melakukan self-hosting atau menggunakan API ter-host?
Pilih self-hosting ketika Anda memerlukan kontrol atas bobot, infrastruktur, atau lokasi data dan dapat menjaga GPU tetap sibuk secara berguna. Untuk evaluasi awal atau permintaan yang variabel, bandingkan Kimi API resmi dan CometAPI menggunakan prompt dan kriteria penerimaan yang sama. Konfirmasikan akses model setiap layanan, parameter yang didukung, kuota, dan ketentuan penanganan data.
Biaya atau faktor operasional
Self-hosted
Kimi API resmi / CometAPI
Biaya kapasitas
Pembelian atau sewa GPU, termasuk waktu idle
Penggunaan API yang ditagihkan; periksa tarif terkini setiap penyedia
Penyimpanan dan jaringan
Penyimpanan checkpoint, cache, dan biaya jaringan
Biaya penyimpanan dan jaringan sisi aplikasi apa pun
Operasi
Penyebaran, pemantauan, peningkatan, dan pemulihan
Integrasi, manajemen kuota, dan pemantauan permintaan
Percobaan ulang
Sertakan waktu GPU mereka dalam biaya komputasi
Sertakan token atau panggilan mereka dalam biaya API
Tinjauan manusia
Hitung waktu koreksi dengan tarif yang sama
Hitung waktu koreksi dengan tarif yang sama
Kecocokan terbaik
Permintaan stabil dan kontrol infrastruktur
Evaluasi dan permintaan variabel
Perbandingan yang berguna adalah:
Biaya per tugas yang berhasil = (komputasi GPU atau biaya API + penyimpanan dan jaringan + operasi + koreksi manusia) / tugas yang berhasil diselesaikan.
Gunakan biaya dan jumlah tugas yang berhasil dari periode pengukuran yang sama. Sertakan upaya gagal dan percobaan ulang dalam total komputasi atau API satu kali; jangan menambahkan biaya percobaan ulang kedua. Untuk alur kerja hibrida, sertakan biaya komputasi dan API. Hitung tugas selesai yang unik, bukan upaya permintaan.
Server yang kurang dimanfaatkan dapat tetap mahal meskipun throughput teoritisnya sangat baik. Sebaliknya, tim dengan infrastruktur yang ada, permintaan stabil, dan persyaratan data yang ketat dapat memperoleh nilai substansial dari self-hosting.
Gunakan prompt dan kriteria penerimaan yang identik saat membandingkan rute penyebaran. Sertakan latensi end-to-end dan kualitas keluaran dalam keputusan.
Coba endpoint ter-host tanpa memuat bobot
Kimi API quickstart resmi menggunakan endpoint di bawah. Setel MOONSHOT_API_KEY di lingkungan Anda dan konfirmasikan akses model di akun Anda. Permintaan ini berjalan di infrastruktur penyedia.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["MOONSHOT_API_KEY"],
    base_url="https://api.moonshot.ai/v1",
)
response = client.chat.completions.create(
    model="kimi-k3.1-pro",
    messages=[{"role": "user", "content": "Explain database indexes in three sentences."}],
    reasoning_effort="low",
    max_completion_tokens=2048,
)
print(response.choices[0].message.content)
Untuk Kimi K3.1 Pro API di CometAPI, setel COMETAPI_API_KEY di lingkungan Anda dan konfirmasikan bahwa akun Anda memiliki akses ke model yang diminta. Permintaan berjalan secara remote:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_API_KEY"],
    base_url="https://api.cometapi.com/v1",
)
response = client.chat.completions.create(
    model="kimi-k3.1-pro",
    messages=[{"role": "user", "content": "Explain database indexes in three sentences."}],
    max_tokens=2048,
)
print(response.choices[0].message.content)
Bandingkan hasilnya dengan endpoint lokal Anda menggunakan kriteria penerimaan yang sama. Periksa harga rute saat ini dan parameter yang didukung sebelum memperkirakan biaya produksi.
Kesimpulan
Self-hosting Kimi K3.1 Pro praktis dengan konfigurasi GPU yang didukung dan lingkungan inferensi yang cocok. Gunakan langkah penyebaran di atas untuk menetapkan endpoint yang berfungsi, lalu ukur kualitas tugas, latensi, dan biaya pada beban kerja Anda sendiri. Pilih API ter-host jika Anda masih memvalidasi aplikasi atau tidak memiliki perangkat keras yang sesuai.
Tanya Jawab
Apakah laptop biasa dapat menjalankan model lengkap?
Laptop biasa bukan target yang praktis untuk kebutuhan kapasitas checkpoint asli. Ini dapat bertindak sebagai klien yang terhubung ke server inferensi Anda atau API ter-host.
Apakah memasang aplikasi desktop dihitung sebagai penyebaran lokal?
Lokasi instalasi aplikasi tidak menentukan tempat inferensi terjadi. Self-hosting memerlukan bobot model dan proses inferensi berjalan di infrastruktur yang Anda kendalikan.
Mengapa model membutuhkan begitu banyak memori jika hanya 104B parameter yang aktif?
Token yang berbeda dapat memilih pakar yang berbeda. Parameter aktif menggambarkan partisipasi dalam komputasi; penyebaran tetap perlu menyimpan dan mengakses seluruh set bobot.
Dapatkah saya langsung mengaktifkan konteks satu juta token penuh?
Tingkatkan panjang konteks secara bertahap dan ukur penggunaan memori GPU pada konkurensi target Anda. Model mendukung 1,048,576 token, tetapi kapasitas penyajian yang dapat digunakan bergantung pada cache dan pengaturan paralelisme Anda.
Apakah penyebaran lokal akan mereproduksi skor benchmark yang dipublikasikan?
Tidak secara otomatis. Kuantisasi, anggaran penalaran, alat, prompt, dan kerangka evaluasi semuanya dapat memengaruhi hasil. Validasi konfigurasi terhadap tugas Anda sendiri.
Haruskah saya menguji melalui API sebelum membeli perangkat keras?
Jika Anda belum memastikan bahwa model memenuhi persyaratan kualitas Anda, pengujian API memberikan baseline awal dengan pekerjaan infrastruktur yang lebih sedikit. Tim dengan perangkat keras yang sesuai dan persyaratan residensi data yang jelas dapat langsung melanjutkan ke evaluasi self-hosting yang terkontrol.