

TL;DR
MiMo-V2.5 adalah pilihan default yang lebih kuat untuk pekerjaan multimodal, agen rutin, dan produksi yang sensitif biaya. MiMo-V2.5-Pro adalah opsi spesialis untuk penalaran sulit, pengodean skala repositori, dan penggunaan alat yang berjalan lama. Keduanya menyediakan jendela konteks 1M token dan hingga 128K token keluaran, tetapi Pro menggunakan backbone bahasa yang jauh lebih besar dan biayanya sekitar 3,1× untuk token masukan dan keluaran biasa.
MiMo-V2.5 vs. Pro: Keputusan Cepat
| Spesifikasi — rilis resmi | MiMo-V2.5 | MiMo-V2.5-Pro | Model yang direkomendasikan | Alasan |
|---|---|---|---|---|
| Posisi utama | Model omni-modal dan agen efisien | Agen unggulan dan pengodean kompleks | Pilih sesuai beban kerja | Masukan omni-modal menguntungkan V2.5; pekerjaan teks sulit berkelanjutan menguntungkan Pro. |
| Arsitektur | Sparse MoE | Sparse MoE | Pilih sesuai beban kerja | Ukuran model saja tidak menetapkan pilihan yang lebih baik untuk setiap tugas. |
| Total parameter | 310B | 1.02T | Pilih sesuai beban kerja | Model yang lebih besar menargetkan penalaran sulit, tetapi total ukuran bukan hasil tugas. |
| Parameter yang diaktifkan | 15B | 42B | Pilih sesuai beban kerja | Gunakan penyelesaian tugas dan biaya untuk memutuskan. |
| Lapisan LLM | 48 | 70 | Pilih sesuai beban kerja | Jumlah lapisan menggambarkan arsitektur, bukan kemenangan universal. |
| Pakar yang dirutekan | 256 | 384 | Pilih sesuai beban kerja | Perbedaannya berarti hanya jika itu meningkatkan beban kerja target. |
| Pakar yang diaktifkan per token | 8 | 8 | Keduanya | Keduanya mengaktifkan delapan pakar per token. |
| Jendela konteks | 1M tokens | 1M tokens | Keduanya | Keduanya mengiklankan jendela 1M token; uji pengambilan efektif. |
| Keluaran maksimum | 128K tokens | 128K tokens | Keduanya | Keduanya mengiklankan hingga 128K token keluaran. |
| Modalitas masukan | Teks, gambar, video, dan audio | Teks | MiMo-V2.5 | Menerima masukan gambar, video, dan audio; Pro berfokus pada masukan teks. |
| Pemanggilan alat | Ya | Ya | Pilih sesuai beban kerja | Keduanya dapat memanggil alat; uji tingkat keberhasilan pada trajektori aktual. |
| Bobot terbuka dan lisensi | Ya; MIT | Ya; MIT | Keduanya | Keduanya menawarkan bobot terbuka di bawah MIT; biaya penyajian berbeda. |
Perbedaan Penentu: Multimodal vs Agent-First
V2.5 secara native menerima teks, gambar, video, dan audio. Xiaomi memasangkan backbone bahasa dengan encoder visi 729M-parameter dan encoder audio 261M-parameter, memungkinkan informasi multimodal berpartisipasi langsung dalam alur penalaran yang sama.
- Analisis tangkapan layar sebelum memanggil alat.
- Pahami video dan trek audionya secara bersamaan.
- Ekstrak informasi dari diagram dan gambar dokumen.
- Operasikan antarmuka visual dan agen pendukung multimodal.
- Melakukan penalaran atas urutan video yang panjang.
V2.5-Pro mengikuti desain berbeda. Xiaomi saat ini menetapkan teks sebagai modalitas masukan dan menekankan penalaran mendalam, pengembangan kode, serta orkestrasi alat jangka panjang.
Jika alur kerja itu sendiri memuat masukan gambar, video, atau audio, mulailah dengan V2.5. Uji Pro ketika bagian tersulitnya adalah penalaran atas teks, kode sumber, alat, atau trajektori agen yang panjang.

Perbandingan benchmark multimodal resmi dari Xiaomi.
Mengapa V2.5-Pro Bisa Lebih Baik pada Tugas Sulit
Skala Model: 310B/15B vs. 1.02T/42B
Kedua model menggunakan backbone Mixture-of-Experts jarang (Sparse MoE), atensi hibrida jendela geser dan global, serta tiga modul Multi-Token Prediction. Kartu model V2.5 dari Xiaomi mendokumentasikan backbone total 310B dengan 15B aktif; kartu model Pro menskalakan ini ke total 1.02T parameter dengan 42B diaktifkan per token.
| Arsitektur — kartu model resmi | V2.5 | Pro | Perbedaan |
|---|---|---|---|
| Total parameter | 310B | 1.02T | Sekitar 3,3× |
| Parameter aktif | 15B | 42B | 2,8× |
| Ukuran tersembunyi | 4,096 | 6,144 | 1,5× |
| Lapisan LLM | 48 | 70 | Tambahan 22 |
| Head atensi | 64 | 128 | 2× |
| Pakar yang dirutekan | 256 | 384 | 1,5× |
| Pakar per token | 8 | 8 | Sama |
| Lapisan MTP | 3 | 3 | Sama |
V2.5 menggunakan pola atensi 5:1, sementara Pro beralih ke pola lokal-ke-global 6:1. Xiaomi mengatakan desain ini mengurangi kebutuhan cache KV hampir 6× dan 7× masing-masing dibandingkan atensi penuh di seluruh jaringan.
Total parameter tidak berbanding lurus dengan kualitas jawaban. Backbone Pro yang lebih besar paling berdampak ketika kesulitan penalaran atau panjang trajektori membuat peningkatan reliabilitas kecil per langkah menjadi terakumulasi.
Mengapa Peningkatan Kecil pada Reliabilitas Dapat Berkombinasi
Tugas agen panjang memiliki banyak langkah saling bergantung. Kesalahan pada pemanggilan alat awal dapat memaksa percobaan ulang atau membatalkan pekerjaan selanjutnya, sehingga peningkatan moderat pada reliabilitas per langkah dapat memberi efek lebih besar pada penyelesaian ujung-ke-ujung. Evaluasilah efek itu pada tugas representatif alih-alih mengasumsikan ukuran model menjaminnya.
Di Mana V2.5-Pro Sebenarnya Meningkat?
Perbandingan numerik paling bersih adalah evaluasi base-model Xiaomi, di mana kedua model muncul di bawah pengaturan yang sama. Ini menghindari penggabungan hasil yang dihasilkan oleh harness tidak terkait atau konfigurasi pasca-pelatihan.
Pengetahuan Umum: Kenaikan Kecil hingga Moderat
Dalam perbandingan base-model Xiaomi, Pro naik 1,2 poin pada BBH, 3,1 pada MMLU, dan 2,7 pada MMLU-Pro. Ini terukur tetapi lebih kecil dibanding kenaikan pada tugas penalaran yang lebih sulit.
Matematika dan Sains: Kenaikan Lebih Besar
Pro naik 8,6 poin pada GPQA-Diamond, 16,3 pada GSM8K, dan 18,5 pada MATH dalam evaluasi base-model yang sama. Ini adalah bukti paling jelas untuk memilih Pro ketika penalaran sulit mendorong keberhasilan tugas.
Pengodean: Lebih Baik, tetapi Tidak Selalu Lebih Baik
Kenaikan yang dilaporkan adalah 4,3 poin pada HumanEval+, 3,2 pada MBPP+, 4,1 pada LiveCodeBench v6, dan 4,9 pada SWE-Bench AgentLess. Uji tugas tingkat repositori dan penggunaan alat secara terpisah: skor base-model ini tidak mengukur setiap alur kerja agen produksi.
Hasil benchmark: Pro bukan tiga kali lebih baik hanya karena biayanya sekitar tiga kali lebih mahal. Nilainya meningkat secara progresif seiring meningkatnya kesulitan penalaran dan durasi tugas.
Baris-baris ini adalah evaluasi base-model, bukan janji bahwa API produksi akan mereproduksi skor yang sama. Hasil agen bergantung pada alat, prompt, percobaan ulang, lingkungan eksekusi, dan anggaran token.
Pasca-pelatihan dan Agen Cakrawala Panjang
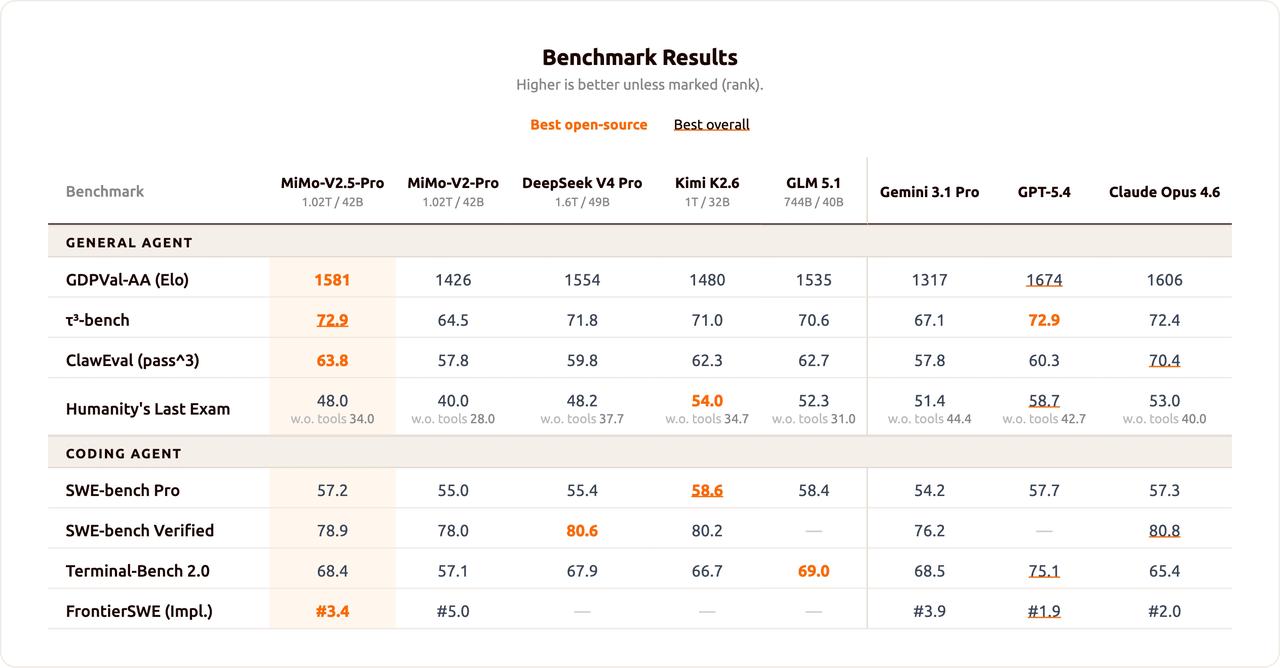
Model produksi menambahkan fine-tuning tersupervisi, pembelajaran penguatan beragen, dan Distilasi On-Policy Multi-Teacher. Xiaomi melaporkan skor pasca-pelatihan sebesar 56,1 pada SWE-bench Pro, 65,8 pada Terminal-Bench 2.0, dan 62,1 Pass³ pada bagian umum Claw-Eval untuk V2.5.
Pro lebih eksplisit dioptimalkan untuk rekayasa perangkat lunak ber-cakrawala panjang. Xiaomi menggambarkan ratusan pemanggilan alat dalam trajektori berkelanjutan dan mempublikasikan hasil 78,9% SWE-bench Verified.
Satu studi kasus resmi menunjukkan Pro menyelesaikan compiler SysY dalam 4,3 jam dengan 672 pemanggilan alat dan semua 233 pengujian lulus. Pelajarannya bukan bahwa setiap permintaan pengodean membutuhkan Pro; melainkan perbedaan reliabilitas kecil dapat menentukan apakah alur kerja dengan ratusan tindakan saling bergantung selesai.

Gambar benchmark pengodean dan agen resmi Xiaomi.
Konteks Panjang: Kapasitas Sama, Beban Kerja Berbeda
Kedua model menyediakan jendela konteks 1M token dan hingga 128K token keluaran melalui API Xiaomi saat ini. Ukuran konteks mentah karenanya tidak membedakan keduanya.
V2.5 menarik ketika konteks panjang mencakup materi multimodal seperti video, gambar dokumen, atau jejak agen visual. Pro adalah model untuk diuji ketika konteks itu sendiri menjadi masalah penalaran: repositori besar, kontrak panjang, korpus riset, atau trajektori agen yang berisi banyak tindakan berurutan.
Jendela konteks besar menggambarkan kapasitas, bukan jaminan fidelitas penalaran. Evaluasi pengambilan, retensi instruksi, dan penggunaan bukti pada panjang yang penting bagi aplikasi.
Harga dan Efisiensi Biaya
Harga luar negeri Xiaomi bayar sesuai pemakaian membuat trade-off menjadi jelas.
| Harga — daftar harga resmi | V2.5 | Pro | Rasio |
|---|---|---|---|
| Masukan tanpa cache per 1M token | $0.14 | $0.435 | 3.11× |
| Masukan di-cache per 1M token | $0.0028 | $0.0036 | 1.29× |
| Keluaran per 1M token | $0.28 | $0.87 | 3.11× |
| Jendela konteks | 1M | 1M | Sama |
| Keluaran maksimum | 128K | 128K | Sama |
Permintaan dengan 1M token masukan tanpa cache dan 200K token keluaran diperkirakan menelan biaya $0.196 pada V2.5 dan $0.609 pada Pro sebelum hit cache, biaya pencarian web, atau penagihan spesifik penyedia.
Perbedaan harga cache lebih kecil: Pro sekitar 29% lebih mahal untuk masukan hit cache alih-alih 211% lebih mahal. Agen jangka panjang dengan prompt sistem stabil, definisi alat, atau prefiks repositori karenanya harus mengukur tingkat hit cache aktualnya.
Perkirakan biaya per tugas yang berhasil. Agen Pro yang menyelesaikan alur kerja sulit sekali mungkin berbiaya lebih rendah daripada upaya gagal berulang pada model yang lebih murah.
Model Mana yang Harus Anda Gunakan?
| Beban kerja — panduan resmi | Pilihan yang lebih baik | Alasan |
|---|---|---|
| Obrolan teks rutin | V2.5 | Biaya lebih rendah; Pro sering tak perlu |
| Generasi volume tinggi | V2.5 | Harga token standar ~3,1× lebih rendah |
| Pemahaman gambar, video, atau audio | V2.5 | Masukan multimodal native |
| Pemanggilan alat rutin | V2.5 | Kapabilitas agen kuat dengan biaya lebih rendah |
| Matematika dan sains sulit | Pro | Kenaikan benchmark lebih besar |
| Pengodean skala repositori | Pro | Dirancang untuk rekayasa perangkat lunak kompleks |
| Ratusan pemanggilan alat bergantung | Pro | Cocok untuk eksekusi berkelanjutan |
| Konteks 1M sensitif biaya | V2.5 | Konteks nominal sama dengan biaya jauh lebih rendah |
Hasil pilihan: V2.5 adalah default untuk aplikasi multimodal, agen rutin, dan beban kerja sensitif biaya. Pro adalah peningkatan untuk penalaran sulit, rekayasa perangkat lunak kompleks, dan trajektori otonom yang panjang.
Strategi Produksi yang Lebih Baik: Merutekan di Antara Keduanya
Satu pilihan model global sering tidak diperlukan. Rute permintaan multimodal dan rutin ke V2.5, lalu eskalasi hanya penalaran teks yang sulit, pengodean kompleks, atau eksekusi cakrawala panjang ke Pro.
| Dimensi evaluasi | Ukuran | Mengapa penting | Sinyal perutean |
|---|---|---|---|
| Penyelesaian | Tugas berhasil / percobaan | Mencerminkan reliabilitas ujung-ke-ujung | Eskalasi kelas dengan penyelesaian rendah |
| Kualitas | Skor manusia atau rubrik | Mencegah biaya token mendominasi | Eskalasi tugas berisiko tinggi |
| Reliabilitas alat | Galat dan percobaan ulang | Galat kecil berakumulasi dalam agen | Eskalasi trajektori panjang |
| Latensi | Waktu hingga hasil diterima | Mencakup overhead percobaan ulang | Pertahankan tugas interaktif tetap ringan |
| Biaya | Pengeluaran per tugas diterima | Merefleksikan kegagalan dan pengulangan | Gunakan model termurah yang berhasil |
Uji Kedua API di CometAPI
API MiMo-V2.5 di CometAPI dan API MiMo-V2.5-Pro di CometAPI mendukung evaluasi berdampingan melalui satu lapisan agregasi. Kirim prompt, instruksi sistem, alat, dan batas keluaran yang sama ke kedua model, lalu bandingkan keberhasilan tugas dan biaya.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

models = ["mimo-v2.5", "mimo-v2.5-pro"]
prompt = """
Review this implementation plan.
Identify hidden technical risks and propose the three highest-priority fixes.
"""

for model in models:
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=2000,
    )
    print(f"\n--- {model} ---")
    print(response.choices[0].message.content)
Jalankan batch representatif yang memuat permintaan langsung, penalaran sulit, pengeditan kode, tugas konteks panjang, dan pemanggilan alat agen. Catat tingkat penyelesaian, token, latensi, galat alat, percobaan ulang, kualitas jawaban, dan biaya per tugas yang berhasil.
Batasan
Batasan V2.5
Backbone bahasa yang lebih kecil meninggalkan performa saat kesulitan penalaran meningkat. Kesenjangannya moderat pada BBH tetapi menjadi jauh lebih besar pada GPQA-Diamond dan MATH. Jendela konteks 1M token juga tidak boleh disalahartikan sebagai fidelitas penalaran 1M token yang terjamin.
Batasan Pro
Harga masukan dan keluaran biasa Pro sekitar 3,1× dari V2.5, dan masukan teks saja membuatnya tidak cocok sebagai pengganti langsung untuk aplikasi multimodal. Model bobot terbuka 1.02T-parameter juga merupakan proyek self-hosting yang menuntut meskipun 42B parameter diaktifkan per token.
Kesimpulan Akhir
Pilih V2.5 untuk aplikasi multimodal, agen rutin, dan produksi sensitif biaya. Pilih Pro untuk penalaran sulit, rekayasa perangkat lunak kompleks, dan agen otonom yang berjalan lama. Untuk beban kerja campuran, rute sebagian besar trafik ke V2.5 dan eskalasi hanya permintaan yang kesulitannya atau panjang trajektorinya membenarkan biaya tambahan.
FAQ
Apakah Pro selalu lebih baik daripada V2.5?
Tidak. Pro lebih kuat pada penalaran teks sulit dan pengodean, tetapi V2.5 mendukung masukan gambar, video, dan audio serta jauh lebih murah.
Apakah kedua model mendukung jendela konteks 1M token?
Ya. Keduanya mengiklankan 1M token konteks dan hingga 128K token keluaran. Aplikasi tetap harus menguji pengambilan dan penalaran pada panjang operasi sebenarnya.
Agen multimodal harus menggunakan model yang mana?
Mulailah dengan V2.5 karena secara native menerima masukan visual dan audio. Pro saat ini menargetkan alur kerja masukan teks.
Kapan Pro sepadan dengan harganya yang lebih tinggi?
Paling dapat dipertahankan ketika reliabilitas penalaran yang lebih baik memengaruhi penyelesaian matematika sulit, pengodean skala repositori, atau trajektori panjang yang berisi banyak pemanggilan alat saling bergantung.
Haruskah sistem produksi hanya menggunakan satu model?
Tidak harus. Lapisan perutean dapat menjaga pekerjaan rutin dan multimodal pada V2.5 sambil mengeskalasi penalaran teks sulit dan tugas agen ke Pro.