

TL;DR
Muse Wonder, Claude Opus 5.5, dan GPT-6 Sol adalah model berkemampuan tinggi yang diposisikan untuk pengodean dan alur kerja agen. Muse Wonder baru dari Meta menekankan memori persisten dan eksekusi berkelanjutan; Opus 5.5 memimpin indeks kecerdasan agregat yang dikutip; GPT-6 Sol memiliki tarif input dan output standar konteks pendek terendah dalam perbandingan ini, sementara tingkat konteks panjangnya diberi harga terpisah. Pilih berdasarkan kualitas tugas representatif, keandalan, dan total biaya, bukan satu skor papan peringkat.
Key Takeaways
- Kecerdasan keseluruhan: Claude Opus 5.5 meraih 58 dibanding 52 untuk Muse Wonder pada Intelligence Index v4.3 yang dilaporkan.
- Pengodean jangka panjang: Muse Wonder mencatat 78.8 pada DeepSWE 1.1 dan 53.1 pada SWE-Marathon; Opus 5.5 mencatat 74.2 dan 46.3 dalam tabel Meta.
- Penalaran berbiaya rendah: GPT-6 Sol mulai dari $2 input / $10 output per 1 juta token melalui API standar konteks pendek OpenAI.
- Agen berfokus pada memori: Muse Wonder memperkenalkan Active Memory dan Active Focus.
- Ketersediaan penting: Muse Wonder Full adalah produk terpisah yang lebih dibatasi dibanding Muse Wonder standar yang dapat diakses pengembang.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol at a Glance
Pilih Muse Wonder untuk agen persisten dan rekayasa yang berjalan lama, Claude Opus 5.5 untuk pengodean luas dan pekerjaan yang berat di terminal, serta GPT-6 Sol untuk biaya token konteks pendek standar yang lebih rendah.
| Decision factor | Muse Wonder | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|
| Start testing with | Agen persisten dan rekayasa jangka panjang | Pengodean berat-di-terminal dan alur kerja profesional | Pengodean dan otomasi peka anggaran |
| Context window | 1,048,576 tokens | 1M tokens | 1,050,000 tokens |
| Published strength | DeepSWE 78.8; SWE-Marathon 53.1 | Intelligence Index 58; ProgramBench 70.5 | Input/output standar $2/$10 per 1M tokens |
| Standard input / output per 1M tokens | $4 / $20 | $4 / $20 | $2 / $10; tingkatan konteks pendek |
| Provider access | Meta Model API; Full adalah produk berlangganan terpisah | Anthropic API | OpenAI API |
| Selection metric | Kualitas tugas yang diterima dan total biaya | Kualitas tugas yang diterima dan total biaya | Kualitas tugas yang diterima dan total biaya |
| Developer | Meta | Anthropic | OpenAI |
| Release | 12 Oktober 2026 | 22 September 2026 | 16 September 2026 |
| Input modalities | Teks, gambar, audio, video; input PDF didokumentasikan | Teks, gambar | Teks, gambar |
| Output | Teks | Teks | Teks |
| Distinctive capability | Active Memory dan Active Focus | Alur kerja alat dan subagen | Upaya penalaran yang dapat dikonfigurasi dan alat API |
Ikhtisar ini merangkum spesifikasi bertanggal dan hasil yang dipublikasikan yang ditinjau di bawah. Baris tolok ukur menggunakan metode evaluasi berbeda, dan tarif token rendah tidak menetapkan biaya lebih rendah per tugas yang berhasil. Muse Wonder standar dan Muse Wonder Full adalah pilihan akses yang berbeda.
Spesifikasi diperiksa pada 13 Oktober 2026. Modalitas dan fitur yang didukung bergantung pada endpoint dan permukaan rilis yang dipilih, termasuk ketersediaan audio. Kapabilitas tingkat model tidak menjamin dukungan di setiap rute gateway.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Overview and Specifications
Muse Wonder: Persistent Agent Workflows
Meta memperkenalkan Muse Wonder dan Muse Wonder Full pada 12 Oktober 2026. Muse Wonder standar menekankan tugas profesional yang berjalan lama, memori agen persisten, dan pemulihan dari hambatan. Active Memory dimaksudkan untuk mengambil konteks sebelumnya yang berguna, sementara Active Focus dirancang untuk mempertahankan kemajuan di sepanjang pekerjaan multi-langkah. Meta menggambarkan pengodean, riset, analisis keuangan, dan bantuan personal sebagai skenario utama.
Claude Opus 5.5: Professional Coding and Tool Use
Claude Opus 5.5 menargetkan pengodean, penalaran, dan alur kerja profesional multi-alat. Anthropic merilisnya pada 22 September 2026. Jendela konteksnya adalah satu juta token, sementara hasil pengodean yang dilaporkan di bawah menunjukkan kekuatan yang bervariasi menurut tolok ukur.
GPT-6 Sol: Cost-Conscious Reasoning
GPT-6 Sol bertujuan menggabungkan penalaran kuat dan penggunaan alat dengan inferensi yang relatif terjangkau. Model ini mendukung alur kerja terprogram melalui ekosistem API OpenAI. Tarif standar konteks pendeknya lebih rendah daripada tarif Claude Opus 5.5 yang tertera, meski ekonomi ujung-ke-ujung juga bergantung pada percobaan ulang dan penggunaan token penalaran.
OpenAI menggambarkan GPT-6 Sol sebagai model untuk pengodean kompleks dan alur kerja agensi; pengumuman rilisnya menyediakan hasil evaluasi yang digunakan di bawah. Artikel ini membandingkan versi model yang ditentukan, bukan setiap model yang lebih baru dalam lini masing-masing vendor.
Architecture and Reasoning Controls
Sumber yang dikutip di sini tidak menyediakan rincian jumlah parameter dan arsitektur yang sebanding untuk ketiga model. Karena itu, tidak ada peringkat padat versus mixture-of-experts yang dapat dibenarkan. Active Memory dan Active Focus menggambarkan kapabilitas agen Meta; keduanya bukan pengganti arsitektur neural yang diungkapkan. GPT-6 Sol mengekspos upaya penalaran yang dapat dikonfigurasi, sementara skor Meta dan Claude yang dilaporkan juga bergantung pada upaya dan pengaturan evaluasi. Perlakukan pengaturan tersebut sebagai bagian dari konfigurasi yang dibandingkan, bukan ukuran komputasi yang dapat dipertukarkan.
Hasil perbandingan: Ketiganya menawarkan jendela konteks besar dan API pengembang. Muse Wonder mendokumentasikan modalitas input tingkat model yang lebih luas; Opus 5.5 dan GPT-6 Sol menekankan alur kerja teks dan gambar. Kapasitas konteks dan ketersediaan fitur tetap perlu diperiksa pada endpoint yang dipilih.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Performance
Published Benchmarks and Source Boundaries
Kartu model resmi Meta menawarkan perbandingan langsung Muse Wonder versus Claude Opus 5.5. OpenAI memublikasikan hasil GPT-6 Sol secara terpisah, sehingga ketiga model tidak dapat ditempatkan pada satu papan peringkat yang sepenuhnya terkontrol tanpa menyelaraskan rangka evaluasi, versi, dan pengaturan.
| Benchmark | Muse Wonder | Claude Opus 5.5 | Higher score |
|---|---|---|---|
| Artificial Analysis Intelligence Index v4.3 | 52 | 58 | Opus |
| Personal Superintelligence Index | 54.3 | 55.2 | Opus |
| Harvey LAB-AA | 10.0 | 4.2 | Muse |
| Vals Finance Agent V2 | 56.6 | 58.6 | Opus |
| AutomationBench-AA | 39.1 | 41.2 | Opus |
| JobBench | 70.5 | 75.4 | Opus |
| MemoryBench | 85.6 | 81.5 | Muse |
| Terminal-Bench 4.0-AA | 52.0 | 59.6 | Opus |
| DeepSWE 1.1 | 78.8 | 74.2 | Muse |
| SWE-Marathon | 53.1 | 46.3 | Muse |
| ProgramBench | 50.0 | 70.5 | Opus |
| HealthBench Pro | 60.5 | 65.6 | Opus |
Metodologi kartu model resmi membedakan pengujian internal, evaluasi pihak ketiga, dan skor pesaing yang dilaporkan penyedia. Tabel ini mereproduksi nilai yang dilaporkan; tabel ini tidak menetapkan uji coba seragam yang dikendalikan secara independen di semua baris.
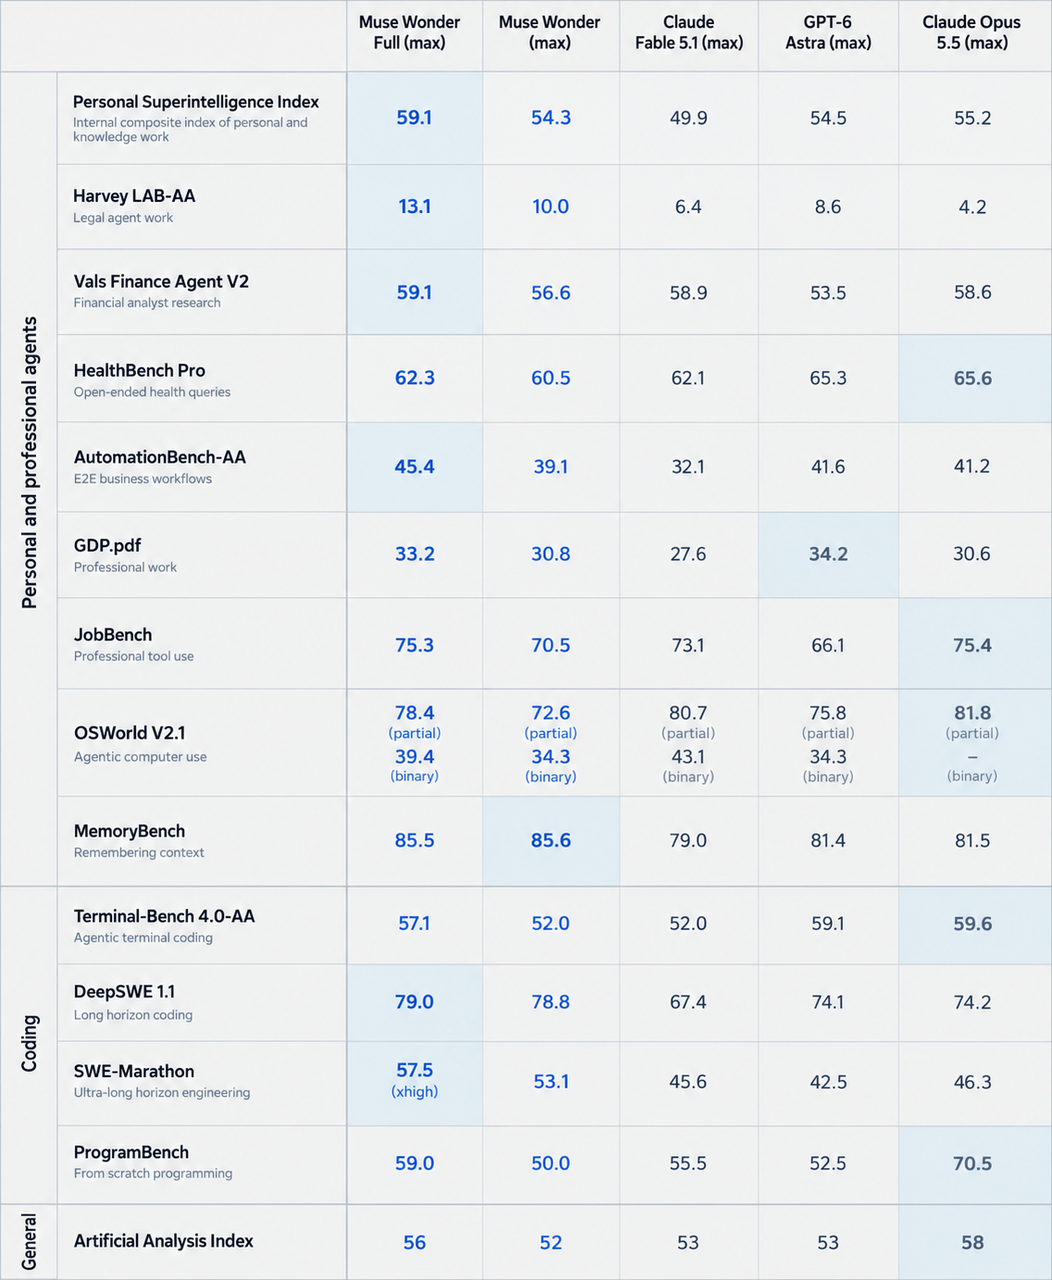
Kartu skor tolok ukur asli dari kartu model Muse Wonder milik Meta, direproduksi tanpa menggambar ulang. Model OpenAI tambahan yang ditampilkan dalam gambar resmi ini adalah GPT-6 Astra, bukan GPT-6 Sol. Tabel di sekitarnya mengidentifikasi model yang relevan dengan artikel ini.
Evaluation Conditions
DeepSWE v1.1 mencakup 113 tugas di 91 repositori dan lima bahasa, dinilai dengan uji fungsional dan regresi menggunakan pass@1; kartu skor Meta menggunakan hasil Datacurve untuk Muse Wonder dan Opus 5.5. SWE-Marathon menggunakan uji proyek dan melaporkan pass@1 dari Abundant AI; rangka agen bervariasi, dan skor Wonder Full ditandai xhigh. ProgramBench menggunakan mini-swe-agent dan mengukur rollout yang lulus setidaknya 95% uji tersembunyi, dengan internet dinonaktifkan setelah penyiapan. MemoryBench adalah uji percakapan 64K–100K token internal Meta yang dinilai oleh juri LLM. Lingkungan dan metrik ini tidak boleh digabung menjadi satu skor akurasi umum.
Coding and Software Engineering
Muse Wonder memimpin pada hasil DeepSWE 1.1 dan SWE-Marathon yang dilaporkan. Claude Opus 5.5 memimpin pada Terminal-Bench 4.0-AA dan ProgramBench. Perbedaan ini menunjukkan bahwa rekayasa jangka panjang, penggunaan alat baris perintah, dan rekonstruksi program menekan keterampilan yang berbeda.
GPT-6 Sol Results and Cross-Source Comparability
| Published OpenAI evaluation | GPT-6 Sol | Reported setting |
|---|---|---|
| DeepSWE 1.1 | 68.8% | Maximum reasoning |
| AutomationBench 1.0.6 | 33.2% | xhigh reasoning |
| Agents' Last Exam V1 | 56.4% | Maximum reasoning |
| OSWorld 2.0 offline | 60.5% | xhigh reasoning |
Hasil evaluasi yang dipublikasikan OpenAI melaporkan skor di atas. Hasil OSWorld-nya adalah reward parsial pada set offline v2026.08.08, bukan tingkat penyelesaian tugas yang ketat. OpenAI mencatat bahwa evaluasi menggunakan lingkungan riset atau API miliknya; konfigurasi produksi dapat berbeda.
Skor DeepSWE yang dilaporkan menyiratkan selisih 10.0 poin persentase antara Muse Wonder dan GPT-6 Sol, serta selisih 5.4 poin antara Opus 5.5 dan GPT-6 Sol. Ini adalah perbedaan aritmetika antar publikasi, bukan estimasi terkontrol dari keunggulan model semata. Pengaturan agen yang berbeda, prompt, tingkat upaya, dan anggaran alat dapat memengaruhi hasil.
Memory and Long-Running Agents
Muse Wonder menargetkan agen yang harus mengingat keputusan sebelumnya, memulihkan konteks, dan melanjutkan pekerjaan yang terhenti. Active Memory dapat membantu asisten riset mengingat fakta spesifik proyek, sementara Active Focus mendukung tindakan iteratif ketika rencana sebelumnya tidak berhasil. Kapabilitas produk ini tidak menggantikan verifikasi status, izin, jejak audit, atau konfirmasi manusia wajib untuk tindakan sensitif.
Muse Wonder Full Performance
Muse Wonder Full adalah pilihan produk terpisah. Meta menawarkan Muse Wonder standar melalui API-nya, sementara Full dibatasi untuk langganan Power Usage dan Maximum Usage di Muse Code. Skor yang lebih tinggi tidak menjadikan Full sebagai pengganti API untuk model standar.
Hasil Wonder Full yang dilaporkan Meta adalah 56 pada Intelligence Index, 59.1 pada Personal Superintelligence, 13.1 pada Harvey LAB-AA, dan 45.4 pada AutomationBench-AA. Full juga meraih 79.0 pada DeepSWE 1.1, 57.5 pada SWE-Marathon, 85.5 pada MemoryBench, dan 75.3 pada JobBench. Hasil yang dipublikasikan ini menggambarkan produk Full dengan akses terpisah; ini bukan pengukuran baru dari perbandingan dengan rangka bersama.
Dibanding skor Muse Wonder standar di atas, Full meningkat pada tujuh dari delapan ukuran yang dilaporkan ini; MemoryBench sedikit lebih rendah di 85.5 versus 85.6. Opus 5.5 masih memimpin Intelligence Index yang dilaporkan di 58.
Latency and Reliability
Bukti yang dikutip tidak menyediakan perbandingan latensi tiga model yang cocok. Ukur waktu hingga output berguna pertama, median dan waktu tugas ujung-ke-ujung persentil ke-95, frekuensi timeout, dan penyelesaian tanpa intervensi. Tahan input tugas, izin alat, konkurensi, dan kriteria penerimaan tetap; catat pengaturan upaya dan anggaran percobaan ulang. Kecepatan generasi token yang lebih cepat saja tidak menetapkan penyelesaian tugas multi-langkah yang lebih cepat.
Hasil perbandingan: Muse Wonder memimpin uji rekayasa berkelanjutan yang dikutip, sementara Opus 5.5 memimpin uji terminal dan rekonstruksi program yang dikutip. GPT-6 Sol tetap menjadi kandidat dengan harga token lebih rendah, tetapi publikasi yang tersedia tidak membuktikan peringkat kualitas atau kecepatan lingkungan setara di ketiganya.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Cost
Official API Token Prices
| Price per 1M tokens | Muse Wonder | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|
| Standard input | $4 | $4 | $2 |
| Standard output | $20 | $20 | $10 |
| Cached input | $0.20 | $0.20 | $0.20 |
| Long-context input | $4 | $4 | $4 |
| Long-context output | $20 | $20 | $15 |
| Long-context cached input | $0.20 | $0.20 | $0.40 |
Meta memublikasikan $4 input, $20 output, dan $0.20 input di-cache per juta token. Anthropic mencantumkan Opus 5.5 di $4 input, $20 output, dan $0.20 hit cache per juta token. Tabel harga OpenAI mencantumkan GPT-6 Sol di $2/$10 untuk input/output konteks pendek dan $4/$15 untuk konteks panjang; tarif input di-cache juga bervariasi menurut tingkatan. Terapkan tingkatan konteks per permintaan, mode pemrosesan, dan kondisi endpoint yang relevan sebelum memperkirakan beban kerja.
Untuk GPT-6 Sol, permintaan yang berisi lebih dari 272,000 token input ditagih dengan tarif lebih tinggi:
- Token input: 2× tarif standar, naik dari $2 menjadi $4 per 1 juta token.
- Token input di-cache: 2× tarif standar, naik dari $0.20 menjadi $0.40 per 1 juta token.
- Token output: 1.5× tarif standar, naik dari $10 menjadi $15 per 1 juta token.
Tarif yang lebih tinggi ini berlaku untuk seluruh permintaan, bukan hanya token yang melebihi 272,000. Permintaan dengan 272,001 token input karena itu masuk ke tingkatan harga konteks panjang untuk semua token input, input di-cache, dan output-nya.
Sebagai perbandingan, Muse Wonder dan Claude Opus 5.5 tidak memberlakukan premi harga konteks panjang yang setara di bawah tarif API standar mereka.
Pembedaan ini sangat penting untuk analisis dokumen besar, pengodean skala repositori, dan agen AI yang berjalan lama, di mana keunggulan harga konteks pendek GPT-6 Sol dapat menyempit saat permintaan menjadi lebih besar.
CometAPI Pricing and Billing Conditions
Pada saat peninjauan, CometAPI mencantumkan Opus 5.5 di $3.20 input / $16 output dan GPT-6 Sol di $1.60 input / $8 output per 1 juta token. Ini adalah tarif independen CometAPI dan tidak boleh disamakan dengan harga resmi penyedia di atas. Konfirmasikan rute yang berlaku, tingkatan konteks, dan kondisi penagihan akun sebelum memperkirakan biaya; harga dan ketentuan dapat berubah.
Cost per Accepted Task
Hitung biaya per tugas yang diterima sebagai total belanja model dan alat yang ditagihkan, termasuk percobaan ulang dan fallback yang dikenakan biaya, dibagi jumlah output yang memenuhi kriteria penerimaan yang telah ditentukan. Catat waktu tinjauan manusia secara terpisah atau konversi dengan tarif tenaga kerja yang eksplisit. Lacak permintaan gagal dan biaya aktual secara independen: kegagalan saja tidak menetapkan apakah sebuah permintaan ditagih.
Hasil perbandingan: GPT-6 Sol memiliki tarif input dan output standar konteks pendek terendah, sementara Muse Wonder dan Opus 5.5 berbagi tarif dasar tertera yang sama. Biaya aktual per tugas yang diterima bergantung pada rute penagihan yang dipilih, penggunaan cache, tingkatan konteks, biaya alat, percobaan ulang, dan upaya peninjauan.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Comparison and Selection
Capability and Workload-Based Selection
- Untuk pengodean luas dan alur kerja terminal, mulai dengan Claude Opus 5.5 karena memimpin Intelligence Index, Terminal-Bench, dan ProgramBench yang dikutip. Validasi pada refactoring, eksekusi alat, dan konsistensi level program.
- Untuk proyek rekayasa yang diperpanjang, mulai dengan Muse Wonder karena hasil DeepSWE dan SWE-Marathon yang dilaporkan lebih kuat daripada Opus 5.5. Ukur penyelesaian tugas, pemulihan dari hambatan, dan total biaya tugas.
- Untuk agen personal persisten, mulai dengan Muse Wonder karena menawarkan Active Memory dan Active Focus serta memiliki skor MemoryBench yang dilaporkan lebih tinggi daripada Opus 5.5. Uji daya ingat, koreksi, kontinuitas, dan isolasi proyek.
- Untuk alur kerja alat multi-langkah, evaluasi ketiganya. Muse menawarkan Active Focus, Opus menekankan orkestrasi alat, dan GPT-6 Sol mendukung alat Responses API. Bandingkan keseluruhan tumpukan agen, termasuk izin alat, percobaan ulang, dan penanganan status.
- Untuk dokumen profesional dan analisis, evaluasi Muse Wonder atau Claude Opus 5.5. Muse memiliki kekuatan khusus, sementara Opus memiliki indeks agregat yang dikutip lebih kuat. Gunakan dokumen representatif dan kriteria penerimaan spesifik tugas.
- Untuk otomasi berbiaya sensitif dan volume tinggi, mulai dengan GPT-6 Sol karena memiliki tarif input dan output standar konteks pendek terendah yang tercantum. Periksa biaya per tugas yang diterima, tingkatan konteks, latensi, dan percobaan ulang.
- Untuk opsi kelas atas Meta, evaluasi Muse Wonder Full jika dapat diakses. Model ini memiliki skor yang dilaporkan lebih tinggi pada beberapa tugas khusus, tetapi terpisah dari model API standar. Konfirmasikan akses langganan dan kecocokan sebelum pengujian.
Professional Coding
Claude Opus 5.5 adalah pilihan default yang baik bagi tim yang membutuhkan asisten rekayasa luas, khususnya di mana eksekusi alat, refactoring, dan konsistensi level program penting. Keunggulan yang dilaporkan pada Terminal-Bench dan ProgramBench memperkuat kasus tersebut, meski tim harus memvalidasi seluruh tumpukan agen alih-alih hanya modelnya.
High-Volume Automation
GPT-6 Sol menarik ketika permintaan banyak dan sensitivitas biaya tinggi. Bahkan defisit kualitas yang kecil bisa diterima untuk tugas berisiko rendah dan mudah diperiksa seperti membuat draf dokumentasi, mengekstrak bidang terstruktur, atau menjelaskan kode. Untuk run otonom yang panjang, lacak kualitas, token, latensi, dan percobaan ulang secara bersama.
Production Evaluation Checklist
Evaluasi produksi harus melacak enam metrik: kebenaran, diukur dengan jawaban yang diterima atau lulus uji; keandalan, diukur dengan tugas yang selesai tanpa penyelamatan manusia; latensi, diukur dengan durasi tugas ujung-ke-ujung; penggunaan token, diukur dengan total input dan output yang ditagihkan; efisiensi agen, diukur dengan pemanggilan alat dan percobaan korektif; dan biaya efektif, dihitung sebagai total pengeluaran dibagi tugas yang diterima.
Hasil perbandingan: Masukkan Muse Wonder dalam daftar pendek untuk perilaku agen persisten dan tugas rekayasa yang diperpanjang, Opus 5.5 untuk alur kerja pengodean luas dengan tuntutan terminal yang kuat, dan GPT-6 Sol ketika biaya token menjadi kendala utama. Promosikan kandidat hanya setelah memenuhi ambang kualitas dan keandalan spesifik tugas.
Where Can You Access Muse Wonder, Claude Opus 5.5, and GPT-6 Sol?
Official Provider Access
Gunakan Meta Model API untuk Muse Wonder standar, Anthropic API untuk Opus 5.5, atau OpenAI API untuk GPT-6 Sol. Muse Wonder Full tersedia melalui paket langganan Muse Code yang ditentukan alih-alih sebagai pengganti langsung untuk model API standar. Periksa akses akun, batas penggunaan, dan fitur permintaan yang didukung untuk rute yang Anda pilih.
CometAPI Access
Gateway terpadu dapat menyederhanakan autentikasi, penagihan, dan perutean. Gunakan model berkinerja lebih tinggi untuk peninjauan arsitektur yang kompleks dan model yang lebih murah untuk drafting berulang berisiko rendah. Pengidentifikasi model dan format permintaan yang didukung harus selalu diperiksa terhadap endpoint API target.
Pengembang dapat mengakses API Claude Opus 5.5 di CometAPI dan API GPT-6 Sol di CometAPI untuk mengevaluasi beban kerja representatif. Konfirmasikan permukaan API yang didukung untuk setiap model alih-alih mengasumsikan bahwa gateway bersama membuat semua format permintaan dapat dipertukarkan.
Rute CometAPI yang dikutip dalam artikel ini mencakup Opus 5.5 dan GPT-6 Sol. Artikel ini tidak menetapkan rute CometAPI untuk Muse Wonder atau Wonder Full; gunakan rute penyedia yang dikonfirmasi saat mengevaluasi produk tersebut.
Conclusion
Tidak ada satu model pun yang menang di setiap beban kerja. Muse Wonder adalah kandidat terkuat untuk diuji guna perilaku agen persisten dan tugas rekayasa yang berjalan lama. Claude Opus 5.5 adalah kandidat kuat untuk pengodean luas, alur kerja berat di terminal, dan pekerjaan pengetahuan, serta memimpin nilai Artificial Analysis Intelligence Index yang dilaporkan oleh Meta. GPT-6 Sol menawarkan harga token standar konteks pendek terendah dan menarik untuk otomasi peka biaya. Tim produksi harus membuat pilihan akhir menggunakan kualitas tugas yang diterima, keandalan, latensi, percobaan ulang, penggunaan alat, dan total biaya pada beban kerja yang representatif.
FAQ
How can teams fairly test Muse Wonder, Opus 5.5, and GPT-6 Sol?
Gunakan set tugas nyata yang ditahan dengan kriteria penerimaan tetap, artefak input identik, dan izin alat yang terdokumentasi. Catat setiap versi model, pengaturan upaya, rangka agen, timeout, dan anggaran token. Jalankan uji berulang ketika output bervariasi, laporkan kegagalan serta keberhasilan, dan pisahkan perbandingan rangka bersama dari perbandingan sistem berkonfigurasi terbaik. Ini menghasilkan bukti yang berlaku untuk alur kerja Anda, bukan pengaturan tolok ukur tim lain.
Can an API gateway preserve agent state when switching models?
Alamat gateway bersama tidak dengan sendirinya menjamin keadaan percakapan portabel, pengenal panggilan alat, atau referensi respons tersimpan. Simpan catatan sisi aplikasi yang kanonik tentang pesan, output alat, dan status tugas yang tervalidasi. Uji status tiap rute dan semantik alat sebelum merutekan pekerjaan yang sedang berlangsung ke model lain; jika tidak, fallback yang lebih murah dapat kehilangan informasi yang diperlukan untuk menyelesaikan dengan benar.
How should teams budget for retries and human review?
Tentukan hasil yang diterima sebelum pengujian, lalu bagi total belanja model dan alat yang ditagihkan dengan hasil yang diterima. Laporkan tenaga tinjauan secara terpisah atau sertakan menggunakan tarif per jam yang dinyatakan. Hitung upaya gagal, panggilan korektif, dan model fallback, dan bandingkan tugas yang tipikal serta berbiaya tinggi. Ini mencegah menganggap harga token yang lebih rendah sebagai jaminan penurunan biaya pekerjaan yang bermanfaat.
What should a memory-sensitive agent evaluation include?
Uji apakah agen mengingat fakta relevan, menggabungkan koreksi, mengabaikan instruksi usang, dan menjaga proyek terpisah tetap terisolasi. Sertakan tindak lanjut yang tertunda dan pembaruan yang saling bertentangan alih-alih hanya satu prompt panjang. Periksa perilaku memori di tingkat aplikasi serta tingkat model, karena persistensi, pengambilan, dan penghapusan bergantung pada sistem yang diterapkan.