
TL;DR
OpenAI Decisions API dan TypeSafe Jev sama-sama mengembalikan keputusan yang dibatasi dengan dukungan probabilitas, bukan prosa generatif biasa. OpenAI menggunakan GPT-6 Luna melalui endpoint khusus; TypeSafe Jev adalah model System One yang berspesialisasi. Jev lebih murah pada tarif token masukan yang dipublikasikan ($0.042 versus $0.10 per juta), sementara OpenAI memiliki dukungan gambar native. Angka vendor yang ditinjau di sini tidak menetapkan pemenang akurasi atau kecepatan secara head-to-head.
Pokok-Pokok Utama
- Harga: Jev 58% lebih murah per token masukan pada tarif dasar yang dipublikasikan.
- Arsitektur: OpenAI Decisions API menggunakan GPT-6 Luna; Jev dibuat khusus untuk pemrosesan keputusan.
- Modalitas: OpenAI mendukung teks dan gambar; Jev berfokus pada teks dan masukan terstruktur.
- Benchmark: Klaim kecepatan vendor menggunakan baseline yang berbeda; bandingkan pada dataset berlabel yang sama.
- Pemilihan: Prioritaskan dukungan multimodal dan integrasi OpenAI, atau throughput teks saja dan biaya, tergantung aplikasi Anda.
Sekilas: OpenAI Decisions API vs Jev
Gambaran di bawah ini membandingkan endpoint keputusan yang didokumentasikan dan tarif dasar yang dipublikasikan, diperiksa pada 12 Oktober 2026. Akses model, batas, dan ketentuan layanan harus diverifikasi untuk akun penyebaran.
| Feature | OpenAI Decisions API | TypeSafe Jev |
|---|---|---|
| Provider | OpenAI | TypeSafe AI |
| Engine | GPT-6 Luna | Jev System One |
| Endpoint | POST /v1/decisions | POST /v1/systemone |
| Model identifier | gpt-6-luna | jev-1.13.0 / jev-latest |
| Inputs | Text + images | Text / structured text |
| Question types | Predicate (condition probability), choice (category), score (rubric) | Noul (probabilitas kondisi), choice (kategori), score (tingkat) |
| Request questions | Array with names | Object keyed by ID |
| Context limit | Not specified in the linked Decisions guide | 64K total; state + longest question ≤32K |
| Base input cost / 1M | USD 0.10 | USD 0.042 |
| Output token cost | No charge | No charge |
| Vendor speed statement | About 10× faster than Responses API | 70–500 ms end to end |
| Availability | Public beta | Early access in the launch announcement; verify current account access |
| Distinct advantage | Image-based decisions | Lower published input cost |
| Generative reasoning / coding | Not the output contract of this endpoint | Not the output contract of this endpoint |
Banyak alur kerja AI membutuhkan kategori, probabilitas, atau skor—bukan paragraf. Tiket dukungan perlu diarahkan; agen harus memilih tindakan yang disetujui; antrean tinjauan perlu mengidentifikasi masukan yang tidak pasti. Kedua produk menjadikan keputusan semacam itu sebagai keluaran API kelas satu.
OpenAI merilis Decisions API dalam beta pada 6 Oktober 2026. Endpoint GPT-6 Luna-nya menerima teks dan gambar. Jev adalah model System One khusus dari TypeSafe AI untuk evaluasi non-generatif, dengan pendekatan pelatihan yang dijelaskan sebagai Reinforcement Learning for Calibrated Decisions (RLCD).
Jenis pertanyaan dalam tabel mencakup tiga tugas bersama. Predicate milik OpenAI dan noul milik Jev memperkirakan apakah suatu kondisi benar, seperti niat pengembalian dana atau kelayakan. Choice memilih dari kategori yang telah ditentukan, seperti Billing, Technical, dan Shipping, untuk perutean. Score mengevaluasi masukan terhadap rubrik atau tingkat, seperti urgensi atau prioritas. Deskripsi ini mengkonsolidasikan dua ikhtisar produk; skema permintaan dan semantik probabilitas tetap memerlukan penanganan spesifik penyedia.
Apa itu OpenAI Decisions API dan Jev?
OpenAI Decisions API dan TypeSafe Jev adalah layanan AI berfokus pada keputusan yang dirancang untuk mengubah data masukan menjadi keluaran terstruktur dan dibatasi alih-alih teks terbuka. Tidak seperti model bahasa besar tradisional yang menghasilkan penjelasan atau respons percakapan, API ini mengevaluasi pertanyaan yang telah ditentukan dan mengembalikan keputusan, probabilitas, atau skor. Ini membuatnya sangat berguna untuk alur kerja otomatis seperti perutean permintaan pelanggan, klasifikasi konten, penilaian risiko, dan pemilihan alat agen AI, di mana keluaran yang dapat diprediksi dan pemrosesan yang efisien sangat penting.
OpenAI Decisions API didukung oleh GPT-6 Luna dan beroperasi melalui endpoint /v1/decisions. Ini mendukung masukan teks dan gambar, dengan tiga jenis keputusan: predicate, choice, dan score. Keunggulan utamanya adalah menggabungkan pemahaman kontekstual model AI serbaguna dengan antarmuka keputusan khusus, sehingga cocok untuk klasifikasi multimodal dan aplikasi yang sudah terintegrasi dengan ekosistem OpenAI.
TypeSafe Jev, sebaliknya, adalah model keputusan khusus yang diakses melalui endpoint /v1/systemone. Ini berfokus pada evaluasi berbasis teks menggunakan tiga jenis pertanyaan: noul, choice, dan score. Jev menekankan inferensi yang efisien, prediksi terstruktur, dan kalibrasi probabilitas, menjadikannya opsi menarik untuk klasifikasi volume tinggi dan pipeline keputusan otomatis. Meskipun keduanya menangani masalah serupa, perbedaan dalam arsitektur, kemampuan masukan, harga, dan desain API dapat sangat memengaruhi mana yang lebih cocok untuk aplikasi tertentu.
Pendekatan Model, Batas Masukan, dan Cakupan
Perbandingan ini menyangkut perilaku API yang didokumentasikan dan pemposisian produk. OpenAI mengekspos GPT-6 Luna melalui endpoint keputusan, sementara TypeSafe memposisikan Jev sebagai model System One khusus. Deskripsi ini saja tidak menetapkan keunggulan akurasi atau mengungkap semua detail implementasi.
Jev mengizinkan 64K token di seluruh permintaan, dengan batas terpisah 32K untuk state ditambah pertanyaan terpanjang. Hitung instruksi pertanyaan dan kriteria serta masukan bersama. Panduan Decisions OpenAI yang ditautkan tidak menyatakan batas konteks numerik terpisah untuk endpoint ini; verifikasi batas yang berlaku alih-alih mengasumsikan bahwa angka jendela konteks model umum berlaku tanpa perubahan.
Benchmark penalaran generatif dan penyusunan kode berada di luar cakupan endpoint keputusan yang dibatasi ini. Untuk pembuatan penjelasan atau pembuatan kode, evaluasi endpoint generatif yang sesuai secara terpisah. Hasil untuk model serbaguna yang mendasari tidak menetapkan kinerja untuk endpoint Decisions.
Akurasi dan Latensi
Materi vendor yang dikutip tidak menyediakan pengujian berpasangan yang menetapkan pemenang akurasi atau latensi. Pernyataan kecepatan kira-kira 10× OpenAI membandingkan Decisions dengan Responses API miliknya. TypeSafe melaporkan latensi end-to-end 70–500 ms dan mengatakan evaluasi yang dipublikasikan umumnya dijalankan dari laptop di wilayah barat Amerika Serikat.
| Metric | OpenAI Decisions API | Jev | Assessment |
|---|---|---|---|
| Head-to-head accuracy | No matched test in the cited sources | No matched test in the cited sources | No winner |
| Speed | Relative vendor claim | Absolute vendor range | Not directly comparable |
| Calibration | Probabilities; separate confidence for choice/score | Probabilities; derived confidence for choice/score | Test observed calibration |
| Text categorization | Supported | Supported | Both viable |
| Visual categorization | Native images | No native images | OpenAI advantage |
Kalibrasi Probabilitas dan Ambang Tinjauan
Model bisa akurat tetapi kurang terkalibrasi. Di antara prediksi yang diberi probabilitas 0,90 untuk kelas terpilih, kira-kira 90% seharusnya benar jika probabilitas tersebut terkalibrasi pada distribusi evaluasi. Jangan mengganti field API yang disebut confidence untuk probabilitas ini tanpa memeriksa definisinya. Jev menurunkan confidence Choice dari distribusi probabilitasnya: confidence = (p_max − 1/n) / (1 − 1/n), di mana n adalah jumlah pilihan. Hasil Noul tidak memiliki field confidence terpisah. Ukur ECE dan skor Brier dari probabilitas yang sesuai, bersamaan dengan precision, recall, dan macro F1; pilih ambang tinjauan dari contoh berlabel.
Harga dan Biaya per Keputusan yang Diterima
OpenAI mencantumkan USD $0.10 per satu juta token masukan untuk /v1/decisions; Jev mencantumkan USD $0.042 per satu juta token masukan. Keduanya mencantumkan tanpa biaya token keluaran untuk layanan keputusan ini. Dengan tarif dasar tersebut, Jev 58% lebih murah per token masukan. Premi pemrosesan regional dan pengganda konteks panjang OpenAI dapat berlaku; percobaan ulang, prapemrosesan, dan tinjauan dapat menambah biaya alur kerja.
Asumsikan setiap permintaan menggunakan 500 token masukan yang ditagihkan pada kedua layanan. Ini adalah perhitungan ilustratif, bukan faktur vendor.
| Monthly decisions | Input tokens | OpenAI cost | Jev cost | Difference |
|---|---|---|---|---|
| 10,000 | 5M | $0.50 | $0.21 | $0.29 |
| 100,000 | 50M | $5.00 | $2.10 | $2.90 |
| 1,000,000 | 500M | $50 | $21 | $29 |
| 10,000,000 | 5B | $500 | $210 | $290 |
| 100,000,000 | 50B | $5,000 | $2,100 | $2,900 |
Biaya per keputusan benar yang diterima = (pengeluaran API + pengeluaran percobaan ulang + pengeluaran tinjauan manusia) / jumlah keputusan benar yang diterima. Tarif per token yang rendah dapat diimbangi oleh tingkat salah rute atau eskalasi yang lebih tinggi.
Untuk alur kerja GPT-6 Luna konvensional, tabel harga model CometAPI mencantumkan tarif USD per satu juta token, diperiksa pada 12 Oktober 2026. Ini adalah tarif endpoint model; halaman yang ditautkan menampilkan contoh Responses API dan tidak menetapkan dukungan native untuk /v1/decisions atau harganya.
| Published tier | Input / 1M tokens | Output / 1M tokens |
|---|---|---|
| Short context (page condition: ≤272,000 tokens) | $0.08 | $0.40 |
| Long context (as listed on the page) | $0.16 | $0.60 |
Token keluaran biasa GPT-6 Luna di CometAPI ditagihkan. Pisahkan estimasi ini dari dua layanan keputusan di atas, yang biaya token keluarannya dipublikasikan nol. Misalnya, 500 token masukan plus 20 token keluaran berbiaya $0.000048 per permintaan konteks pendek, atau $48 per satu juta permintaan, sebelum biaya lainnya. Konfirmasikan tier yang berlaku dan tarif akun di katalog model live sebelum membuat anggaran.
Alur Kerja Agen dan Pertukaran Modalitas
Keduanya dapat merutekan panggilan alat, mengevaluasi apakah kondisi penjaga terpenuhi, atau memberi skor suatu tindakan. Tidak ada yang menggantikan otorisasi, validasi masukan, atau izin alat eksplisit. Untuk otomasi visual, dukungan gambar native OpenAI menyederhanakan pipeline; untuk perutean teks murni, biaya dasar Jev yang lebih rendah bisa menarik.
Penanganan keluaran berbeda di batas respons. OpenAI mengembalikan sebuah answers array, dengan name yang mengidentifikasi pertanyaan; Jev mengembalikan sebuah answers object yang dikunci oleh ID pertanyaan. Normalkan struktur ini sebelum menerapkan aturan bisnis bersama. Jev menurunkan confidence dari distribusi probabilitasnya; jangan berasumsi field yang bernama sama memiliki makna yang setara di berbagai penyedia. Validasi label dan kalibrasikan ambang tinjauan pada data aplikasi.
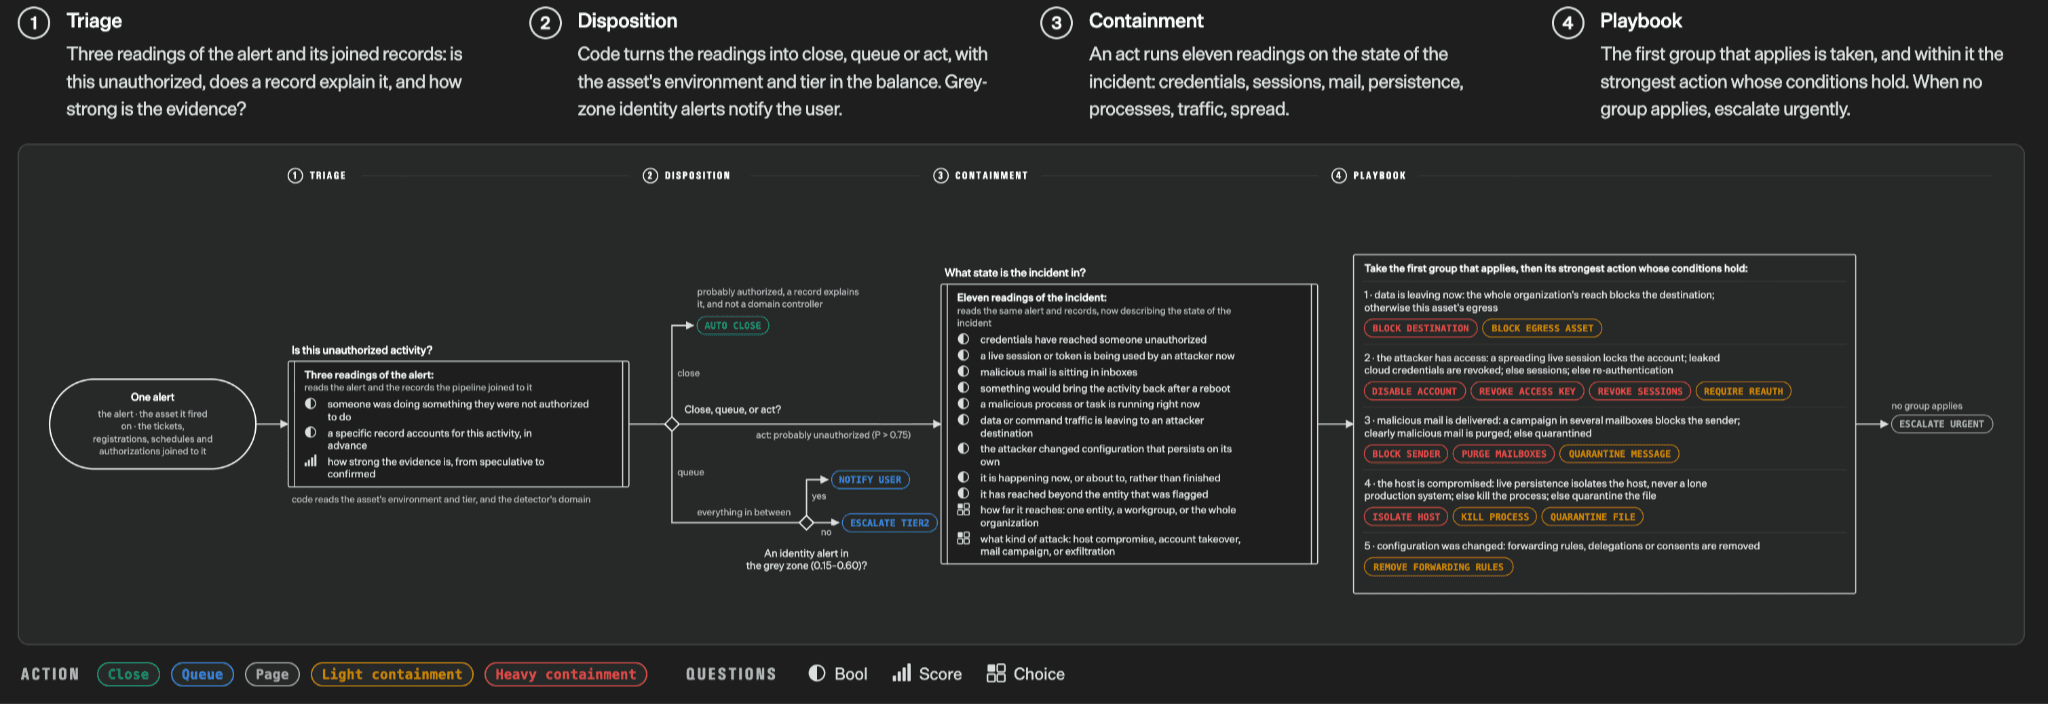
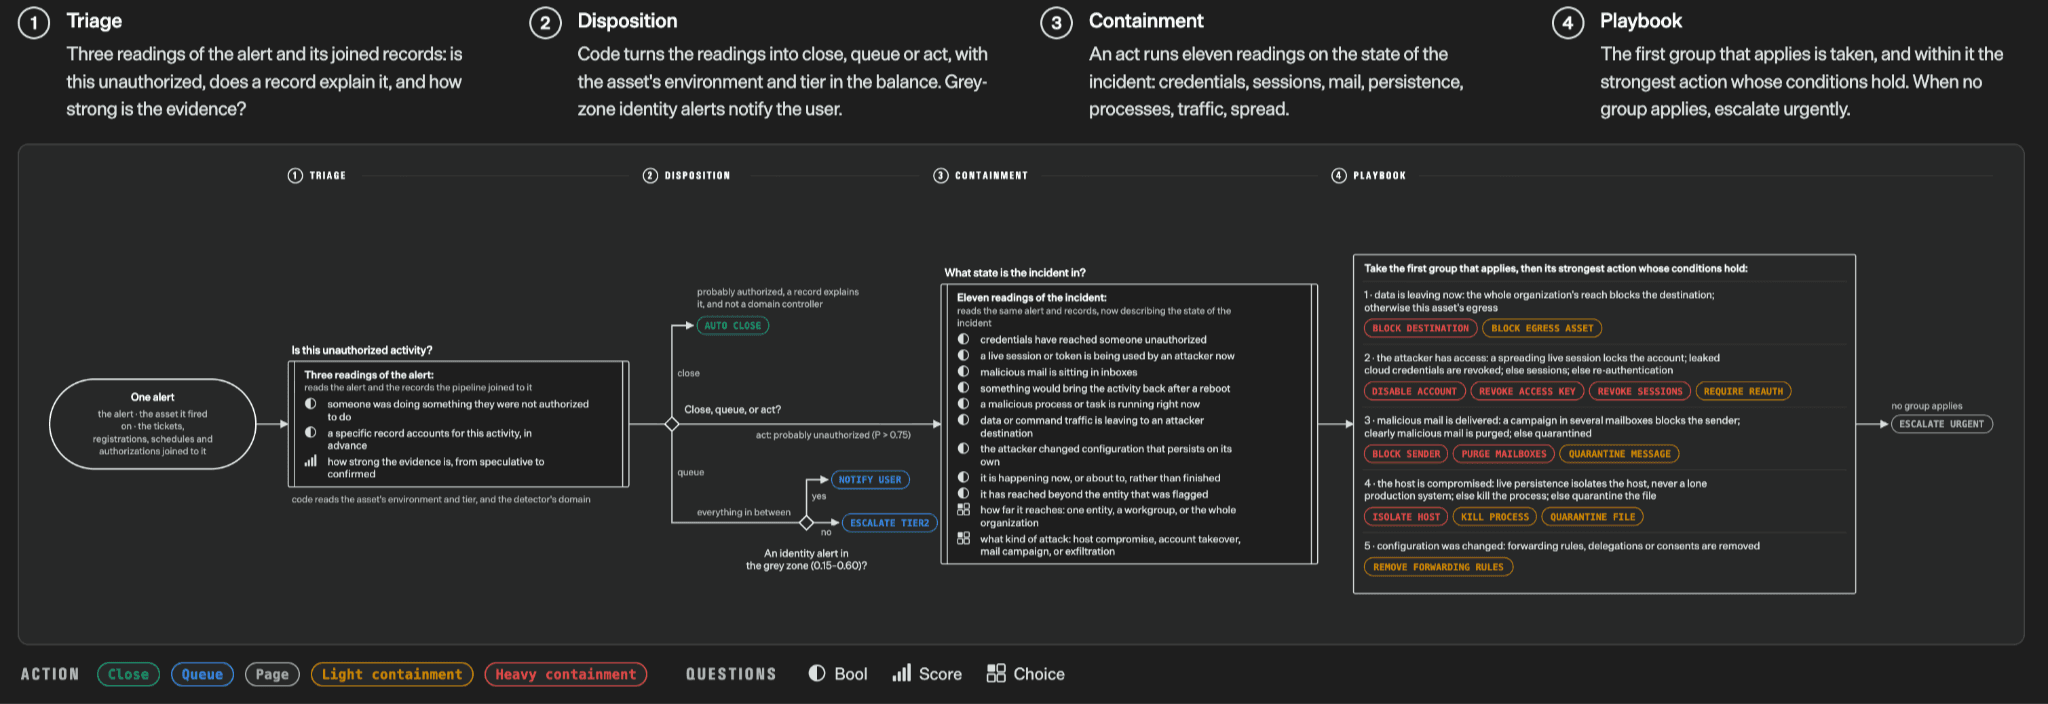
Sumber: Introducing System One Models & Jev; gambar asli. Ini mengilustrasikan komposisi alur kerja, bukan benchmark berpasangan terhadap OpenAI Decisions API.
Perbedaan Penggunaan API: OpenAI Decisions API vs Jev
Akses harus dikonfigurasi secara terpisah untuk masing-masing penyedia: setiap contoh di bawah menggunakan host dan kunci API sendiri. OpenAI mendokumentasikan Decisions sebagai endpoint beta publik. Untuk Jev, konfirmasikan akses dan kredensial saat ini dengan TypeSafe sebelum penyebaran. Untuk kedua layanan, verifikasi izin akun, ketersediaan regional, kuota, dan ketentuan layanan; contoh permintaan tidak menjamin akses produksi. Akses pihak ketiga ke model generatif tidak dengan sendirinya mengonfirmasi dukungan untuk endpoint keputusan native.
Cara menggunakan OpenAI Decisions API
Konsepnya tumpang tindih, tetapi skema permintaan berbeda. OpenAI mengirimkan input dan array pertanyaan bernama; Jev menggunakan state dan objek questions yang dikunci oleh ID pertanyaan. Implementasikan adapter khusus penyedia sebelum menerapkan kebijakan keputusan bersama.
Rutekan tiket dukungan dengan OpenAI Decisions API.
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "I was charged twice for my order.",
    "questions": [{
      "type": "choice", "name": "department",
      "instructions": "Which team should handle this?",
      "choices": [
        {"value":"billing","description":"Charges and refunds"},
        {"value":"technical","description":"Product errors"},
        {"value":"other","description":"Other requests"}
      ]
    }]
  }'
Cara menggunakan Jev API
Permintaan cURL berikut menggunakan endpoint System One Jev untuk mengklasifikasikan tiket dukungan. Setel TYPESAFE_API_KEY di lingkungan Anda, tempatkan tiket di state, dan definisikan department di dalam objek questions. Peta criteria mencantumkan label perutean yang diizinkan dan deskripsinya. Setelah permintaan berhasil, baca entri department di answers dan validasi label yang dipilih sebelum merutekan tiket. Konfirmasikan bahwa pengidentifikasi model tersedia untuk akun Anda.
Rutekan tiket dukungan dengan TypeSafe Jev.
curl https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-1.13.0",
    "state": "I was charged twice for my order.",
    "questions": {
      "department": {
        "type": "choice",
        "instructions": "Which team should handle this?",
        "criteria": {
          "billing":"Charges and refunds",
          "technical":"Product errors",
          "other":"Other requests"
        }
      }
    }
  }'
| Integration element | OpenAI | Jev |
|---|---|---|
| Input | input | state |
| Questions | Array | Keyed object |
| Question ID | name | Object key |
| Binary question | predicate | noul |
| Choices | choices | criteria |
| Answer shape | answers array | answers object |
Kebijakan Tinjauan Bersama untuk Probabilitas Kelas Terpilih
Terapkan ambang batas yang terkalibrasi secara eksplisit pada probabilitas kelas terpilih.
from dataclasses import dataclass
from math import isfinite

@dataclass
class NormalizedDecision:
    label: str | None
    selected_probability: float | None
    provider: str
    needs_review: bool

def apply_review_policy(label, selected_probability, provider, threshold):
    if not isfinite(threshold) or not 0.0 <= threshold <= 1.0:
        raise ValueError("threshold must be between 0 and 1")
    valid_probability = (
        selected_probability is not None
        and isfinite(selected_probability)
        and 0.0 <= selected_probability <= 1.0
    )
    return NormalizedDecision(
        label=label,
        selected_probability=selected_probability,
        provider=provider,
        needs_review=(
            not label
            or not valid_probability
            or selected_probability < threshold
        ),
    )
Contoh Python 3.10+ ini adalah lapisan kebijakan aplikasi, bukan parser respons API. Setiap adapter penyedia harus memvalidasi respons dan mengekstrak probabilitas kelas terpilih. Jangan meneruskan field confidence mentah Jev sebagai selected_probability. Berikan ambang yang terkalibrasi untuk penyedia, pertanyaan, dan dataset evaluasi tersebut; tangani penolakan dan kesalahan transport sebelum memanggil kebijakan.
OpenAI Decisions API vs Jev: Cara memilih
Pilih dalam dua tahap. Pertama, saring persyaratan penyebaran: masukan gambar, akses akun, batas masukan, dan upaya integrasi. Lalu benchmark layanan yang memenuhi syarat pada beban kerja berlabel yang sama. Untuk perutean teks saja, uji apakah harga masukan Jev yang lebih rendah diterjemahkan menjadi biaya total yang lebih rendah; untuk keputusan yang bergantung pada gambar, evaluasi jalur gambar native OpenAI. Bandingkan salah rute, kalibrasi, latensi ekor, percobaan ulang, dan tinjauan manusia pada target kualitas yang disepakati. Tabel di bawah adalah daftar pendek awal, bukan bukti pemenang kinerja keseluruhan.
| Use case | OpenAI Decisions API | Jev | Practical recommendation |
|---|---|---|---|
| Support routing | Supported | Supported | Benchmark Jev first for cost |
| Text categorization | Supported | Supported | Compare calibration |
| Screenshot inspection | Native | Requires vision preprocessing | OpenAI |
| Agent tool selection | Supported | Supported | Measure end-to-end outcomes |
| Multimodal moderation | Text and images | Text only | OpenAI |
| Existing OpenAI stack | Native | New integration | OpenAI |
Untuk otomasi bisnis volume tinggi, seperti perutean dukungan dan klasifikasi teks, Jev layak diprioritaskan saat biaya masukan dan throughput menjadi perhatian utama. Untuk aplikasi multimodal, termasuk inspeksi tangkapan layar, moderasi visual, dan keputusan berbasis gambar, OpenAI Decisions API adalah opsi yang lebih praktis karena dukungan gambar native. Untuk agen AI dan alur kerja perusahaan, pilihan bergantung pada infrastruktur yang ada, kompleksitas integrasi, dan konsekuensi dari keputusan yang salah. OpenAI mungkin menawarkan jalur yang lebih mulus bagi tim yang sudah menggunakan ekosistemnya, sementara Jev patut dipertimbangkan untuk beban kerja teks skala besar. Dalam semua skenario, keputusan akhir harus didasarkan pada akurasi terukur, kalibrasi probabilitas, latensi, dan total biaya operasional, bukan hanya harga utama.
Bagaimana Seharusnya Anda Membandingkan (Benchmark) OpenAI Decisions API dengan Jev?
Jalankan kedua layanan pada masukan dunia nyata yang sama dan berlabel, dengan definisi pertanyaan serta wilayah klien yang cocok. Lacak akurasi, macro F1, ECE, skor Brier, latensi p50/p95/p99, timeouts, penolakan, tingkat tinjauan, dan biaya dolar per keputusan benar yang diterima.
| Dimension | Recommended metrics | Why it matters |
|---|---|---|
| Classification | Accuracy, precision, recall, macro F1 | Quality of labels |
| Calibration | ECE, Brier score | Reliability of probabilities |
| Latency | p50 / p95 / p99 | Operational responsiveness |
| Reliability | 429 / timeout / refusal rate | Production behavior |
| Economics | Cost per accepted correct decision | Real operating expense |
Prosedur yang disarankan: bangun set berlabel yang representatif; sertakan kasus ambigu dan di luar distribusi; kirim tugas yang secara semantik identik; ulangi permintaan cukup banyak untuk mengukur varians; kalibrasikan ambang masing-masing sistem secara independen; dan bandingkan biaya end-to-end termasuk eskalasi dan percobaan ulang.
Kesimpulan
Pilih OpenAI Decisions API saat keputusan bergantung pada bukti gambar atau ketika integrasi OpenAI yang ada mengurangi pekerjaan penyebaran. Evaluasi Jev untuk beban kerja keputusan teks saja di mana tarif token masukan yang dipublikasikan lebih rendah dapat mengurangi pengeluaran inferensi. Ukur kualitas label, kalibrasi, latensi ekor, dan beban kerja tinjauan pada data aplikasi yang sama sebelum memilih.
Jev memiliki harga dasar token masukan yang dipublikasikan lebih rendah; OpenAI Decisions API memiliki masukan gambar native. Angka vendor yang dikutip tidak menetapkan pemenang akurasi atau kecepatan secara keseluruhan. Pilihan terbaik bergantung pada biaya dan kualitas keputusan yang diterima dalam alur kerja lengkap.
Pengembang dapat menggunakan GPT-6 Luna API di CometAPI untuk membuat prototipe klasifikasi ringan dalam alur kerja multi-model yang lebih luas. Halaman model yang ditautkan menyediakan contoh Responses API. Akses ke endpoint generatif tersebut tidak menetapkan dukungan untuk endpoint
/v1/decisionsnative. Ini adalah prototipe pembuatan teks konvensional. Ia tidak mengembalikan skema jawaban Decisions native atau distribusi probabilitas kelas yang terkalibrasi. Validasi label yang dikembalikan terhadap kategori yang diizinkan dan tangani kesalahan API sebelum menghubungkannya ke tindakan hilir. Konfirmasikan dukungan/v1/decisionsnative secara terpisah jika endpoint itu diperlukan.