Bangun dengan CometAPIButuh satu API untuk banyak model?Uji alur kerja di Playground, lalu buat API key saat model dan biayanya sesuai dengan use case Anda.
Apa itu Prompt Caching? OpenAI vs Claude vs Gemini pada 2026
Harap berikan teks atau berkas yang ingin diterjemahkan ke Bahasa Indonesia. Saya akan mempertahankan seluruh struktur dan elemen teknis, serta hanya menerjemahkan teks yang dapat dibaca.
Caching prompt memungkinkan model bahasa menggunakan kembali prefiks prompt yang telah diproses sebelumnya alih-alih mengulangi komputasi input yang sama. Ini dapat menurunkan biaya token input dan meningkatkan latensi, terutama untuk alur kerja agen, dukungan pelanggan, RAG, dan analisis dokumen besar. Pada 2026, OpenAI menawarkan caching otomatis dan kontrol cache eksplisit yang lebih baru, Claude mendukung caching otomatis dan breakpoint cache tingkat blok, dan Gemini menekankan caching implisit untuk model terbarunya. Penyedia mengenakan biaya berbeda untuk penulisan cache, pembacaan, dan, jika berlaku, penyimpanan. Kedaluwarsa dapat memicu penulisan ulang atau biaya input penuh, sehingga penghematan aktual bergantung pada frekuensi penggunaan ulang dan hit cache yang terukur.
Panduan ini membandingkan cache prompt di GPT-6.1 Sol, Claude Opus 5.5, dan Gemini 4 Argon untuk pengembang yang membangun aplikasi dengan input berulang. Fokusnya pada kontrol cache, harga, dan cara memverifikasi penggunaan ulang.
Poin Penting
Cache prompt menggunakan kembali input yang telah diproses—bukan jawaban model sebelumnya.
Ditinjau untuk kejelasan, atribusi sumber, dan terminologi API terkini.
Cache prompt OpenAI bergantung pada prefiks stabil, fitur model yang didukung, serta minimum dan retensi spesifik model.
Cache prompt Claude menawarkan TTL 5 menit dan opsional 1 jam dengan kontrol cache otomatis dan eksplisit.
Caching konteks Gemini bersifat implisit pada model modern; cache eksplisit tetap bergantung pada model.
Penghematan cache prompt bergantung pada penulisan, pembacaan, penyimpanan, dan hit aktual; verifikasi dukungan endpoint dan penagihan token cache saat menggunakan CometAPI.
Apa itu Prompt Caching pada LLM?
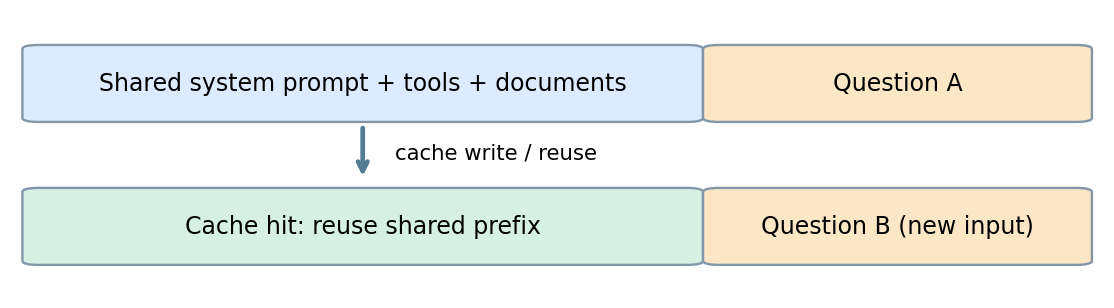
Cache prompt adalah optimasi inferensi yang memungkinkan penggunaan kembali state komputasi yang diturunkan dari prefiks yang telah diproses sebelumnya. Sebuah prompt sering memuat instruksi stabil, definisi tool, atau dokumen yang diikuti oleh pertanyaan pengguna yang berubah. Jika permintaan berikutnya mengulang prefiks yang memenuhi syarat, penyedia dapat menggunakan kembali state kunci-nilai (KV) yang dicache dan hanya memproses sisa yang belum dicache. Tidak seperti cache respons, ini tidak memutar ulang jawaban sebelumnya: model menghasilkan respons baru untuk permintaan saat ini.
Alur Kerja Cache Prompt:
Permintaan pertama: kirim prefiks besar yang dapat diulang dan satu pertanyaan spesifik.
Pembuatan cache: penyedia menyimpan state komputasi menengah yang memenuhi syarat.
Permintaan berikutnya: gunakan kembali prefiks identik dan ganti pertanyaannya.
Pembacaan cache: token yang telah diproses sebelumnya digunakan kembali sementara token baru diproses seperti biasa.
Ilustrasi konseptual dari draf asli: materi prompt yang berulang mendahului pertanyaan yang berubah. Ini bukan diagram arsitektur resmi dari penyedia.
Prinsip desain umum adalah stabilitas prefiks. Kontrak API, keluarga model yang memenuhi syarat, masa hidup cache, dan biaya tidak dapat dipertukarkan.
Sekilas tentang Caching OpenAI, Claude, dan Gemini
Prinsip prefiks stabil yang sama berlaku di semua penyedia, tetapi kontrol di bawah ini spesifik untuk model yang digunakan dalam panduan ini. Periksa model dan endpoint bersama-sama sebelum menyalin suatu pengaturan.
Opsional melalui cache_control pada tingkat permintaan atau blok konten
Caching implisit aktif secara default
Prefiks minimum
1,024 token input yang terlihat
512 token sebelum batas cache
4,096 token input
Kontrol masa berlaku
Responses API: prompt_cache_options.ttl; default 30m atau 12h
Default 5 menit; opsi TTL 1 jam
Masa berlaku implisit yang dikelola penyedia
Tempat menaruh konten stabil
Instruksi awal, tool, dan materi referensi
Definisi tool yang stabil, konten sistem, atau blok pesan sebelum breakpoint
Konten bersama berukuran besar di awal prompt
Bidang penggunaan untuk diperiksa
input_tokens_details.cached_tokens dan penggunaan penulisan cache yang dilaporkan
cache_creation_input_tokens dan cache_read_input_tokens
cached_content_token_count di usage_metadata, jika ada
Pembedaan penting
prompt_cache_key dapat memisahkan pembukuan; tidak wajib untuk perutean otomatis Sol
Breakpoint harus diakhiri pada konten yang tetap tidak berubah
Tidak ada resource cache eksplisit untuk Argon; model lama yang didukung menyediakan antarmuka terpisah
Kontrol Cache Prompt dan Contoh Python
Setiap contoh mengirim materi referensi yang sama dengan dua pertanyaan berbeda. Biarkan konten bersama tetap tidak berubah, jalankan permintaan secara berurutan, dan periksa usage untuk melihat apakah permintaan kedua benar-benar menggunakan kembali input yang dicache.
OpenAI: Kontrol Cache dan Contoh Python
OpenAI secara otomatis mencocokkan prefiks prompt yang memenuhi syarat untuk cache dan, pada model lebih baru yang didukung, mengizinkan konfigurasi breakpoint dan retensi eksplisit. Penggunaan kembali cache sangat berguna ketika instruksi sistem yang panjang, skema tool, atau konteks repositori berulang di banyak permintaan. Panjang prefiks yang diperlukan dan pengali harga token bergantung pada generasi model dan tier retensi yang dipilih.
Contoh ini menggunakan Responses API dengan prompt_cache_options disetel ke mode implicit dan masa berlaku 30 menit. Generasi model sebelumnya menggunakan parameter retensi yang berbeda; ikuti pengaturan untuk model Anda yang tepat.
Instal SDK openai dan setel OPENAI_API_KEY. Gunakan setidaknya 1,024 token yang terlihat dalam prefiks stabil. Jalankan kedua permintaan secara berurutan dan periksa input_tokens_details.cached_tokens dan cache_write_tokens di usage. Hitungan token cache yang positif mengonfirmasi pembacaan cache yang ditagih; ini tidak menjanjikan latensi yang lebih rendah pada setiap permintaan.
Untuk menjalankan contoh, instal SDK Python yang relevan, setel kunci API penyedia, dan buat file UTF-8 reference.txt yang berisi konten stabil yang cukup untuk memenuhi minimum caching model tersebut.
from pathlib import Path
from openai import OpenAI

client = OpenAI()  # Reads OPENAI_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
questions = ["Summarize the architecture.", "Identify the main technical risks."]
for question in questions:
    response = client.responses.create(
        model="gpt-6.1-sol",
        instructions="Use the following reference material.\n" + shared,
        input=question,
        prompt_cache_key="docs-assistant-v1",
        prompt_cache_options={"mode": "implicit", "ttl": "30m"},
    )
    print(response.output_text)
    print(response.usage)
Claude: Kontrol Cache dan Contoh Python
Di Claude Messages API, cache prompt bersifat opt-in. Tambahkan cache_control pada tingkat permintaan untuk penempatan breakpoint otomatis, atau sematkan ke blok konten untuk menandai breakpoint eksplisit. Pengembang dapat menandai instruksi stabil, dokumen, dan blok prompt tertentu, sementara input pengguna di bagian akhir berubah. Cache standar berdurasi singkat adalah lima menit, dengan opsi satu jam untuk beban kerja yang sesuai.
Instal SDK anthropic dan setel ANTHROPIC_API_KEY. Untuk Claude Opus 5.5, sediakan setidaknya 512 token sebelum batas cache. Biarkan blok system identik di seluruh permintaan. Entri cache tersedia saat respons pertama mulai; contoh ini menunggu respons penuh untuk menjaga demonstrasi tetap sederhana. Periksa hitungan pembuatan dan pembacaan cache; prefiks pendek dapat mengembalikan nol untuk keduanya tanpa error.
from pathlib import Path
import anthropic

client = anthropic.Anthropic()  # Reads ANTHROPIC_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Summarize the architecture.", "Identify the main technical risks."]:
    response = client.messages.create(
        model="claude-opus-5-5",
        max_tokens=1024,
        system=[{
            "type": "text",
            "text": shared,
            "cache_control": {"type": "ephemeral"},
        }],
        messages=[{"role": "user", "content": question}],
    )
    print(response.content)
    print(response.usage.cache_creation_input_tokens)
    print(response.usage.cache_read_input_tokens)
Gemini: Caching Implisit dan Contoh Python
Google menyebut implementasinya context caching. Gemini 4 Argon menggunakan caching implisit dan tidak mendukung resource cache eksplisit. Beberapa keluarga model sebelumnya mendukung cache eksplisit dengan TTL yang dapat dikonfigurasi. Pilih antarmuka caching dari kontrak model masing-masing alih-alih mengasumsikan semua model Gemini mengekspos kontrol yang sama.
Instal google-genai dan setel GEMINI_API_KEY. Gunakan setidaknya 4,096 token konten awal bersama untuk Gemini 4 Argon, dan kirim permintaan kedua segera setelah yang pertama. Periksa cached_content_token_count di usage_metadata jika ada. Caching implisit dapat luput meskipun prefiks memenuhi syarat.
from pathlib import Path
from google import genai

client = genai.Client()  # Reads GEMINI_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Summarize the architecture.", "Identify the main technical risks."]:
    response = client.models.generate_content(
        model="gemini-4-argon",
        contents=shared + "\nQuestion: " + question,
    )
    print(response.text)
    print(response.usage_metadata)
Berapa Biaya Cache Prompt di OpenAI, Claude, dan Gemini?
Biaya caching harus dievaluasi sebagai kombinasi penulisan, pembacaan, dan—pada beberapa sistem cache eksplisit—retensi atau penyimpanan. Pengali berikut mengilustrasikan desain umum dan bukan janji harga universal di seluruh versi model.
Kategori biaya
OpenAI
Claude
Gemini
Input tanpa cache
Tarif token input normal
Tarif token input normal
Tarif token input normal
Penulisan cache
Premi penulisan pada model terbaru dimungkinkan
Premi 5m/1h
Implisit atau eksplisit tergantung model
Pembacaan cache
Tarif lebih rendah khusus model
Tarif lebih rendah khusus model
Tarif lebih rendah khusus model
Masa berlaku cache
Khusus model
5m / 1h
Dikelola implisit / dapat dikonfigurasi secara eksplisit
Penyimpanan tambahan
Bergantung pada model
Biasanya tercermin pada tier penulisan
Biaya penyimpanan eksplisit dapat berlaku
Contoh ilustratif: prefiks 10.000 token digunakan ulang di N permintaan, penulisan cache awal biayanya 1,25 kali input biasa, dan pembacaan cache berikutnya biayanya 0,1 kali input biasa. Asumsikan harga input dasar $2 per satu juta token dan hit cache sempurna setelah permintaan pertama.
Jumlah permintaan
Tanpa caching
Dengan caching
Penghematan pada prefiks yang digunakan ulang
10
$0.200
$0.043
78.50%
100
$2.000
$0.223
88.85%
Formula: Biaya prefiks yang dicache = 1.25P + (N − 1) × 0.1P, di mana P adalah biaya biasa untuk memproses prefiks bersama sekali. Contoh ini tidak memasukkan input dinamis, output, kedaluwarsa, miss, penyimpanan, dan layanan lain.
Contoh di atas menggunakan tarif baca ilustratif 10%, bukan tarif saat ini GPT-6.1 Sol. Sol's standard short-context pricing adalah $2 per satu juta token input tanpa cache, $0.10 per satu juta token input yang dicache, dan $2.50 per satu juta token yang ditulis dengan masa berlaku default. Hitung ulang contoh menggunakan model, tier, dan tagihan endpoint aktual Anda.
Masa berlaku yang lebih lama hanya layak jika mencegah cukup banyak penulisan ulang atau permintaan tanpa cache untuk mengimbangi harganya. Penulisan 5 menit dan 1 jam Claude ditagih masing-masing 1,25× dan 2× dari input dasar. Cache eksplisit Gemini pada model lama yang didukung juga dapat menimbulkan biaya penyimpanan. Ukur penggunaan ulang di sela waktu idle nyata, bukan hanya deretan panggilan beruntun.
Perlakukan miss, kedaluwarsa, dan generasi output sebagai bagian dari tagihan. Jika prefiks kedaluwarsa sebelum digunakan ulang, permintaan berikutnya mungkin memerlukan penulisan ulang atau pemrosesan input penuh. Prompt pendek mungkin tidak memenuhi syarat sama sekali, sementara jawaban panjang dapat membuat token output menjadi biaya terbesar bahkan dengan penggunaan ulang cache yang kuat. Bandingkan total biaya per tugas yang diselesaikan sebelum menambah kerumitan caching.
API Cache Prompt Mana yang Terbaik untuk Berbagai Beban Kerja?
Untuk agen pengodean dan dukungan pelanggan, letakkan definisi tool, konteks repositori, kebijakan, dan pengetahuan yang stabil sebelum tugas yang berubah. OpenAI dan Claude menawarkan kontrol breakpoint yang membantu mendefinisikan batas yang dapat digunakan ulang; evaluasi pembacaan cache aktual dari endpoint alih-alih mengasumsikan bahwa teks yang berulang pasti dicache.
Untuk analisis dokumen dan pekerjaan multimodal, tempatkan dokumen sumber atau media yang didukung sebelum pertanyaan. Pendekatan implisit Gemini mengurangi kerja manajemen cache, sementara Claude memungkinkan Anda menandai blok stabil secara langsung. Periksa dukungan untuk jenis media dan model tertentu sebelum mengandalkan penggunaan ulang.
Untuk percakapan panjang, tambahkan giliran baru alih-alih terus menulis ulang bagian awal, dan pilih masa berlaku yang tersedia yang sesuai dengan jeda antar giliran. Jika aplikasi Anda membutuhkan resource cache bernama yang dapat dibuat dan direferensikan secara eksplisit, evaluasi model Gemini yang mendukung antarmuka tersebut; Argon tidak.
Tidak ada pemenang universal: bandingkan tingkat hit cache, biaya per tugas yang diselesaikan, dan latensi di bawah pola trafik Anda yang sebenarnya.
Bagaimana Cache Prompt Mempengaruhi Latensi dan Performa?
Hit cache mengurangi pemrosesan input yang berulang dan dapat mempersingkat waktu ke token pertama. Ini tidak serta merta meningkatkan kualitas jawaban atau mempercepat generasi output, dan input yang dicache tetap menempati jendela konteks. Ukur latensi token pertama dan waktu respons total pada permintaan yang sebanding; hit cache saja bukan bukti bahwa pengguna menerima jawaban akhir lebih cepat.
Cara Mengoptimalkan Cache Prompt dan Mengatasi Miss
Mulai dengan Prefiks yang Stabil dan Berguna
Tempatkan instruksi, definisi tool, kebijakan, dan dokumen yang dapat digunakan ulang di awal; letakkan stempel waktu, ID permintaan, konteks yang berubah, dan pertanyaan pengguna setelahnya. Jaga urutan tool dan skema tetap stabil. Saat menggunakan cache eksplisit, akhiri breakpoint pada blok terakhir yang tidak berubah. Tambahkan materi referensi yang berguna saat membantu tugas; jangan membengkakkan setiap permintaan hanya demi mengejar metrik cache.
Jika Token Cache Tetap Nol
Periksa kelayakan sebelum mengubah prompt: konfirmasi model, endpoint, panjang token minimum, dan pengaturan kontrol cache yang diperlukan secara tepat. Lalu kirim dua permintaan berurutan dengan konten bersama yang identik. Periksa pembuatan cache dan pembacaan cache secara terpisah; permintaan pertama dapat membuat entri yang dapat digunakan ulang oleh permintaan berikutnya. Cache implisit layak untuk kena, bukan dijamin kena.
Untuk Claude, permintaan di bawah minimum dapat mengembalikan nol token pembuatan cache dan pembacaan cache tanpa error. Entri cachenya tersedia saat respons pertama mulai. Panduan caching Claude juga menjelaskan bagaimana penempatan breakpoint dan perubahan pengaturan permintaan memengaruhi penggunaan ulang.
Jika Hit Menghilang di Antara Permintaan
Bandingkan payload aktualnya, bukan hanya template prompt. Cari teks dokumen yang berubah, tool yang tertukar urutannya, skema yang diubah, giliran percakapan awal yang ditulis ulang, atau bidang dinamis yang disisipkan sebelum batas yang dapat digunakan ulang. Periksa waktu berlalu sejak permintaan sebelumnya dan apakah masa berlaku yang dipilih mencakupnya. Ubah satu variabel pada satu waktu dan catat usage yang dihasilkan.
Jika Hit Tidak Menghasilkan Penghematan
Pisahkan input yang dicache, penulisan, input tanpa cache, output, dan biaya penyimpanan apa pun. Penulisan berulang setelah jeda idle, penggunaan ulang rendah, atau jawaban panjang dapat melebihi diskon input. Gunakan perhitungan biaya di atas dengan usage yang terukur dan tarif penagihan aktual endpoint. Pertahankan optimasi hanya jika itu meningkatkan total biaya tugas atau latensi yang terlihat oleh pengguna.
Periksa Dukungan Endpoint dan Batasan Data
Endpoint kompatibilitas dapat menerima permintaan tanpa mengekspos kontrol caching atau bidang usage yang sama seperti API native. Konfirmasikan dukungan parameter dan bandingkan usage yang dikembalikan dengan penagihan akun sebelum menganggap penggunaan ulang sebagai penghematan. Pertahankan isolasi tenant dan kontrol akses, serta ikuti kebijakan retensi dan pemrosesan data penyedia. Caching tidak menggantikan kontrol tersebut.
Bagaimana Menggunakan Cache Prompt dengan CometAPI?
CometAPI menawarkan satu titik integrasi untuk menguji permintaan di berbagai keluarga model. Untuk caching, verifikasi kontrol spesifik penyedia mana yang diterima endpoint yang dipilih dan bagaimana input yang dicache muncul di usage dan penagihan. Pengembang dapat memusatkan pengujian model sambil mempertahankan validasi terpisah untuk perilaku caching dan pembukuan, karena opsi native penyedia tidak dijamin identik di seluruh proxy atau endpoint kompatibilitas.
Untuk penyiapan spesifik model, lihat halaman CometAPI untuk GPT-6.1 Sol, Claude Opus 5.5, dan Gemini 4 Argon. Konfirmasikan bahwa endpoint pilihan Anda mendukung perilaku caching yang Anda butuhkan.
Instal SDK openai dan setel COMETAPI_KEY. Contoh ini mengirim permintaan dengan prefiks berulang melalui antarmuka Chat Completions yang kompatibel dengan OpenAI milik CometAPI. Konfirmasikan ketersediaan model, lalu periksa usage yang dikembalikan dan penagihan akun untuk bukti penggunaan ulang cache. Jangan menyalin parameter cache Responses API ke endpoint ini tanpa memeriksa dukungan.
import os
from pathlib import Path
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Summarize the architecture.", "Identify the main technical risks."]:
    response = client.chat.completions.create(
        model="gpt-6.1-sol",
        messages=[
            {"role": "system", "content": shared},
            {"role": "user", "content": question},
        ],
    )
    print(response.choices[0].message.content)
    print(response.usage)
Kesimpulan
Untuk aplikasi AI dengan penggunaan berulang yang tinggi, cache prompt dapat memberikan perbedaan material pada ekonomi inferensi. OpenAI memberi pengembang kontrol prompt dan retensi yang semakin detail; Claude menyediakan kontrol otomatis dan tingkat blok yang nyaman; Gemini membuat penggunaan ulang implisit menjadi sederhana pada model modern. Implementasi yang tepat bergantung pada volume prompt stabil, tingkat hit, kedaluwarsa, dan total biaya. Mulailah dengan prefiks bersama yang jelas, verifikasi telemetri usage, lalu optimalkan retensi dan pemilihan penyedia menggunakan pengukuran yang menyerupai produksi.
FAQ
Bagaimana saya bisa membandingkan penyedia caching secara adil?
Putar ulang dokumen sumber yang sama-sama berguna dan pertanyaan yang setara, tetapi gunakan hitungan token masing-masing penyedia dan tarif penagihan aktual. Jaga kebutuhan output tetap sebanding dan laporkan permintaan yang tidak berhasil serta yang berhasil. Jumlah karakter tetap tidak menyiratkan jumlah token yang sama, jadi bandingkan biaya per tugas yang diselesaikan bersama pengukuran hit cache.
Haruskah saya mencache setiap dokumen dalam basis pengetahuan yang berubah?
Kelompokkan dokumen berdasarkan seberapa sering mereka berubah dan seberapa sering mereka digunakan ulang. Dokumen yang sering diperbarui dapat berulang kali membatalkan prefiks bersama yang besar; menempatkan materi kebijakan yang stabil di depan dan materi yang berubah di belakang dapat mengurangi paparan tersebut. Versikan materi sumber secara sengaja dan segarkan saat akurasi membutuhkannya, bahkan jika hal itu mengurangi penggunaan ulang cache.