TL;DR: Alibaba merilis Qwen4-Max pada 16 November 2026 sebagai model flagship dari generasi Qwen4. Evaluasi resmi melaporkan kinerja tugas industri yang lebih baik dan biaya eksekusi lebih rendah dibanding Qwen3.8-Max, mencerminkan peningkatan efisiensi token dan penurunan harga API.
Poin-Poin Utama
- Ukuran model: Qwen4-Max memiliki 2.4 triliun parameter backbone, dengan 71 miliar diaktifkan per token.
- Jendela konteks: Qwen4-Max mendukung jendela konteks satu juta token.
- Dukungan multimodal: Qwen4-Max menerima teks, gambar, dan video serta menghasilkan teks.
- Fitur pengembang: Qwen4-Max mendukung pemanggilan fungsi, keluaran terstruktur, cache konteks, dan penelusuran web.
- Opsi akses: Pengguna dapat mengakses Qwen4-Max melalui aplikasi Qwen yang didukung, API QwenCloud berbasis penggunaan, dan langganan Token Plan.
Apa itu Qwen4-Max?
Dalam pengumuman resmi Alibaba, Qwen menggambarkan Qwen4-Max sebagai rekan tim AI untuk pekerjaan, kreasi, dan eksplorasi. Kemampuannya berfokus pada memahami tujuan, mengoperasikan alat, merespons umpan balik eksekusi, dan menyampaikan hasil melalui beberapa tahap.
Untuk alur kerja ini, model menyediakan penalaran dan koordinasi. Aplikasi, alat, dan lingkungan eksekusi yang terhubung menjalankan operasinya.
Spesifikasi Qwen4-Max
Halaman model resmi QwenCloud mencantumkan spesifikasi berikut:
| Spesifikasi | Qwen4-Max |
|---|---|
| Model ID | qwen4-max |
| Parameter backbone | 2.4 triliun |
| Parameter yang diaktifkan/token | 71 miliar |
| Jendela konteks | 1 juta token |
| Input / output | Teks, gambar, dan video / Teks |
| Batas mode standar | Input maksimum: 991K; output maksimum: 131K token |
| Batas mode berpikir | Input maksimum: 983K; output maksimum: 262K token |
| Panjang penalaran maksimum | 262K token |
| Kapabilitas pengembang | Pemanggilan fungsi, keluaran terstruktur, cache konteks, dan penelusuran web |
| Kompatibilitas API | Protokol API OpenAI dan Anthropic |
Ukuran konteks, batas input, dan batas output merepresentasikan kendala yang berbeda. Aplikasi harus memenuhi semuanya bersamaan dan menyisakan kapasitas yang cukup untuk jawaban yang dihasilkan dan penalaran.
Apa saja Fitur Utama Qwen4-Max?
Kemampuan Qwen4-Max sangat relevan ketika sebuah tugas melintasi banyak dokumen, alat, dan langkah eksekusi. Konteks panjang mempertahankan latar kerja, pemahaman visual memperluas bukti yang tersedia, dan kapabilitas agen membantu mendorong tugas menuju penyelesaian.
Konteks Satu Juta Token dan Pemahaman Visual Bawaan
Jendela konteks besar memungkinkan materi terkait diproses dalam konteks kerja bersama. Aplikasi praktis mencakup membandingkan kontrak, menganalisis dependensi di banyak berkas kode, dan meninjau laporan bersama dokumen pendukung.
Pemahaman visual bawaan memperluas ini ke tangkapan layar, diagram, halaman hasil pemindaian, dan video. Pengguna dapat memberikan gambar teknik atau tangkapan layar antarmuka dan meminta model menafsirkannya berdampingan dengan persyaratan tertulis.
Untuk tugas yang sarat dokumen, mempertahankan nama file, tanggal, dan label bagian membantu mengorganisasi bukti dan membuat analisis yang dihasilkan lebih mudah diverifikasi.
Pemrograman dan Penggunaan Alat Profesional
Qwen4-Max mendukung pemanggilan fungsi, memungkinkan pengembang menghubungkannya dengan basis data, layanan penelusuran, operasi berkas, dan sistem bisnis. Keluaran terstruktur membantu meneruskan hasil model ke proses perangkat lunak berikutnya.
Demo resmi menunjukkan alur kerja perangkat lunak yang lebih luas. Dalam pengembangan gim, model menggunakan engine seperti Unity, Unreal Engine, dan Godot untuk membangun adegan, mengimplementasikan gameplay, dan menyempurnakan hasil melalui pengujian. Di Blender, model mengoordinasikan geometri, material, pencahayaan, dan render.
Untuk mereproduksi alur kerja ini dibutuhkan perangkat lunak, aset, dan izin eksekusi yang relevan. Demo menunjukkan apa yang dapat dilakukan model di dalam lingkungan tersebut.
Agen Jangka Panjang dan Live Delivery
Tugas panjang menjadi sulit dikelola ketika pengguna tidak dapat memeriksa progres hingga selesai. Pendekatan Live Delivery dari Qwen4-Max memperkenalkan hasil awal yang dapat digunakan diikuti pembaruan bertahap.
Untuk penugasan riset, sebuah agen mungkin pertama kali menyampaikan temuan awal dan daftar sumber, lalu memperluas analisis dan menambahkan grafik. Pengguna dapat meninjau setiap versi dan mengarahkan ulang pekerjaan berikutnya.
Qwen juga merilis Qwen-Live-Delivery-Plugin. Untuk alur kerja yang berlangsung berjam-jam atau lebih lama, pengiriman bertahap menciptakan titik pemeriksaan praktis untuk meninjau kualitas dan mengoreksi arah.
Arsitektur dan Efisiensi Token
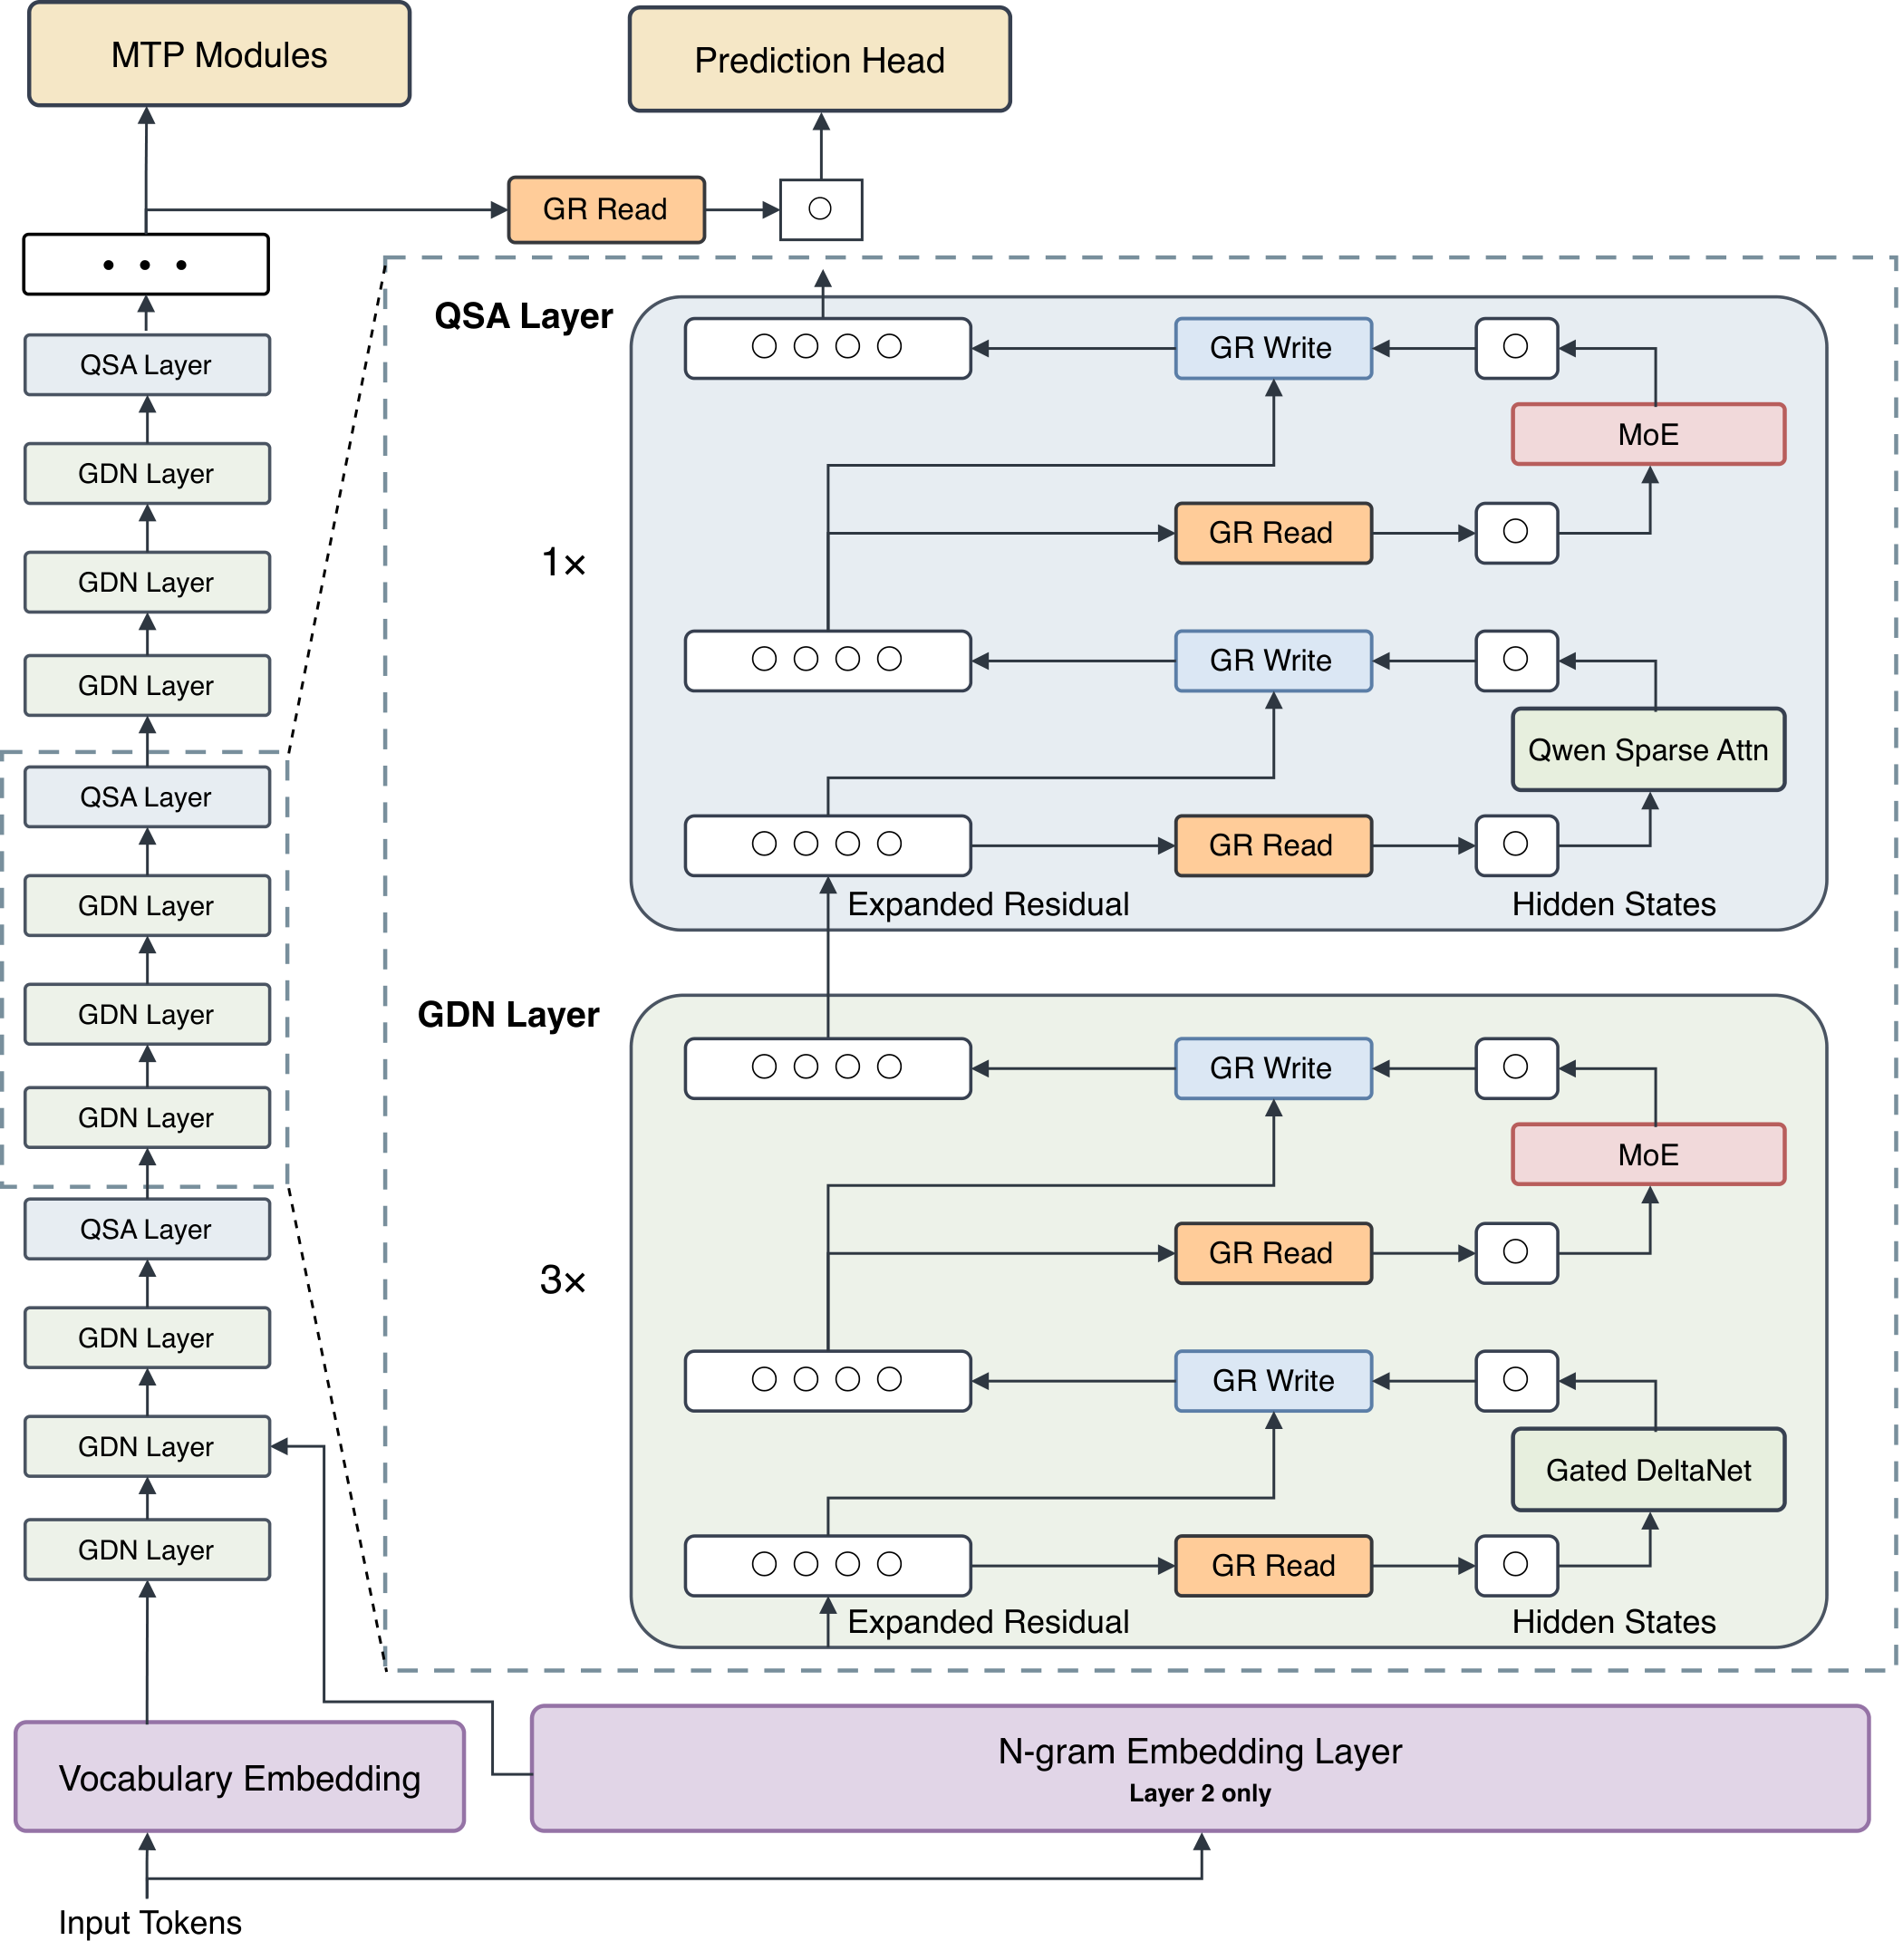
Qwen4-Max memperkenalkan beberapa perubahan pada arsitektur sparse mixture-of-experts:
- Gated DeltaNet dan Qwen Sparse Attention: Menggabungkan kompresi informasi historis dengan atensi selektif terhadap konteks relevan, mengurangi komputasi urutan panjang.
- Gated Residual: Menggunakan empat cabang residual paralel dan gerbang dinamis untuk meningkatkan transfer informasi dan stabilitas pelatihan.
- N-gram Embedding: Menambahkan 328 miliar parameter embedding untuk merepresentasikan pola token lokal melalui operasi lookup, memperluas kapasitas dengan komputasi tambahan yang relatif rendah.
Bagi pengguna, uji praktisnya adalah apakah perubahan ini mengurangi sumber daya yang dibutuhkan untuk menghasilkan hasil yang dapat diterima. Pengukuran konsumsi token yang dipublikasikan Qwen menunjukkan bukti peningkatan pada tugas yang dievaluasi.
Bagaimana Kinerja Qwen4-Max? Tolok Ukur Resmi dan Contoh
Tolok ukur yang dipublikasikan Qwen mengukur kinerja tugas, konsumsi token, dan biaya eksekusi, sementara demonya menggambarkan alur kerja praktis.
Hasil Tolok Ukur Qwen4-Max
Hasil berikut membandingkan Qwen4-Max dengan Qwen3.8-Max:
| Metrik | Qwen4-Max vs. Qwen3.8-Max |
|---|---|
| Skor Work360 | Naik dari 47.74 menjadi 52.69 |
| Konsumsi token Work360 | Berkurang sekitar 24% pada Xhigh dan 35% pada High |
| Konsumsi token Terminal-Bench 4.0 | Berkurang sekitar 48% pada Xhigh dan 49% pada High |
| Biaya rata-rata tugas Work360 | Turun dari RMB 26.58 menjadi RMB 11.16, sekitar 58% lebih rendah |
Penurunan biaya mencerminkan konsumsi token yang lebih rendah dan penetapan harga API yang direvisi.
Untuk aplikasi yang melakukan pemanggilan alat berulang, biaya per tugas yang berhasil diselesaikan adalah perbandingan yang lebih berguna daripada harga token semata. Permintaan berharga lebih rendah menawarkan penghematan terbatas jika alur kerja membutuhkan banyak percobaan ulang atau koreksi manual.
Contoh dalam Riset Keuangan dan Manufaktur
Beberapa contoh resmi memberikan hasil nyata dan keluaran yang terukur.
Dalam riset keuangan, model menggabungkan alat data pasar dan penelusuran untuk menghasilkan kertas kerja Excel dan laporan PowerPoint yang dapat diedit. Tautan sumber dan grafik yang selaras memungkinkan peninjau menelusuri temuan laporan kembali ke data pendukung.
Dalam contoh manufaktur, model menggabungkan pemodelan terparameter, pembuatan jalur alat, dan umpan balik simulasi. Upaya pemrograman manusia yang dilaporkan untuk satu benda kerja turun dari sekitar 475 menit menjadi 24 menit. Hasil ini menggambarkan benda kerja dan lingkungan alat yang didemonstrasikan dan memberikan titik awal yang berguna untuk mengevaluasi proses serupa.
Cara Menafsirkan Hasil
Skor Work360 Qwen4-Max meningkat dari 47.74 menjadi 52.69, kenaikan 4.95 poin. Ini menunjukkan kinerja yang lebih kuat di seluruh tugas industri yang dievaluasi, meski hasil tiap tugas dapat bervariasi. Pengurangan konsumsi token memberikan ukuran efisiensi terpisah, dengan penghematan berbeda pada setelan penalaran High dan Xhigh.
Penurunan 58% yang dilaporkan dalam biaya rata-rata tugas Work360 menggabungkan konsumsi token yang lebih rendah dengan penetapan harga API yang direvisi. Bagi pengembang, pertanyaan relevan adalah apakah penghematan tersebut terbawa hingga tugas yang berhasil diselesaikan setelah percobaan ulang dan koreksi manual.
Demo aplikasi menambah bukti tentang alur kerja dan keluaran tertentu. Gunakan untuk mengidentifikasi tugas yang layak diuji, lalu bandingkan kualitas penyelesaian, upaya peninjauan, dan total biaya dalam kondisi alat yang konsisten.
Harga Qwen4-Max: Biaya API dan Opsi Token Plan
Qwen4-Max tersedia melalui penagihan API berbasis penggunaan dan langganan Token Plan. Opsi yang sesuai bergantung pada apakah Anda membangun aplikasi atau menggunakan alat AI interaktif.
Harga API Resmi Berbasis Penggunaan
QwenCloud mencantumkan harga wilayah Singapura berikut:
| Item penagihan | Harga per 1 juta token |
|---|---|
| Input standar | $1.50 |
| Output | $4.50 |
| Input cache implisit | $0.075 |
| Baca cache eksplisit | $0.075 |
Pembuatan cache eksplisit dikenai biaya $1.875 per satu juta token untuk cache lima menit dan $3.00 untuk cache satu jam.
Sebuah tugas yang menggunakan 100,000 token input tanpa cache dan 10,000 token output yang ditagihkan berbiaya $0.195 dalam biaya token model, tidak termasuk alat atau layanan tambahan yang dapat ditagihkan.
Input yang di-cache dihargai 95% di bawah input standar. Aplikasi yang berulang kali mengirim instruksi yang sama, definisi alat, atau awalan dokumen dapat mengurangi biaya input dengan meningkatkan penggunaan cache.
Cara Kerja Token Plan
Token Plan menggunakan penagihan langganan dan pengurangan Credits. Saat ini mencantumkan qwen4-max di antara model yang didukung.
Per 17 November 2026, halaman wilayah Singapura menampilkan rencana bulanan individual berikut:
| Paket | Harga bulanan | Kredit bulanan |
|---|---|---|
| Lite | $6 | 20,000 |
| Essential | $10 | 45,000 |
| Standard | $18 | 80,000 |
| Pro | $43 | 200,000 |
Halaman tersebut juga mengiklankan promosi pengguna baru mulai dari $3. Kelayakan dan jumlah akhir ditampilkan saat checkout.
Credits adalah satuan penagihan langganan, bukan alokasi token langsung. Konsumsi bergantung pada model dan aturan alat yang berlaku.
Menurut dokumentasi Token Plan, layanan ini ditujukan untuk penggunaan interaktif di alat AI yang kompatibel dan saat ini tersedia di wilayah Singapura.
Cara Mengakses Qwen4-Max
Ada tiga jalur praktis: gunakan produk Qwen, terhubung langsung melalui QwenCloud, atau konfigurasi alat AI yang kompatibel. Masing-masing memiliki kebutuhan penyiapan berbeda, khususnya seputar kredensial dan endpoint.
Gunakan Aplikasi Qwen
Pengumuman resmi mencantumkan Qwen Studio, aplikasi Qwen, QwenWork, dan Qoder sebagai saluran akses.
Produk ini menyediakan titik awal yang nyaman untuk menguji analisis dokumen, bantuan pengodean, dan alur kerja perkantoran. Pengembang yang perlu mengontrol permintaan, alat, dan penanganan hasil dapat beralih ke integrasi API langsung.
Akses API QwenCloud
Untuk mengakses Qwen4-Max, masuk ke QwenCloud, dapatkan kunci API untuk wilayah yang dipilih, dan konfigurasikan endpoint yang sesuai dengan ID model qwen4-max. QwenCloud menyediakan akses yang kompatibel dengan OpenAI. Pengguna yang bermigrasi dari pratinjau juga harus meninjau parameter permintaan dan konfigurasi penagihan mereka.
Konfigurasikan Alat Pengodean dan Agen
Dokumentasi Token Plan menyediakan panduan integrasi untuk alat termasuk Qwen Code, Cline, Cursor, dan OpenCode.
Konfigurasi umumnya memerlukan kunci API khusus, Base URL yang sesuai, dan nama model. Token Plan menggunakan domain endpoint terpisah token-plan.maas.qwencloudapi.com, dan kuncinya tidak dapat dipertukarkan dengan kunci API berbasis penggunaan.
Ikuti panduan untuk alat pilihan Anda, lalu validasikan penyiapan dengan tugas yang mencakup membaca materi, melakukan operasi, dan memeriksa hasil.
Siapa yang Sebaiknya Menggunakan Qwen4-Max?
Qwen4-Max layak dievaluasi ketika alur kerja berulang membutuhkan konteks ekstensif, banyak alat, dan keluaran yang dapat diverifikasi.
- Pengembang dapat mengevaluasi Qwen4-Max untuk perubahan kode multi-berkas, pengembangan frontend, dan agen yang menggunakan alat eksternal.
- Tim kantor dan riset dapat menggunakannya untuk menganalisis dokumen, mengorganisasi data, dan menyiapkan laporan dengan sumber yang dapat ditelusuri.
- Tim desain dan konten dapat mengujinya untuk pemodelan 3D, prototipe gim, dan alur kerja video yang terhubung ke perangkat lunak profesional.
- Tim perusahaan dapat mengevaluasi proses berulang dengan akses data terdefinisi, antarmuka alat, dan kriteria penerimaan.
Untuk alur kerja finansial, legal, dan medis, gunakan untuk pemrosesan bukti dan dukungan analitis, dengan profesional berkompeten meninjau kesimpulan yang berakibat.
FAQ
Apakah batas output Qwen4-Max satu juta token?
Tidak. Jendela konteks dan panjang output maksimum adalah batas yang terpisah. QwenCloud mencantumkan output maksimum 131K token dalam mode standar dan 262K token dalam mode berpikir. Permintaan juga harus memenuhi batas input dan konteks yang berlaku.
Haruskah saya memilih API Qwen4-Max atau Token Plan?
Pilih API berbasis penggunaan saat mengintegrasikan Qwen4-Max ke aplikasi atau layanan backend. Token Plan ditujukan untuk penggunaan interaktif di alat AI yang kompatibel dan menggunakan Credits langganan. Kedua opsi memerlukan kredensial dan endpoint terpisah.
Bisakah saya menggunakan Qwen4-Max secara gratis?
Akses API resmi dan Token Plan adalah layanan berbayar. Akses gratis melalui aplikasi Qwen, jika tersedia, mengikuti aturan akun dan penggunaan tiap produk; ini tidak menetapkan alokasi API gratis.
Bisakah saya mengunduh Qwen4-Max untuk penerapan lokal?
Per 17 November 2026, Qwen belum menyediakan open weights untuk Qwen4-Max, sehingga rilis resmi tidak menawarkan model yang dapat diunduh untuk penerapan lokal. Qwen telah mengumumkan rencana untuk secara bertahap membuka sumber model yang lebih kecil dalam seri Qwen4.
Kesimpulan
Qwen4-Max adalah kandidat kuat untuk analisis dokumen panjang, pengodean kompleks, dan alur kerja yang melibatkan banyak alat. Evaluasi resmi menunjukkan skor lebih tinggi dan biaya tugas lebih rendah daripada Qwen3.8-Max pada beban kerja yang dilaporkan.
Mulailah dengan tugas representatif yang sudah memiliki kriteria penerimaan yang jelas. Bandingkan kualitas output, waktu koreksi manual, waktu eksekusi, dan total biaya. Peningkatan di seluruh ukuran tersebut memberikan dasar praktis untuk memperluas Qwen4-Max ke alur kerja serupa.