Bangun dengan CometAPIButuh satu API untuk banyak model?Uji alur kerja di Playground, lalu buat API key saat model dan biayanya sesuai dengan use case Anda.
Gemini 4 Carbon adalah model frontier milik Google DeepMind untuk rekayasa yang menuntut dan keamanan siber defensif. Diumumkan pada 28 Oktober 2026, model ini meningkatkan kinerja Argon pada evaluasi publik terkait pemrograman, keamanan, dan konteks panjang. Tarif perkenalan adalah $2 per satu juta token input dan $10 per satu juta token output, namun akses awal dibatasi untuk pembela siber terpilih dan mitra tepercaya. Bagi pengembang, peluangnya adalah kerja otonom yang lebih kuat; kendala langsungnya adalah akses.
Key Takeaways
Gemini 4 Carbon adalah model frontier Google berikutnya setelah Argon, dioptimalkan untuk rekayasa agenik multi-hari dan pertahanan keamanan siber.
Gemini 4 Carbon menempati peringkat #1 pada Artificial Analysis Intelligence Index v5.0 (skor 59), di atas Claude Opus 5.5 (58) dan GPT-6 Astra (57). Peningkatan kuat pada pemrograman, pengembangan web full-stack (+89 Elo di WebDev Arena ke #4), penalaran ilmiah, pemahaman multimodal, dan alignment (0,0% keberhasilan pada Gray Swan Indirect Prompt Injection Benchmark).
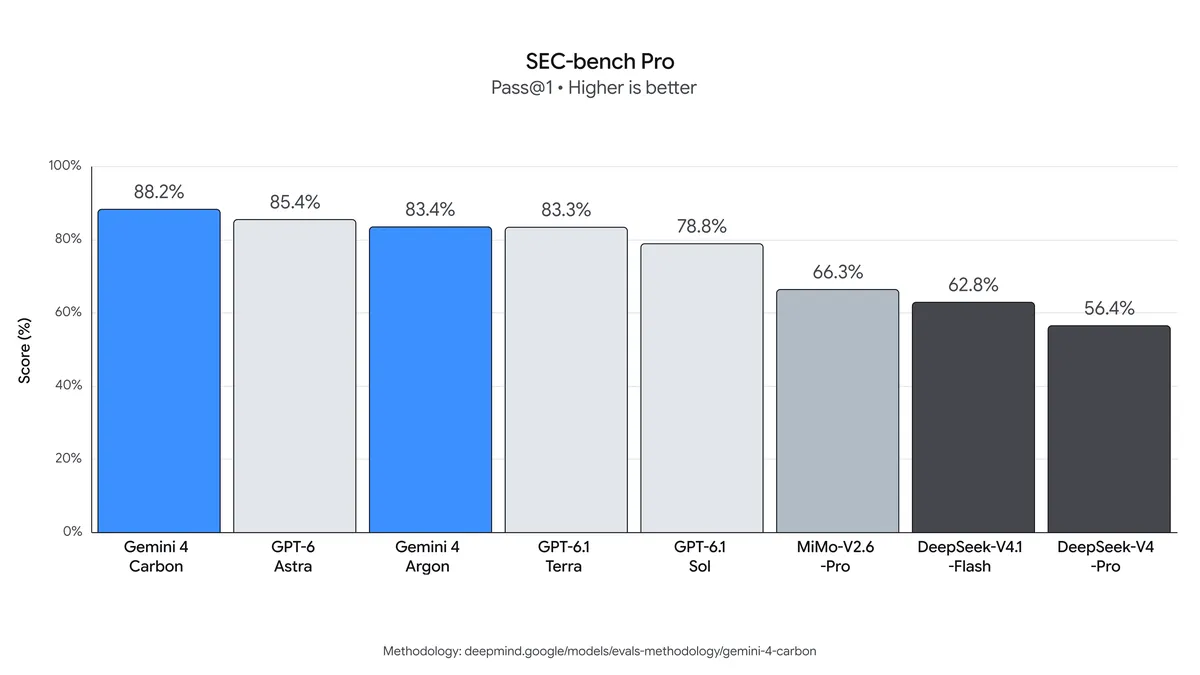
Skor keamanan yang menonjol (tanpa guardrail): 88,2% pada SEC-bench Pro (menemukan kerentanan), 54,8% pada ExploitGym (eksploitasi), dan 71,0% pada CWE-bench (patching).
Ditinjau untuk kejelasan, atribusi sumber, dan terminologi API terkini.
Akses awal terbatas melalui Fairwind Program untuk pembela siber; API publik dan peluncuran lebih luas akan datang kemudian.
Tarif perkenalan sama seperti Argon; setelah periode perkenalan, tarif standar berlaku.
Platform seperti CometAPI sudah mendukung keluarga Gemini yang lebih luas (termasuk Argon) melalui API terpadu yang kompatibel dengan OpenAI, sehingga memudahkan pergantian model dan persiapan untuk rilis Carbon yang lebih luas. Detail API publik dan tanggal rilis luas belum diumumkan per 29 Oktober 2026.
What Is Gemini 4 Carbon?
Gemini 4 Carbon adalah model AI frontier terbaru Google, dirancang untuk menangani rekayasa perangkat lunak kompleks, riset keamanan siber, dan alur kerja otonom.
Carbon dirancang untuk pekerjaan yang melibatkan investigasi, eksekusi, dan verifikasi lintas banyak langkah. Agen rekayasa defensif mungkin memeriksa repositori, memvalidasi kerentanan yang dicurigai dalam lingkungan terisolasi, mengembangkan patch, dan menguji apakah perubahan tersebut mengatasi cacat awal.
Google melaporkan bahwa tim internalnya telah mengamati Carbon bekerja melalui tugas rekayasa kompleks selama beberapa hari. Ini adalah observasi internal, bukan jaminan yang dipublikasikan mengenai runtime otonom tertentu. Google belum merilis laporan teknis lengkap, jumlah parameter, atau detail arsitektur. Jendela konteks dan batas output diharapkan serupa atau lebih baik daripada Argon (dilaporkan dalam rentang multi-juta token dengan kapasitas output tinggi), dan mendukung input multimodal termasuk teks, gambar, video, audio, dan PDF.
What Are the Key Features of Gemini 4 Carbon?
Long-Horizon Software Engineering
Carbon dirancang untuk masalah rekayasa yang tidak dapat diselesaikan secara andal dalam satu langkah penalaran.
Contohnya meliputi analisis akar penyebab di repositori besar, kegagalan terkait dependensi, debugging sistem tingkat rendah, dan refactoring kompleks.
Peningkatannya menargetkan kemampuan untuk terus bekerja setelah upaya pertama tidak berhasil.
Agen pemrograman yang efektif harus mengenali saat solusi pertama gagal, memeriksa bukti baru, dan merevisi pendekatannya tanpa melenceng dari tugas asli.
Defensive Cybersecurity Workflows
Hasil keamanan Carbon mencakup menemukan kerentanan, memvalidasi keter-eksploitasian, dan menambal cacat. Pertanyaan berguna bagi tim keamanan adalah apakah agen dapat bergerak dari isu yang dicurigai ke temuan yang dapat direproduksi dan perbaikan yang teruji, sambil menghormati izin dan lingkungan yang diberikan kepadanya.
Long-Context dan Multimodal Understanding
Carbon mencatat skor GraphWalks BFS F1 sebesar 96,2% pada subset 256K–1M token, naik dari 84,2% milik Argon. Ini adalah bukti tentang penalaran graf konteks panjang, bukan jaminan pengambilan yang benar dari dokumen berjuta-juta token apa pun.
Hasil Chartography dan Blueprint-Bench 2 yang diterbitkan juga mencakup pemahaman visual. Tes ini dapat membantu mengidentifikasi alur kerja dokumen dan grafik yang menjanjikan, tetapi tidak menetapkan skema modalitas lengkap untuk API publik di masa depan.
How Does Gemini 4 Carbon Perform on Benchmarks?
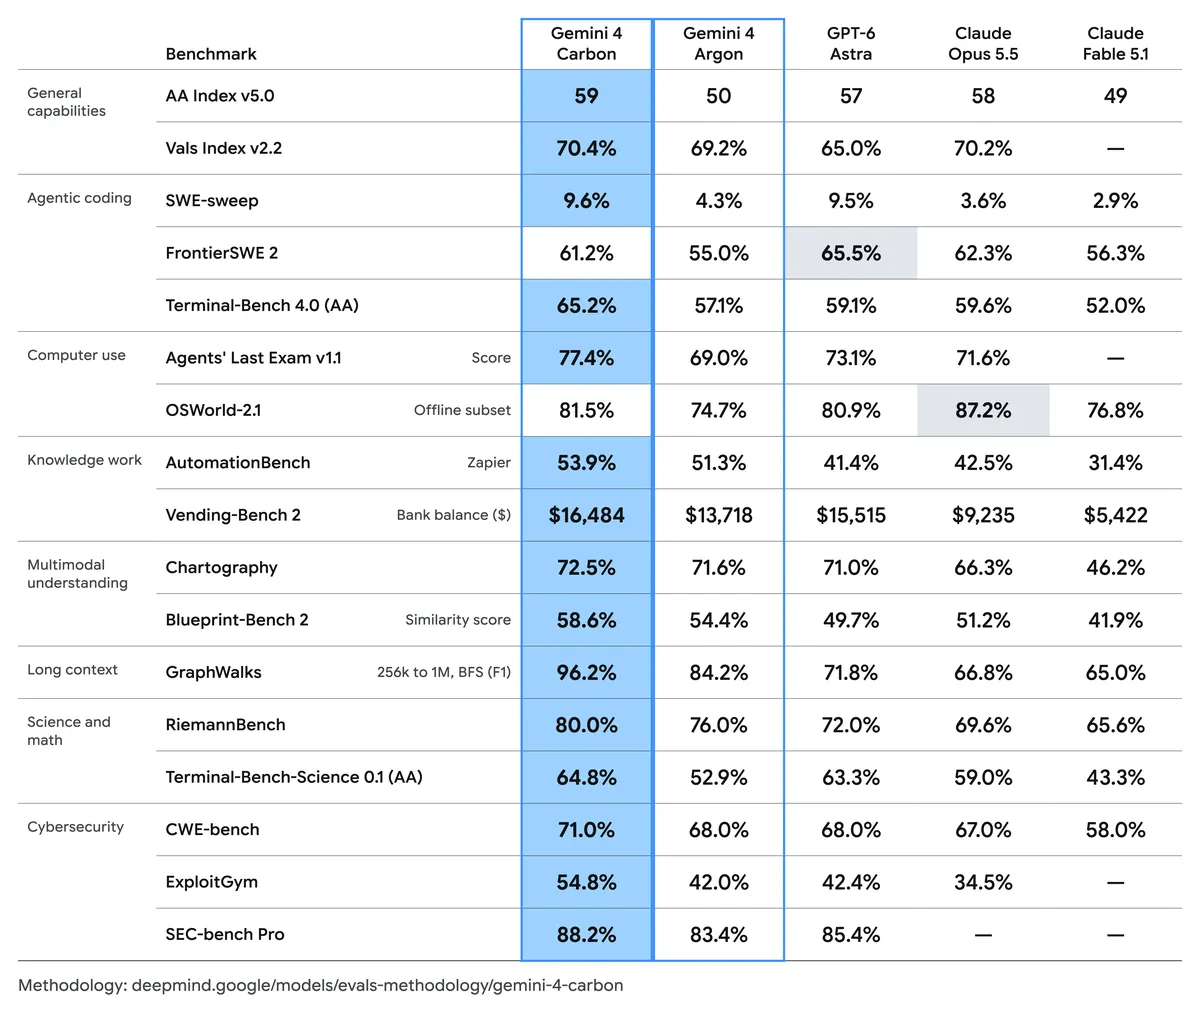
Hasil yang dipublikasikan menyoroti tiga alasan untuk mengevaluasi Carbon: kinerja pemrograman yang lebih kuat, penalaran konteks panjang yang lebih baik, dan peningkatan di seluruh alur kerja keamanan siber. Pengumuman resmi (https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon/) menyertakan bagan perbandingan asli di bawah; hasil kunci diringkas pada bagian berikut.
Pilih benchmark yang menyerupai beban kerja Anda. Model yang memimpin indeks kecerdasan umum masih bisa tertinggal dari model lain pada tugas rekayasa tertentu.
Benchmark Results and Test Conditions
Penalaran keseluruhan: Carbon meraih 59 pada AA Intelligence Index v5.0, dibandingkan dengan 50 untuk Argon, 57 untuk GPT-6 Astra, dan 58 untuk Claude Opus 5.5.
Pemrograman: Terminal-Bench 4.0 naik dari 57.1% menjadi 65.2%, peningkatan 8.1 poin persentase dibanding Argon. SWE-sweep meningkat dari 4.3% menjadi 9.6%.
Penalaran konteks panjang: Carbon meraih 96.2% pada subset GraphWalks 256K–1M token BFS F1, naik dari 84.2% milik Argon.
Di mana alternatif unggul: GPT-6 Astra meraih 65.5% pada FrontierSWE 2 versus 61.2% milik Carbon; Claude Opus 5.5 meraih 87.2% pada subset offline OSWorld versus 81.5% milik Carbon. Perbandingan ini merujuk pada model dan pengaturan evaluasi dalam bagan yang dipublikasikan.
Di 17 hasil terpilih pada perbandingan asli, Carbon memimpin 15. Keluasan ini membuatnya menjadi kandidat menjanjikan untuk alur kerja kompleks, namun dua pengecualian menunjukkan mengapa campuran tugas Anda sendiri penting. Bandingkan model berdasarkan hasil yang diterima, waktu penyelesaian, dan biaya alih-alih merata-ratakan skor benchmark yang tidak terkait.
Metodologi evaluasi (https://deepmind.google/models/evals-methodology/gemini-4-carbon/) umumnya menggunakan pengaturan thinking tertinggi dan pass@1 kecuali dinyatakan lain. Ini menggabungkan hasil yang dijalankan Google dengan evaluator eksternal dan skor yang dilaporkan penyedia, sehingga scaffolding agen dan anggaran penalaran tidak identik di setiap entri.
GraphWalks: Subset yang dikutip menggunakan 200 masalah dan melaporkan BFS F1.
Agents’ Last Exam: Evaluasi menggunakan set v1.1 berisi 122 tugas, harness ALE-Claw, jendela lima jam, dan filter keamanan diaktifkan.
OSWorld: Hasil yang dilaporkan mencakup subset offline 82 tugas dan mengambil maksimum dari tiga percobaan tunggal.
Coding Performance in Practice
Carbon meningkatkan Terminal-Bench 4.0 dari 57.1% menjadi 65.2%, kenaikan 8.1 poin persentase. SWE-sweep naik dari 4.3% menjadi 9.6%, lebih dari dua kali lipat meskipun masih di bawah 10% secara absolut. Hasil ini mendukung evaluasi pekerjaan repositori yang sulit, sekaligus menunjukkan mengapa tes dan tinjauan independen tetap diperlukan.
How Strong Is Gemini 4 Carbon at Cybersecurity?
Benchmark dan tugas keamanan
Gemini 4 Carbon
Gemini 4 Argon
Perbedaan
SEC-bench Pro — penemuan kerentanan
88.2%
83.4%
+4.8 poin persentase
ExploitGym — validasi eksploit
54.8%
42.0%
+12.8 poin persentase
CWE-bench — remediasi kerentanan
71.0%
68.0%
+3.0 poin persentase
Kenaikan terbesar ada pada validasi eksploit. Bagi tim defensif yang berwenang, bukti yang dapat direproduksi bahwa kerentanan dapat dieksploitasi dapat meningkatkan prioritisasi; temuan yang hanya masuk akal saja tidak cukup. Patch tetap memerlukan pengujian yang mengonfirmasi cacat asli diperbaiki dan fungsionalitas yang ada tetap terjaga.
Google melaporkan evaluasi keamanan eksternal tanpa guardrail penerapan. SEC-bench Pro menggunakan split mesin JavaScript 183 tugas tertentu; ExploitGym menggunakan setup offline percobaan tunggal dengan mitigasi dimatikan. Kondisi ini tidak menetapkan perilaku produksi yang tidak dibatasi atau tingkat deteksi untuk perangkat lunak dunia nyata apa pun.
Is Gemini 4 Carbon Safer and More Reliable Than Argon?
Klaim tanpa dukungan menurun sekitar 50% relatif terhadap Argon dalam pengujian internal.
Overreach agen menurun 26%.
Under-service menurun 29%.
Peringatan misalignment tingkat tinggi menurun hampir 80% di lingkungan pemrograman internal.
Kecurangan yang berhasil pada Terminal-Bench 4.0 turun ke 0.0% dalam evaluasi Google.
Pada benchmark injeksi prompt tidak langsung Gray Swan, tingkat keberhasilan serangan Carbon adalah 0.0% versus 0.7% milik Argon. Ini berarti serangan yang dievaluasi tidak berhasil dalam setup tersebut; ini tidak menetapkan imunitas terhadap serangan baru atau lingkungan alat yang berbeda.
Angka-angka ini berasal dari evaluasi yang berbeda dan tidak boleh digabungkan menjadi satu skor reliabilitas.
Untuk agen produksi, pertahankan pemeriksaan izin independen, log eksekusi, dan validasi atas hasil yang diklaim. Perilaku model yang meningkat membantu, tetapi aplikasi tetap harus mengendalikan file, layanan, dan tindakan mana yang dapat diaksesnya.
Periode perkenalan Carbon belum memiliki tanggal akhir yang diumumkan. Perkenalan harga Argon yang dipublikasikan berakhir 30 November 2026 (https://ai.google.dev/gemini-api/docs/pricing); tenggat tersebut tidak berlaku untuk Carbon. Penetapan harga batch, biaya alat tambahan, dan tingkat gratis belum diumumkan untuk Carbon.
Example Request Cost
Misalkan sebuah permintaan menggunakan 200.000 token input yang tidak di-cache dan 10.000 total token output yang ditagihkan. Pada tarif perkenalan yang diumumkan, input berbiaya $0.40 dan output $0.10, total $0.50. Penggunaan token yang sama akan berbiaya $1.00 pada tarif selanjutnya.
Jika semua 200.000 token input memenuhi syarat diskon input-cache yang diumumkan, estimasi perkenalan menjadi $0.12 termasuk output. Ini adalah ilustrasi bersyarat, bukan janji bahwa setiap input berulang akan memenuhi syarat.
Jatah output harus mencakup token pemikiran yang ditagihkan sebagai output berdasarkan aturan akhir yang berlaku. Jika 10.000 hanya merujuk pada jawaban yang terlihat, token pemikiran tambahan yang ditagihkan akan meningkatkan estimasi. Alat, percobaan ulang, dan layanan lain dikecualikan.
How Can Developers Prepare for the Gemini 4 Carbon API?
Current Gemini 4 Carbon API Availability
Per 29 Oktober 2026, akses dimulai dengan pembela keamanan siber terpilih dan berkembang bertahap ke mitra tepercaya. Fairwind Program Google (https://deepmind.google/fairwind-program/) menggambarkan jalur akses terkontrol. Tanggal rilis pengembang yang luas dan pengidentifikasi model Carbon publik belum diumumkan.
Karena itu, harga yang diumumkan tidak berarti bahwa aplikasi dapat memanggil API Carbon yang tersedia umum saat ini. Batas konteks publik final, output maksimum, skema modalitas, kompatibilitas alat, dan batas operasionalnya masih memerlukan spesifikasi produksi terdokumentasi.
Anda dapat mulai mengevaluasi alur kerja pemrograman sebelum Carbon tersedia luas. Bangun baseline dengan model yang dapat Anda akses hari ini, lalu bandingkan Carbon pada tugas yang sama saat API-nya dibuka. Tiga opsi yang dipertimbangkan adalah Gemini 4 Argon, GPT-6.1 Astra, dan Claude Opus 5.5; konfirmasikan nama model, akses, dan harga yang tepat dengan penyedia Anda sebelum memilih jalur.
Gemini 4 Argon: Mulailah di sini jika Anda sudah menggunakan Gemini atau menginginkan baseline langsung untuk Carbon. Coba perubahan repositori yang representatif, tinjauan kode, dan perbaikan bug, lalu catat output mana yang lulus uji penerimaan Anda.
**GPT-6.1 Astra:** Sertakan sebagai perbandingan lintas penyedia untuk tugas rekayasa yang sama. Ukur perbaikan yang diterima, waktu penyelesaian, dan total biaya. Hasil GPT-6 Astra yang dibahas sebelumnya berlaku untuk versi yang dibenchmark tersebut dan tidak boleh dianggap sebagai skor GPT-6.1 Astra.
**Claude Opus 5.5:** Tambahkan sebagai kandidat lain untuk analisis repositori, refactoring, dan tinjauan. Gunakan deskripsi tugas dan kriteria validasi yang sama sehingga Anda dapat membandingkan nilai praktis dari setiap hasil.
Biarkan pemilihan model dapat dikonfigurasi dan simpan prompt, kasus uji, serta hasil dari setiap run. Itu memberi Anda titik awal yang berguna untuk mengevaluasi Carbon tanpa mengikat alur kerja Anda ke format API yang belum diumumkan.
Benchmark
Gemini 4 Carbon
Gemini 4 Argon
GPT-6 Astra
Claude Opus 5.5
AA Intelligence Index v5.0
59
50
57
58
Vals Index v2.2
70.4%
69.2%
65.0%
70.2%
SWE-sweep
9.6%
4.3%
9.5%
3.6%
FrontierSWE 2
61.2%
55.0%
65.5%
62.3%
Terminal-Bench 4.0 (AA)
65.2%
57.1%
59.1%
59.6%
Agents' Last Exam v1.1
77.4%
69.0%
73.1%
71.6%
OSWorld-2.1, offline subset
81.5%
74.7%
80.9%
87.2%
AutomationBench, Zapier
53.9%
51.3%
41.4%
42.5%
Prepare a Model Evaluation Workflow
Kerangka evaluasi praktis harus mengukur lebih dari sekadar kualitas jawaban umum.
Untuk alur kerja pemrograman dan keamanan, metrik yang berguna mencakup:
Tingkat penyelesaian tugas: Seberapa sering agen memenuhi uji penerimaan yang telah ditentukan?
Kebenaran patch: Apakah perubahan yang diusulkan mengatasi cacat asli tanpa merusak perilaku yang ada?
Tingkat positif palsu: Seberapa sering isu yang dilaporkan gagal divalidasi?
Latensi end-to-end: Berapa lama alur kerja penuh, termasuk eksekusi alat?
Biaya tugas total: Berapa biaya setiap hasil yang diterima setelah percobaan ulang dan penggunaan alat?
Kepatuhan instruksi: Apakah agen tetap berada dalam file, alat, dan tindakan yang diotorisasi?
Gunakan set tugas nyata yang tetap dan catat setiap model, pengaturannya, penggunaan token, dan hasil uji. Sertakan percobaan ulang dan koreksi manual dalam biaya. Setelah Carbon tersedia, jalankan evaluasi yang sama untuk melihat apakah ia memberikan lebih banyak pekerjaan yang diterima untuk waktu dan anggaran Anda.
Conclusion
Gemini 4 Carbon adalah peningkatan yang menjanjikan untuk pemrograman yang menuntut, penalaran konteks panjang, dan pekerjaan keamanan defensif. Hasil yang dipublikasikan menunjukkan peningkatan jelas dibanding Argon, sementara akses awal tetap terbatas per 29 Oktober 2026. Untuk saat ini, bangun baseline dengan model yang tersedia dan jaga integrasi Anda tetap fleksibel. Saat API publik Carbon dibuka, bandingkan kualitas pekerjaan yang diselesaikan, waktu yang dihemat, dan total biaya sebelum memutuskan apakah akan beralih.
FAQ
Can Gemini 4 Carbon run without human supervision?
Laporan pekerjaan rekayasa internal multi-hari tidak menetapkan keandalan tanpa pengawasan untuk tugas sewenang-wenang. Tim yang mempertimbangkan eksekusi otonom harus mendefinisikan tindakan yang diizinkan, kondisi penghentian, dan uji penerimaan, lalu mengukur seberapa sering agen menyelesaikan pekerjaan tanpa koreksi. Runtime saja tidak menunjukkan bahwa output agen benar.
Can an existing Argon integration switch directly to Carbon?
Tidak berdasarkan bukti yang tersedia di sini. Biarkan pemilihan penyedia dapat dikonfigurasi, tetapi verifikasi pengidentifikasi model Carbon yang sebenarnya, skema yang didukung, alat, batas, dan akses akun sebelum mengubah penerapan. Menggunakan ulang prompt dapat membantu perbandingan terkontrol; itu tidak membuktikan kompatibilitas API.
Which Gemini 4 Carbon tests matter for a private codebase?
Sertakan bug representatif, perubahan repositori, dan temuan keamanan dengan kriteria penerimaan yang diketahui. Periksa apakah patch lulus uji yang relevan, apakah temuan dapat direproduksi, dan apakah tidak ada perubahan perilaku yang tidak terkait. Sertakan upaya yang gagal dan koreksi manual dalam analisis biaya, sehingga skor benchmark publik yang kuat tidak menyembunyikan pekerjaan operasional.