

TL;DR
Claude Opus 5.5 è un forte candidato di partenza perché offre prezzi per token sostanzialmente più bassi pur eguagliando o superando Fable 5.1 in diverse valutazioni pubblicate, applicando $4 per milione di token in input e $20 per milione di token in output, rispetto a Fable 5.1 a $10 e $50.
Fable 5.1 mantiene un ruolo quando un’attività è insolitamente difficile, di lunga durata, costosa da ritentare o destinata a funzionare senza stretta supervisione. La regola pratica è semplice: iniziare con Opus 5.5, poi eseguire l’escalation solo quando test produttivi rappresentativi mostrano che Fable 5.1 riduce fallimenti, correzioni o costi di retry a sufficienza da giustificare il suo premio.
Claude Opus 5.5 vs Claude Fable 5.1 a colpo d’occhio
| Dimensione | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|
| Data di rilascio | 22 set. 2026 | 1 set. 2026 |
| ID modello API | claude-opus-5-5 | claude-fable-5-1 |
| Contesto / output massimo | 1M / 128K | 1M / 128K |
| Input / output per MTok | $4 / $20 | $10 / $50 |
| Lettura cache per MTok | $0.20 | $0.25 |
| Terminal-Bench 4.0 | 66.4% | 55.8% |
| FrontierCode v1.1 | 54.4% | 50.3% |
| CursorBench 4.0 | 57.8% | 51.8% |
| GDPval-AA v2.1 | 1846 Elo | 1735 Elo |
| Migrazione HAProxy C-to-Rust | 9.5 ore; costo per task inferiore del 51% | 12 ore; costo per task di riferimento |
| Opzione di velocità | Fast mode, fino a 2.5× la velocità normale | Nessuna modalità di lancio equivalente |
| Livello di sforzo iniziale | Orientato a Medium | Alto |
| Uso predefinito consigliato | Coding frontier quotidiano, agenti, produzione supervisionata e traffico API elevato | Lavori di massimo valore, difficili, di lunga durata o non presidiati |
| Accesso API | Anthropic API e provider compatibili, incluso CometAPI | Anthropic API e provider compatibili, incluso CometAPI |
Nota di lettura: Le cifre dei benchmark sono riportate da Anthropic e dipendono da livello di sforzo, harness, salvaguardie, rilascio dei task, numero di prove e errore standard. Devono essere confrontate solo in condizioni di valutazione corrispondenti.
Punti chiave
- Le tariffe standard di input e output di Opus 5.5 sono inferiori del 60% rispetto a quelle di Fable 5.1.
- Entrambi i modelli supportano una finestra di contesto da 1M token e fino a 128K di output, quindi costi, impostazioni di sforzo e aderenza al carico contano più della dimensione nominale del contesto.
- I risultati pubblicati da Anthropic favoriscono Opus 5.5 in molte valutazioni di coding e agentiche, ma le impostazioni dei benchmark influiscono in modo sostanziale sul risultato.
- Valutazioni indipendenti supportano la posizione di frontiera di Opus 5.5 pur riportando punteggi assoluti diversi, rafforzando la necessità di test allineati.
- Per la maggior parte del lavoro produttivo supervisionato, Opus 5.5 è il punto di partenza più forte. Fable 5.1 è un livello di escalation, non la scelta automatica di default.
Che cos’è Claude Opus 5.5?
Claude Opus 5.5 è il primo modello Claude 5.5 di Anthropic. È posizionato per agentic coding, agenti di lunga durata, lavori di conoscenza professionali, flussi di lavoro enterprise, analisi finanziaria, vision e computer use.
Il suo ID modello API è claude-opus-5-5. Il pensiero adattivo è sempre attivo, mentre gli sviluppatori controllano l’intensità del reasoning tramite i livelli di sforzo low, medium, high, xhigh e max. Anthropic offre anche la Fast mode, che può funzionare fino a 2,5 volte la velocità normale a $8/M per input e $40/M per output.
Che cos’è Claude Fable 5.1?
Claude Fable 5.1 è posizionato per progetti impegnativi e di lunga durata, come coding di più ore, ricerche complesse, interazione con browser, agenti autonomi e flussi di lavoro che coinvolgono più applicazioni.
Il suo ID modello API è claude-fable-5-1. Utilizza il pensiero adattivo, parte da un’impostazione di sforzo API più elevata ed è meglio trattato come opzione premium quando il costo atteso di fallimento o di retry ripetuti supera il costo di inferenza aggiuntivo.
Una lettura semplificata sarebbe che Opus 5.5 offra quasi la stessa portata al 40% del prezzo standard dei token di Fable. Ma è proprio qui che una semplice tabella di specifiche può risultare fuorviante.
Confronto tra codice e benchmark
Anthropic riporta Opus 5.5 avanti rispetto a Fable 5.1 su Terminal-Bench 4.0, FrontierCode v1.1, CursorBench 4.0, GDPval-AA v2.1, AutomationBench, Humanity’s Last Exam con strumenti, Terminal-Bench-Science, OSWorld 2.0 e Chartography.
Come leggere i risultati dei benchmark
Anthropic riporta Opus 5.5 avanti rispetto a Fable 5.1 su Terminal-Bench 4.0, FrontierCode v1.1, CursorBench 4.0, GDPval-AA v2.1, AutomationBench, Humanity’s Last Exam con strumenti, Terminal-Bench-Science, OSWorld 2.0 e Chartography. Queste cifre sono risultati di valutazione, non costanti del modello indipendenti dalla configurazione.
La maggior parte dei punteggi in evidenza di Opus 5.5 ha utilizzato il livello di sforzo max, mentre Terminal-Bench 4.0 ha usato xhigh. La progettazione dell’harness, la configurazione degli strumenti, le salvaguardie, il numero di prove, l’errore standard, i comportamenti di fallback e i tetti di costo possono tutti cambiare il risultato. Anthropic stessa avverte che i margini dei benchmark possono sovrastimare il divario pratico tra modelli di frontiera.
Prestazioni nel coding
| Benchmark | Claude Opus 5.5 | Claude Fable 5.1 | Interpretazione |
|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | 55.8% | Vantaggio riportato di 10,6 punti per task agentici basati su terminale |
| FrontierCode v1.1 | 54.4% max; 54.6% medium | 50.3% | Opus 5.5 a Medium resta competitivo per l’economia produttiva |
| CursorBench 4.0 | 57.8% max; 52.5% medium | 51.8% | Il livello Medium supera leggermente il risultato riportato di Fable |
| GDPval-AA v2.1 | 1846 Elo | 1735 Elo | Vantaggio riportato nel lavoro agentico professionale |
Queste cifre sono risultati di benchmark riportati da Anthropic. La tabella va letta insieme alle avvertenze sulle impostazioni di valutazione nelle sezioni seguenti e alla pagina ufficiale del modello Claude Opus.
I primi tre risultati spiccano perché coprono il carico di lavoro in cui Claude sta diventando commercialmente sempre più importante: gli agenti per l’ingegneria del software. Terminal-Bench 4.0 mostra una differenza assoluta di 10,6 punti percentuali; FrontierCode mostra 4,1 punti; CursorBench 4.0 mostra 6 punti.
GDPval-AA, che misura il lavoro agentico professionale, riporta anche 1846 Elo per Opus 5.5 contro 1735 per Fable 5.1. Se queste cifre fossero tutta la storia, la gerarchia di prodotto sembrerebbe invertita. Non è così semplice.
Valutazione indipendente
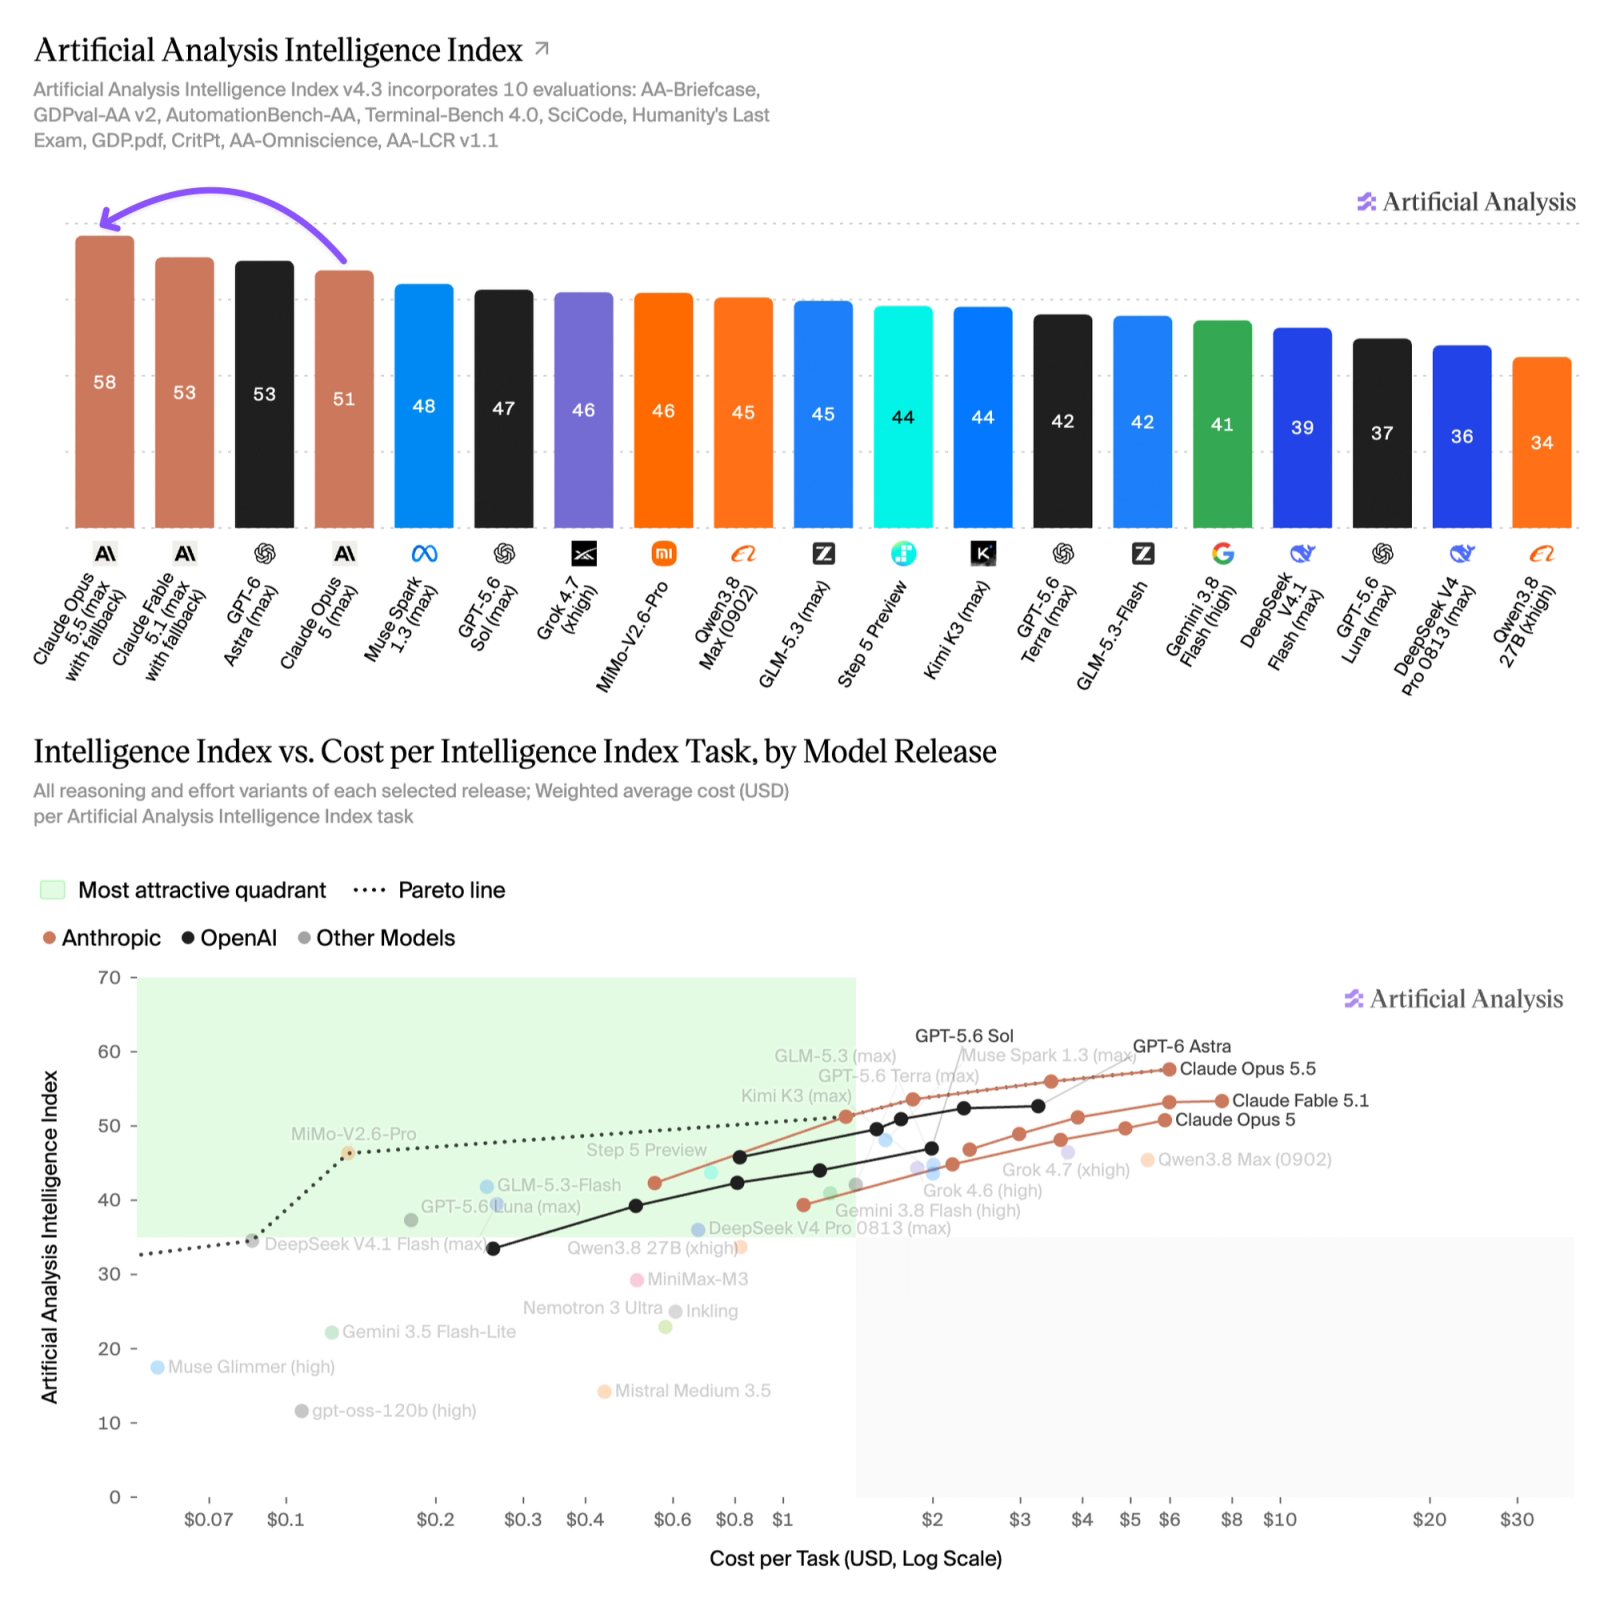
Artificial Analysis ha collocato Opus 5.5 Max a 58 sul suo Intelligence Index e ha riportato risultati solidi su AA-Briefcase, GDPval-AA, AutomationBench-AA, Terminal-Bench 4.0, SciCode e Humanity’s Last Exam. Il suo risultato su Terminal-Bench 4.0 è stato 59.6%, inferiore al 66.4% di Anthropic, dimostrando perché i team dovrebbero documentare versione del modello, livello di sforzo, harness, strumenti, numero di prove e limite di costo ogni volta che i punteggi non coincidono.
Confronto di prezzo e costo per task completato
CometAPI offre prezzi per token inferiori alle tariffe ufficiali, consentendo agli sviluppatori di ottenere le stesse prestazioni dell’API ufficiale utilizzando il formato standard di richiesta dei messaggi.
Prezzi per token
| Prezzi | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|
| Input | $4 | $10 |
| Output | $20 | $50 |
| Scrittura cache 5 min | $5 | $12.50 |
| Scrittura cache 1 ora | $8 | $20 |
| Lettura cache | $0.20 | $0.25 |
| Input/output batch | Sconto 50% | Sconto 50% |
Supponiamo che un carico di lavoro consumi 10 milioni di token freschi in input e 2 milioni di token in output. Senza effetti di cache:
10 × $4 + 2 × $20 = $80
10 × $10 + 2 × $50 = $200
In base a tali ipotesi, Opus 5.5 costa il 60% in meno. Tuttavia, questo numero non va confuso con l’affermazione di Anthropic secondo cui Opus 5.5 costa circa il 40% in meno da eseguire rispetto a Opus 5.
Si tratta di due confronti completamente diversi. La cifra del 40% include i prezzi più bassi del tier Opus per Opus 5.5 e la riduzione del consumo di token per task rispetto a Opus 5. La cifra del 60% deriva direttamente dal confronto dei prezzi standard di Opus 5.5 e Fable 5.1.
Costo per task completato
Un’API di modello in realtà non vende token. Gli sviluppatori acquistano lavoro completato.
Un team di coding non si preoccupa che un modello abbia consumato 6,2 milioni di token. Si preoccupa se il modello ha corretto il bug, completato la migrazione, passato la suite di test o terminato il task di ricerca.
Anthropic lo afferma direttamente nella sua analisi What a task costs on Opus 5.5: due modelli con prezzi simili possono avere costi per task molto diversi se uno necessita di più turni, rilegge più contesto, ritenta più spesso o genera più token di thinking.
Task Cost = Fresh Input Cost
          + Cache Read Cost
          + Cache Write Cost
          + Output / Thinking Cost
          + Retry Cost
Quest’ultimo elemento è spesso trascurato. Un modello più economico che fallisce due volte può diventare più costoso di un modello più caro che completa il task in un’unica esecuzione. Allo stesso modo, un’impostazione di sforzo elevata che evita dieci turni di retry può effettivamente abbassare il costo totale.
Economia del prompt caching
Agenti con uso intensivo della cache riutilizzano ripetutamente definizioni di strumenti, contesto di repository, istruzioni di sistema, cronologia conversazionale e output di test. Poiché il prezzo della lettura cache è $0.20/M per Opus 5.5 e $0.25/M per Fable 5.1, il divario è molto più piccolo rispetto alla differenza di $6/M nel prezzo dell’input fresco. I team dovrebbero quindi tracciare separatamente input freschi, letture cache, scritture cache, output, turni di strumenti e retry.
Economia dei livelli di sforzo
Potenzialmente sì. Artificial Analysis ha testato cinque impostazioni di sforzo di Opus 5.5 e ha trovato una chiara curva capacità-costo.
| Sforzo Opus 5.5 | Artificial Analysis Intelligence Index | Costo per task dell’Index |
|---|---|---|
| Low | 42 | $0.55 |
| Medium | 51 | $1.34 |
| High | 54 | $1.82 |
| Xhigh | 56 | $3.46 |
| Max | 58 | $5.98 |
Il livello Medium è un punto di partenza sensato per modifiche di codice di routine, refactor noti e debugging supervisionato. High o xhigh possono essere giustificati per guasti di sistema ambigui, migrazioni notturne o task in cui un piano errato genera un sostanziale rework.
Confronto di sicurezza e affidabilità
Nessuno dei due modelli dovrebbe essere etichettato come più sicuro basandosi esclusivamente su benchmark di capacità. Un confronto difendibile richiede prompt, strumenti, permessi, livelli di sforzo, limiti di retry e criteri di accettazione allineati. Una capacità maggiore può ridurre errori accidentali, ma maggiore autonomia ed esecuzioni più lunghe aumentano l’impatto di un piano sbagliato, di una prompt injection, di una chiamata a strumento non sicura o di una deriva non rilevata.
| Dimensione di sicurezza | Confronto pratico | Controllo in produzione |
|---|---|---|
| Reasoning e sforzo | Opus 5.5 espone più livelli di sforzo, mentre Fable 5.1 parte da una postura di sforzo più elevata. Più reasoning non sostituisce l’applicazione delle policy. | Fissare la policy di sforzo per carico di lavoro e ritestare il comportamento di sicurezza ogni volta che cambia. |
| Autonomia di lunga durata | Fable 5.1 è posizionato per lavori difficili e non presidiati; anche Opus 5.5 supporta flussi agentici. Il rischio cresce con durata, permessi e numero di azioni irreversibili. | Usare checkpoint, gate di approvazione, tetti di tempo e costo e condizioni di rollback o arresto automatico. |
| Uso di strumenti e computer | Entrambi i modelli possono operare strumenti, quindi la scelta del modello da sola non controlla l’esposizione dei dati o azioni distruttive. | Applicare il principio del minimo privilegio, allowlist, sandboxing, isolamento dei segreti e conferma prima di azioni esterne o irreversibili. |
| Valutazione e auditabilità | Punteggi di benchmark pubblici non stabiliscono qualità dei rifiuti, resistenza alla prompt injection o tassi di incidenti in produzione. | Loggare chiamate agli strumenti e decisioni di policy; misurare tasso di compliance non sicura, falsi rifiuti, successo di injection, leakage di segreti, tentativi distruttivi e qualità del recovery. |
Regola pratica di sicurezza: iniziare con la configurazione Opus 5.5 con il minimo privilegio che soddisfi il task ed eseguire l’escalation a Fable 5.1 solo dopo che la stessa suite di sicurezza viene superata. Per flussi di lavoro ad alto impatto, richiedere approvazione umana a prescindere da quale modello ottenga punteggi più alti nei test di capacità.
- Eseguire test avversariali di prompt injection ed esfiltrazione dati con il set di strumenti reale di produzione.
- Separare permessi di lettura, scrittura, pubblicazione, cancellazione e finanza invece di concedere un unico ruolo di strumento ampio.
- Definire trigger di rollback per violazioni di policy, ripetuti fallimenti degli strumenti, espansioni di scope inattese e sforamenti di costo.
- Rivalidare dopo cambiamenti di modello, system prompt, livello di sforzo, strumenti, permessi o routing.
Come scegliere tra Opus 5.5 e Fable 5.1
| Carico di lavoro | Punto di partenza consigliato | Condizione di escalation |
|---|---|---|
| Coding quotidiano e code review | Opus 5.5, livello Medium | Escalare solo per casi insolitamente difficili o ad alto rischio |
| Lavoro su feature multi-file | Opus 5.5, Medium o High | Usare Fable quando fallimenti ripetuti di pianificazione dominano i costi |
| Migrazione a livello di repository | Testare prima Opus 5.5 a High o Xhigh | Escalare per i progetti non presidiati più difficili |
| Esecuzioni autonome notturne | Opus 5.5 con checkpoint rigorosi | Preferire Fable quando il costo di una direzione errata è estremo |
| Traffico API ad alto volume | Opus 5.5 | Escalare solo la minoranza di task soggetti a fallimento |
| Deployment Fable già validato | Mantenere il deployment attuale durante i test | Passare solo dopo che Opus raggiunge le stesse soglie di accettazione |
Un test di produzione pratico
Eseguire gli stessi task rappresentativi, prompt, strumenti, policy di sforzo, criteri di accettazione e limiti di retry su entrambi i modelli. Registrare tasso di task accettati, latenza, input freschi e in cache, output e token di thinking, chiamate agli strumenti, retry, correzioni umane e costo totale per risultato accettato. Includere task di routine e casi di fallimento difficili.
Linee guida di migrazione per gli attuali utenti di Claude Opus 5
Gli utenti attuali di Opus 5 dovrebbero testare Opus 5.5 come successore invece di presumere che la sostituzione dell’ID modello sia priva di rischi. Confrontare profondità di pianificazione, pattern di chiamata agli strumenti, lunghezza delle risposte, conformità al formato, latenza, comportamento della prompt cache, recupero da chiamate a strumenti fallite, routing di sicurezza e costo per task completato. Mantenere criteri di rollback e il modello esistente disponibili finché Opus 5.5 non supera test di accettazione simili alla produzione.
Gli utenti attuali di Fable 5.1 non necessitano di una sezione di migrazione generica. Dovrebbero invece trattare Opus 5.5 come una possibile ottimizzazione e valutarlo secondo gli stessi criteri di accettazione di produzione prima di modificare un deployment già validato.
Accesso tramite CometAPI
Gli sviluppatori che valutano entrambi i modelli possono consultare le guide correlate CometAPI per Claude Opus 5.5 e Claude Fable 5.1. Integrando tramite qualsiasi provider API compatibile, confermare l’esatto ID del modello, i parametri di sforzo supportati, il comportamento della cache, i limiti di rate, la disponibilità regionale e il prezzo corrente prima del deployment in produzione.
Usare claude-opus-5-5 per Opus 5.5 e claude-fable-5-1 per Fable 5.1 laddove tali identificatori siano supportati. Evitare di instradare silenziosamente entrambe le classi di carico attraverso un unico livello di sforzo fisso; la selezione del modello e la policy di sforzo dovrebbero essere configurate indipendentemente.
Python — Anthropic Messages API tramite CometAPI
import os
import anthropic

client = anthropic.Anthropic(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com",)

message = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=2048,
    messages=[{"role": "user","content": ("Analyze this codebase and propose a safe migration plan."),}],)print(message.content[0].text)
Conclusione
Claude Opus 5.5 sposta il confine pratico tra il modello frontier quotidiano di Anthropic e il suo tier premium di escalation. È sostanzialmente più economico alle tariffe standard per token, guida molti benchmark pubblicati di coding e agentici e offre sufficiente flessibilità di sforzo per coprire un ampio spettro produttivo.
Claude Fable 5.1 resta rilevante quando il task è difficile, di alto valore, di lunga durata o non presidiato e il costo del fallimento supera il maggiore costo di inferenza. Per la maggior parte dei team, la politica migliore è iniziare con Opus 5.5, misurare gli esiti per task completato ed eseguire l’escalation in modo selettivo.
FAQ
Come dovrebbero i team progettare un test A/B di produzione per Opus 5.5 e Fable 5.1?
Usare gli stessi task rappresentativi, prompt, strumenti, policy di sforzo, criteri di accettazione e limiti di retry per entrambi i modelli. Registrare tasso di task accettati, latenza, input freschi e in cache, output e token di thinking, chiamate agli strumenti, retry, correzioni umane e costo totale per risultato accettato. Eseguire un numero sufficiente di task per coprire il lavoro di routine così come i casi di fallimento difficili.
Quando prezzi dei token più bassi possono non ridurre il costo totale per task?
Un modello a prezzo inferiore può comunque costare di più se richiede turni aggiuntivi, rilegge il contesto, produce più token di thinking o necessita di retry ripetuti. Anche il comportamento della cache conta: il divario di prezzo dell’input si riduce nelle sessioni lunghe dominate da letture cache. Confrontare il costo per task completato invece del solo list price.
Cosa dovrebbe essere documentato quando i risultati dei benchmark non coincidono?
Registrare versione del modello, livello di sforzo, harness, impostazioni di fallback e sicurezza, numero di prove, rilascio dei task, errore standard e tetto di costo. Etichettare ogni risultato come ufficiale o indipendente ed evitare di combinare punteggi da configurazioni non allineate in un’unica classifica.
Quali rischi di migrazione dovrebbero monitorare gli attuali utenti di Fable 5.1?
Osservare cambiamenti nella profondità di pianificazione, pattern di chiamata agli strumenti, lunghezza delle risposte, conformità al formato, latenza, comportamento della prompt cache, recupero dai fallimenti degli strumenti e routing di sicurezza. Mantenere disponibile il deployment esistente durante la valutazione, stabilire criteri di rollback e migrare solo dopo che Opus 5.5 soddisfa le stesse soglie di accettazione su task simili alla produzione.
Metadati SEO
Meta title: Claude Opus 5.5 vs Fable 5.1: Codice, costi e benchmark
Meta description: Confronta Claude Opus 5.5 e Claude Fable 5.1 tra benchmark di coding, prezzi API, velocità, caching, livelli di sforzo, costo per task completato e aderenza al carico di lavoro.
Parole chiave: Claude Opus 5.5 vs Claude Fable 5.1, Claude Opus 5.5, Claude Fable 5.1, benchmark di coding di Claude, prezzi API di Claude, CometAPI, modelli di coding AI
URL slug: claude-opus-5-5-vs-claude-fable-5-1