
In breve
DeepSeek V4.1 Flash sostituisce la precedente generazione V4 Flash con un modello MoE encoder–decoder causale da 552B parametri, comprensione nativa delle immagini, una finestra di contesto da 1M token e costi di serving sostanzialmente inferiori. Nel confronto ufficiale di DeepSeek, migliora la maggior parte dei benchmark di coding, terminale, sicurezza e agent rispetto a V4 Pro 0813, mentre V4 Pro rimane avanti su GPQA Diamond e HLE senza strumenti.
L’attuale pagina dei prezzi dell’API di DeepSeek elenca nuovamente deepseek-flash e deepseek-v4-pro come route separate, che servono rispettivamente V4.1 Flash e V4-Pro-0813. Hanno prezzi, limiti di concorrenza e supporto visione differenti. Le nuove integrazioni dovrebbero quindi selezionare l’ID modello che corrisponde al carico di lavoro previsto, invece di fare affidamento su comportamenti storici di alias.
Punti chiave
- V4.1 Flash e V4 Pro sono attualmente scelte API ufficiali distinte: usa deepseek-flash per V4.1 Flash e deepseek-v4-pro per V4-Pro-0813.
- I maggiori guadagni comparabili compaiono in attività su terminale, agent di coding, automazione ed esecuzione orientata alla sicurezza — non in ogni benchmark di ragionamento a libro chiuso.
- V4.1 Flash è sostanzialmente più economico rispetto alla route V4 Pro attualmente elencata su input con hit di cache, input con miss di cache e token di output.
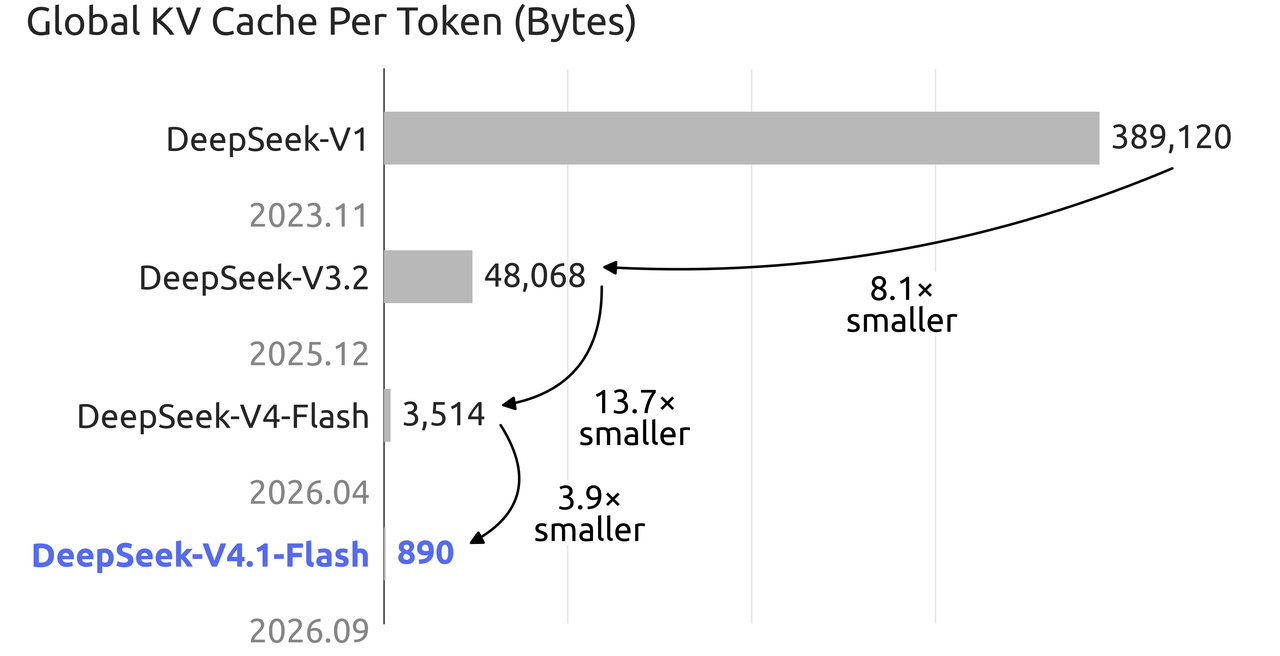
- V4.1 Flash aggiunge visione nativa, aumenta la concorrenza documentata da 500 a 2.500 e riduce lo storage globale della KV-cache a 890 byte per token.
- La migrazione dovrebbe essere esplicita anche se gli alias funzionano: aggiorna gli ID modello, convalida i comportamenti con e senza thinking, ritesta le chiamate agli strumenti e gli input immagine, e monitora l’uso di token e la latenza.
Nota di instradamento attuale: la pagina ufficiale dei prezzi identifica deepseek-v4-pro come V4-Pro-0813, separato da V4.1 Flash.
Come si confrontano le specifiche di DeepSeek V4.1 Flash e V4 Pro?
L’architettura è passata da un design MoE molto grande e sparso in V4 Pro a un design asimmetrico encoder–decoder causale in V4.1 Flash. Il modello più recente attiva meno parametri per l’elaborazione dell’input rispetto alla generazione dell’output, il che aiuta a ridurre il costo di prefill preservando al contempo una forte capacità di generazione.
| Specifiche | DeepSeek V4.1 Flash | DeepSeek V4 Pro 0813 |
|---|---|---|
| Architettura | MoE encoder–decoder causale | MoE sparso |
| Parametri totali Parametri del backbone / conteggio dei pesi nel repository | 552B parametri del backbone; Hugging Face indica una dimensione del modello di 763B | 1.6T parametri del backbone; Hugging Face indica una dimensione del modello di circa 1.7T |
| Parametri attivi | 8B per l’input; 16B per l’output | 49B per token |
| Finestra di contesto | 1M token | 1M token |
| Output massimo | 384K token | 384K token |
| Modalità 'thinking' e 'non-thinking' | Supportato | Supportato |
| Comprensione nativa delle immagini | Supportato | Non supportato |
| Concorrenza documentata | 2,500 | 500 nell’attuale configurazione |
| Stato API ufficiale attuale | Attivo come deepseek-flash | Attivo come deepseek-v4-pro (V4-Pro-0813) |
Chiarimento sul conteggio dei parametri: la scheda modello di V4.1 Flash di DeepSeek descrive 552B parametri del backbone, mentre il repository su Hugging Face riporta una dimensione del modello di 763B. Queste cifre descrivono ambiti di conteggio diversi e non dovrebbero essere presentate come totali intercambiabili.
Chiarimento sulla lunghezza dell’output: la scheda modello di V4.1 Flash raccomanda max_tokens ≥ 256K per l’inferenza locale, mentre l’attuale pagina dei prezzi dell’API di DeepSeek afferma esplicitamente un massimo di output di 384K per entrambi i modelli API. Un’impostazione di inferenza raccomandata non è la stessa di un limite massimo imposto dall’API.
Dove migliora DeepSeek V4.1 Flash rispetto a V4 Pro?
La tabella dei benchmark ufficiali di DeepSeek mostra i miglioramenti più chiari nei carichi di lavoro ad alta esecuzione. La colonna percentuale sotto è calcolata dai punteggi pubblicati; i confronti percentuali sono omessi laddove la metrica è una valutazione o dove una semplice percentuale sarebbe fuorviante.
| Benchmark | V4.1 Flash | V4 Pro 0813 | Differenza | Interpretazione |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 90.6 | 87.9 | +2.7 punti; +3.1% | Esecuzione su terminale più affidabile |
| Terminal-Bench 3.0 | 30.0 | 11.8 | +18.2 punti; +154.2% | Grande guadagno su task terminal più difficili |
| Terminal-Bench 4.0 | 31.2 | 12.4 | +18.8 punti; +151.6% | Grande guadagno su task terminal più recenti |
| DeepSWE v1.1 | 74.2 | 62.7 | +11.5 punti; +18.3% | Migliore lavoro software a livello di repository |
| ProgramBench | 20.3 | 15.5 | +4.8 punti; +31.0% | Program synthesis migliorata |
| NL2Repo-Bench | 64.0 | 61.5 | +2.5 punti; +4.1% | Miglior conversione linguaggio naturale→repository |
| CyberGym | 88.1 | 83.3 | +4.8 punti; +5.8% | Esecuzione cyber più forte |
| HLE with tools | 63.9 | 60.0 | +3.9 punti; +6.5% | Miglior ragionamento con strumenti |
| Automation-Bench | 54.8 | 43.2 | +11.6 punti; +26.9% | Guadagno materiale in automazione |
| Agents’ Last Exam | 31.8 | 25.7 | +6.1 punti; +23.7% | Migliore comportamento generale degli agent |
| Codeforces rating | 3,471 | 3,348 | +123 punti di rating | Miglior coding competitivo |
| GPQA Diamond | 90.9 | 92.4 | −1.5 punti | V4 Pro mantiene un vantaggio |
| HLE without tools | 36.8; 39.1 su subset testuale | 42.7 su subset testuale | −3.6 punti su subset testuale comparabile | V4 Pro mantiene un vantaggio |

Il risultato è multidimensionale: V4.1 Flash è decisamente migliore per agent di coding, operazioni da terminale, automazione, task di sicurezza, uso di strumenti, visione, concorrenza e costo. Il vantaggio residuo di V4 Pro è concentrato in alcuni test di puro ragionamento. I carichi di lavoro dovrebbero quindi essere valutati in base al mix di task, piuttosto che su una singola affermazione aggregata.
Perché DeepSeek V4.1 Flash è più efficiente di V4 Pro?
Calcolo asimmetrico tra input e output
V4.1 Flash attiva 8B parametri durante l’elaborazione dell’input e 16B durante la generazione dell’output. Questo design asimmetrico prende di mira le diverse esigenze di calcolo di prefill e decoding, riducendo i costi senza forzare entrambe le fasi attraverso lo stesso budget di parametri attivi.
Impronta KV-cache più piccola
DeepSeek riporta che V4.1 Flash usa un quarto della HBM e un ottavo della capacità SSD richieste dalla KV-cache della generazione precedente. Il grafico pubblicato colloca la KV-cache globale a 890 byte per token, rispetto ai 3,514 byte per V4 Flash.
Input multimodale nativo e concorrenza più alta
V4.1 Flash può interpretare le immagini in modo nativo ed espone un limite di concorrenza documentato di 2.500, cinque volte l’attuale valore di 500 di V4 Pro. Questi cambiamenti contano per agent basati su screenshot, estrazione di documenti, troubleshooting visivo e code di produzione ad alto volume.
Quanto costa DeepSeek V4.1 Flash rispetto a V4 Pro?
L’attuale listino ufficiale dell’API prezza le due route separatamente. Per 1M token, V4.1 Flash costa $0.003/$0.006 per input con hit di cache, $0.15/$0.30 per input con miss di cache e $0.60/$1.20 per output (off-peak/peak). V4 Pro costa rispettivamente $0.022/$0.044, $0.66/$1.32 e $1.98/$3.96. I prezzi possono cambiare, quindi i budget di produzione dovrebbero fare riferimento alla pagina dei prezzi in tempo reale.
Come migrare da DeepSeek V4 Pro o V4 Flash a V4.1 Flash?
Usa l’ID modello di produzione esplicito
Usa deepseek-flash quando vuoi V4.1 Flash. I nomi più vecchi deepseek-v4-flash e deepseek-v4-flash-vision-exp instradano ancora verso V4.1 Flash e vengono fatturati al nuovo prezzo Flash, ma una denominazione esplicita rende più semplice monitorare e auditare futuri rollback. Usa deepseek-v4-pro quando vuoi intenzionalmente il backend V4-Pro-0813 attualmente elencato.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_DEEPSEEK_API_KEY",
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-flash",  # or "deepseek-v4-pro"
    messages=[{"role": "user", "content": "Review this migration plan."}],
)

print(response.choices[0].message.content)
Ritesta il comportamento, non solo la compatibilità dell’endpoint
- Esegui prompt rappresentativi sia in modalità con thinking sia senza thinking; confronta successo del task, conteggio dei token e latenza.
- Ritesta gli schemi degli strumenti, l’output JSON, il comportamento della Responses API, la completazione con prefisso e FIM dove utilizzati.
- Aggiungi test con input immagine se il prodotto userà la nuova capacità visiva nativa.
- Reimposta i budget usando le tariffe peak e off-peak invece di portare avanti le assunzioni di V4 Pro.
- Traccia il tasso di hit della prompt-cache, perché può dominare il costo dell’input su larga scala.
Scegli esplicitamente il backend previsto
L’attuale route deepseek-v4-pro seleziona V4-Pro-0813. I team dovrebbero registrare la versione del modello risolta, la data di valutazione, il set di prompt e la finestra di prezzo, così che i confronti restino riproducibili se l’instradamento dovesse cambiare di nuovo.
Quali carichi di lavoro si adattano meglio a DeepSeek V4.1 Flash?
| Carico di lavoro | Scelta consigliata | Motivo |
|---|---|---|
| Agent di coding e manutenzione di repository | V4.1 Flash | Punteggi più alti su DeepSWE, ProgramBench, NL2Repo e terminale |
| Automazione guidata da strumenti | V4.1 Flash | Punteggi più alti su Automation-Bench, HLE-con-strumenti e agent |
| Assistenti con consapevolezza delle immagini | V4.1 Flash | Comprensione nativa delle immagini |
| Serving ad alto throughput o sensibile ai costi | V4.1 Flash | Concorrenza più alta e prezzi per token molto più bassi |
| Historical V4 Pro reproductionCurrent V4 Pro access and evaluation | V4 Pro | La route ufficiale identifica attualmente V4-Pro-0813 |
| Ragionamento puro a libro chiuso | Valida sui dati di dominio | V4 Pro rimane più alto su GPQA Diamond e HLE senza strumenti |
DeepSeek V4.1 Flash vs V4 Pro FAQ
DeepSeek V4.1 Flash è migliore di V4 Pro?
Per la maggior parte delle dimensioni di produzione — agent di coding, task da terminale, automazione, uso di strumenti, visione, throughput e prezzo — sì. V4 Pro ha ancora punteggi più alti pubblicati su GPQA Diamond e HLE senza strumenti, quindi i carichi di lavoro di puro ragionamento dovrebbero essere testati con prompt specifici di dominio.
Posso ancora chiamare deepseek-v4-pro?
Sì. L’attuale pagina ufficiale dell’API elenca deepseek-v4-pro come V4-Pro-0813, con propri prezzi e limite di concorrenza.
Quale ID modello dovrebbe usare una nuova integrazione?
Usa deepseek-flash per V4.1 Flash, o deepseek-v4-pro per V4-Pro-0813. Non trattare i due ID come alias.
Gli ID modello V4 Flash vecchi funzionano ancora?
DeepSeek afferma che le richieste a deepseek-v4-flash e deepseek-v4-flash-vision-exp sono instradate automaticamente a V4.1 Flash e fatturate al nuovo prezzo Flash. Si raccomanda comunque di aggiornare l’ID modello configurato per maggiore chiarezza.
DeepSeek V4.1 Flash supporta le immagini?
Sì. La comprensione nativa delle immagini fa parte di V4.1 Flash; l’API storica di V4 Pro non forniva questa funzionalità.
DeepSeek V4.1 Flash è più economico dell’attuale V4 Pro?
Sì. L’attuale listino ufficiale mostra prezzi più bassi per input con hit di cache, input con miss di cache e output per V4.1 Flash rispetto a V4 Pro.
Devo aspettarmi output identici dopo la migrazione?
No. La compatibilità dell’endpoint non garantisce percorsi di ragionamento, selezione degli strumenti, uso di token o formattazione identici. Riesegui le valutazioni di produzione prima di fare affidamento su soglie precedenti.