
TL;DR
Claude Fable 5.1 presenta un caso più solido nei benchmark per coding autonomo difficile e lavoro a lungo orizzonte. GPT-5.6 Sol offre costi token ordinari più bassi, un ampio stack di strumenti nativi e un tempo minore al primo token nel confronto indipendente a massimo sforzo. La scelta predefinita giusta dipende dal costo di un task fallito, non solo dal punteggio di benchmark più alto.
Nell’istantanea dell’8 settembre 2026 dell’Intelligence Index, Fable 5.1 segna 53, contro 47 per GPT-5.6 Sol. La velocità di output è praticamente alla pari a 69,9 contro 69,8 token/s. Questi risultati sostengono una decisione qualità-verso-costo; non stabiliscono un vincitore universale in velocità.
Key Takeaways
- Scegli Fable 5.1 per i task autonomi più difficili quando le tue valutazioni giustificano il prezzo più alto.
- Parti con GPT-5.6 Sol per inferenza “frontier” sensibile ai costi e applicazioni che beneficiano dei suoi strumenti integrati.
- Confronta separatamente il ritardo di avvio rispetto alla velocità di output: GPT-5.6 Sol ha un tempo al primo token inferiore, mentre il throughput è quasi uguale.
- Modella separatamente scritture/letture di cache, retention e tariffe long-context. I prezzi headline di input/output non descrivono ogni workload di agenti.
Dati verificati l’8 settembre 2026. I risultati indipendenti usano GPT-5.6 Sol al massimo sforzo e Fable 5.1 con Adaptive Reasoning, Max Effort, Default Fallback. I benchmark del vendor e quelli indipendenti usano setup di valutazione diversi. I prezzi sono in USD per milione di token (MTok), salvo diversa indicazione.
GPT-5.6 Sol vs Fable 5.1: verdetto rapido
| Dimensione | GPT-5.6 Sol | Claude Fable 5.1 | Scelta migliore |
|---|---|---|---|
| Intelligence Index indipendente v4.3 (8 set) | 47 | 53 | Fable 5.1 |
| Terminal-Bench 4.0 indipendente (7 set) | 39,9% | 52,0% | Fable 5.1 |
| Terminal-Bench 4.0 eseguito da Anthropic | 37,3% | 55,8% | Fable 5.1 |
| Finestra di contesto | 1,05M | 1M | Alla pari di fatto |
| Output massimo | 128K | 128K | Parità |
| Input testo/immagine | Sì | Sì | Parità |
| Prezzo ufficiale input / MTok | $4 | $10 | Sol |
| Prezzo ufficiale output / MTok | $20 | $50 | Sol |
| Lettura cache ufficiale / MTok | $0,40 | $0,25 | Fable 5.1 |
| Velocità di output indipendente (8 set) | 69,8 tok/s | 69,9 tok/s | Alla pari di fatto |
| Ampiezza strumenti API | Molto ampia | Forte | Sol |
| Lavoro autonomo di lunga durata | Eccellente | Punto di forza | Fable 5.1 |
| Produzione sensibile ai costi | Scelta migliore predefinita | Escalation premium | Sol |
Una policy iniziale utile è Sol per il lavoro “frontier” di routine, con Fable 5.1 come percorso di escalation quando un task non soddisfa la tua soglia di qualità o autonomia. Valida tale policy rispetto al costo per task riuscito.
GPT-5.6 Sol espone sei livelli di sforzo di ragionamento, da nessuno a massimo, con medio come default. Fable 5.1 usa pensiero adattivo sempre attivo; i controlli di sforzo modulano la profondità del ragionamento, e il default è alto.
I 50.000 token extra nel contesto di GPT-5.6 Sol difficilmente determineranno la maggior parte delle architetture. La fatturazione e il riuso della cache diventano più importanti man mano che una richiesta si avvicina al milione di token; la sezione sul long-context qui sotto spiega perché.
What is GPT-5.6 Sol?
GPT-5.6 Sol è un tier ad alta capacità nella famiglia GPT-5.6 di OpenAI per workflow impegnativi di coding, ricerca, pianificazione e agenti. Il suo principale punto di forza in questo confronto è la combinazione di controlli di ragionamento e dell’ambiente di esecuzione circostante.
Tramite la Responses API, GPT-5.6 Sol supporta un ampio portafoglio di strumenti nativi: web search, file search, code interpreter, hosted shell, apply patch, computer use, MCP, skills e tool search. Questo può ridurre il numero di componenti runtime separati che un’applicazione deve integrare.
OpenAI descrive anche chiamata di strumenti programmabile ed esecuzione multi-agente per la famiglia. Queste funzionalità di piattaforma contano quando un modello deve coordinare il lavoro tra strumenti, piuttosto che restituire una singola risposta.
What is Claude Fable 5.1?
Claude Fable 5.1 è rivolto a coding impegnativo, lavoro professionale di conoscenza, ricerca e agenti a lunga esecuzione. I suoi risultati diretti nei benchmark lo rendono un forte candidato per task in cui recupero, persistenza e completamento riuscito contano più di una risposta breve.
Anthropic enfatizza esecuzione autonoma sostenuta su diverse applicazioni, inclusi pianificazione, recupero da step falliti e comunicazione dei progressi. Considera tale posizionamento come un invito a testare task più lunghi, non come garanzia che ogni workflow finirà correttamente.
Fable 5.1 differisce anche da GPT-5.6 Sol nel comportamento API: le sue restrizioni di scelta forzata degli strumenti contano per i workflow che richiedono al modello di chiamare uno strumento specifico. Verifica le modalità supportate di tool_choice quando migri un loop di agenti deterministico.
La domanda di integrazione è quindi pratica: la tua applicazione può tollerare un loop di ragionamento più autonomo, oppure richiede un controllo più fine su ogni step? Testa il comportamento esatto degli strumenti prima di scegliere una strada.
Benchmark comparison: Fable 5.1 has the stronger direct evidence
I confronti di benchmark tra vendor concorrenti sono facili da fraintendere. Le valutazioni originali del lancio GPT-5.6 di OpenAI precedono Fable 5.1, mentre il rilascio di Fable 5.1 di Anthropic contiene confronti diretti più recenti con GPT-5.6 Sol.
Il modo più pulito di leggere le evidenze è quindi su tre livelli: il confronto diretto di Anthropic, i test indipendenti attuali e il profilo di capacità di GPT-5.6 Sol pubblicato da OpenAI.
Anthropic’s direct Fable 5.1 vs GPT-5.6 Sol results
I risultati ufficiali dei benchmark includono cinque task con punteggi riportati per entrambi i modelli. Le differenze in punti percentuali e Elo sotto sono calcolate a partire da quei valori pubblicati.
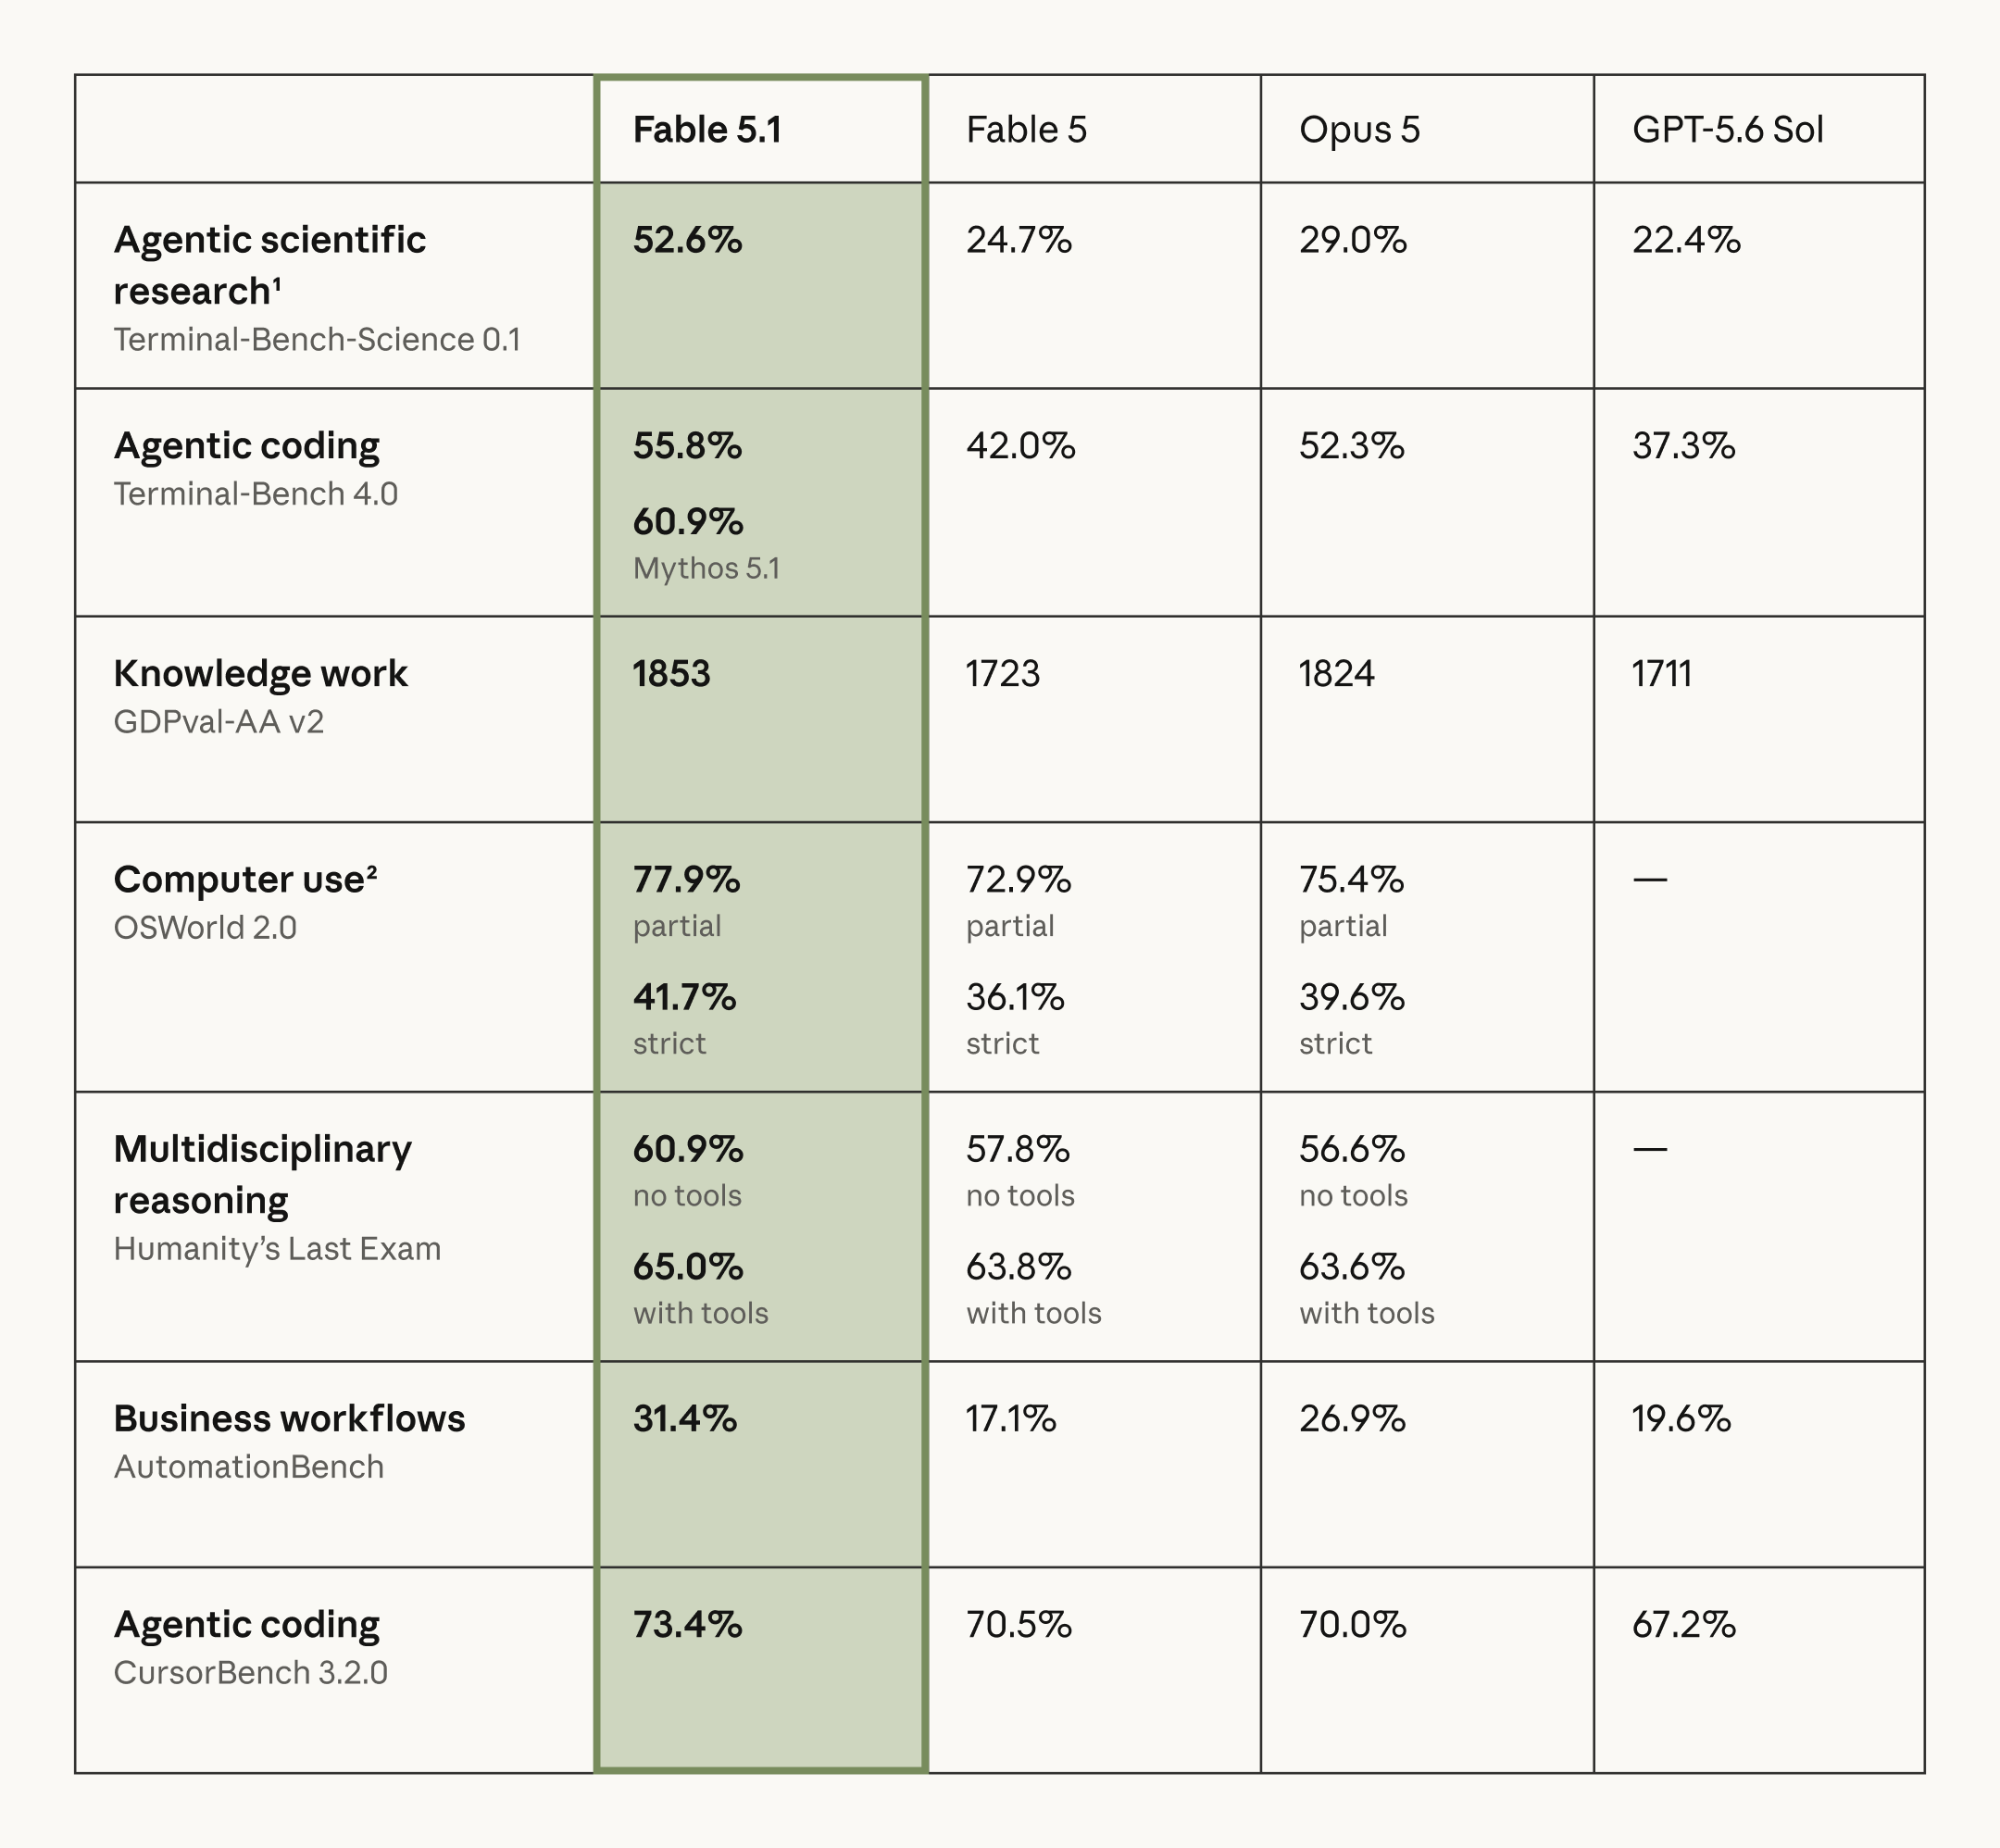
| Benchmark | GPT-5.6 Sol | Claude Fable 5.1 | Vantaggio Fable 5.1 |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 22,4% | 52,6% | +30,2 pt |
| Terminal-Bench 4.0 | 37,3% | 55,8% | +18,5 pt |
| GDPval-AA v2 | 1711 Elo | 1853 Elo | +142 Elo |
| AutomationBench | 19,6% | 31,4% | +11,8 pt |
| CursorBench 3.2.0 | 67,2% | 73,4% | +6,2 pt |
Il risultato è insolitamente coerente: Fable 5.1 supera GPT-5.6 Sol in ogni riga diretta pubblicata da Anthropic. Le differenze maggiori compaiono nella ricerca scientifica basata su agenti e nel coding su terminale, più che nel ragionamento breve ordinario.
Fonte: Anthropic — grafico di benchmark originale.
Si tratta di valutazioni gestite dal vendor: Anthropic ha testato sia il proprio modello sia quello concorrente. Forniscono evidenze comparative dirette, ma non sono test indipendenti. Anthropic riporta un errore standard di ±3,5–4,5 punti percentuali per modello su Terminal-Bench-Science; la tabella sopra mostra stime puntuali, non intervalli di confidenza.
I risultati del vendor favoriscono Fable 5.1, ma le evidenze indipendenti richiedono date e configurazioni proprie.
Independent benchmarks: separate dated results from live measurements
Artificial Analysis ha introdotto Intelligence Index v4.3 il 7 settembre, sostituendo Terminal-Bench 2.1 con Terminal-Bench 4.0 e aggiungendo AutomationBench-AA. Il rilascio riporta 53 per Fable 5.1 e 47 per GPT-5.6 Sol, in linea con i punteggi arrotondati mostrati nel confronto dell’8 settembre. La tabella distingue i risultati terminal del rilascio dalle misurazioni di performance successive.
| Confronto metriche AA indipendenti / rilascio v4.3 | GPT-5.6 Sol (max) | Claude Fable 5.1 (max) | Risultato |
|---|---|---|---|
| Intelligence Index v4.3 (8 set) | 47 | 53 | Fable |
| Terminal-Bench 4.0 (rilascio 7 set) | 39,9% | 52,0% | Fable |
| OSWorld 2.0 | 62,6% | 41,7% | |
| Velocità di output (8 set) | 69,8 tok/s | 69,9 tok/s | Alla pari di fatto |
| Tempo al primo token (8 set) | 132,10 s | 277,47 s | Sol |
| Prezzo normalizzato AA del mix di token / MTok | $3,08 | $7,175 | Sol |
Istante: 8 settembre 2026, salvo la riga Terminal-Bench del 7 settembre esplicitamente datata. Fable 5.1 usa Adaptive Reasoning, Max Effort, Default Fallback; Sol usa max. Le misurazioni live possono cambiare. Il prezzo normalizzato di AA per il mix di token usa un rapporto 7:2:1 tra cache-hit/input/output; non è il costo di ogni richiesta API.
OSWorld 2.0 è il vantaggio più grande riportato per Sol in questo confronto: 62,6% contro 41,7% per Fable 5.1, un vantaggio di 20,9 punti. Questo controbilancia i risultati più forti di Fable su Intelligence Index e Terminal-Bench.
Le evidenze supportano un trade-off specifico: Fable 5.1 ha un punteggio Intelligence Index più alto, mentre Sol ha un tempo al primo token più basso e un prezzo normalizzato inferiore. Il throughput di output è praticamente uguale. Queste misurazioni sostengono scelte diverse per lavoro batch sensibile alla qualità e applicazioni interattive.
Il confronto indipendente datato su Terminal-Bench punta nella stessa direzione del test di Anthropic: 52,0% contro 39,9%, rispetto al 55,8% contro 37,3% del vendor. I due gap non sono intercambiabili perché i setup di valutazione differiscono.
What OpenAI’s benchmarks still tell us about GPT-5.6 Sol
Le valutazioni di lancio di OpenAI forniscono ulteriore contesto sulle capacità di GPT-5.6 Sol. Precedono i nuovi risultati testa a testa discussi sopra, quindi non andrebbero usate come confronto diretto con Fable 5.1.
OpenAI riporta 88,8% su Terminal-Bench 2.1 per GPT-5.6 Sol. È evidenza di forte capacità di coding basato su agenti nel setup di lancio; la versione di benchmark più vecchia non va confrontata numericamente con i punteggi di Terminal-Bench 4.0.
GPT-5.6 Sol vs Fable 5.1 for coding
Per generazione di codice “semplice”, entrambi i modelli sono sovradimensionati per molti workload di produzione. La separazione diventa più chiara quando il coding diventa ingegneria del software basata su agenti: ispezionare un grande repository, modificare più file, eseguire comandi, diagnosticare errori, scrivere test e iterare finché il task non passa.
Qui, Claude Fable 5.1 ha un caso benchmark attuale più forte. Guida sia il confronto Terminal-Bench 4.0 del vendor sia quello indipendente, e anche il risultato su CursorBench di Anthropic lo favorisce 73,4% a 67,2%.
Per una valutazione pratica del coding, includi cambiamenti su tutto il repository, test, review e performance. Uno snippet di codice breve riuscito è un proxy debole per completare un task che copre più file e tentativi falliti.
GPT-5.6 Sol resta convincente quando l’ambiente di esecuzione circostante conta quanto la qualità grezza del modello. Il supporto nativo per shell execution, apply-patch, code interpreter, file search, computer use e MCP può ridurre l’infrastruttura di orchestrazione che devi costruire.
Verdetto per il coding: scegli Fable 5.1 quando le tue evals enfatizzano il lavoro autonomo più duro su repository. Scegli GPT-5.6 Sol quando una capacità leggermente inferiore nei benchmark è accettabile in cambio di costi più bassi e di uno stack di esecuzione integrato ampio.
Reasoning controls and developer experience
Le due API espongono l’intelligenza in modo diverso.
La gamma di sforzo di Sol da “nessuno” a “massimo” permette a un team di testare qualità e ritardo a vari settaggi. Uno sforzo più basso può ridurre il lavoro di ragionamento, ma il settaggio giusto dipende dal costo del fallimento del task.
Il pensiero adattivo sempre attivo di Fable rende la taratura dello sforzo un esercizio diverso. Confronta i settaggi che la tua applicazione distribuirà, invece di trattare etichette di sforzo identiche come budget di calcolo identici.
Non esiste quindi un confronto universalmente equo tra “Sol di default” e “Fable di default”. Le loro configurazioni di ragionamento predefinite differiscono. Le valutazioni in produzione dovrebbero confrontare o budget di sforzo equivalenti o i settaggi esatti che la tua applicazione userà davvero.
GPT-5.6 Sol vs Fable 5.1:Which is better for AI agents?
La scelta dipende dal collo di bottiglia: ragionamento difficile o runtime circostante.
Il vantaggio di Fable nei benchmark citati per terminale, automazione e lavoro professionale lo rende un candidato sensato per i task più difficili. Misura il tasso di completamento e il recupero dagli step falliti prima di generalizzare quel vantaggio al tuo agente.
Il portfolio di strumenti documentato di Responses per GPT-5.6 Sol lo rende interessante per applicazioni costruite attorno a search, file, esecuzione shell e patch. È un vantaggio di integrazione da valutare insieme all’accuratezza del task, non un suo sostituto.
| Requisito dell’agente | GPT-5.6 Sol | Claude Fable 5.1 |
|---|---|---|
| Ragionamento duro a lungo orizzonte | Eccellente | Miglior corrispondenza |
| Autonomia terminal/repository | Eccellente | Evidenza più forte |
| Portafoglio di strumenti nativi integrati | Più forte | Forte |
| Selezione forzata dello strumento | Supportata; verificare l’API scelta | Limitata; verificare le modalità tool_choice |
| Integrazione piattaforma multi-agente | Vantaggio forte | Disponibile via architettura di agenti |
| Comunicazione progressi in lavori lunghi | Buona | Comportamento centrale |
| Agenti ad alto volume sensibili ai costi | Meglio | Premium |
| Contesto massivo ripetuto in cache | Buono | Potenzialmente molto interessante |
Usare entrambi può essere economico quando solo una piccola quota di task richiede escalation. Misura se i completamenti extra compensano il prezzo più alto e il ritardo di avvio del secondo modello.
Long context: 1.05M vs 1M is not the important difference
I numeri headline sembrano quasi identici: GPT-5.6 Sol offre 1,05M token e Fable offre 1M. Una differenza di capacità del 5% difficilmente determinerà se puoi analizzare un grande repository, un corpus legale, un archivio di ricerca o una storia di agente multi-ora. Entrambi sono già nella classe del milione di token.
Per GPT-5.6 Sol, input sopra 272K attiva tariffe long-context più alte per la richiesta: $8/MTok input, $0,80/MTok input in cache e $30/MTok output. Anche le scritture in cache passano da $5 a $10/MTok.
Fable 5.1 mantiene le sue tariffe standard per contesto 1M: $10/MTok input, $50/MTok output e $0,25/MTok letture di cache. Non c’è un premium separato sopra 272K in questa configurazione documentata.
Considera un turno con 100K token di input non in cache, 900K token letti dalla cache e 20K token totali di output fatturati. GPT-5.6 Sol costa 0,1 × $8 + 0,9 × $0,80 + 0,02 × $30 = $2,12. Fable 5.1 costa 0,1 × $10 + 0,9 × $0,25 + 0,02 × $50 = $2,225.
Questo turno “cache-heavy” riduce quasi il gap di prezzo perché Fable ha letture di cache più economiche. Il risultato dipende dal mix di token del workload; non significa che i due modelli costino uguale per un’intera sessione di agente.
Ipotesi di costo: il prefisso da 900K token è già in cache, e i 100K di input freschi non vengono fatturati come nuova scrittura di cache. La stima esclude la scrittura iniziale in cache e le fee degli strumenti. L’allocazione di 20K di output include tutto l’output fatturato, inclusi eventuali token di ragionamento fatturati.
Pricing: Sol wins ordinary workloads, Fable wins one important cache metric
Alle tariffe verificate, Sol costa $4 input / $20 output per MTok, con letture di cache a $0,40. Fable 5.1 costa $10 input, $50 output e $0,25 letture di cache. La tabella separa i prezzi del provider dalle tariffe GPT-5.6 Sol API in CometAPI e Claude Fable 5.1 API in CometAPI.
| Componente di prezzo | Prezzi ufficiali GPT-5.6 Sol | Prezzi ufficiali Claude Fable 5.1 |
|---|---|---|
| Input ufficiale / MTok | $4,00 | $10,00 |
| Output ufficiale / MTok | $20,00 | $50,00 |
| Lettura cache ufficiale / MTok | $0,40 | $0,25 |
| Scrittura cache ufficiale / MTok | $5,00 (30 minuti) | $12,50 (5 minuti) |
| Sopra 272K di input: input / lettura cache / scrittura cache / output | $8 / $0,80 / $10 / $30 | Stesse tariffe base documentate |
| CometAPI input / MTok | $3,20 | $8,00 |
| CometAPI output / MTok | $16,00 | $40,00 |
Le durate di scrittura della cache differiscono: Sol usa un periodo di retention predefinito di 30 minuti, mentre la tariffa mostrata per Fable 5.1 è per una scrittura di 5 minuti. Verifica creazione, refresh ed espirazione della cache per il provider e la route che usi.
Alle tariffe verificate del provider diretto, Fable 5.1 costa 2,5× rispetto a Sol sia per input non in cache ($10 vs $4/MTok) sia per output ($50 vs $20/MTok). Tratta queste tariffe come confronto datato, poiché promozioni del provider e prezzi gateway possono cambiare.
Una richiesta a contesto breve con 100K di input e 10K di output totale fatturato costa circa $0,60 con Sol o $1,50 con Fable alle tariffe del provider diretto. Alle tariffe CometAPI sopra, lo stesso mix costa $0,48 o $1,20. Questi esempi escludono scritture in cache e fee degli strumenti.
La tariffa di lettura della cache di Fable su contesto breve è inferiore del 37,5%: ($0,40 − $0,25) ÷ $0,40. Può contare per agenti che riusano un grande prefisso stabile, ma il risparmio totale dipende comunque da input fresco, frequenza di scrittura e volume di output.
Verdetto sui prezzi: Sol è il punto di partenza più economico per traffico a contesto fresco. Fable diventa più competitivo man mano che cresce la quota di lettura da cache; confronta il costo dell’intera sessione, inclusa creazione e refresh della cache.
Speed and latency
I test a sforzo massimo possono impiegare molto tempo a ragionare prima del primo token visibile.
Le misurazioni di throughput e latenza dell’8 settembre mostrano 69,9 token/s di output per Fable e 69,8 per Sol. Il tempo al primo token è 277,47 secondi contro 132,10 secondi. Il throughput di output è praticamente uguale; in questa configurazione Sol inizia a produrre output visibile prima.
Queste sono misurazioni di benchmark a massimo sforzo, non latenza promessa per ogni chiamata API. Lunghezza del prompt, configurazione del ragionamento, carico del provider, strumenti e stato della cache possono cambiare il risultato. Tempo al primo token e tempo di risposta completo sono metriche diverse.
Per lavoro interattivo, il minor ritardo di avvio osservato può favorire Sol. Per ricerche asincrone o lavoro su repository notturno, il completamento riuscito può contare più dell’attesa del primo token. Esegui benchmark su entrambi i modelli ai settaggi e alla concorrenza che intendi usare.
Safeguards are a production difference
Entrambi i modelli applicano salvaguardie più forti poiché le loro capacità si estendono a domini sensibili di cybersecurity e scientifici, ma le implementano in modo diverso.
OpenAI descrive protezioni stratificate e monitoraggio per la famiglia GPT-5.6. Le applicazioni in domini sensibili dovrebbero valutare le salvaguardie rilevanti come parte del comportamento in produzione.
I termini di rerouting e retention di Anthropic descrivono l’instradamento di alcune richieste sensibili di cybersecurity o biologia verso modelli meno capaci, senza addebitare la tariffa Fable per tali richieste reindirizzate. Il periodo di retention dei dati di default è 30 giorni, con eccezioni per accordi enterprise idonei.
Per coding e lavoro di conoscenza ordinari, queste differenze possono non emergere mai. Per prodotti di sicurezza, workload regolamentati o deployment sensibili alla privacy, appartengono alla checklist di valutazione insieme a qualità dei benchmark e prezzo.
Which model should you choose?
Il confronto complessivo può essere ridotto alla forma del workload.
| Carico di lavoro | GPT-5.6 Sol | Claude Fable 5.1 | Raccomandazione |
|---|---|---|---|
| Coding autonomo difficile | Eccellente | Benchmark attuali più forti | Fable 5.1 |
| Ricerca a lungo orizzonte | Eccellente | Punto di forza | Fable 5.1 |
| API “frontier” ad alto volume | Molto più economico | Costoso | Sol |
| Assistente di coding interattivo | TTFT a massimo sforzo più basso misurato | TTFT a massimo sforzo più alto misurato | Testare i settaggi deployati |
| Agente API ricco di strumenti | Stack nativo di strumenti più ampio | Forte | Sol |
| Agente con contesto in cache da 1M token | Competitivo | Prezzo lettura cache molto basso | Testare entrambi |
| Qualità massima di ragionamento | Eccellente | Vantaggio indipendente | Fable 5.1 |
| Costo per richiesta ordinaria | Vantaggio netto | Premium | Sol |
| Ragionamento su immagini/documenti | Forte | Forte | Test su workload |
| Stack single-provider OpenAI | Adattamento naturale | Richiede migrazione/gateway | Sol |
| Routing indipendente dal modello | Forte | Forte | Usare entrambi via CometAPI |
Una policy di routing deve giustificare la propria complessità. Confronta un baseline a singolo modello con una policy “Sol-first” che scala i task difficili a Fable 5.1, e mantieni il router solo se migliora qualità o costo per task riuscito.
How to compare GPT-5.6 Sol and Fable 5.1 through CometAPI
CometAPI integra già GPT-5.6 Sol e Claude Fable 5.1. Accedi a entrambi i modelli con i rispettivi formati di richiesta nativi, invia lo stesso set di valutazione e confronta i risultati restituiti con settaggi allineati.
Usa richieste in formato nativo per ciascun modello e mantieni fermi prompt, dataset, settaggi di sforzo, concorrenza e regole di scoring. Ripeti le esecuzioni; una singola richiesta sequenziale per modello non basta per stimare in modo affidabile latenza o qualità.
Per una valutazione di produzione, usa un set di prompt fisso, esecuzioni ripetute in ordine alternato, registra il settaggio di sforzo e misura correttezza, tasso di passaggio dei test, successo degli strumenti, retry, uso di token, tempo trascorso e costo totale per task riuscito. Ottimizza ciascun modello separatamente dopo il baseline comune.
Final verdict: GPT-5.6 Sol or Claude Fable 5.1?
Fable 5.1 ha evidenze dirette più forti per il coding autonomo più difficile e il lavoro a lungo orizzonte. Guida le cinque righe condivise del benchmark del vendor e il confronto terminal indipendente datato. Questo lo rende un forte candidato di escalation, soggetto a validazione sui tuoi task.
Sol ha prezzi token ordinari più bassi, controlli di ragionamento più fini e un ampio stack di strumenti nativi. Nella configurazione indipendente a massimo sforzo verificata, ha anche un tempo al primo token inferiore; il throughput di output è praticamente alla pari.
Dai priorità a Fable 5.1 quando i task autonomi più duri determinano il tuo tasso di successo. Parti con Sol per inferenza “frontier” attenta ai costi o applicazioni ricche di strumenti. Per workload interattivi, testa i settaggi deployati per confermare se il vantaggio osservato di ritardo d’avvio persiste.
Scegli un singolo modello quando soddisfa i requisiti in modo semplice. Aggiungi routing quando i risultati di valutazione mostrano che alternare tra i due migliora qualità o costo per task riuscito.
FAQ
Claude Fable 5.1 è migliore di GPT-5.6 Sol?
Ha un Intelligence Index indipendente più alto nell’istantanea dell’8 settembre: 53, contro 47 per Sol. Guida anche il test terminal indipendente datato. Questo supporta un vantaggio di qualità su queste valutazioni, non che sia migliore per ogni workload.
GPT-5.6 Sol è più economico di Claude Fable 5.1?
Per traffico API ordinario non in cache, sì: le tariffe verificate del provider diretto sono $4/$20 per MTok per Sol e $10/$50 per Fable 5.1. Workload pesanti di cache possono ridurre quel divario perché la lettura cache di Fable costa meno. Includi comportamento di scrittura ed espirazione nell’estimo.
Quale modello è migliore per il coding?
Fable 5.1 ha evidenze benchmark più forti per coding autonomo in questo confronto. Sol resta attraente per workflow a costo più basso e i suoi strumenti di esecuzione integrati. Usa task su repository con test eseguibili per decidere se il gap misurato conta per la tua applicazione.
Quale modello ha una finestra di contesto più ampia?
Sol guida tecnicamente a 1,05M contro 1M token di Fable 5.1, mentre entrambi consentono fino a 128K di output. In pratica, la soglia tariffaria >272K di Sol e le letture di cache economiche di Fable sono di solito più importanti della differenza di capacità di 50K token.
Posso accedere a entrambi i modelli tramite CometAPI?
Sì. Le API GPT-5.6 Sol in CometAPI e Claude Fable 5.1 in CometAPI supportano un punto di partenza comune per valutazioni di testo. Verifica ragionamento, caching e supporto strumenti specifici della route prima di estendere il baseline a un agente di produzione.