TL;DR
GPT-6.1 Sol non è una variante con contesto più ampio o più costosa rispetto a GPT-6 Sol. Mantiene la stessa finestra di contesto da 1,05 milioni di token, output massimo da 128K e prezzi API Standard di $2/$10, migliorando al contempo coding, uso del computer, flussi di lavoro professionali, affidabilità fattuale e comportamento agentico. Il cambiamento di prezzo più evidente riguarda la cache dei prompt: il costo dell’input in cache scende da $0,20 a $0,10 per milione di token.
Il risultato pratico è che GPT-6.1 Sol punta meno a cambiare la forma dell’API e più a ottenere un lavoro sostanzialmente più utile con all’incirca lo stesso budget di token.
Punti chiave
- GPT-6.1 Sol è un upgrade di capacità rispetto a GPT-6 Sol, con la stessa finestra di contesto da 1.050.000 token e il tetto di output a 128.000 token.
- I prezzi Standard per input e output restano a $2/M e $10/M; l’input in cache scende da $0,20/M a $0,10/M.
- Le valutazioni ufficiali mostrano maggiore forza in coding, uso del computer, automazione business e flussi scientifici; i risultati dipendono dal benchmark e dall’impostazione di reasoning.
- La migrazione richiede di controllare sia lo sforzo di reasoning sia la compatibilità dell’endpoint API: GPT-6.1 Sol non rimuove nulla e richiede Responses API per le chiamate agli strumenti.
- Convalidare successo del task, latenza, hit effettivi della cache e costo end-to-end prima di sostituire un deployment GPT-6 Sol stabile.
Che cos’è GPT-6.1 Sol e perché è arrivato così presto dopo GPT-6 Sol?
OpenAI ha introdotto GPT-6 Sol il 22 settembre 2026. Una settimana dopo, il 29 settembre, il suo system-card addendum ha annunciato GPT-6.1 Sol. OpenAI presenta la nuova release come un upgrade a GPT-6 Sol piuttosto che un livello di prezzo separato.
Il breve intervallo di rilascio è significativo perché GPT-6.1 Sol non è posizionato come un nuovo tier di prodotto. OpenAI ha mantenuto il tier Sol e ha concentrato l’aggiornamento su capacità per compiti difficili, efficienza dei costi e affidabilità degli agenti.
OpenAI posiziona GPT-6.1 Sol intorno al coding agentico, all’uso del computer e al lavoro professionale. Il confronto importante è il successo del compito a un dato costo, più che il nome del modello in sé. Il riepilogo dei benchmark ufficiali qui sotto separa i guadagni di capacità dalle specifiche API invariate.
Questo rende il confronto insolitamente lineare: GPT-6.1 Sol è principalmente un upgrade di capacità ed efficienza più che un upgrade della finestra di contesto o del prezzo base.
GPT-6.1 Sol vs. GPT-6 Sol: cosa resta uguale?
Entrambi i modelli mantengono la stessa capacità di punta, le modalità di input/output supportate e i prezzi Standard per input/output. La tabella annota anche differenze nelle date di cutoff, nelle opzioni di reasoning, nelle chiamate agli strumenti e nelle tariffe per input in cache; tali differenze non vanno confuse con specifiche condivise.
Specifiche condivise e differenze di compatibilità
| Specifica | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|
| Model ID | gpt-6.1-sol | gpt-6-sol |
| Data di rilascio | 29 set 2026 | 22 set 2026 |
| Finestra di contesto | 1.050.000 token | 1.050.000 token |
| Output massimo | 128.000 token | 128.000 token |
| Knowledge cutoff | 30 apr 2026 | 20 apr 2026 |
| Input / output testo | Sì / Sì | Sì / Sì |
| Input immagine | Sì | Sì |
| Prezzo input Standard | $2,00 / 1M | $2,00 / 1M |
| Input in cache | $0,10 / 1M | $0,20 / 1M |
| Cache write | $2,50 / 1M | $2,50 / 1M |
| Prezzo output | $10,00 / 1M | $10,00 / 1M |
| Sforzo di reasoning | low, medium, high, xhigh, max | none, low, medium, high, xhigh, max |
| Output strutturati | Sì | Sì |
| Function calling | Sì tramite Responses API; non disponibile via Chat Completions | Sì tramite Responses API; Chat Completions solo con reasoning_effort=none |
| Fine-tuning | No | No |
| Input audio / video | Non supportato | Non supportato |
| Output immagine nativo | Non supportato; image generation è uno strumento separato | Non supportato; image generation è uno strumento separato |
Le due colonne ufficiali del modello sopra documentano gli stessi limiti di contesto e output. Questi numeri descrivono la capacità; non implicano pari accuratezza di retrieval o latenza in ogni workload a lungo contesto.
La knowledge cutoff avanza leggermente, dal 20 al 30 aprile 2026. Più importante, GPT-6.1 Sol non supporta più reasoning.effort="none"; le impostazioni disponibili partono da low.
Per gli sviluppatori che dipendono dal comportamento a latenza minima, questo dettaglio di compatibilità merita test perché GPT-6 Sol supporta ancora lo sforzo di reasoning none.
Architettura: cosa resta non divulgato
Nessuna delle pagine modello usate per questo confronto fornisce un conteggio dei parametri o un’analisi dettagliata dell’architettura. Il system-card addendum ufficiale afferma che GPT-6.1 Sol usa gli stessi tipi di dati e training di Astra; ciò non prova che Sol e Astra abbiano architetture identiche. Differenze di architettura e scala dei parametri restano quindi non divulgate nel materiale citato.
Prezzo base invariato; letture in cache più economiche
Per i token ordinari non in cache, no. Le tariffe Standard di input e output restano invariate. Il principale miglioramento di prezzo riguarda l’input in cache.
| Prezzi API ufficiali — USD per 1M token | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|
| Input / 1M token | $2,00 | $2,00 |
| Input in cache / 1M | $0,10 | $0,20 |
| Cache write / 1M | $2,50 | $2,50 |
| Output / 1M token | $10,00 | $10,00 |
GPT-6.1 Sol riduce l’input in cache a $0,10 per milione di token, cioè il 5% della tariffa di input non in cache.
Ad esempio, riutilizzare 100 milioni di token di input in cache costa circa $10 su GPT-6.1 Sol contro $20 su GPT-6 Sol. La differenza è modesta per prompt isolati ma più significativa per agent ad alto volume con prefissi di prompt stabili.
Si applicano anche le condizioni di prezzo ufficiali mostrate nella documentazione del modello: richieste sopra 272K token di input usano tariffe input e cache 2x e prezzi output 1,5x per l’intera richiesta. La modalità Fast di GPT-6.1 Sol è 2x rispetto allo Standard; Batch e Flex sono al 50% sotto lo Standard. L’elaborazione regionale aggiunge un 10% di maggiorazione dove disponibile, e la modalità Fast non è disponibile con residenza dati UE. Possono applicarsi addebiti separati per gli strumenti. Pianifica il budget in base alla modalità di elaborazione selezionata, alla regione e agli effettivi hit di cache.
Cosa è migliorato in GPT-6.1 Sol?
L’upgrade si valuta meglio su coding, workflow agentici, documenti professionali, scienza, fattualità e recupero dagli errori. Le sezioni seguenti raggruppano tali miglioramenti mantenendo le condizioni e le limitazioni dei benchmark originali.
Panoramica dei benchmark: guadagni riportati e condizioni di valutazione
Il punto di forza di GPT-6.1 Sol emerge dalla performance a livello di task più che dalle specifiche grezze. OpenAI riporta miglioramenti in ingegneria del software, automazione business, interazione con il computer, flussi scientifici, fattualità e allineamento degli agenti.
| Risultati benchmark / valutazioni ufficiali | GPT-6.1 Sol vs. GPT-6 Sol | Cosa significa il cambiamento |
|---|---|---|
| DeepSWE v1.1 | +6,4 punti percentuali rispetto al miglior risultato di GPT-6 Sol, con minore sforzo di reasoning e costo per task; non è confronto a pari sforzo | Ingegneria software a lungo orizzonte più forte |
| AutomationBench 1.0.6 | +4,8 punti a sforzo medio per entrambi i modelli Sol; +2,2 punti su Opus 5.5 a sforzo medio | Migliore esecuzione agent multi-step nel business |
| OSWorld 2.0 offline | +7 punti a sforzo massimo; ricompensa parziale sul set offline, release v2026.08.08; meno della metà del costo per task | Flussi di uso del computer migliorati |
| Terminal-Bench Science 0.1 | Oltre 2x il punteggio di GPT-6 Sol a sforzo massimo, con meno della metà del costo per task | Grande guadagno nei flussi scientifici agentici |
| Valutazione di fattualità difficile | A sforzo basso, risposte con errori in calo dall’11,4% al 7,7%; valutazione selezionata su prompt difficili | Meno errori fattuali su prompt difficili |
| Test di allineamento con ricerca rotta | A sforzo massimo, mancata dichiarazione della ricerca rotta dal 4,9% al 2,1%; task deliberatamente avversari | Miglior riconoscimento dei guasti degli strumenti |
Questi sono risultati riportati da OpenAI, non misurazioni indipendenti di CometAPI. OpenAI ha valutato i suoi modelli nel suo ambiente di ricerca o tramite API; il comportamento in produzione può differire con prompt di sistema e strumenti disponibili. Le cifre dei concorrenti provengono da report pubblici. Il costo del task riflette la configurazione testata e non coincide con il prezzo per token. Non si devono inferire dettagli non riportati come budget per run o scaffold.
Il risultato ufficiale nella tabella di benchmark confronta GPT-6.1 Sol a sforzo di reasoning inferiore con il miglior punteggio di GPT-6 Sol. Non va descritto come un confronto di velocità a pari sforzo. DeepSWE v1.1 valuta task originali di ingegneria del software in codebase reali.
Per contesto, il lancio originale di GPT-6 Sol riportava 68,8% a sforzo massimo su DeepSWE v1.1.
Coding: ingegneria del software a lungo orizzonte più robusta
Il coding è probabilmente l’upgrade più netto. DeepSWE v1.1 valuta agent su task originali di ingegneria del software in codebase reali che richiedono lavoro sostenuto e multi-step.
Il miglioramento su DeepSWE riassunto sopra è rilevante quando un agente deve ispezionare un repository, pianificare modifiche, usare strumenti e riparare errori attraverso molti step. Gli sviluppatori possono confrontare questo upgrade con GPT-6 Astra API in CometAPI per decidere se i task più difficili giustificano un modello a costo più alto.
Questo conta più di un breve benchmark di coding perché agent di coding long-running accumulano costi attraverso reasoning ripetuto, chiamate agli strumenti, letture file, patch e riuso di contesto. GPT-6.1 Sol migliora sia il completamento dei task sia l’economia del contesto ripetuto senza aumentare la tariffa standard $2/$10 per token.
La GPT-6 Sol API in CometAPI resta utile per deployment esistenti e offre un percorso compatibile con OpenAI per workload di coding e agentici.
Agenti AI e flussi di lavoro business: automazione e uso del computer
Sì, e il miglioramento va oltre il coding. AutomationBench valuta se un agente può completare workflow end-to-end usando molti strumenti in ambiti sales, marketing, operations, support, finance e HR.
Il risultato a medio sforzo abbinato in AutomationBench nel riepilogo è pertinente ai workflow business fortemente basati su strumenti. Resta un risultato di benchmark, non una garanzia di successo nello stack di strumenti di un’azienda. Il confronto include anche Claude Opus 5.5 API in CometAPI; valuta tutti i candidati con gli stessi strumenti e criteri di successo prima di selezionarne uno.
Per l’uso del computer, il risultato su OSWorld sopra usa il set offline e ricompensa parziale. Un punteggio più alto con ricompensa parziale non implica necessariamente che ogni task sia completato end-to-end. Stato del browser, permessi, comportamento di recovery e qualità dell’integrazione degli strumenti influenzano ancora gli esiti in produzione.
Documenti professionali e scienza: capacità su compiti complessi più ampia
GPT-6.1 Sol spinge il tier Sol più avanti anche nel knowledge work professionale. OpenAI valuta la comprensione di documenti complessi con GDP.pdf, dove i modelli rispondono a domande realistiche basate su PDF contenenti tabelle, grafici, diagrammi, formattazione densa e note in piccolo in campi come finanza, sanità e diritto.
GDP.pdf aggiunge evidenza per l’analisi professionale di PDF oltre alla semplice domanda-risposta testuale. Considera il risultato nel lancio come una valutazione di comprensione documentale, non una garanzia che ogni grafico, nota a piè di pagina o pagina scansionata venga interpretata correttamente.
Il risultato su Terminal-Bench Science nel riepilogo ufficiale copre flussi quali analisi dati, simulazione e dimostrazione di teoremi. Una valutazione locale utile dovrebbe misurare correttezza e riproducibilità dell’output finale, rilevando anche il costo totale di strumenti e modello.
Questo non significa che GPT-6.1 Sol sostituisca universalmente Astra. OpenAI continua a posizionare Astra come il suo modello di massima capacità per il lavoro end-to-end più difficile. Il cambiamento importante è che il divario di performance tra Sol e Astra si riduce mentre il loro divario di prezzo per token resta ampio.
Fattualità e affidabilità degli agenti: meno errori e miglior gestione dei guasti
I dati di fattualità di OpenAI vanno in quella direzione, sebbene la valutazione non vada interpretata come un tasso universale di allucinazioni.
L’annuncio ufficiale riporta direttamente un miglioramento di fattualità a sforzo basso: le risposte contenenti errori scendono dall’11,4% con GPT-6 Sol al 7,7% con GPT-6.1 Sol, un calo di 3,7 punti percentuali, pari a circa il 32% di riduzione relativa. Queste conversazioni selezionate in precedenza innescavano errori; le cifre non sono un tasso universale di allucinazione.
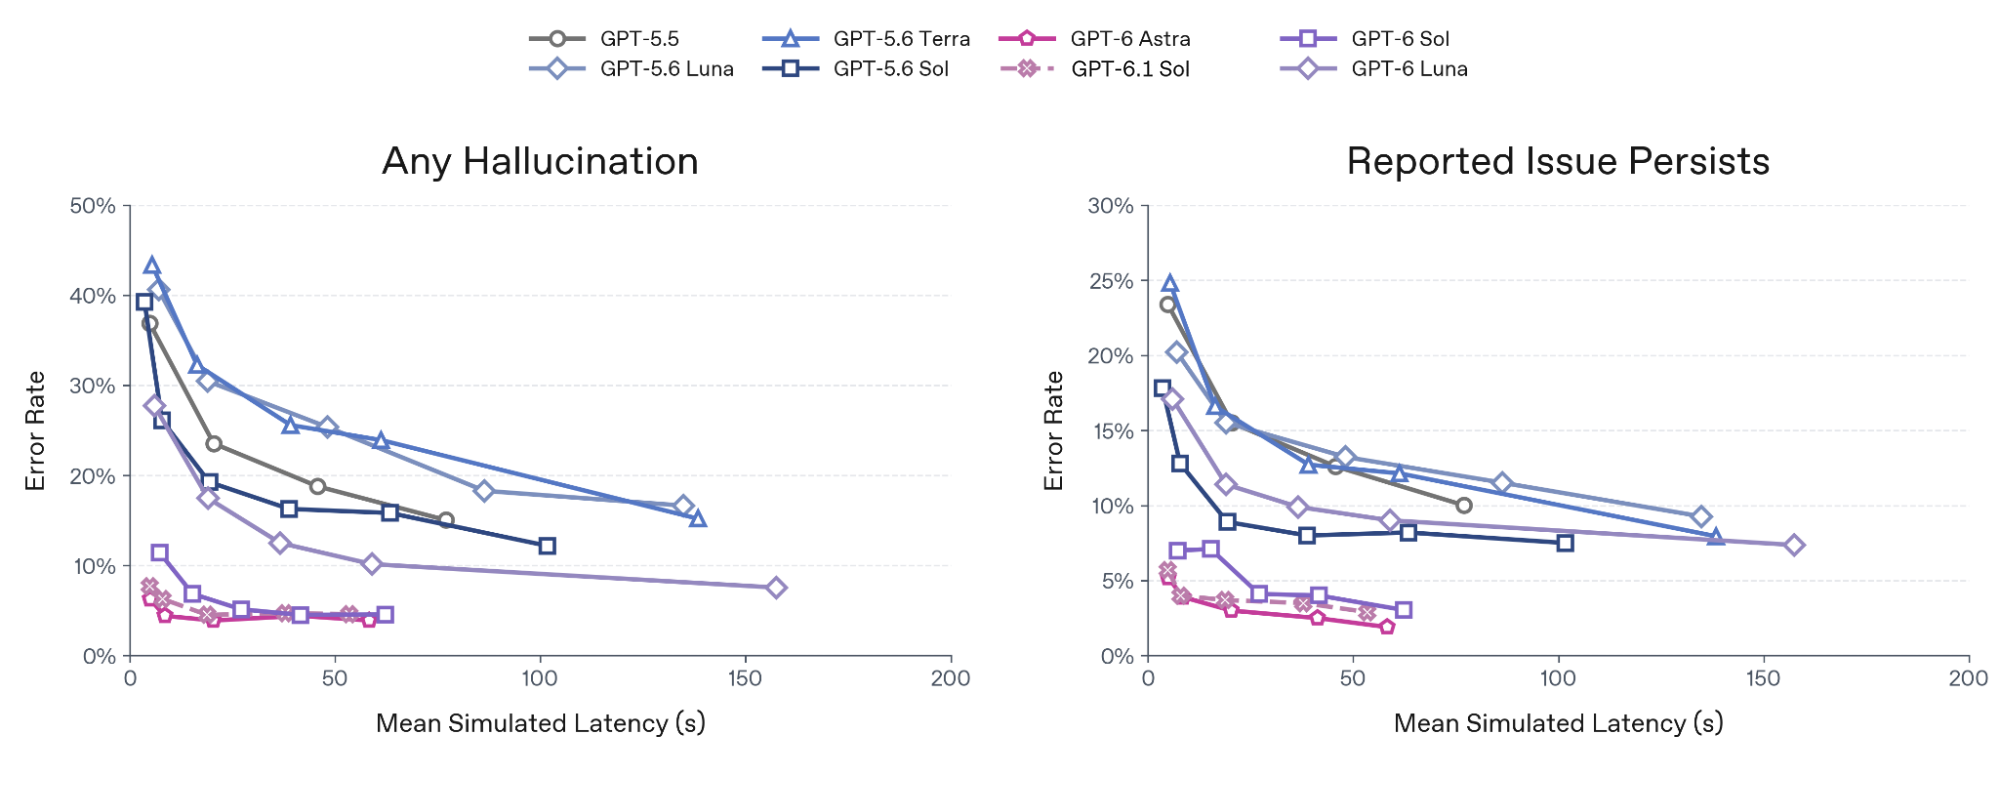
Il grafico originale sopra è estratto direttamente dal PDF della system card di OpenAI senza ridisegno. Traccia valutazioni selezionate di conversazioni difficili contro la latenza simulata; i due pannelli misurano qualsiasi allucinazione e la persistenza del problema riportato. Non va letto come una stima di errore valida per la produzione.
| Modello | Tasso di failure con ricerca rotta — sforzo massimo |
|---|---|
| GPT-6.1 Sol | 2,1% |
| GPT-6 Sol | 4,9% |
| GPT-6 Astra | 1,5% |
| GPT-6 Luna | 28,7% |
La GPT-6 Luna API in CometAPI è un’altra opzione orientata ai costi, ma il suo risultato sulla ricerca rotta qui illustra perché un agente deve essere testato sulla gestione dei guasti oltre che sull’esecuzione riuscita degli strumenti.
Si tratta di valutazioni deliberatamente avversarie piuttosto che tassi di failure rappresentativi della produzione. Sono utili come evidenza che GPT-6.1 Sol è migliore nel riconoscere quando gli strumenti non sono disponibili o sono guasti, invece di proseguire con affermazioni non supportate.
GPT-6.1 Sol vs. GPT-6 Sol: conviene aggiornare?
Per un nuovo workflow complesso, GPT-6.1 Sol è un forte candidato di valutazione. Per un deployment stabile di GPT-6 Sol, aggiorna solo quando i guadagni misurati giustificano la migrazione. Il limite di contesto condiviso e i prezzi base per token rendono possibile un confronto equo, ma i benchmark pubblici non possono decidere se la tua applicazione diventerà più veloce, affidabile o economica.
Quando vale la pena testare l’upgrade
Dai priorità a una prova quando il coding a livello di repository, l’automazione business multi-step, l’uso del computer o l’analisi di documenti complessi rappresentano una quota sostanziale del tuo workload. I miglioramenti riportati nella sezione precedente sono rilevanti per questi casi d’uso. Considerali motivi per testare, non garanzie che il tuo tasso di successo in produzione aumenterà nella stessa misura.
Anche le applicazioni con contesto ripetuto sono un buon caso di test. La tariffa ridotta per le letture in cache può diminuire la parte di fattura dell’input quando le richieste riutilizzano davvero un prefisso stabile. Se la maggior parte della spesa deriva da token generati, strumenti o tentativi falliti, lo sconto sulla cache può avere scarso effetto. Confronta il costo totale per risultato accettato, inclusi retry e tempi di revisione.
Quando è ragionevole tenere GPT-6 Sol
Mantieni GPT-6 Sol quando soddisfa già i tuoi obiettivi di qualità, latenza e budget e il modello più recente non porta benefici materiali in una valutazione rappresentativa. Anche un’integrazione funzionante ha valore: evita di sostituire una rotta stabile solo perché il nome del modello è più recente.
La compatibilità può essere decisiva. GPT-6 Sol supporta il reasoning none; GPT-6.1 Sol parte da low. Un’applicazione che usa le function call di Chat Completions di Sol con none deve spostare il loop degli strumenti su Responses per usare 6.1 Sol. Controlla anche i parametri di campionamento e il parsing delle risposte. Questi sono cambiamenti di migrazione, non un semplice swap di model ID. Vedi le linee guida di migrazione OpenAI.
Come decidere l’upgrade
Crea un set di valutazione fisso con task di routine, casi difficili e guasti degli strumenti del workflow previsto. Mantieni costanti le definizioni dei task, i permessi degli strumenti e i criteri di accettazione. Confronta una baseline Sol validata con una configurazione 6.1 Sol valida; registra esplicitamente le impostazioni di reasoning invece di fingere che none e low siano equivalenti.
- Qualità: misura completamenti accettati, correzioni fattuali, chiamate agli strumenti non valide e sforzo di revisione umana.
- Velocità: confronta la latenza end-to-end p50/p95, inclusi retry e attese degli strumenti.
- Costo: registra input non in cache, letture in cache, cache write, token di reasoning e output, addebiti per strumenti e sforzo di engineering.
- Rollout: inizia con una piccola quota di traffico, preserva un fallback Sol ed espandi solo quando si raggiungono soglie predefinite.
Raccomandazione pratica: scegli GPT-6.1 Sol quando la prova offre migliori economics per task accettato o un guadagno di capacità necessario senza regressioni inaccettabili. Tieni GPT-6 Sol per le rotte dove compatibilità e risultati comprovati superano il beneficio misurato. Un deployment misto è sensato quando solo alcune classi di task migliorano. Queste sono raccomandazioni basate sul workload, non l’affermazione che un modello vinca universalmente.
Come migrare da GPT-6 Sol a GPT-6.1 Sol?
Al livello più semplice, l’identificatore del modello cambia da gpt-6-sol a gpt-6.1-sol.
Una richiesta Responses API può essere così:
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "medium"},
    input="Analyze this repository and identify the cause of the failing tests."
)

print(response.output_text)
Cambiare l’identificatore del modello è solo il primo passo. GPT-6.1 Sol supporta low, medium, high, xhigh e max, mentre GPT-6 Sol supporta anche none. Rimuovi qualsiasi impostazione esplicita none e scegli uno sforzo consentito. Le applicazioni che usano strumenti hanno anche bisogno delle Responses API: Chat Completions di GPT-6.1 Sol non supporta le chiamate agli strumenti, mentre Chat Completions di GPT-6 Sol supporta le function call solo con none. Le colonne ufficiali del modello nella tabella delle specifiche documentano queste restrizioni di endpoint.
I team dovrebbero ritestare i workflow sensibili alla latenza, le chiamate agli strumenti, la cache dei prompt, il comportamento su contesti lunghi e qualsiasi logica che invii esplicitamente reasoning.effort="none".
Questo esempio punta direttamente a OpenAI usando OPENAI_API_KEY; non è un esempio verificato di endpoint CometAPI. Mantieni disponibile la tua rotta GPT-6 Sol durante un rollout graduale, registra successo dei task e latenza p95 e fai rollback se i criteri di accettazione della tua applicazione non sono soddisfatti.
Quali workload traggono più vantaggio dall’upgrade a GPT-6.1 Sol?
| Workload | Vantaggio di GPT-6.1 Sol |
|---|---|
| Agenti di coding | Performance DeepSWE più alta |
| Debugging a livello repo | Migliore ingegneria software a lungo orizzonte |
| Agenti browser/computer | +7 punti su OSWorld 2.0 |
| Automazione enterprise | Performance AutomationBench più alta |
| Agenti con contesto ripetuto | Letture in cache più economiche del 50% |
| Analisi PDF complesse | Performance sui documenti professionali vicina ad Astra |
| Flussi scientifici | Oltre 2x il punteggio di GPT-6 Sol nella valutazione Terminal-Bench Science di OpenAI |
| Workflow sensibili ai fatti | Tasso di errori fattuali più basso su prompt difficili |
| Agenti centrati sugli strumenti | Comportamento migliore quando gli strumenti falliscono |
GPT-6 Sol resta utile dove le integrazioni esistenti sono già stabili o dove gli sviluppatori hanno specificamente bisogno dell’impostazione di reasoning none. Per nuovi deployment centrati su agenti, coding, uso del computer o workflow con contesto ripetuto, GPT-6.1 Sol modifica l’equazione costo-prestazioni senza cambiare il normale prezzo per token di input/output.
In che modo CometAPI può aiutarti ad aggiornare da GPT-6 Sol a GPT-6.1 Sol?
Per gli sviluppatori che già usano la GPT-6 Sol API in CometAPI, l’upgrade a GPT-6.1 Sol può essere gestito come una migrazione relativamente piccola, non una riscrittura completa dell’integrazione.
GPT-6.1 Sol è ora disponibile tramite CometAPI con l’identificatore di modello gpt-6.1-sol. CometAPI mostra attualmente un prezzo di input short-context a partire da $1,60 per milione di token, rispetto alla tariffa ufficiale OpenAI di $2,00, mentre il prezzo di output parte da $8,00 per milione di token. Questo mantiene il modello Sol più recente nello stesso schema di prezzi scontati di GPT-6 Sol, dando agli sviluppatori accesso a prestazioni più forti in coding, agent e uso del computer.
Poiché CometAPI fornisce un’interfaccia compatibile con OpenAI, le applicazioni esistenti di GPT-6 Sol possono di solito mantenere la stessa struttura SDK e il flusso di richiesta, cambiando semplicemente l’ID modello in gpt-6.1-sol. CometAPI offre anche strumenti per confrontare modelli, testare prompt, stimare costi di workload e ispezionare il comportamento della migrazione prima del rollout in produzione.
Un processo di upgrade più sicuro è eseguire prima gli stessi prompt rappresentativi su GPT-6 Sol e GPT-6.1 Sol, poi confrontare qualità dell’output, latenza, comportamento degli strumenti e costo totale. Questo è particolarmente importante per applicazioni che dipendono da impostazioni di reasoning, output strutturati, chiamate agli strumenti o agent long-running, perché la compatibilità del modello non garantisce comportamento identico su ogni workload.
Per team che gestiscono workload con contesto ripetuto o pesantemente agentici, la rotta più recente può migliorare anche l’economia. CometAPI attualmente prezza le letture in cache short-context di GPT-6.1 Sol a $0,08 per milione di token, contro i $0,10 ufficiali di OpenAI, mentre le tariffe di input e output short-context sono indicate al 20% in meno rispetto ai prezzi ufficiali.
In pratica, CometAPI può rendere la transizione GPT-6 Sol → GPT-6.1 Sol un processo in tre step:
- Sostituisci
gpt-6-solcongpt-6.1-sol. - Esegui benchmark sugli stessi prompt e workflow agentici di produzione prima di spostare il traffico.
- Sposta i workload gradualmente una volta che qualità dell’output, comportamento degli strumenti, latenza e costo soddisfano i tuoi requisiti.
Questo approccio consente agli sviluppatori di adottare GPT-6.1 Sol senza ricostruire l’applicazione attorno a un nuovo stack API, pur convalidando le differenze comportamentali introdotte dal modello più recente.
Conclusione
GPT-6 Sol non è tecnicamente obsoleto. Mantiene la stessa finestra di contesto da 1,05M, il tetto di output a 128K, output strutturati, input immagine e prezzi Standard $2/$10. La sua opzione di reasoning none può contare anche per integrazioni esistenti. La decisione di upgrade dovrebbe basarsi su risultati di task misurati e compatibilità, non solo sulla versione.
Tuttavia, la documentazione di GPT-6 Sol di OpenAI ora indirizza gli sviluppatori a GPT-6.1 Sol come modello Sol più recente.
Per la maggior parte dei workload complessi, la domanda chiave non è quindi se GPT-6.1 Sol abbia una finestra di contesto più ampia o una tariffa più alta per token—non è così. La domanda è se maggior successo nei task, letture in cache più economiche, fattualità migliorata e comportamento agentico più forte giustifichino il cambio dell’identificatore di modello e il retest del workload.
FAQ
Come si migra da GPT-6 Sol a GPT-6.1 Sol con chiamate agli strumenti?
No. Verifica prima endpoint e campi della richiesta, poi sposta il loop degli strumenti su Responses API e testa parsing delle chiamate, validazione degli argomenti, retry e gestione degli errori. Esegui un canary su task rappresentativi prima di aumentare il traffico; una richiesta solo testo riuscita non verifica un loop strumenti funzionante.
GPT-6.1 Sol è più economico nei workload reali?
Traccia token di input in cache e non in cache, cache write, token di reasoning e di output, modalità di elaborazione e addebiti degli strumenti. Confronta il costo per task accettato piuttosto che il solo prezzo dei token in cache. I prefissi stabili aiutano solo quando le richieste colpiscono effettivamente la cache, e loop di strumenti più lunghi o tentativi falliti possono compensare i risparmi della cache.
Come testare GPT-6.1 Sol prima di passare da GPT-6 Sol?
Usa un set fisso di task simili alla produzione e registra completamento riuscito, correzioni fattuali, chiamate agli strumenti non valide, latenza p50/p95 e costo totale. Definisci soglie accettabili prima dei test. Mantieni una rotta di fallback sul modello precedente ed espandi il traffico solo dopo che la nuova configurazione soddisfa tali soglie.
Come testare GPT-6.1 Sol con PDF?
Costruisci un piccolo corpus con tabelle dense, note a piè di pagina, grafici e pagine scansionate rappresentative del workflow previsto. Poni domande con risposte verificabili e richiedi evidenza di pagina o tabella. Valuta separatamente accuratezza dei calcoli, caveat mancanti e risposte non supportate; mantieni revisione umana per output i cui errori abbiano conseguenze materiali.