TL;DR
Grok 4.7 e Xiaomi MiMo‑V2.6 sono state rilasciate a un solo giorno di distanza, ma rappresentano due approcci diversi all’AI di frontiera. Grok 4.7 enfatizza uno stack di agenti proprietario e strettamente integrato per coding e lavoro professionale basato sulla conoscenza, mentre MiMo‑V2.6‑Pro combina pesi aperti, una finestra di contesto più ampia, comprensione multimodale nativa e prezzi API aggressivi.
SpaceXAI posiziona Grok 4.7 come il suo modello di frontiera per coding, attività agentiche e lavoro di conoscenza con una finestra di contesto da 500K token e sforzo di ragionamento configurabile.
Xiaomi posiziona MiMo‑V2.6‑Pro come una ammiraglia multimodale con contesto da 1M con pesi aperti e supporto alla comprensione di testo, immagini, audio e video.
In sintesi: Grok 4.7 è il prodotto più verticalmente integrato e gestito a livello di agenti; MiMo‑V2.6‑Pro offre ai developer maggiore controllo sul deployment e prezzi per token grezzi molto più bassi. La scelta migliore dipende dal carico di lavoro, non da un singolo punteggio di benchmark.
Punti chiave
- Grok 4.7 è costruito per coding di lungo orizzonte e agenti professionali. Nella valutazione pubblicata dal fornitore di SpaceXAI, ottiene 46,3% su CursorBench 4.0, 71,0% su DeepSWE v1.1 con effort alto e 1.657 su AA Briefcase v1.1.
- MiMo‑V2.6‑Pro è insolitamente competitivo per un modello open. Xiaomi pubblica i pesi del modello e riporta risultati vicini ai sistemi proprietari di frontiera su vari benchmark di coding e agent, ma i punteggi tra vendor non sono direttamente intercambiabili.
- MiMo ha il vantaggio di contesto e multimodalità. MiMo‑V2.6‑Pro supporta una finestra di contesto da 1M token e comprensione di testo, immagini, audio e video, rispetto ai 500K di contesto di Grok 4.7 con input di testo e immagini.
- MiMo è sostanzialmente più economico sui token API grezzi. Il prezzo standard ufficiale è $0.435/$0.87 per milione di token input/output non in cache per MiMo‑V2.6‑Pro contro $2/$6 per Grok 4.7.
- L’architettura di deployment è il trade‑off decisivo. Grok offre lo stack di strumenti hosted first‑party più solido; i pesi aperti di MiMo abilitano deployment privato, serving personalizzato e controllo più profondo dell’infrastruttura.
Grok 4.7 vs MiMo‑V2.6‑Pro a colpo d’occhio
| Dimension | Grok 4.7 | MiMo-V2.6-Pro |
|---|---|---|
| Release | 21 settembre 2026 | 22 settembre 2026 |
| Access and control | API proprietaria ed ecosistema di agent gestiti | Pesi aperti, opzione self‑hosting e accesso API |
| Performance evidence | Forza dichiarata dal provider in coding e task agent a lunga durata; validare sullo stesso harness | Forza dichiarata dal provider in ragionamento, coding e compiti multimodali; validare sullo stesso harness |
| Distinctive strengths | Strumenti first‑party, workflow gestiti e agent connessi al web/X | Controllo del deployment, contesto da 1M token e comprensione di testo/immagini/audio/video |
| Context window | 500K token | 1M token |
| Input modalities | Testo e immagine | Testo, immagine, audio e video |
| Official standard uncached input / output per 1M tokens | $2 / $6 | $0.435 / $0.87 |
| Reasoning | Low to xHigh | Ragionamento profondo |
| Open weights | No | No |
| Best fit | Workflow gestiti di coding e agent | Deployment privato, input multimodale e costo token grezzo inferiore |
Che cos’è Grok 4.7?
SpaceXAI ha rilasciato ufficialmente Grok 4.7 il 21 settembre 2026 come suo modello più capace per coding e lavoro di conoscenza. Il lancio è significativo perché i report pre‑release mescolavano fatti confermati con presunte fughe su aspetti architetturali. La documentazione finale del lancio non pubblica il numero totale o attivo di parametri, quindi le stime pre‑release sui parametri non vanno considerate specifiche ufficiali.
Secondo il post di lancio ufficiale, Grok 4.7 usa un nuovo modello base, più grande, rispetto a Grok 4.6 ed è stato addestrato con un run di reinforcement learning più lungo, pesato verso problemi che richiedono molte ore per essere completati.
I modelli ottimizzano livelli diversi dello stack. Grok 4.7 offre un ambiente gestito più ricco attorno al modello; MiMo‑V2.6‑Pro espone di più il modello e il livello di deployment agli sviluppatori.
Per prompt oltre 200K token, SpaceXAI applica prezzi per contesti più alti. La fascia pubblicata è $4 per milione di token input, $1 per milione di token input in cache e $12 per milione di token output.
Novità in Grok 4.7
Il cambiamento più significativo è l’obiettivo di training, non semplicemente un numero di benchmark più alto. SpaceXAI afferma che il mix di reinforcement learning si è spostato verso task più lunghi, di molte ore, mentre il modello è stato addestrato a verificare il proprio lavoro con maggiore attenzione e a comprendere nativamente il harness Grok Bot. Questa combinazione mira alla vera esecuzione agentica: mantenere lo stato, usare strumenti, controllare il lavoro intermedio e restare coerente in lunghi percorsi di task.
Prestazioni di Grok 4.7
| SpaceXAI-published benchmark | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| CursorBench 4.0 | 46.3% | 40.4% | 41.7% | 51.8% |
| DeepSWE v1.1 | 71.0%* | 65.2% | 72.7% | 70.0% |
| EEBench | 64.0% | 53.0% | 39.4% | 56.4% |
| AA Briefcase v1.1 | 1,657 | 1,546 | 1,487 | 1,678 |
| Terminal-Bench 4.0 | 38.0% | 20.3% | 37.3% | 57.9% |
| Harvey Legal Agent Benchmark | 19.6% | 15.8% | 2.5% | 6.7% |
| HealthBench Professional | 56.7% | 48.5% | 60.5% | 62.1% |
SpaceXAI indica DeepSWE di Grok 4.7 come high effort. Si tratta di valutazioni pubblicate dal vendor e vanno interpretate in base all’harness e alle impostazioni di ragionamento documentati.
SpaceXAI presenta i grafici di lancio come contenuti web‑native sulla pagina ufficiale dell’annuncio; la tabella riportata sopra conserva i valori di benchmark divulgati senza sostituirli con un grafico ridisegnato.
Che cos’è Xiaomi MiMo‑V2.6?
Xiaomi ha rilasciato ufficialmente e open‑sourced MiMo‑V2.6 il 22 settembre 2026. La famiglia include MiMo‑V2.6‑Pro e MiMo‑V2.6‑Flash, con un’opzione di serving Pro‑UltraSpeed per carichi sensibili alla latenza. Per un confronto diretto con Grok 4.7, MiMo‑V2.6‑Pro è l’ammiraglia corrispondente.
I materiali ufficiali di Xiaomi documentano separatamente pesi aperti, input multimodale nativo e prezzi API. Questa combinazione rende MiMo‑V2.6 rilevante oltre le classifiche di benchmark.
MiMo‑V2.6 vs MiMo‑V2.5: cosa è stato migliorato?
Il titolo architetturale non è semplicemente un checkpoint più grande. Il rilascio pubblico di Xiaomi punta molto sul post‑training e sul Live RL. Secondo le note di rilascio ufficiali, Pro e Flash hanno completato ciascuno 30 step di reinforcement learning e insieme hanno generato circa 750.000 traiettorie; i costi dell’RL stage divulgati sono stati approssimativamente $2,62 milioni per Pro e $850.000 per Flash.
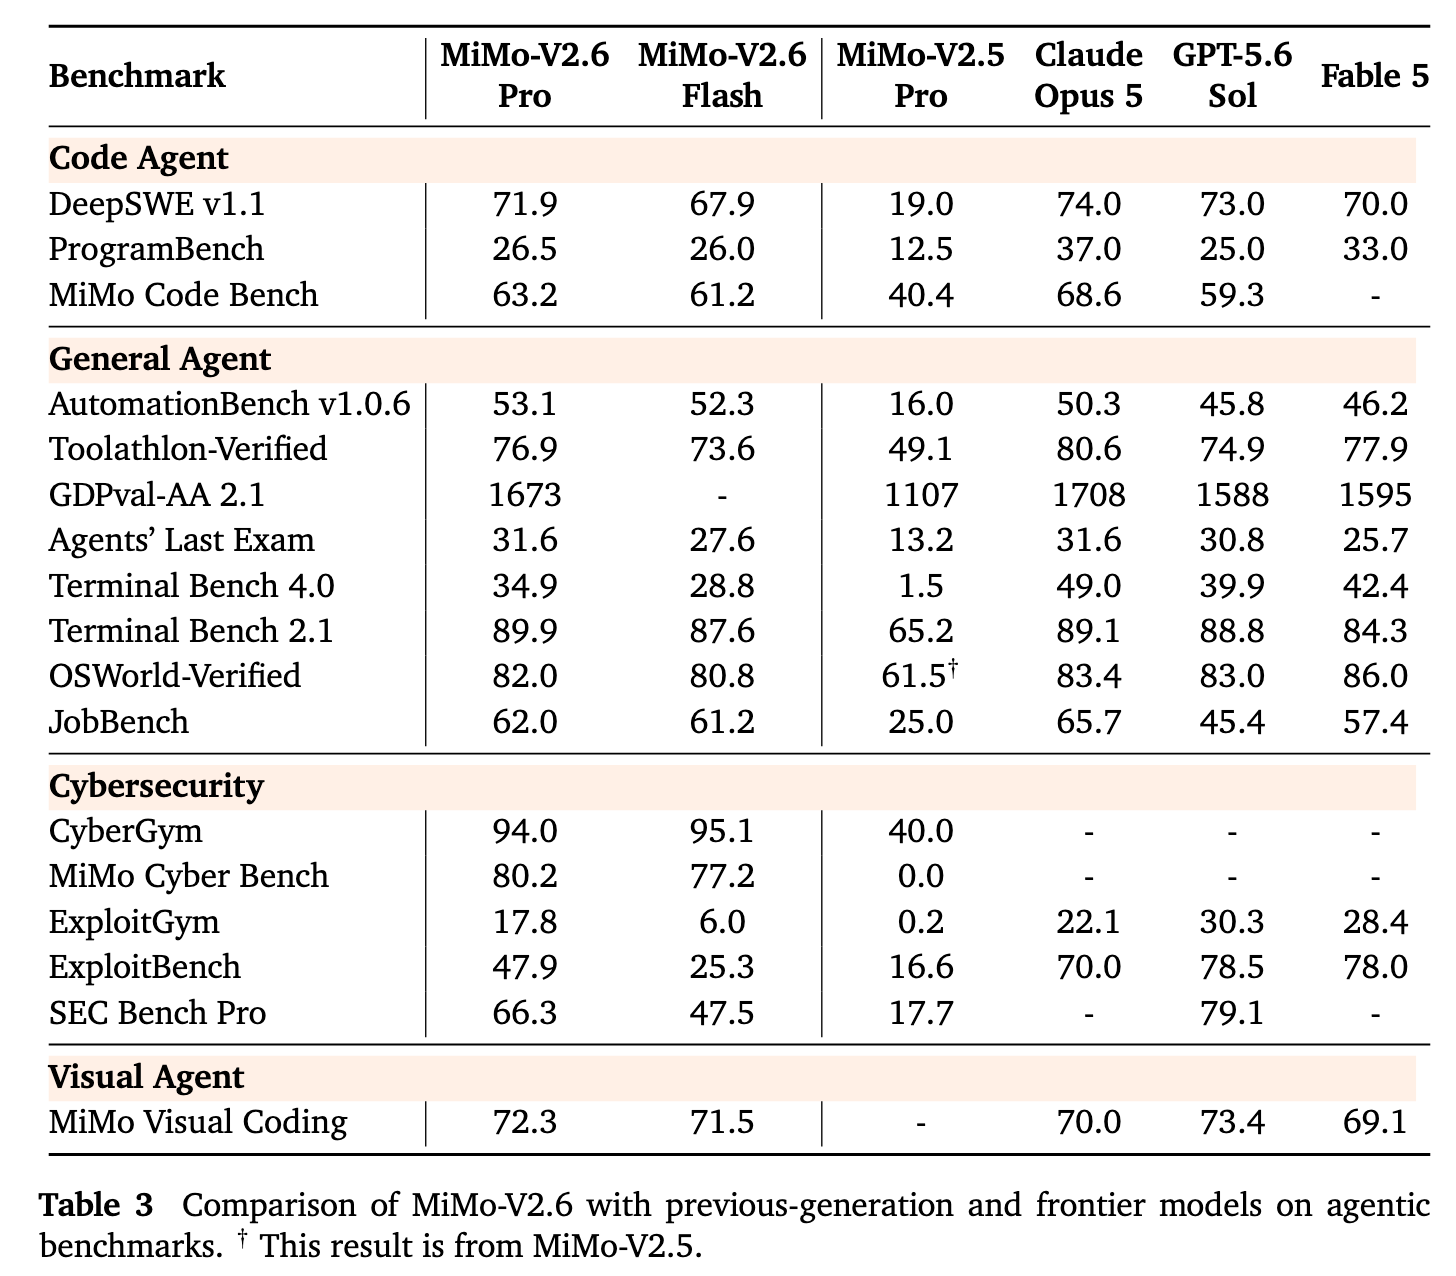
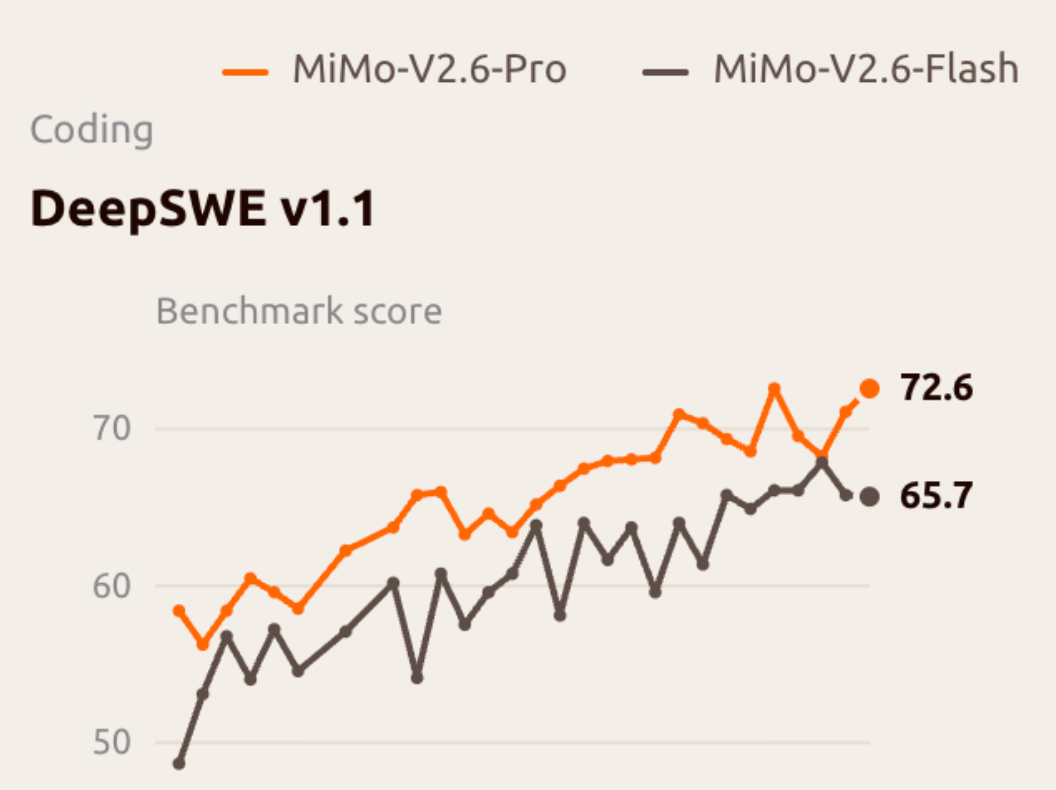
Un dettaglio di benchmark richiede attenzione: la curva Live RL di Xiaomi mostra MiMo‑V2.6‑Pro raggiungere circa 72,6 su DeepSWE v1.1 durante il training run, mentre la tabella di confronto finale riporta 71,9. Questi numeri si riferiscono a contesti di valutazione diversi e non devono essere fusi senza indicarlo.
Grok 4.7 vs MiMo‑V2.6‑Pro: confronto dei benchmark
I confronti diretti di benchmark richiedono cautela. I vendor non usano sempre gli stessi harness, budget di ragionamento, checkpoint o configurazioni degli strumenti. Anche quando i nomi dei benchmark coincidono, piccole differenze di punteggio possono essere meno significative di quanto appaiano. Il confronto più sicuro è separare le misure realmente allineate dalle evidenze direzionali.
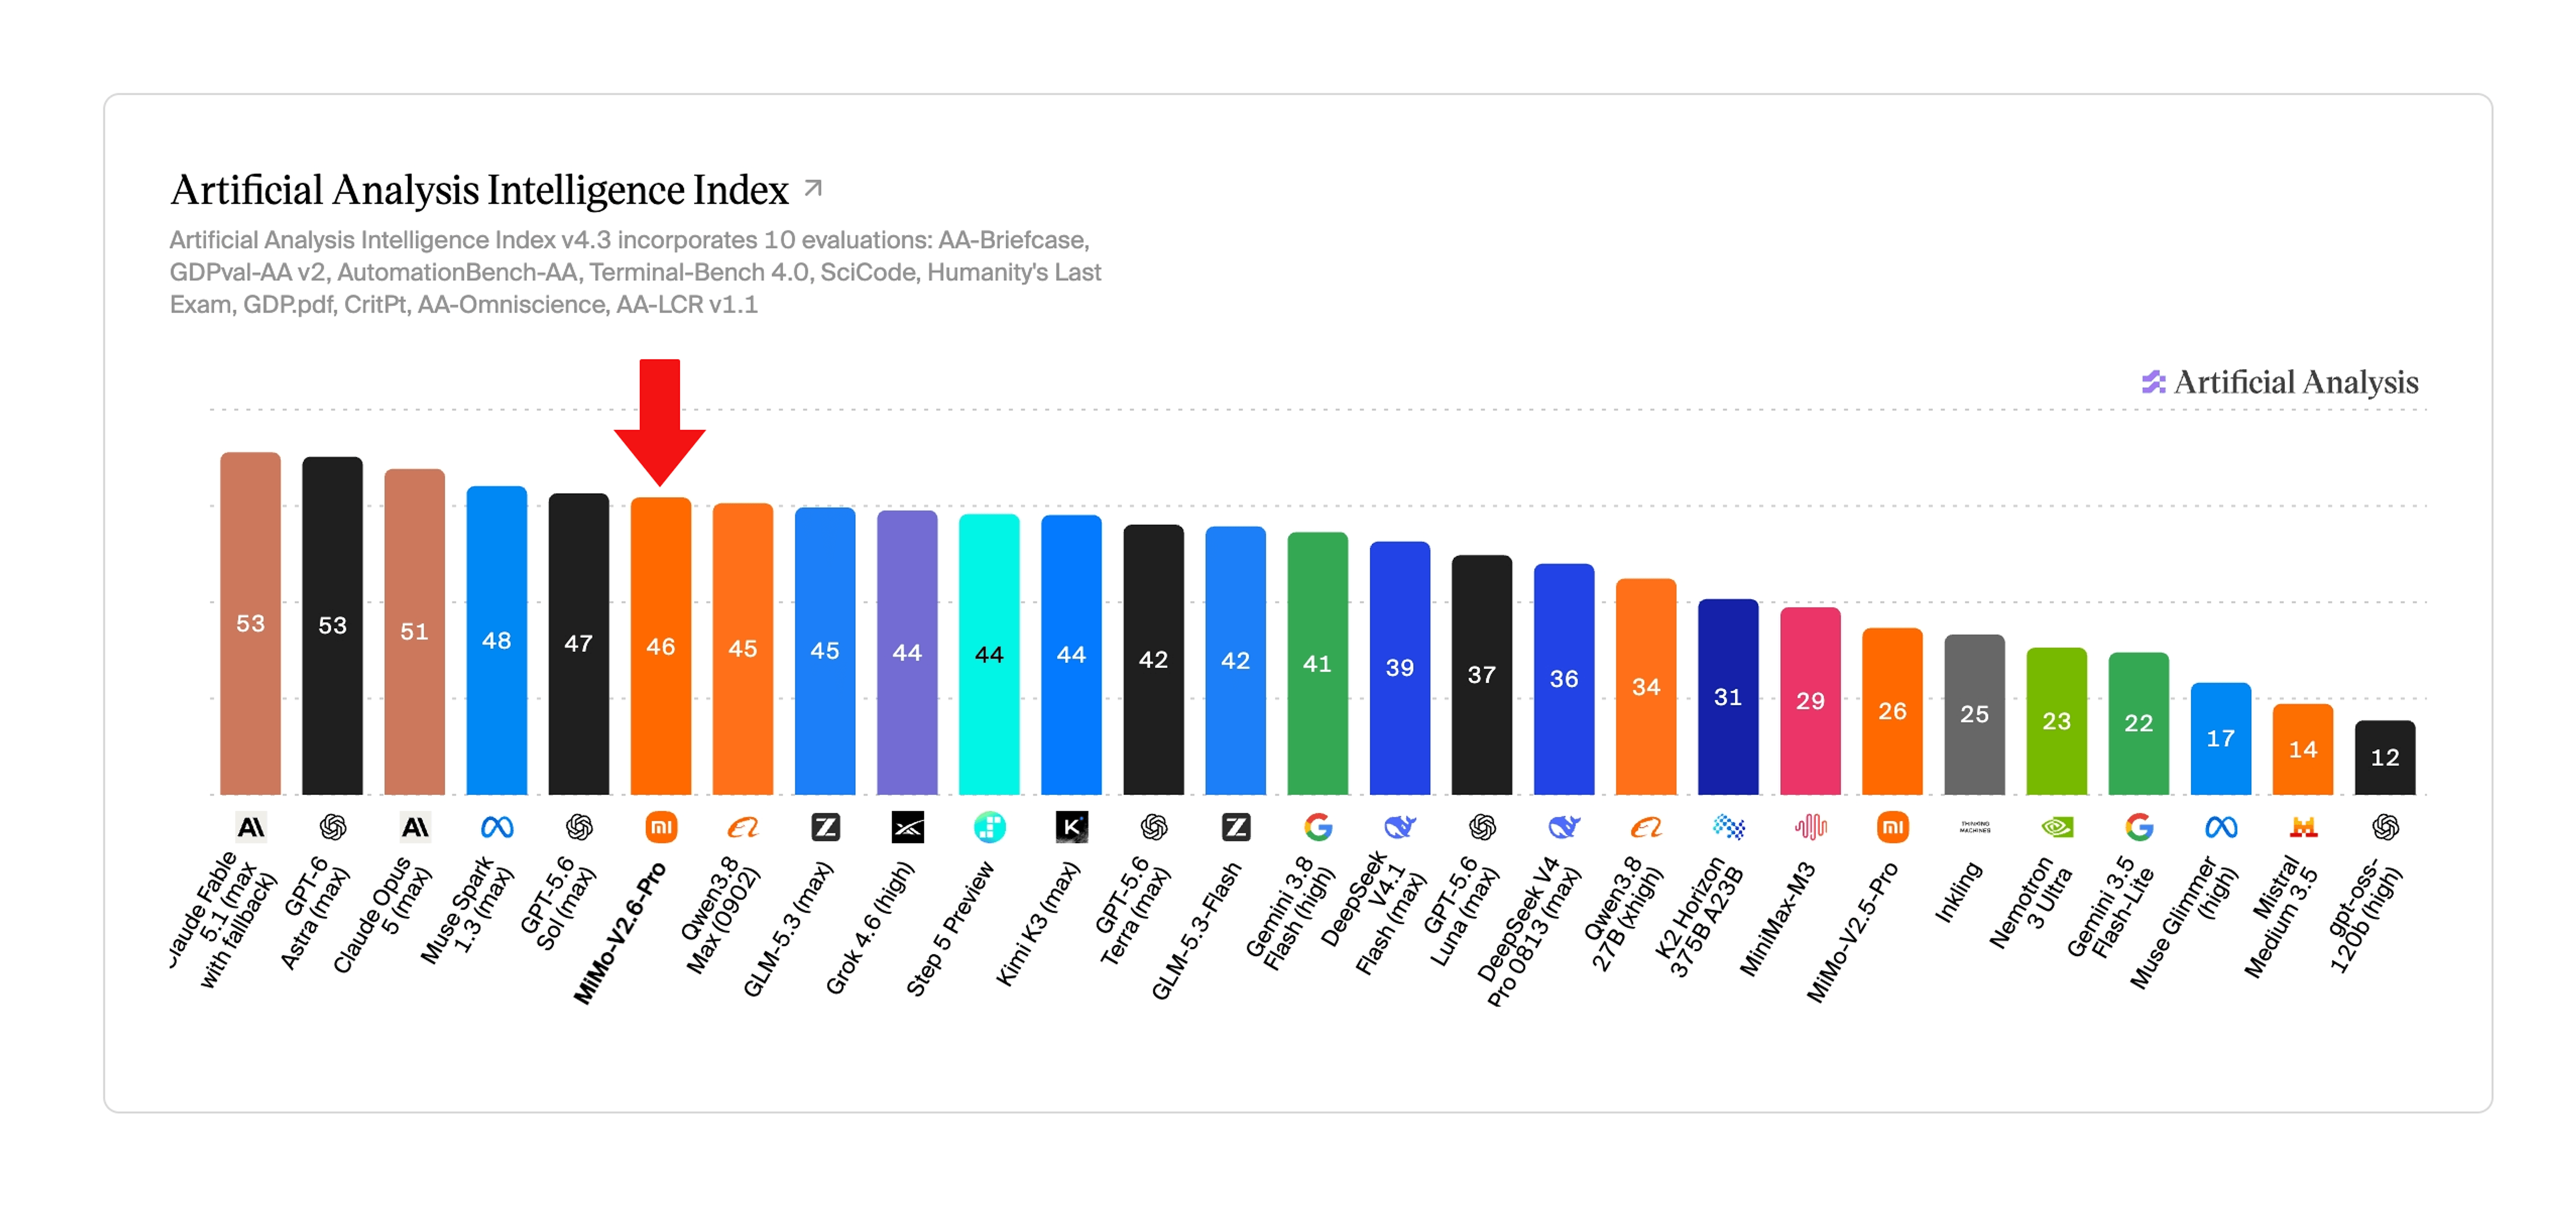
Artificial Analysis Intelligence Index
Xiaomi riporta 46,32 per MiMo‑V2.6‑Pro sull’indice composito Artificial Analysis. Qualsiasi confronto con Grok dovrebbe essere vincolato all’istantanea di Artificial Analysis e alla configurazione del modello utilizzate; non si dovrebbe presentare un’uguaglianza arrotondata senza quella fonte.
Prestazioni su coding e agent
| Benchmark | Grok 4.7 — SpaceXAI | MiMo-V2.6-Pro — Xiaomi | Interpretazione |
|---|---|---|---|
| DeepSWE v1.1 | 71.0* | 71.9** | Numericamente vicini; run e impostazioni diverse |
| GDPval-AA | Vedi grafico SpaceXAI | 1,673 | Solo direzionale, a meno di harness allineati |
| AA Briefcase | 1,657 | Vedi grafico Xiaomi | Usare i valori del vendor con il relativo contesto |
| Terminal-Bench 4.0 | 38.0 | 34.9 | Direzione simile; l’harness incide |
| Context window | 500K | 1M | MiMo supporta più contesto di lavoro |
*SpaceXAI riporta DeepSWE di Grok 4.7 con effort alto. *La tabella di confronto finale di Xiaomi riporta 71,9; la curva di training Live RL raggiunge circa 72,6. Queste cifre provengono da contesti di valutazione diversi.
Adattamento al flusso di lavoro di coding
Per il coding, la distinzione dipende dal significato di “coding”: risoluzione di problemi grezzi su repository o un’esperienza completa di coding‑agent gestita. Su DeepSWE v1.1, i numeri pubblicati sono abbastanza vicini che un divario inferiore al punto non dovrebbe da solo determinare la scelta in produzione.
Il vantaggio di Grok 4.7 è più in alto nello stack. È integrato con Grok Build, disponibile in Cursor, progettato per comprendere l’harness Grok Bot e abbinato a strumenti first‑party di esecuzione del codice e ricerca.
Il vantaggio di MiMo‑V2.6‑Pro è più in basso nello stack. I pesi aperti lo rendono pratico per costruire un assistente di coding privato, personalizzare il serving, applicare controlli di residenza dei dati o sperimentare con un harness agent proprietario.
Per i team che scelgono tra i due, un A/B test in produzione su repository rappresentativi sarà più informativo di un singolo benchmark pubblico di coding.
Grok 4.7 vs MiMo‑V2.6‑Pro: differenze nelle capacità multimodali
Questa è una delle differenze più chiare. Grok 4.7 accetta input di testo e immagini e produce testo. La piattaforma Grok più ampia offre prodotti multimediali separati, ma non vanno confusi con la superficie di modalità del modello grok‑4.7 in sé.
MiMo‑V2.6‑Pro supporta la comprensione di testo, immagini, audio e video. Combinato con una finestra di contesto da 1M token, questo amplia la gamma di workflow gestibili in un unico contesto di modello.
- Analisi di screenshot e codice nello stesso task
- Comprensione video con istruzioni di accompagnamento
- Elaborazione audio long‑form
- Agenti di uso del computer con feedback visivo
- Assistant di ricerca multimodali
- Estrazione e QA multimodali su larga scala
Grok 4.7 vs MiMo‑V2.6‑Pro: confronto dei prezzi API
| Official API pricing | Grok 4.7 | MiMo-V2.6-Pro |
|---|---|---|
| Input / 1M tokens | $2.00 | $0.435 |
| Cached input / 1M | $0.50 | $0.0036 |
| Output / 1M | $6.00 | $0.87 |
| Long-context surcharge | Sì, oltre 200K token di prompt | Nessun tier standard comparabile |
| Open-weight/self-host option | No | Yes |
A prezzo di listino, MiMo‑V2.6‑Pro è diverse volte più economico sia sull’input normale sia sull’output generato, con una differenza particolarmente ampia per il contesto in cache. Questo può incidere materialmente sull’economia di agent che elaborano ripetutamente repository, documenti lunghi o contesti persistenti.
Importante nota sui prezzi: la finestra di contesto da 500K di Grok 4.7 non significa che l’intero contesto sia fatturato alla tariffa standard. Le richieste oltre 200K token di prompt sono addebitate al tier per contesti lunghi.
Al 24 settembre 2026, CometAPI lista Grok 4.7 a $1.60 per input e $4.80 per output per 1M token, rispetto agli ufficiali $2.00 e $6.00. Lista MiMo‑V2.6‑Pro a $0.348 per input e $0.696 per output, rispetto agli ufficiali $0.435 e $0.87. Queste tariffe standard elencate sono inferiori del 20% rispetto alle corrispondenti ufficiali. Prezzi e requisiti di idoneità possono cambiare; confermare le pagine modello live prima di pianificare il budget.
Il prezzo per token non è identico al costo per task completato. I modelli di ragionamento possono consumare volumi di token diversi, usare un numero differente di chiamate agli strumenti e richiedere tassi di retry differenti. La valutazione in produzione dovrebbe quindi tracciare insieme costo per task completato, latenza e tasso di successo.
Grok 4.7 vs MiMo‑V2.6‑Pro: accesso e disponibilità
La differenza di accesso è lineare: Grok 4.7 è disponibile tramite API e workflow Grok gestiti, mentre i pesi del modello non sono offerti per self‑hosting. MiMo‑V2.6‑Pro è disponibile tramite API e con pesi aperti, offrendo ai team un ulteriore percorso self‑hosted.
La disponibilità è distinta da licenze o flessibilità di deployment. Al 24 settembre 2026, entrambi i modelli hanno anche pagine di catalogo live su CometAPI. I team dovrebbero confermare endpoint, regione, rate limit ed eleggibilità dell’account prima del rollout in produzione; un modello elencato non garantisce identica disponibilità o livelli di servizio per ogni account.
| Availability question | Grok 4.7 | MiMo-V2.6-Pro |
|---|---|---|
| Official API | Disponibile tramite xAI | Disponibile tramite Xiaomi MiMo |
| CometAPI catalog | Elencato come disponibile | Elencato come disponibile |
| Self-hosted weights | Non disponibili | Opzione con pesi aperti |
| Operational check | Confermare accesso account, regione, rate limit e disponibilità tool | Confermare accesso account, prontezza endpoint e requisiti self‑hosting |
Pesi aperti e accesso proprietario
Il fatto che MiMo‑V2.6‑Pro abbia pesi aperti modifica il confronto più di un divario di un punto nel benchmark. Crea opzioni per deployment privato, tuning dell’engine di inferenza, post‑training personalizzato, controlli di residenza dei dati e integrazione infrastrutturale più profonda.
Grok 4.7 fa il trade‑off opposto: meno controllo sugli interni del modello in cambio di un servizio gestito e continuamente operato e di un ecosistema first‑party strettamente integrato. Per molte organizzazioni, requisiti di governance e infrastruttura determineranno la shortlist prima delle prestazioni di benchmark.
Come usare le API di Grok 4.7 e MiMo V2.6 in CometAPI
Gli sviluppatori possono accedere alla Grok 4.7 API in CometAPI tramite un workflow API unificato, riducendo la necessità di mantenere integrazioni specifiche per ciascun provider.
Per i team che confrontano più modelli di frontiera, uno strato API unificato è particolarmente utile perché gli stessi prompt di produzione, harness di test, conteggio token e codice applicativo possono essere riprodotti tra modelli con meno variabili di integrazione.
CometAPI ora elenca MiMo‑V2.6‑Pro come disponibile, con disponibilità API confermata il 22 settembre 2026. Controllare il catalogo live e l’accesso dell’account prima dell’uso in produzione.
Con entrambe le pagine modello ora elencate come disponibili, un A/B test a livello di applicazione può mantenere quanto più possibile coerenti prompt, strumenti, impostazioni di ragionamento e criteri di successo, quindi confrontare completamento dei task, latenza, uso di token e modalità di failure.
Grok 4.7 vs MiMo‑V2.6‑Pro: aderenza del modello per caso d’uso
| Requirement | Model fit / evaluation guidance |
|---|---|
| First-party web and X search | Grok 4.7 |
| Managed long-running agents | Grok 4.7 |
| Grok Build / Cursor workflows | Grok 4.7 |
| 1M-token context | MiMo-V2.6-Pro |
| Native audio/video understanding | MiMo-V2.6-Pro |
| Open weights, self-hosting, and model control | MiMo-V2.6-Pro |
| Lowest raw API token cost | MiMo-V2.6-Pro |
| Repository coding | Valutare entrambi su repository rappresentativi |
| Professional knowledge agents | Valutare entrambi su task di produzione |
La decisione dovrebbe quindi essere inquadrata attorno all’architettura del carico di lavoro. Grok 4.7 è progettato per rendere più capace uno stack di agenti gestito; MiMo‑V2.6‑Pro è progettato per rendere l’intelligenza di alto livello più economica, più multimodale e più controllabile.
Quale scegliere?
Scegli Grok 4.7 se vuoi un’esperienza di agent gestita con ricerca web e X first‑party, esecuzione nativa del codice e meno infrastruttura da operare. È l’opzione più pratica per i team che valorizzano uno stack di strumenti integrato e workflow professionali o di coding a lunga durata.
Scegli MiMo‑V2.6‑Pro se ti servono pesi aperti, deployment privato, una finestra di contesto da 1M token, comprensione nativa di audio e video o prezzi API sostanzialmente più bassi. È l’opzione più forte quando i vincoli principali sono controllo del deployment, copertura multimodale ed efficienza dei costi.
Se la scelta è ancora poco chiara, esegui entrambi i modelli sugli stessi task rappresentativi con prompt, strumenti, budget di ragionamento, timeout e policy di retry identici. Seleziona il modello che offre la migliore combinazione di tasso di completamento, latenza, costo totale per task riuscito e impegno di revisione umana.
Conclusione
Grok 4.7 vs MiMo V2.6 è rivelatore perché l’intelligenza grezza non è più l’unico differenziatore significativo. Entrambi i modelli occupano una fascia di alta capacità simile nelle valutazioni pubbliche attuali, ma le loro strategie di prodotto divergono nettamente.
Grok 4.7 combina una finestra di contesto da 500K, ragionamento configurabile, un training di agenti a lungo orizzonte solido e uno stack first‑party maturo per ricerca ed esecuzione. MiMo‑V2.6‑Pro combina una finestra di contesto da 1M, input multimodali nativi, pesi aperti e prezzi API ben al di sotto di molti sistemi proprietari di frontiera.
Per gli sviluppatori, la domanda pratica è quindi meno “qual è il punteggio di benchmark più alto?” e più “dove dovrebbe vivere l’intelligenza?”. Un ecosistema di agent gestito e uno stack di modello aperto e personalizzabile risolvono problemi operativi diversi. La scelta giusta è quella che meglio corrisponde al carico di lavoro in produzione, ai vincoli di infrastruttura e al modello di costo.
FAQ
Grok 4.7 è un modello da 2.1 trilioni di parametri?
Circolava una cifra intorno a 2,1T prima del rilascio, ma la documentazione finale di SpaceXAI su Grok 4.7 non pubblica il numero totale o attivo di parametri. L’affermazione confermata è che Grok 4.7 usa un modello base più grande di Grok 4.6.
MiMo‑V2.6 è open source?
Xiaomi ha rilasciato MiMo‑V2.6 come famiglia di modelli open con pesi scaricabili e risorse di ricerca associate. In pianificazione di produzione, i team dovrebbero comunque rivedere la licenza esatta del modello e i termini di ridistribuzione per l’uso previsto.
Quanto costa Grok 4.7 vs MiMo‑V2.6‑Pro per task agent completato?
Normalizza set di task, prompt, permessi degli strumenti, policy di retry e criteri di successo. Traccia token di input totali, input in cache, ragionamento e output, chiamate agli strumenti, latenza, retry e tempo di revisione umana. Il prezzo per token grezzo è solo una componente del costo per task completato.
Quanto sono affidabili i confronti di benchmark tra Grok 4.7 e MiMo‑V2.6‑Pro?
Usa lo stesso repository o set di task, harness di agent, strumenti, budget di ragionamento, timeout, policy di retry e rubrica di scoring. Riporta intervalli di confidenza o variazioni su run ripetuti e tieni separati i valori pubblicati dai vendor dai risultati interni.
Grok 4.7 applica tariffe maggiori per prompt con contesto lungo?
SpaceXAI documenta tariffe più alte quando i token di prompt superano 200K. Poiché il tier più alto si applica alla richiesta, i team che usano repository grandi o contesto agente persistente dovrebbero modellare esplicitamente la soglia.