
TL;DR
Kimi K3 è open-weight ma non a scala workstation: servire il modello nativo richiede GPU di classe data center e memoria distribuita. Usa vLLM per il percorso di produzione più diretto, oppure SGLang quando contano topologia, parallelismo degli esperti e controllo della cache. Le build GGUF della community abbassano la soglia hardware, ma richiedono comunque circa 500 GB fino a ben oltre 1 TB di memoria indirizzabile e scambiano velocità o qualità per la fattibilità. Per PC e Mac ordinari, prova prima tramite un'API ospitata e passa all’hosting autonomo solo quando privacy, utilizzo sostenuto o controllo dell’infrastruttura giustificano il costo.
What Is Kimi K3?
Kimi K3 è il modello di punta multimodale nativo open-weight di Moonshot AI, pensato per coding a lungo orizzonte, lavoro conoscitivo agentico, reasoning e comprensione visiva.
Moonshot lo descrive come il primo modello open di classe 3T al mondo. La sua architettura combina Kimi Delta Attention e Attention Residuals con un design MoE sparso che seleziona solo un sottoinsieme di esperti per ciascun token.
La scala è insolita anche per gli standard dei modelli frontier. Invece di attivare tutti i 2.8T parametri per ogni token, K3 seleziona 16 degli 896 esperti instradati, più esperti condivisi. Questo riduce significativamente il calcolo per token, sebbene tutti i pesi del modello debbano comunque essere disponibili da qualche parte nel sistema di inferenza.
| Specification | Kimi K3 — specifiche ufficiali del modello |
|---|---|
| Architecture | Mixture-of-Experts |
| Total parameters | 2.8T |
| Activated parameters | 104B |
| Experts | 896 |
| Selected experts per token | 16 |
| Context length | 1,048,576 tokens |
| Vision encoder | MoonViT-V2 |
| Native quantization | pesi MXFP4 / attivazioni MXFP8 |
| Formal model-card modalities | Testo + immagine |
K3 applica inoltre il quantization-aware training a partire dallo stadio SFT, invece di trattare il serving a bassa precisione come un puro passaggio di compressione post-addestramento.
La sua architettura è quindi ottimizzata per il serving su larga scala—ma “sparse compute” non va confuso con “impronta di memoria piccola”. Solo una parte della rete calcola ogni token, ma l’intero pool di esperti deve comunque essere accessibile.
How Does Kimi K3 Perform?
Il benchmark ufficiale di Kimi K3 posiziona il modello vicino ai principali modelli frontier proprietari, in particolare su ingegneria del software a lungo orizzonte e carichi agentici.
La selezione seguente copre reasoning, coding, agent e vision. Punteggi più alti sono migliori per tutte le metriche mostrate.
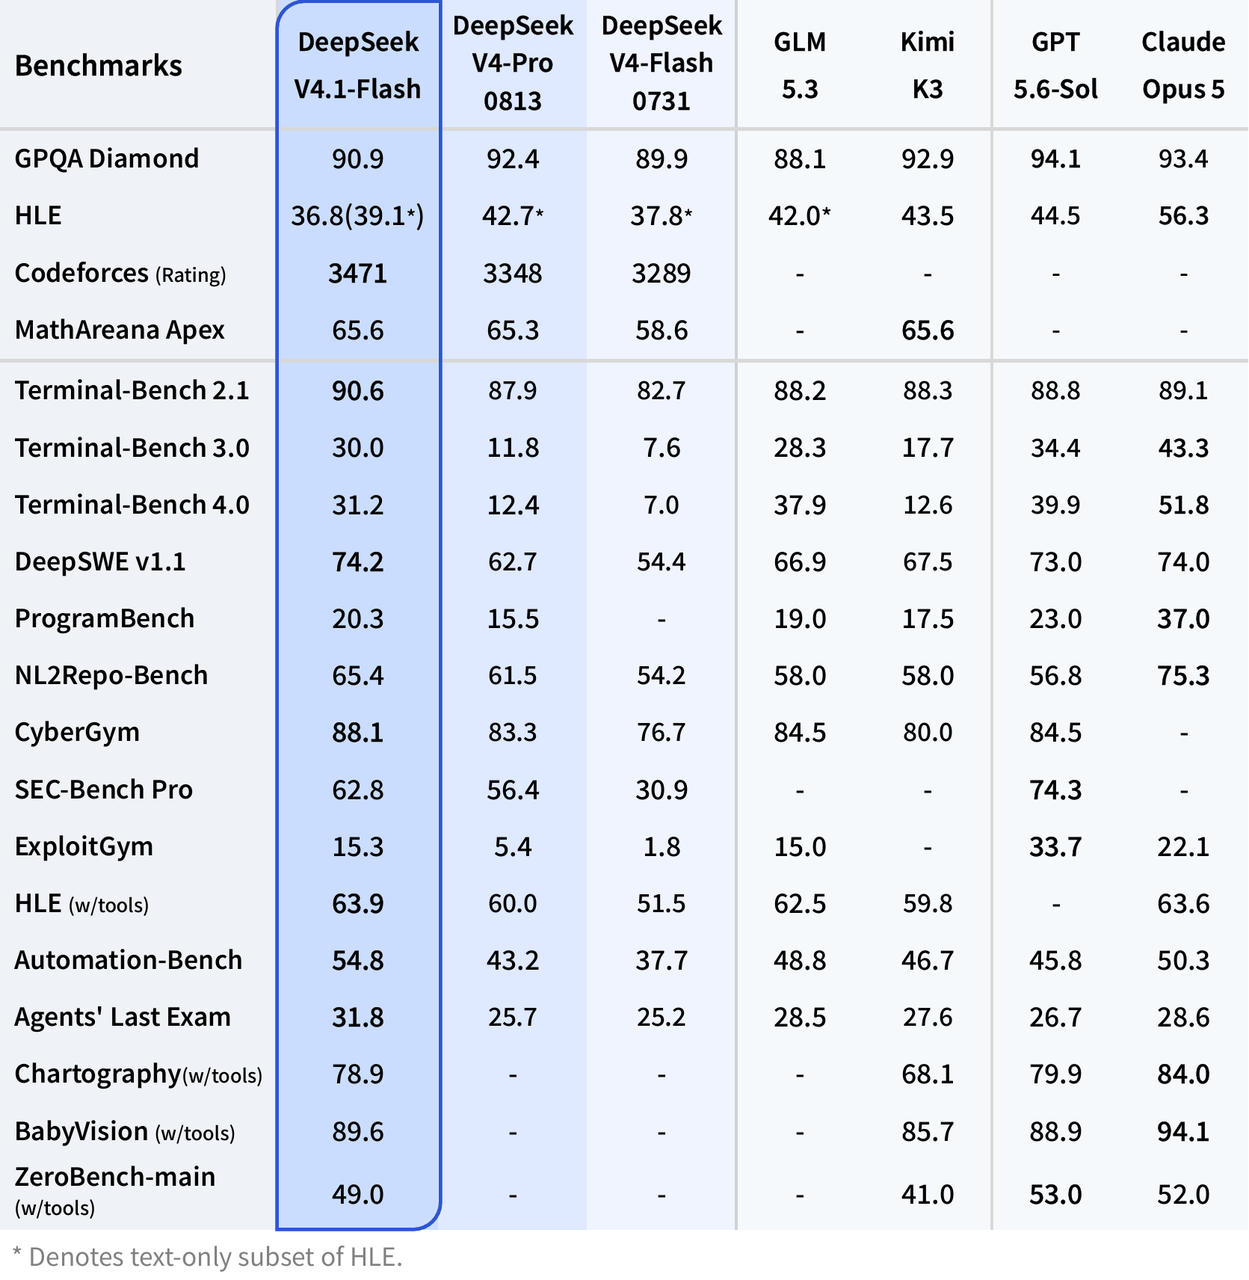
| Benchmark — risultati ufficiali Moonshot | Kimi K3 | GPT-5.6 Sol | Claude Fable 5 | Claude Opus 4.8 |
|---|---|---|---|---|
| GPQA Diamond | 93.5 | 94.1 | 92.6 | 91.0 |
| ProgramBench | 77.8 | 77.6 | 76.8 | 71.9 |
| Terminal-Bench 2.1 | 88.3 | 88.8 | 88.0 | 84.6 |
| FrontierSWE | 81.2 | 71.3 | 86.6 | 66.7 |
| SWE-Marathon | 42.0 | 39.0 | 35.0 | 40.0 |
| BrowseComp | 91.2 | 90.4 | 88.0 | 84.3 |
| OmniDocBench | 91.1 | 85.8 | 89.8 | 87.9 |
| PerceptionBench | 58.5 | 59.7 | 57.2 | 47.2 |
I punteggi ufficiali collocano Kimi K3 vicino a GPT-5.6 Sol, Claude Fable 5 e Claude Opus 4.8 su compiti di reasoning, coding, agent e vision. Considera questi risultati riportati dai provider come contesto di capacità piuttosto che come una classifica universale; l’analisi dettagliata dei benchmark è trattata separatamente. Per questa guida, il punto operativo è che l’hosting autonomo offre capacità di livello frontier e controllo dell’infrastruttura, ma non un scorciatoia economica da desktop.
Can You Actually Run Kimi K3 Locally?
Sì, ma ci sono due definizioni molto diverse di “locale”.
Server locale / data center privato: realistico.
Desktop o laptop normale: tecnicamente sperimentabile con build della community fortemente quantizzate, ma generalmente impraticabile per un uso interattivo.
L’attuale ricetta vLLM per Kimi K3 imposta una soglia di base molto alta:
- NVIDIA: almeno 8× GB300
- AMD ROCm: almeno 8× MI355X o MI350X
- Driver NVIDIA: R580+ per l’attuale immagine CUDA 13 di K3
- Infrastruttura multi-node consigliata per traffico di produzione reale
La guida vLLM day-0 originale ha anche mostrato un percorso di quick-start con 8 GPU B300 o 8 GPU MI355X. Per un nuovo deployment di produzione, segui la ricetta più recente perché riflette lo stack di serving dopo le ottimizzazioni del giorno del lancio.
Questo è il punto chiave: K3 è open-weight, ma non è un modello open a scala consumer.
Official Weights vs Community GGUF Quantizations
C’è un altro modo per ridurre la soglia hardware: la quantizzazione della community.
L’attuale repository Unsloth K3 fornisce diverse varianti GGUF che possono essere eseguite tramite software compatibile con llama.cpp.
Confronto consolidato. Le cifre di memoria indirizzabile sono stime di pianificazione (dimensione del download più circa il 10–15% di margine a runtime), non garanzie; impostazioni di contesto, cache, visione e offload possono richiedere di più.
| Variant | Download | Suggested addressable memory | Vision support | Documented runtime | Purpose / quality evidence |
|---|---|---|---|---|---|
| UD-Q1_0 | 466 GB | ≥520 GB | Il repository dichiara il supporto visione; verifica il percorso runtime corrispondente. | Fork PR di Unsloth per llama.cpp; percorso via Ollama documentato, versione non fissata. | Proof-of-concept; nessun test indipendente specifico per la variante citato. |
| UD-TQ1_0 | 509 GB | ≥570 GB | Stessa avvertenza a livello di repository per la visione. | Stesso percorso runtime documentato. | Esperimento aggressivo di classe 1-bit; nessun test indipendente specifico citato. |
| UD-IQ1_S | 594 GB | ≥665 GB | Stessa avvertenza a livello di repository per la visione. | Stesso percorso runtime documentato. | Esperimento locale estremo; nessun test indipendente specifico citato. |
| UD-IQ1_M | 649 GB | ≥730 GB | Stessa avvertenza a livello di repository per la visione. | Stesso percorso runtime documentato. | Compromesso 1-bit di qualità superiore; nessun test indipendente specifico citato. |
| UD-IQ2_XXS | 711 GB | ≥800 GB | Stessa avvertenza a livello di repository per la visione. | Stesso percorso runtime documentato. | Esperimento di classe 2-bit; nessun test indipendente specifico citato. |
| UD-Q2_K_XL | 861 GB | ≥970 GB | Stessa avvertenza a livello di repository per la visione. | Stesso percorso runtime documentato. | Grande server CPU/GPU; nessun benchmark indipendente sulla quantizzazione K3 citato. |
| UD-Q4_K_XL | 1.51 TB | ≥1.7 TB | Stessa avvertenza a livello di repository per la visione. | Esempi diretti per llama.cpp e Ollama documentati per questa variante. | Serving GGUF orientato alla qualità; nessun benchmark K3 sulla quantizzazione citato. |
| UD-Q8_K_XL | 1.56 TB | ≥1.75 TB | Stessa avvertenza a livello di repository per la visione. | Stesso percorso runtime documentato. | Build community quasi lossless; poco vantaggio di storage rispetto a Q4. |
Questa distinzione spiega anche perché alcuni primi articoli sul deployment locale citano 594 GB: 594 GB ora corrisponde alla build GGUF UD-IQ1_S della community, non a una descrizione utile del checkpoint nativo completo attuale.
Un modello da 466–649 GB è drasticamente più piccolo rispetto all’impronta di deployment originale, ma rimane enorme per gli standard delle workstation. Dovresti inoltre lasciare memoria per lo stato a runtime, il contesto, le cache, il proiettore di visione, i processi del sistema operativo e altro overhead.
La capacità del disco non è la stessa della memoria di inferenza. Avere un SSD da 1 TB non significa che un modello da 600 GB funzionerà rapidamente su una macchina con 64 GB di RAM. L’offloading su SSD può rendere possibili esperimenti estremi, ma la generazione di token può diventare dolorosamente lenta.
How to Deploy Kimi K3 with vLLM
Per un hosting autonomo serio, vLLM è il punto di partenza più semplice.
Moonshot attualmente elenca vLLM come uno dei motori di inferenza K3 consigliati, e vLLM fornisce supporto specifico per K3 per KDA, MoE MXFP4, parsing del reasoning, tool calling, caching dei prefissi e deployment distribuito.
Check the prerequisites
Per il deployment di produzione su NVIDIA, la ricetta testata corrente utilizza il container vllm/vllm-openai:kimi-k3.
Verifica le GPU:
nvidia-smi
Conferma Docker:
docker --version
Conferma che NVIDIA Container Toolkit veda gli acceleratori:
docker run --rm --gpus all nvidia/cuda:13.0.0-base-ubuntu24.04 nvidia-smi
Se l’ultimo comando non vede tutte le GPU, correggi il runtime GPU host/container prima di scaricare un modello multi-terabyte.
Set your Hugging Face token
Se per il repository del modello è richiesta l’autenticazione, archivia il token in una variabile d’ambiente invece di inserirlo in chiaro negli script.
export HF_TOKEN="YOUR_HUGGING_FACE_TOKEN"
Pull the K3 vLLM container
docker pull vllm/vllm-openai:kimi-k3
La ricetta attuale specifica una build CUDA 13 e un driver NVIDIA R580 o più recente.
Launch Kimi K3
Current Blackwell TP8 starting template (vLLM recipe updated 2026-09-10): usalo come baseline, poi rigenera o esegui benchmark del profilo per il tuo hardware e traffico specifici.
docker run --rm \
  --gpus all \
  --ipc=host \
  -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -e HF_TOKEN="$HF_TOKEN" \
  -e VLLM_USE_V2_MODEL_RUNNER=1 \
  vllm/vllm-openai:kimi-k3 \
  --model moonshotai/Kimi-K3 \
  --tensor-parallel-size 8 \
  --gpu-memory-utilization 0.95 \
  --kv-cache-dtype fp8 \
  --attention-backend TOKENSPEED_MLA \
  --attention-config '{"use_prefill_query_quantization":true,"mla_prefill_backend":"TOKENSPEED_MLA"}' \
  --prefix-match-unit 128 \
  --enable-prefix-caching \
  --max-model-len 131072 \
  --enable-auto-tool-choice \
  --tool-call-parser kimi_k3 \
  --reasoning-parser kimi_k3
La ricetta attuale richiede l’immagine K3 CUDA 13 e un driver NVIDIA R580 o più recente. La cache KV in FP8 deve essere abbinata a un backend MLA di prefill/decode compatibile; esegui benchmark di alternative prima di modificare la configurazione dell’attenzione.
Fonte: vLLM Kimi K3 recipe. Questo sostituisce il precedente comando day-0 invece di presentarlo come ricetta di produzione attuale.
Per un primo run di validazione, considera di limitare la lunghezza massima del modello invece di allocare immediatamente l’intera capacità da 1,048,576 token. L’attuale ricetta vLLM raccomanda esplicitamente di regolare max-model-len in base al carico.
Ad esempio:
--max-model-len 131072
Questo non cambia il limite di contesto architetturale di K3. Semplicemente fornisce al motore di serving un perimetro operativo più gestibile per i test iniziali.
Test the local endpoint
vLLM espone un’API compatibile OpenAI sulla porta 8000.
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "moonshotai/Kimi-K3",
    "messages": [
      {
        "role": "user",
        "content": "Explain the difference between tensor parallelism and expert parallelism."
      }
    ],
    "max_tokens": 512
  }'
Oppure usa l’SDK Python di OpenAI:
python
from openai import OpenAI

 client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="EMPTY",
    timeout=3600,
 )

response = client.chat.completions.create(
    model="moonshotai/Kimi-K3",
    messages=[
        {
            "role": "user",
            "content": "Write a Python function that validates a JSON schema.",
        }
    ],
    max_tokens=1024,
 )

print(response.choices[0].message.content)
La ricetta ufficiale vLLM utilizza lo stesso pattern localhost compatibile OpenAI, rendendo relativamente facile commutare un’applicazione tra inferenza locale e ospitata.
How to Deploy Kimi K3 with SGLang
SGLang è l’altro percorso di deployment principale ufficialmente consigliato da Moonshot.
È particolarmente rilevante quando desideri un controllo più profondo sul serving distribuito, sul parallelismo degli esperti, sui kernel specifici per l’hardware o su topologie di produzione complesse.
Usa il Cookbook dedicato di SGLang per Kimi K3 e seleziona una topologia specifica per l’hardware. Di seguito è riportato il profilo Unified/Balanced verificato a singolo nodo 8×B300 dal cookbook; è stato misurato con SGLang v0.5.18 al commit 71de97b2.
Installa una build compatibile con K3:
pip install --upgrade pip
pip install uv
uv pip install --prerelease=allow sglang
Avvia il profilo verificato B300 TP8/DCP8:
sglang serve \
  --trust-remote-code \
  --model-path moonshotai/Kimi-K3 \
  --tp-size 8 \
  --dcp-size 8 \
  --mem-fraction-static 0.85 \
  --mamba-full-memory-ratio <value-from-official-calculator> \
  --reasoning-parser kimi_k3 \
  --tool-call-parser kimi_k3 \
  --host 0.0.0.0 \
  --port 30000
--mamba-full-memory-ratio dipende dal carico: calcolalo dalla lunghezza media input più output nel cookbook ufficiale. Non copiare questa topologia B300 su H100/H200, GB200/GB300, AMD o deployment multi-node; quei profili utilizzano layout TP/PP/DCP/EP differenti.
Testa il server:
curl http://localhost:30000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "moonshotai/Kimi-K3",
    "messages": [{"role": "user", "content": "Give me a five-step debugging plan for a distributed Python application."}]
  }'
Per un deployment reale, valida capacità, qualità dell’output e recupero da failure sulla versione SGLang, topologia, lunghezza del contesto e mix di traffico esatti che intendi eseguire.
vLLM vs SGLang vs llama.cpp
La scelta del motore di inferenza dipende principalmente dall’hardware e dallo scopo del deployment.
| Deployment method | Hardware class | Official native weights | OpenAI-compatible API | Distributed production | Ease of setup | Best fit |
|---|---|---|---|---|---|---|
| vLLM | Cluster GPU da data center | Sì | Sì | Eccellente | Media | Scelta predefinita per la produzione |
| SGLang | Cluster GPU da data center | Sì | Sì | Eccellente | Media–Alta | Serving distribuito avanzato |
| llama.cpp + GGUF | Workstation/server a memoria enorme | Quant. community | Sì | Limitata rispetto a vLLM/SGLang | Bassa–Media | Sperimentazione locale |
| Ollama + GGUF | Workstation/server a memoria enorme | Quant. community | Sì | Non l’obiettivo principale | Facile | Test orientati alla comodità |
| CometAPI | Nessuna GPU locale richiesta | Hosted | Sì | Gestita | Molto facile | Sviluppatori senza hardware classe K3 |
Se possiedi un server con 8 GPU classe Blackwell/MI35x, inizia con vLLM.
Se stai progettando un cluster di inferenza distribuito specialistico e desideri controlli di serving più a basso livello, valuta anche SGLang.assistant_message
Se il tuo obiettivo è semplicemente “Voglio dimostrare che K3 può eseguire sull’hardware che possiedo”, GGUF più llama.cpp è molto più accessibile—purché la tua macchina abbia una quantità davvero eccezionale di memoria.
How to Run a Quantized Kimi K3 with llama.cpp or Ollama
Il repository GGUF di Kimi K3 della community fornisce ora varianti compatibili con llama.cpp.
Questo percorso abbassa drasticamente la barriera d’ingresso rispetto a un deployment con pesi nativi da data center, ma “drasticamente” è relativo: anche le build più piccole sono centinaia di gigabyte.
Install llama.cpp on macOS or Linux
L’attuale scheda modello GGUF fornisce:
curl -LsSf https://llama.app/install.sh | sh
Su Windows:
winget install llama.cpp
Start an OpenAI-compatible server
Il repository documenta attualmente UD-Q4_K_XL come esempio:
llama serve \
  -hf unsloth/Kimi-K3-GGUF:UD-Q4_K_XL
Puoi anche eseguire direttamente la CLI:
llama cli \
  -hf unsloth/Kimi-K3-GGUF:UD-Q4_K_XL
Questi comandi provengono direttamente dall’attuale scheda modello Kimi K3 GGUF.
Tuttavia, UD-Q4_K_XL è circa 1.51 TB, quindi non è la variante con cui la maggior parte degli utenti di workstation inizierebbe. Se la tua priorità è ridurre i requisiti di memoria invece di preservare quanta più qualità possibile, valuta prima le varianti 1-bit e 2-bit più piccole.
Ad esempio:
llama serve \
  -hf unsloth/Kimi-K3-GGUF:UD-IQ1_M
L’attuale directory UD-IQ1_M è di circa 649 GB.
Un modello da 649 GB non è comunque un modello “da laptop” normale. Idealmente, lo stato del modello frequentemente accesso dovrebbe risiedere in memoria veloce. Un offloading pesante su SSD può rendere tecnicamente possibile un esperimento estremo senza renderlo utile per un lavoro interattivo.
Run the Same GGUF Build with Ollama
Ollama è un layer di comodità per lo stesso percorso di deployment GGUF, non un quarto metodo di hosting autonomo indipendente.
Il repository K3 GGUF espone anche un percorso via Ollama.
Ad esempio:
bash
ollama run hf.co/unsloth/Kimi-K3-GGUF:UD-Q4_K_XL
Ollama semplifica la gestione dei modelli e l’esperienza API, ma non elimina i requisiti di memoria di K3.
Cambiare il launcher da llama.cpp a Ollama non può trasformare una quantizzazione da diverse centinaia di gigabyte in un modello da 24 GB di GPU. I dati sottostanti del modello devono comunque essere archiviati e accessibili.
Per questo motivo, Ollama va visto come un comodo wrapper di runtime, non come un workaround hardware.
Which Kimi K3 Quantization Should You Choose?
Per gli esperimenti, la scelta è principalmente un trade-off tra dimensione del modello e fedeltà.
| GGUF quantization choices | Size | Relative memory pressure | Quality expectation | Recommended use |
|---|---|---|---|---|
| UD-Q1_0 | 466 GB | Più bassa | Rischio di degrado più aggressivo | Proof-of-concept |
| UD-IQ1_S | 594 GB | Molto alta | Aggressiva | Esperimenti locali estremi |
| UD-IQ1_M | 649 GB | Molto alta | Miglior compromesso 1-bit | Server sperimentale a grande memoria |
| UD-Q2_K_XL | 861 GB | Estrema | Fedeltà migliore | Grande server CPU/GPU |
| UD-Q4_K_XL | 1.51 TB | Classe data center | Fedeltà superiore | Hosting autonomo orientato alla qualità |
| Native K3 serving | Classe data center | Classe data center | Comportamento previsto del modello | Produzione |
Important Kimi K3 Serving Behavior
C’è un dettaglio di implementazione specifico di K3 facile da trascurare.
K3 utilizza uno storico del ragionamento preservato. Moonshot afferma che conversazioni multi-turn e workflow di tool call dovrebbero inviare l’intero precedente messaggio dell’assistente al modello, inclusi reasoning_content e tool_calls, invece di preservare solo il contenuto visibile.
Un pattern applicativo semplificato è simile a questo:
messages = [
    {
        "role": "user",
        "content": "Inspect this project and propose a migration plan.",
    }
 ]

first = client.chat.completions.create(
    model="moonshotai/Kimi-K3",
    messages=messages,
    max_tokens=2048,
 )

assistant_message = first.choices[0].message

 # Preserve the whole message object, not just assistant_message.content.
 messages.append(
    assistant_message.model_dump(exclude_none=True)
 )

messages.append(
    {
        "role": "user",
        "content": "Now identify the riskiest part of that plan.",
    }
 )

second = client.chat.completions.create(
    model="moonshotai/Kimi-K3",
    messages=messages,
    max_tokens=2048,
 )
Questo diventa particolarmente importante per agent di coding, loop di strumenti e sessioni autonome di lunga durata.
K3 mantiene anche il reasoning abilitato e supporta sforzo di ragionamento low, high e max. Quando il tuo layer di serving espone questi parametri, tratta lo sforzo di ragionamento come un altro controllo di latenza/qualità invece di massimizzarlo sempre per ogni richiesta.
How to Optimize a Local Kimi K3 Deployment
Do not allocate the full 1M context immediately
K3 supporta 1,048,576 token, ma la massima capacità del modello e una configurazione server sensata sono cose diverse.
Per lo sviluppo, inizia con qualcosa come:
--max-model-len 131072
Poi aumenta il contesto solo dopo aver misurato memoria disponibile, time to first token, throughput e concorrenza attesa.
Enable prefix caching
Gli agent di coding riutilizzano spesso istruzioni del repository, schemi degli strumenti, system prompt e prefissi lunghi.
Con vLLM:
--enable-prefix-caching
L’architettura ibrida dell’attenzione di K3 ha richiesto una gestione speciale per il caching dei prefissi, e vLLM ha implementato un supporto specifico per il modello.
Use the K3 parsers
Per i carichi agent, includi:
--tool-call-parser kimi_k3 \
--reasoning-parser kimi_k3
Questo mantiene le tool call e l’output del reasoning allineati al formato di serving di K3.
Keep storage fast
Un modello di questa scala esercita una pressione insolita sullo storage locale durante il primo download, il caricamento dei checkpoint, gli aggiornamenti e il recovery.
Lo storage NVMe è preferibile a dischi lenti montati in rete. Se più macchine condividono i file del modello, la topologia della cache del modello e la banda di rete diventano parte dell’architettura di inferenza piuttosto che semplici dettagli di deployment.
Monitor more than GPU utilization
Traccia:
- Utilizzo di HBM/VRAM
- RAM della CPU
- tasso di hit della cache
- tempo al primo token
- token decodificati al secondo
- profondità della coda delle richieste
- comunicazione inter-GPU
- banda inter-nodo
- parsing delle tool call fallito
- tempo di caricamento del modello
Alla scala di K3, un’apparente metrica sana di utilizzo GPU non indica se la topologia di serving è efficiente.
Local Kimi K3 vs Hosted Kimi K3
L’hosting autonomo offre il massimo controllo sul percorso dei dati, sul runtime e sui pesi del modello, rendendo al contempo il team responsabile della capacità GPU, dello scaling, degli upgrade, del monitoring e del recovery. L’accesso ospitato rimuove gran parte del lavoro infrastrutturale ed è generalmente il percorso più rapido per la valutazione o per una domanda variabile.
Per l’analisi completa dell’hardware e del break-even, leggi Kimi K3 Self-Hosting vs API. Per prezzi dei token, caching e confronti con K2.7, usa la guida ai prezzi di Kimi K3. Questo articolo mantiene quindi il confronto breve e si concentra su comandi di deployment, configurazione e troubleshooting.
Common Kimi K3 Local Deployment Problems
The model does not fit in GPU memory
Questo è il failure più prevedibile.
Non calcolare la memoria a partire dai 104B parametri attivati. Questa cifra descrive il calcolo per token, non la quantità di dati di peso degli esperti che il sistema di serving deve rendere disponibile.
Usa una topologia distribuita supportata, una quantizzazione GGUF più piccola o un servizio ospitato.
CUDA or NVIDIA driver errors
L’attuale immagine vLLM K3 è basata su CUDA 13 e richiede un driver host R580+.
Se l’host è ancora su uno stack R575/CUDA 12.9, aggiornalo o segui il percorso di build-from-source descritto da vLLM invece di presumere che il container risolva l’incompatibilità del driver host.
The first request is extremely slow
Verifica se il checkpoint è ancora in caricamento, se sta compilando i kernel, scaldando le cache o scaricando file.
Con asset di classe multi-terabyte, “processo server avviato” e “modello pronto per traffico di produzione” non sono stati equivalenti.
Tool calls fail intermittently
La ricetta vLLM attuale annota che K3 può occasionalmente produrre una forma di tool call che il suo parser non si aspetta. I sistemi di produzione dovrebbero quindi validare gli schemi delle tool call e implementare retry invece di fidarsi ciecamente di ogni chiamata generata.
Long conversations become less stable
Assicurati di restituire l’intero messaggio dell’assistente—incluso reasoning e informazioni sugli strumenti—ai turni successivi di K3.
Omettere i campi nascosti dello stato di reasoning può rompere il pattern di storico del pensiero preservato che K3 è stato addestrato a usare.
So, What Is the Best Way to Deploy Kimi K3 Locally?
Per la maggior parte delle organizzazioni con hardware idoneo, vLLM è il miglior primo percorso di deployment. Ha supporto dedicato per K3, un’API compatibile OpenAI, parser specifici per il modello, caching dei prefissi, supporto alla decodifica speculativa e ricette hardware aggiornate.
Scegli SGLang quando l’ingegneria dell’inferenza distribuita e un controllo di serving fine sono più importanti del percorso di setup più breve.
Scegli llama.cpp più una quantizzazione GGUF della community solo quando il tuo obiettivo è la sperimentazione su workstation/server e sei consapevole che anche le versioni a 1 bit restano di diverse centinaia di gigabyte.
Per una workstation sviluppatore convenzionale, la conclusione più pratica è diversa: non acquistare centinaia di gigabyte di RAM solo per forzare K3 su un desktop. Prova prima Kimi K3 tramite CometAPI, quantifica il beneficio sui tuoi compiti e passa all’hosting autonomo solo quando privacy, utilizzo sostenuto o controllo dell’infrastruttura rendono l’economia sensata.
FAQ
Can Kimi K3 run on a single consumer GPU?
Non realisticamente. Il modello è ben oltre la capacità di VRAM delle GPU consumer. Le quantizzazioni GGUF a basso bit della community riducono notevolmente l’impronta, ma le varianti più piccole attuali sono comunque di centinaia di gigabyte.
Can I run Kimi K3 on a Mac?
Esecuzione sperimentale su CPU/Apple Silicon con GGUF e offloading su storage è in linea di principio possibile, ma performance interattive e capacità di memoria sono i fattori limitanti. Un MacBook tipico non va considerato una piattaforma pratica per il serving di K3.
Does Kimi K3 support Ollama?
Le build GGUF della community possono essere lanciate tramite Ollama. Il runtime semplifica il setup ma non cambia il requisito di memoria sottostante.
Is vLLM or SGLang better for Kimi K3?
vLLM è la scelta più semplice per un nuovo deployment di produzione. SGLang è attraente per team che costruiscono topologie di serving distribuite sofisticate. Entrambi sono tra i motori di inferenza K3 consigliati da Moonshot.
How much context does Kimi K3 support?
La specifica ufficiale del modello supporta 1,048,576 token. Un server locale non deve esporre l’intera finestra di contesto; impostare un max-model-len più basso può essere più pratico per il deployment iniziale e una maggiore concorrenza.
Is Kimi K3 open source?
Una descrizione più precisa è open-weight. Moonshot ha rilasciato i pesi del modello sotto la Kimi K3 License. Esamina direttamente quella licenza prima di ridistribuzione commerciale o altri usi in cui i termini di licenza sono rilevanti.
What is the easiest way to use Kimi K3 without local GPUs?
Un’API ospitata è il percorso più semplice. Kimi K3 è disponibile tramite CometAPI con un’interfaccia di chat-completions compatibile OpenAI, quindi il codice applicativo può rimanere vicino a quello che useresti contro un server vLLM o SGLang locale.
