Crea con CometAPITi serve una sola API per più modelli?Testa il flusso di lavoro in Playground, poi crea una chiave API quando modello e costo sono adatti al tuo caso d'uso.
Come eseguire MiniMax M3.1 Flash in locale: guida a GPU, vLLM & SGLang
Scopri come eseguire MiniMax M3.1 Flash in locale. Esplora la sua architettura MoE da 428B/23B, i requisiti GPU, la configurazione di vLLM e SGLang, i benchmark e le API alternative.
MiniMax M3.1 Flash porta l’AI open-weight in workflow esigenti di coding e agenti, ma l’esecuzione in locale richiede hardware importante. La sua architettura MoE da 428B parametri attiva solo 23B parametri per token, riducendo il compute senza eliminare la necessità di conservare l’intero modello. Gli sviluppatori con sistemi multi‑GPU supportati possono distribuirlo con vLLM o SGLang. Per chi vuole evitare la gestione dell’infrastruttura, la API MiniMax M3.1 Flash in CometAPI offre un modo più semplice per iniziare.
Punti chiave
L’hardware è il principale ostacolo. Le configurazioni vLLM pubblicate usano quattro GPU Blackwell o AMD MI355X supportate, oppure otto GPU H100/H200.
Revisionato per chiarezza, attribuzione delle fonti e terminologia API aggiornata.
Il long context ha un costo in memoria. Il modello supporta fino a un milione di token, ma i limiti pratici di serving dipendono dalla memoria GPU disponibile e dalla concorrenza.
Il deployment è specifico per l’hardware. Usa motore d’inferenza, formato di quantizzazione e configurazione dell’acceleratore compatibili, invece di un generico comando di installazione.
I benchmark sono solo un punto di partenza. Valuta accuratezza nel coding, completamento dei task degli agenti, latenza e throughput sui tuoi carichi.
Inferenza locale e hosted rispondono a esigenze diverse. Il self‑hosting offre maggiore controllo sull’infrastruttura, mentre l’accesso via API riduce complessità di setup e oneri di manutenzione.
Che cos’è MiniMax M3.1 Flash?
MiniMax M3.1 Flash accetta testo, immagini e video e genera testo. È progettato per workflow di coding, automazione, interazione con il computer e sicurezza. I pesi sono distribuiti sotto la MiniMax Community License. Prima di offrire un servizio commerciale, leggi la licenza fornita con il checkpoint e verifica le condizioni applicabili al tuo uso.
Specifiche di MiniMax M3.1 Flash
Specifica
MiniMax M3.1 Flash
Sviluppatore
MiniMax
Famiglia di modelli
MoE multimodale nativo
Parametri totali
Circa 428B
Parametri attivi
Circa 23B per token
Contesto massimo
1,048,576 token (capacità del modello)
Tipi di input
Testo, immagini e video (in base al route)
Output
Testo
Attenzione
MiniMax Sparse Attention in ogni layer
Quantizzazione
MXFP8 layer densi / NVFP4 expert
Draft decoding
Testa di bozza DSpark integrata
Reasoning effort
low, medium, high, xhigh, max
Velocità riportata
200+ token/s in condizioni favorevoli; P50 170+ token/s
Licenza
MiniMax Community License
Inferenza documentata
vLLM, SGLang
Topologia tipica
4 GPU Blackwell o MI355X supportate; 8 GPU H100/H200
Come MiniMax M3.1 Flash usa la sua architettura 428B/23B?
Un modello Mixture‑of‑Experts (MoE) instrada ogni token verso expert selezionati. In MiniMax M3.1 Flash, circa 23B parametri sono attivi per token, mentre il pool completo è circa 428B. L’attivazione sparsa riduce il compute; non trasforma il checkpoint in un modello denso da 23B.
Cosa è cambiato in MiniMax M3.1 Flash?
Attenzione sparsa: Applicata in tutto il modello per ridurre il lavoro di attenzione su input lunghi; il beneficio dipende dai kernel di serving e dal prompt.
Pesi a precisione mista: Componenti densi MXFP8 ed expert NVFP4 riducono storage e compute, ma richiedono comunque hardware e kernel compatibili.
Decoding DSpark: Una testa di bozza integrata può accelerare la generazione nelle ricette supportate; i risultati dipendono dall’accettazione dei token e dal carico.
Serving power‑aware: La schedulazione a livello infrastrutturale può migliorare l’utilizzo, ma non è una funzione che ottieni automaticamente scaricando i pesi.
Quale hardware serve per MiniMax M3.1 Flash?
Considera la memoria GPU in quattro parti: pesi del checkpoint, cache key‑value (KV) per i token precedenti, buffer runtime e margine per il carico. Le stime sotto coprono solo lo storage grezzo dei parametri. Precisione mista, scale di quantizzazione, componenti multimodali e overhead di serving cambiano il requisito reale.
Topologie GPU convalidate
Acceleratori
Topologia pubblicata
Note
NVIDIA GB200/GB300/B200/B300
4 GPU, parallelismo a tensori
Percorso NVFP4‑nativo Blackwell
NVIDIA H100/H200
8 GPU, parallelismo a tensori
Cache FP8 e percorso Marlin MoE
AMD MI355X
4 GPU, parallelismo a tensori
Richiede ROCm e impostazioni AITER supportate
GPU consumer 24–32 GB
Nessuna ricetta a checkpoint completo
Non sufficiente per un semplice caricamento su singola GPU
Workstation solo CPU
Nessun deployment pratico convalidato
Esperimenti di offloading non sono linee guida production
Stima della memoria: Lo storage grezzo per 428B parametri è circa 856 GB in BF16, 428 GB in 8‑bit o 214 GB in un 4‑bit idealizzato. Il checkpoint ufficiale mescola formati, quindi queste cifre non sono requisiti VRAM a runtime. Considera scale di quantizzazione, cache KV, buffer runtime e concorrenza; usa i file del checkpoint reali e la ricetta per la tua GPU per dimensionare il sistema.
Riserva spazio NVMe per il checkpoint, download temporanei e una copia per il rollback.
Quale metodo di deployment dovresti scegliere?
Per un cluster locale supportato, vLLM è un punto di partenza pratico con configurazioni di riferimento e integrazione API familiare; SGLang è adatto a team che esplorano la personalizzazione del serving dopo aver verificato la compatibilità, mentre CometAPI offre un percorso hosted per il prototyping e lo switching tra modelli.
Requisito
vLLM locale
SGLang locale
CometAPI
Pesi e GPU
Scaricare i pesi; gestire GPU supportate
Scaricare i pesi; gestire GPU supportate
Inferenza gestita dal provider; nessun peso locale
Blackwell / AMD MI355X
Ricette specifiche per l’hardware
Ricette specifiche per l’hardware
Hardware gestito dal provider
H100/H200
Ricetta a otto GPU documentata
Verifica la matrice di supporto attuale
Hardware gestito dal provider
Decoding e parallelismo
DSpark su percorsi supportati; serving tensor e distribuito
Decoding specifico per hardware; parallelismo a tensori e tra expert
Limitato alle opzioni esposte dal route
Controllo ed elaborazione dati
Tuo ambiente; gestisci lo scaling
Tuo ambiente; gestisci lo scaling
Provider esterno; scaling gestito dal provider
Scegli il framework con una ricetta convalidata per il tuo hardware, poi confronta latenza e throughput usando gli stessi prompt, precisione e concorrenza.
Come eseguire MiniMax M3.1 Flash in locale con vLLM?
I passaggi seguenti assumono un host Linux dotato di quattro GPU NVIDIA Blackwell compatibili, un ambiente driver/CUDA supportato e accesso al checkpoint ufficiale. Usa una build vLLM convalidata; un’installazione ordinaria su hardware GPU non supportato può fallire anche se l’installazione del pacchetto va a buon fine.
Assicurati che la wheel installata e il runtime CUDA corrispondano alla tua famiglia di GPU. Se è necessaria una build di sviluppo specifica del progetto, segui le note di installazione di riferimento prima di usare gli argomenti di lancio.
Usa un token di accesso Hugging Face appropriato se richiesto, preserva la struttura delle directory e verifica il download completo degli shard prima di avviare il server.
Attendi che il server completi il caricamento e segnali la disponibilità prima di inviare una richiesta. Il comando sopra limita il contesto a 32.768 token e le sequenze concorrenti a quattro per un primo smoke test. Questi limiti ridotti non sono impostazioni da benchmark; regolali dopo aver misurato l’uso di memoria e il comportamento delle richieste sul tuo hardware.
Se l’identificatore servito differisce dal nome della directory, chiama /v1/models e usa l’ID restituito esatto. Una risposta testuale di successo valida solo l’inferenza di base; testa separatamente vision, tool calling, concorrenza e long context.
Passo 5: Integra con un client Python compatibile con OpenAI
L’esempio ascolta su 127.0.0.1 per test locali. Prima di collegare client remoti, applica controlli di accesso davanti all’endpoint e configura timeout dei client, retry con limiti e monitoraggio.
Variante H100/H200: usa la ricetta Hopper a otto GPU
Su otto GPU H100/H200, usa la cache FP8 specifica per Hopper e il percorso Marlin MoE invece della configurazione NVFP4 per Blackwell. Il comando seguente segue la ricetta vLLM ufficiale per Hopper con contesto e concorrenza ridotti a 32K e quattro sequenze per un test iniziale. Disabilita l’input video in linea con quella ricetta. Mantieni questo endpoint dietro i controlli di accesso esistenti.
SGLang offre ricette di deployment M3.1 specifiche per hardware e serving compatibile con OpenAI. Alla snapshot del 23 ottobre, la documentazione include immagini di container di sviluppo dedicate, quindi non si deve presumere che un’installazione generica di SGLang contenga tutto il supporto specifico del modello.
Recupera l’immagine di container dedicata
# NVIDIA development image
docker pull lmsysorg/sglang:dev-minimax-m31-flash

# AMD MI350X/MI355X development image
docker pull lmsysorg/sglang:dev-minimax-m31-flash-mi35x
Poi, segui il cookbook SGLang MiniMax M3.1 per il tuo acceleratore. Scaricare un’immagine significa ottenere solo il runtime; devi comunque avviare un container con accesso alla GPU e lanciare al suo interno la configurazione di serving corrispondente. Usa il comando completo specifico per hardware del cookbook, attendi la disponibilità, quindi interroga la lista dei modelli dell’endpoint prima di inviare una richiesta di test. I percorsi documentati per NVIDIA e AMD usano dipendenze diverse e vanno configurati separatamente.
Come si comporta MiniMax M3.1 Flash nei benchmark?
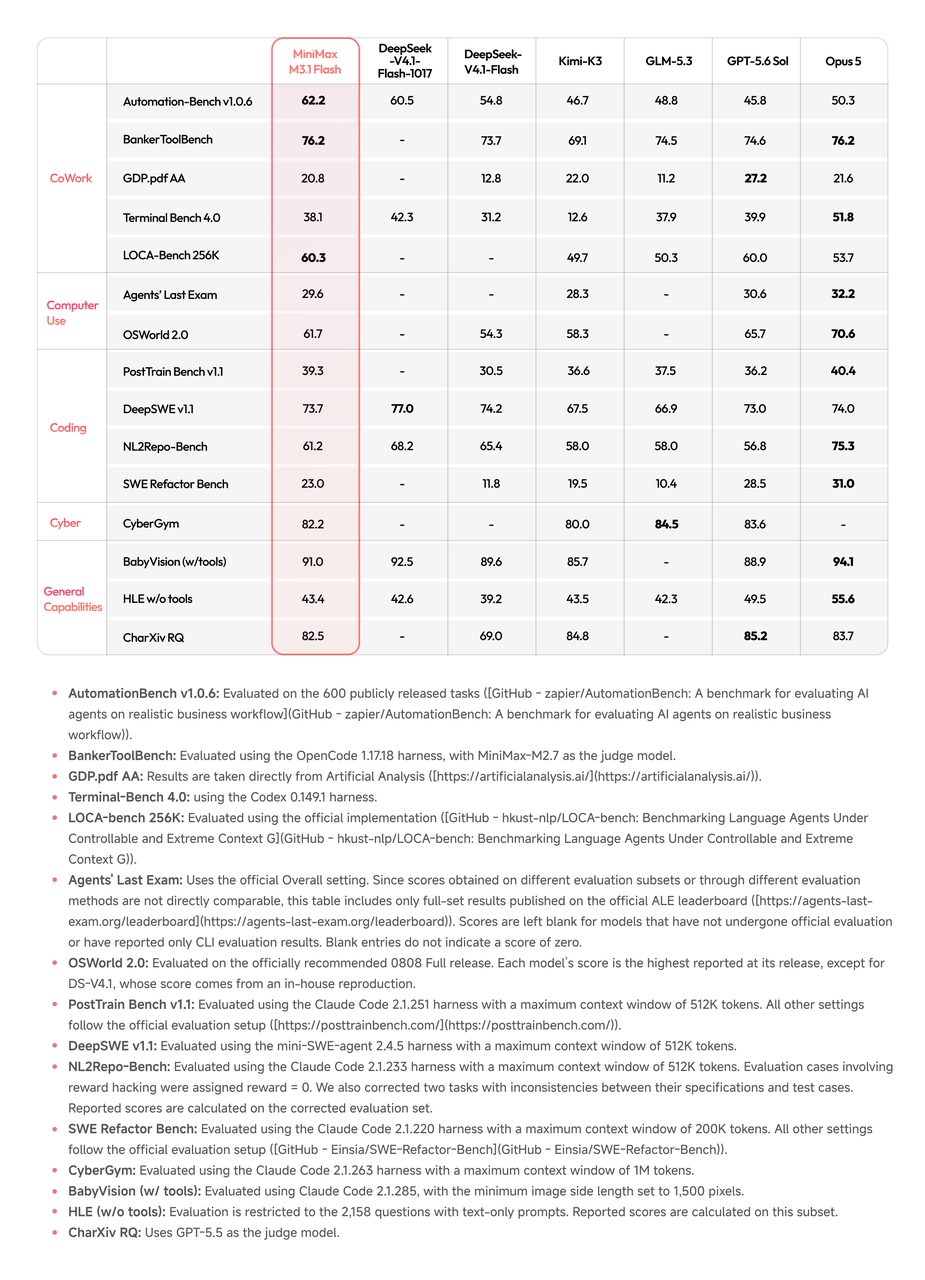
Una volta che il tuo endpoint supera i controlli di base, usa i benchmark pubblicati per decidere quali carichi testare dopo. Le cifre sotto sono valutazioni pubblicate dal vendor, non misurazioni del tuo deployment locale.
Benchmark
M3.1 Flash
DeepSeek V4.1 Flash 1017
Kimi K3
Automation-Bench v1.0.6
62.8
60.5
46.7
DeepSWE v1.1
73.7
77.0
67.5
Terminal Bench 4.0
38.1
42.3
12.6
OSWorld 2.0
61.7
N/D
58.3
NL2Repo-Bench
61.2
68.2
58.0
BabyVision with tools
91.0
92.5
85.7
In questo confronto, MiniMax guida i modelli elencati su Automation‑Bench, mentre DeepSeek primeggia su diversi benchmark di coding. Leggi la scheda modello e le impostazioni di valutazione prima di trarre conclusioni e testa i prompt e gli strumenti che la tua applicazione usa davvero. Punteggi di versioni o setup di benchmark differenti non sono direttamente comparabili.
Come ottimizzare le prestazioni di MiniMax M3.1 Flash?
Controllare contesto e concorrenza
Dopo la prima richiesta andata a buon fine, aumenta una variabile di carico alla volta: lunghezza dell’input, lunghezza dell’output o richieste concorrenti. Registra memoria di picco e latenza di risposta per ciascuna esecuzione. Conserva le ultime impostazioni stabili come punto di rollback, in modo che un esperimento fallito non diventi il tuo nuovo baseline.
Scegliere consapevolmente lo sforzo di ragionamento
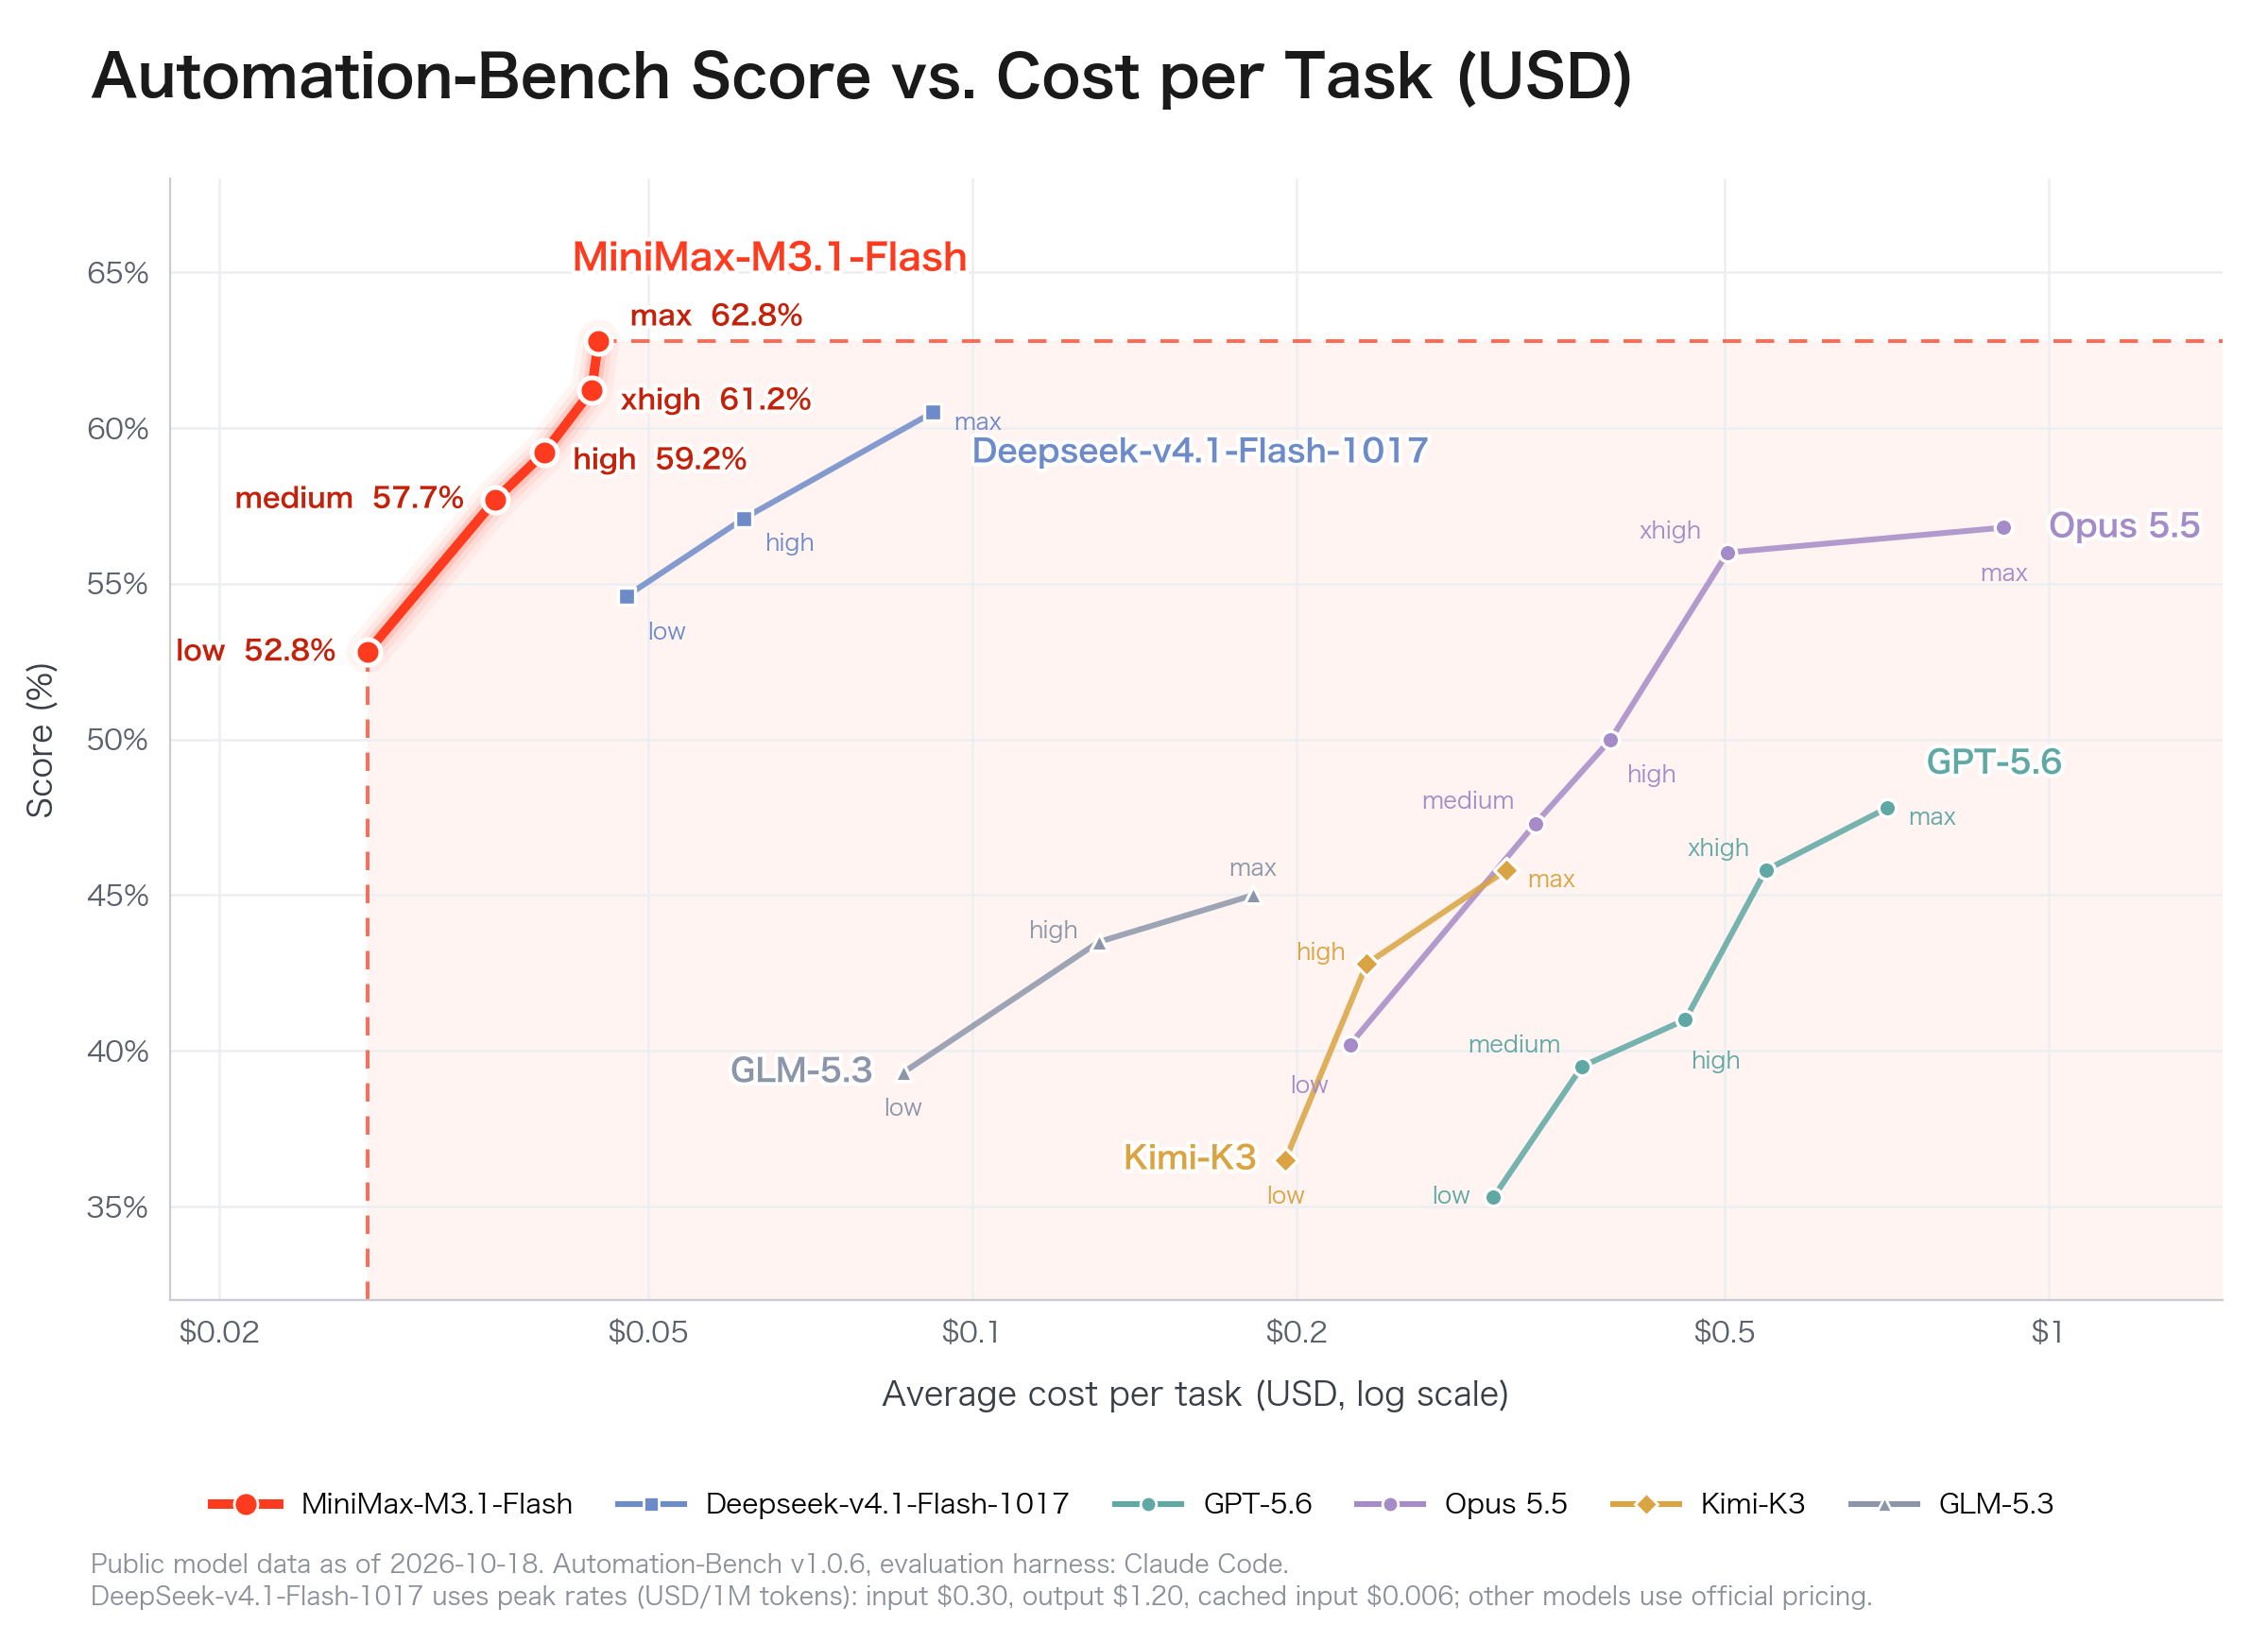
M3.1 Flash supporta low, medium, high, xhigh e max. Impostazioni più alte possono migliorare i punteggi in task impegnativi ma spesso richiedono più token di ragionamento e maggiore latenza. Valuta insieme qualità del completamento del task e costo computazionale trascorso.
Per richieste vLLM locali, la ricetta mostra le impostazioni di reasoning‑effort sotto chat_template_kwargs. Controlla sia la risposta finale sia l’eventuale campo di reasoning restituito separatamente quando validi il tuo client, poiché endpoint hosted e locali possono esporre questi campi in modo diverso.
Monitorare il costo per attività completata
Per gli agenti, i token al secondo non bastano. Registra time‑to‑first‑token, velocità di output, tasso di accettazione della decodifica speculativa, throughput concorrente, errori di tool‑call, utilizzo memoria e costo per task completato. Una risposta più lenta con meno tool falliti può offrire un’economia complessiva migliore.
Come usare la API MiniMax M3.1 Flash in CometAPI?
I team che non necessitano di infrastruttura dedicata di accelerazione possono usare un endpoint hosted compatibile con OpenAI. Questo elimina download del checkpoint e operazioni GPU, ma sposta l’elaborazione delle richieste fuori dall’ambiente self‑hosted.
export COMETAPI_KEY="YOUR_COMETAPI_KEY"

curl https://api.cometapi.com/v1/chat/completions \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "minimax-m3.1-flash",
    "messages": [{"role":"user","content":"Review this Python function for edge cases."}],
    "max_tokens": 2048
  }'
Conferma l’identificatore del modello nella tua console CometAPI prima di eseguire questo esempio. Usa il gateway quando un’API comune tra provider aiuta la tua applicazione; confronta la quotazione attuale con l’accesso diretto per il tuo uso previsto.
Prezzi dell’API MiniMax M3.1 Flash
Prezzo per milione di token
API ufficiale MiniMax
CometAPI
Input
$0.15
$0.80
Output
$0.60
$3.20
Input in cache
$0.015
Conferma la quota del route attuale
Le tariffe dirette dell’API MiniMax nell’annuncio di lancio del 19 ottobre 2026 sono $0.15 per input, $0.60 per output e $0.015 per input in cache per milione di token. Per CometAPI, verifica il route del modello attivo, le tariffe input/output, le regole di caching ed eventuali sconti account prima di stimare la spesa. Confronta il costo totale per il tuo mix atteso di token e retry.
Quali problemi potrebbero verificarsi eseguendo MiniMax M3.1 Flash?
Out of memory durante caricamento o richieste
Se i pesi non si caricano: Controlla lo stadio in errore nel log di avvio, conferma che il checkpoint sia completo e verifica che la topologia GPU e il backend di quantizzazione corrispondano alla ricetta. Se i pesi eccedono la memoria disponibile, usa una configurazione con capacità sufficiente; accorciare una richiesta non risolve un errore di caricamento pesi.
Se i pesi si caricano ma l’allocazione della cache fallisce all’avvio: Controlla le impostazioni della cache e la memoria disponibile, quindi riduci il contesto o la concorrenza configurati in base alla ricetta.
Se il server si avvia ma una richiesta esaurisce la memoria: Riprova con un prompt corto e una richiesta alla volta, quindi aumenta separatamente lunghezza input, lunghezza output e concorrenza monitorando la memoria.
Kernel di quantizzazione o di attenzione incompatibili
L’esecuzione NVFP4 differisce tra hardware Blackwell, Hopper e AMD. Abbina versioni del motore di inferenza, backend di quantizzazione, versioni CUDA/ROCm e famiglie di acceleratori invece di riutilizzare flag indiscriminatamente.
Configurazione della cache per l’attenzione sparsa
Se all’avvio viene segnalato un layout di cache non supportato, confronta la configurazione completa della cache con la ricetta specifica per l’hardware. L’attuale ricetta vLLM richiede --block-size 128 per la cache sparsa/index MSA. Se all’avvio compaiono errori di layout della cache o block‑size, confronta la configurazione completa con la ricetta per il tuo hardware.
Identificatori di modello inattesi
Un percorso locale e il nome del modello in un gateway remoto non sono necessariamente identici. Interroga la risposta locale /v1/models ed evita di codificare supposizioni derivate da un altro endpoint.
Throughput osservato scarso
Distingui lenti processi di prompt da lenta generazione di token. Confronta esecuzioni con la stessa lunghezza di input e limite di output, poi controlla utilizzo GPU e comportamento dell’interconnect prima di aumentare la dimensione del batch. Una cifra di velocità dichiarata da un provider non è un baseline per il tuo cluster locale.
Conclusione
Scegli il tuo primo percorso di deployment in base all’hardware che puoi operare oggi. Usa il walkthrough vLLM per un cluster locale supportato, il cookbook SGLang specifico per hardware per uno stack di serving alternativo, oppure una API hosted quando vuoi concentrarti sull’integrazione applicativa. Mantieni la configurazione che soddisfa i tuoi obiettivi di qualità del task e latenza a un costo operativo sostenibile.
Il modo più affidabile per scegliere un metodo di serving è ottimizzare per lavoro corretto completato per dollaro e minuto, non solo per il picco di token al secondo.
FAQ
Come rendere riproducibile un deployment dopo l’aggiornamento del runtime?
Blocca la revisione del checkpoint, le versioni dell’immagine o dei pacchetti del runtime, lo stack driver e le impostazioni di lancio. Esegui lo stesso piccolo set di accettazione prima di ogni upgrade e mantieni disponibile la precedente configurazione funzionante per il rollback.
Come gestire i retry quando un agente chiama strumenti?
Separa il retry del modello dal ripetere un’azione di uno strumento. Usa chiavi di idempotenza per azioni che modificano i dati, verifica se il primo tentativo è riuscito e valida gli argomenti completi dello strumento prima dell’esecuzione.
Posso passare da un endpoint locale a CometAPI senza cambiare il comportamento dell’applicazione?
Mantieni configurabili endpoint, credenziali e ID modello. Testa streaming, tool call, campi di reasoning e input multimodali su entrambe le route e conferma i requisiti di instradamento dei dati prima di abilitare il fallback.
Cosa testare prima di accettare input multimodali?
Testa immagini e video rappresentativi, inclusi file di bassa qualità e non supportati. Verifica separatamente pre‑processing, limiti di dimensione, qualità delle risposte e timeout; una richiesta testuale riuscita non valida il percorso multimodale.
Come capire se un deployment è pronto per utenti reali?
Definisci target per successo dei task, tool call valide, latenza, errori e costo. Testa traffico realistico, verifica monitoraggio e comportamento di fallback, quindi amplia a partire da un rollout ridotto solo finché tali target restano soddisfatti.