
Sintesi rapida: Per usare la Claude Fable 5.1 API in CometAPI, prepara una chiave API, imposta l’ID modello su claude-fable-5-1 e valida una piccola richiesta prima di costruire un workflow più lungo. Questa guida copre accesso, effort, streaming, strumenti, caching, migrazione e controlli in produzione. Tratta il deployment come qualcosa di più che cambiare una stringa di modello: conferma la compatibilità del percorso, valida gli output e misura qualità dei task accettati, latenza e costo prima di espandere l’uso.
Punti chiave
- Fai funzionare prima una singola richiesta: conferma credenziali, accesso al modello, endpoint scelto e una risposta utilizzabile con dati di test non sensibili.
- Scegli l’effort con consapevolezza: inizia da high, poi confronta altre impostazioni su task rappresentativi invece di usare il massimo effort per ogni richiesta. Claude Code predefinisce High. Claude Cowork / Claude.ai predefinisce Medium.
- Rivedi il comportamento di migrazione: la selezione forzata degli strumenti è rifiutata; mantieni gli step di workflow richiesti e la validazione degli argomenti degli strumenti nel codice dell’applicazione.
- Misura l’intero workflow: traccia uso della cache, costo token, latenza, rifiuti, comportamento di fallback e se il risultato finale supera i tuoi controlli di accettazione.
Per contesto, vedi il precedente tracker Fable 5.1 di CometAPI e il tutorial Fable 5 API. Questo articolo si concentra sull’attuale workflow di integrazione.
Che cos’è Claude Fable 5.1?
Claude Fable 5.1 è il modello generalmente disponibile di Anthropic con la massima capacità per coding ambizioso, ricerca multistep, uso del computer e workflow professionali ricchi di documenti. Anthropic consiglia di iniziare la maggior parte dei carichi con Claude Opus 5 e di passare a Fable 5.1 quando valutazioni Opus ad alto effort non sono ancora sufficienti.
La distinzione è operativa: Fable 5.1 è progettato per continuare a lavorare su step dipendenti, recuperare dopo una chiamata strumento fallita, verificare i risultati e riportare i progressi durante esecuzioni lunghe. Questo può migliorare i tassi di completamento, ma rende costo, latenza e osservabilità centrali per il deployment.
Specifiche API di Claude Fable 5.1
| Specifica ufficiale | Claude Fable 5.1 |
|---|---|
| Provider | Anthropic |
| ID del modello | claude-fable-5-1 |
| Data di rilascio | 1 settembre 2026 |
| Finestra di contesto | 1.000.000 token |
| Output massimo | 128.000 token |
| Input e output | Testo e immagini verso testo |
| Ragionamento | Adattivo, sempre attivo |
| Effort predefinito | L’API è High, Claude Code predefinisce High, Claude Cowork / Claude.ai predefinisce Medium |
| Livelli di effort | low, medium, high, xhigh, max |
| Cutoff della conoscenza | Giugno 2026 |
| Prezzo ufficiale | $10 input / $50 output per milione di token |
| Lettura cache | $0,25 per milione di token |
L’overview ufficiale conferma una finestra di contesto da 1M e output massimo da 128K. Il ragionamento adattivo è sempre attivo; la profondità del reasoning è controllata con l’effort invece di un tradizionale budget di thinking-token.
Claude Fable 5.1 API: prestazioni ufficiali ai benchmark
Il riepilogo dei benchmark è intenzionalmente compatto perché lo scopo principale dell’articolo è l’implementazione. I risultati sotto identificano dove il premium dell’API è più probabile che conti.
| Benchmark Anthropic | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52,6% | 24,7% | 29,0% | 22,4% |
| Terminal-Bench 4.0 | 55,8% | 42,0% | 52,3% | 37,3% |
| GDPval-AA v2 | 1.853 Elo | 1.723 | 1.824 | 1.711 |
| OSWorld 2.0, parziale | 77,9% | 72,9% | 75,4% | — |
| Humanity's Last Exam, no tools | 60,9% | 57,8% | 56,6% | — |
| AutomationBench | 31,4% | 17,1% | 26,9% | 19,6% |
| CursorBench 3.2.0 | 73,4% | 70,5% | 70,0% | 67,2% |
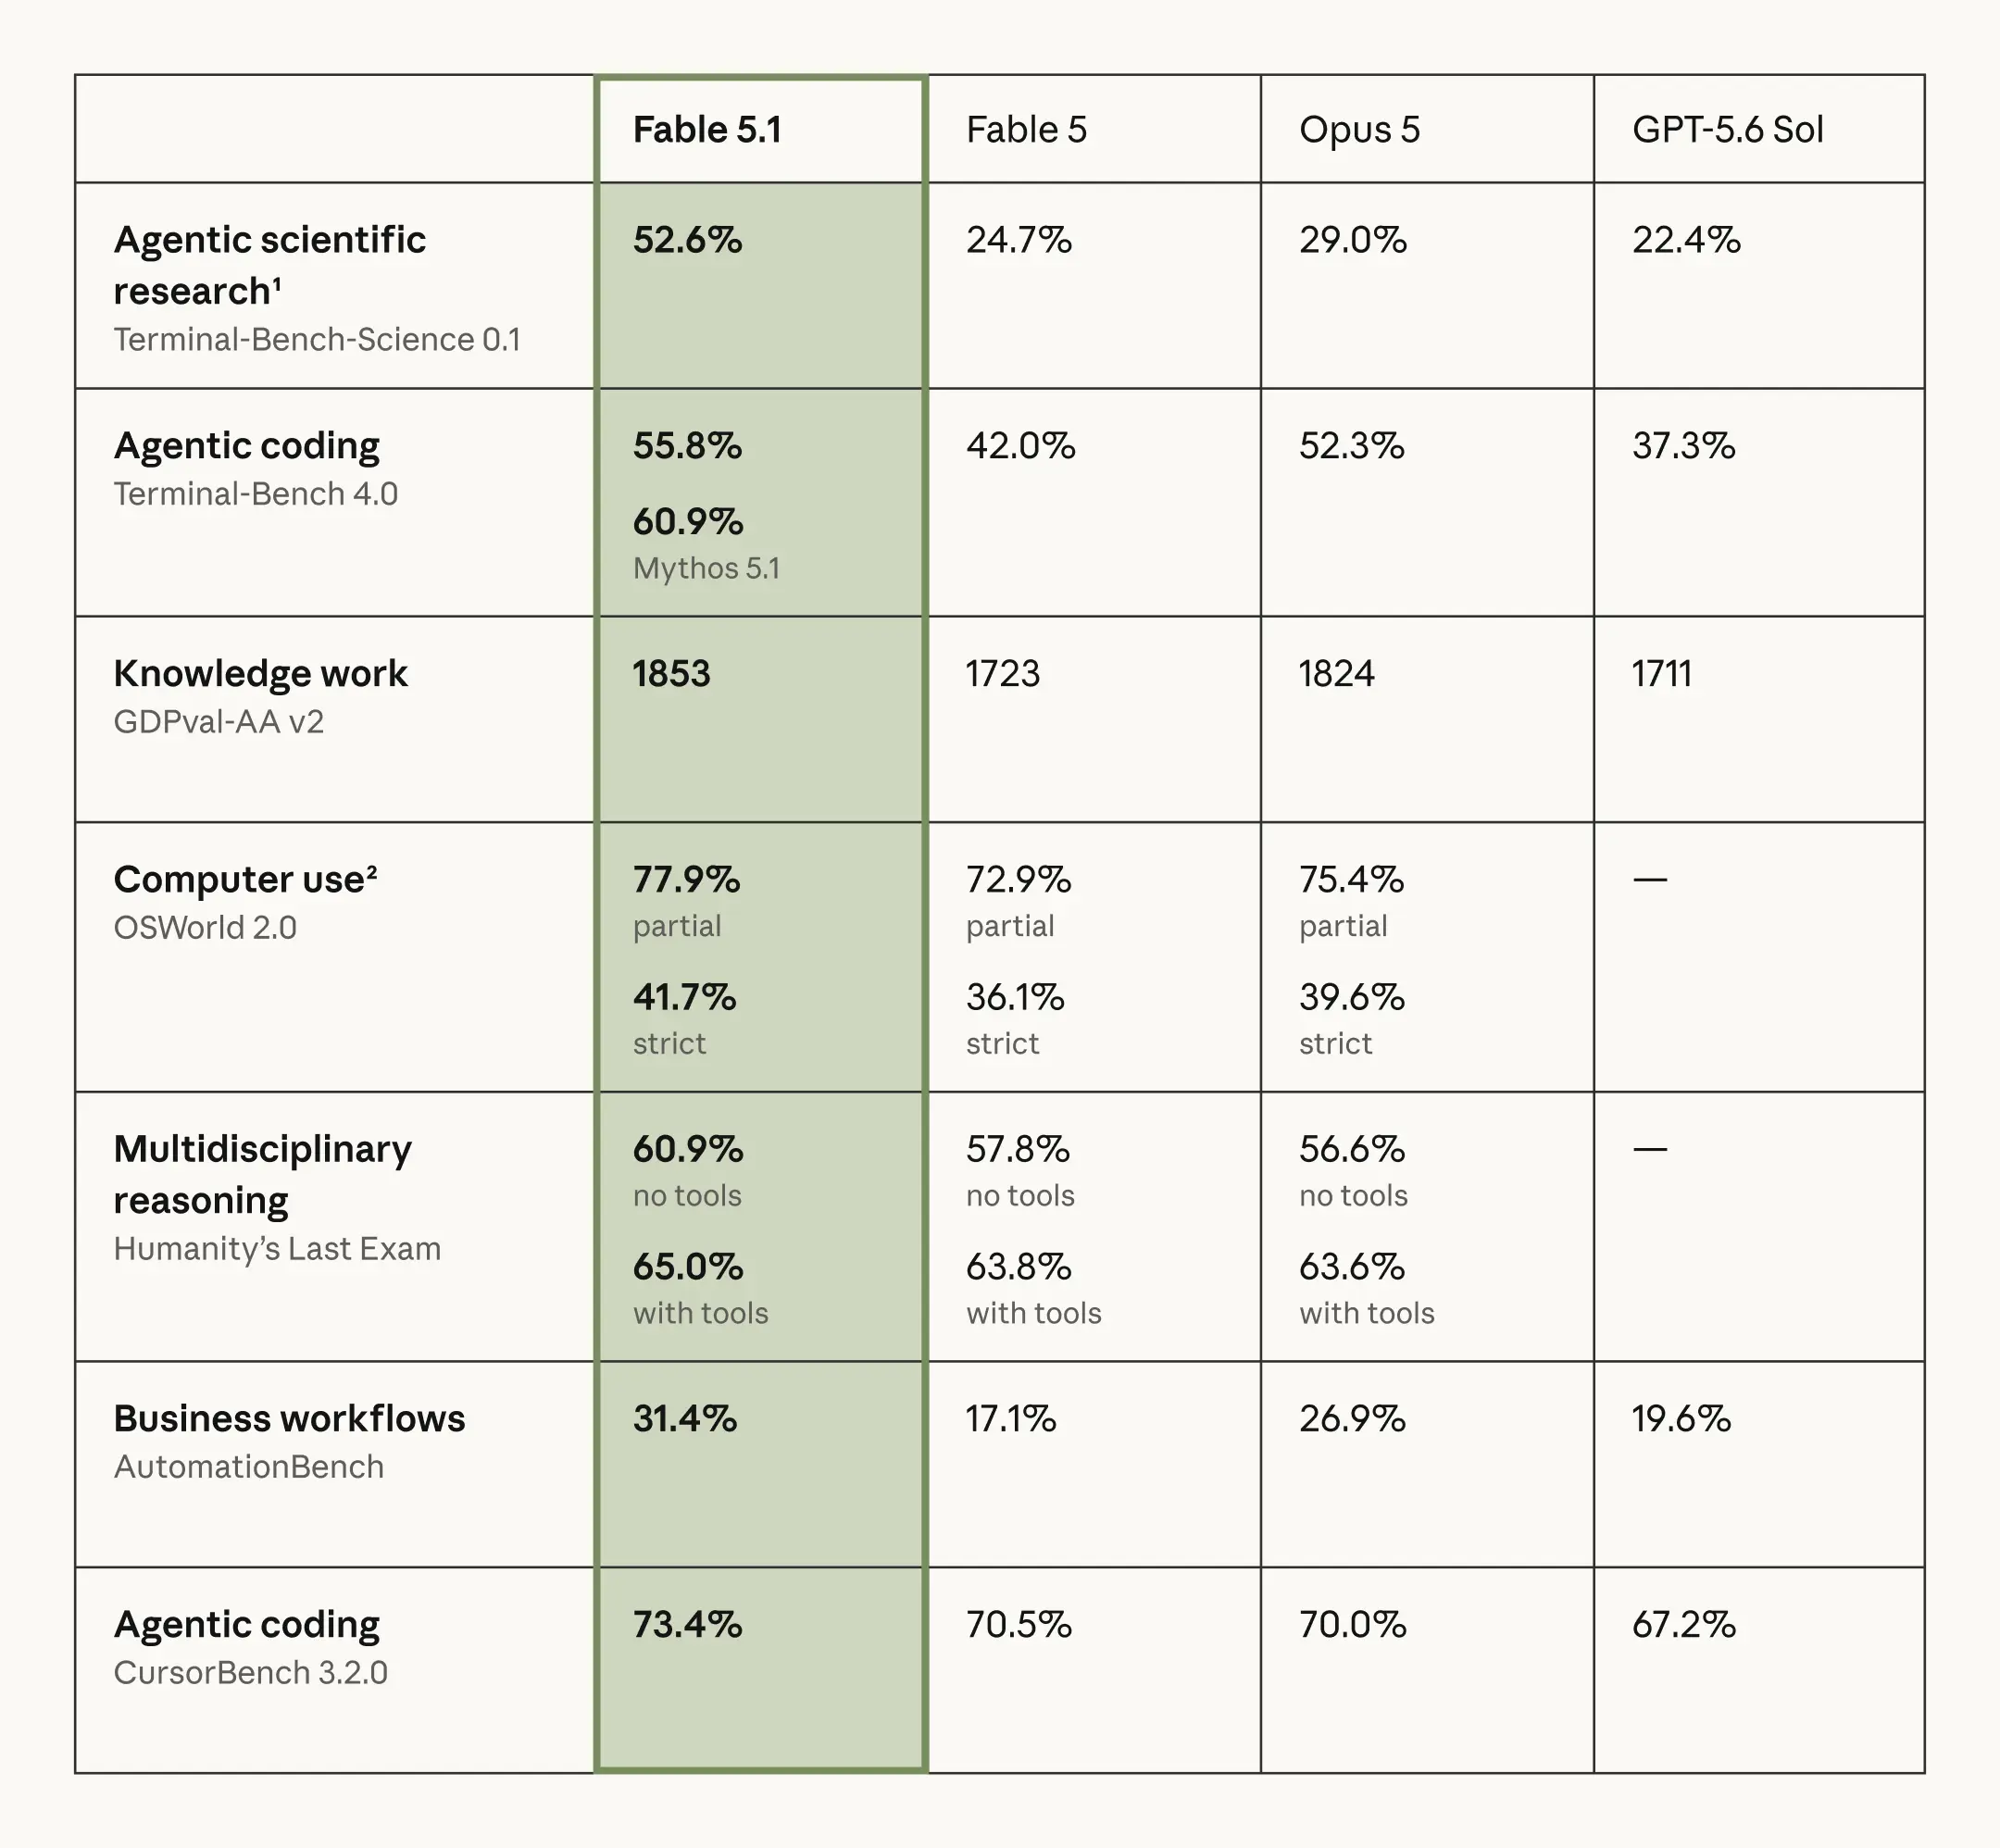
Confronto ufficiale dei benchmark di Claude Fable 5.1 di Anthropic
Il maggior salto generazionale in questo set è Terminal-Bench-Science: 52,6% contro 24,7%. AutomationBench sale da 17,1% a 31,4%, mentre Terminal-Bench 4.0 migliora fino al 55,8%. Il risultato è un forte argomento per testare Fable 5.1 su agenti di ricerca, coding di lunga durata e automazione aziendale—non per instradare ogni richiesta breve al modello più costoso.
Cosa è cambiato dalla Claude Fable 5 API?
| Dimensione | Claude Fable 5.1 | Claude Fable 5 | Impatto sulla migrazione |
|---|---|---|---|
| Ruolo principale | Agenti e ricerca di lunga durata più forti | Modello pubblico originale classe Mythos | Rivalutare i workflow più difficili |
| Scelta forzata degli strumenti | Restituisce un errore | In precedenza supportata | Rimuovere ogni forzatura, anche nominativa |
| Storico del thinking | Regole di compatibilità più rigide | Comportamento precedente | Mantenere storici append-only |
| Aggiornamenti di avanzamento | Aggiornamenti leggibili tra chiamate strumenti | Non disponibili in questa forma | Esporre lo stato delle esecuzioni lunghe |
| Effort per messaggio | Disponibile in beta | Non disponibile in questa forma | Regolare la profondità nella conversazione |
| Prezzo lettura cache | $0,25 / MTok | $1,00 / MTok | Ricalcolare l’economia di lunghi contesti |
| Prezzo input/output | $10 / $50 per MTok | $10 / $50 per MTok | Nessun cambiamento delle list rate |
Tre breaking change
L’uso forzato degli strumenti non è più supportato
Claude Fable 5.1 rifiuta valori tool_choice che forzano qualsiasi strumento o uno strumento specificamente nominato, restituendo un errore 400 invalid-request. Mantieni la selezione automatica, usa schemi rigorosi o structured outputs per la validazione e imponi gli step obbligatori del workflow nell’orchestrazione dell’applicazione invece che forzando una tool call del modello.
I modelli precedenti non possono leggere i thinking block di Fable 5.1
La compatibilità del thinking è unidirezionale: Fable 5.1 può consumare thinking block creati da precedenti modelli Claude compatibili, ma i modelli precedenti non possono leggere i block creati da Fable 5.1. Un router o fallback che passa a un modello precedente può eliminare quei block prima dell’inferenza, quindi le integrazioni dovrebbero registrare gli switch di modello e testare esplicitamente il comportamento di fallback.
Modificare turn precedenti invalida il thinking preservato
Cambiare un precedente system prompt, una definizione di strumento, un messaggio o i byte di un file referenziato può invalidare i thinking block successivi. Tratta il prefisso della conversazione come append-only, usa istruzioni a metà conversazione invece di riscrivere la storia e monitora le trasformazioni di mismatch del prefisso durante la migrazione.
Cinque capacità API aggiuntive
Effort per messaggio
Le applicazioni possono cambiare l’effort durante una conversazione senza invalidare la prompt cache. Questa capacità beta consente a un workflow di abbassare l’effort per i follow-up di routine e aumentarlo per turn difficili di pianificazione, debugging o verifica.
Messaggi di sistema con ambito di turno
Un system message beta può applicarsi a un turno e poi smettere di renderizzarsi dopo il successivo messaggio dell’utente pur restando invariato nello storico. È utile per istruzioni temporanee nei loop degli strumenti perché preserva sia il matching della prompt cache sia la validità dei successivi thinking block.
Aggiornamenti di avanzamento leggibili tra chiamate strumenti
Con l’opzione beta di progress-display, selezionati thinking block possono includere brevi aggiornamenti di stato che un’applicazione può mostrare agli utenti mentre il ragionamento privato resta nascosto. Gli agenti di lunga durata dovrebbero trattare questi aggiornamenti come stato operativo, non come risposte finali.
Prezzo inferiore per le letture della cache
Le letture della cache costano $0,25 per milione di token, un quarto della tariffa Fable 5, mentre i prezzi base input e output restano invariati. Questo può ridurre in modo significativo il costo di sessioni lunghe che riutilizzano ripetutamente un prefisso stabile in cache.
Provenienza dei contenuti
Il testo generato porta la filigrana statistica di Anthropic, mentre i media supportati recuperati tramite la Files API possono includere C2PA Content Credentials firmate. Questi meccanismi di provenienza non aggiungono token al prompt né richiedono cambi di formato della richiesta.
Cosa serve prima di usare la Claude Fable 5.1 API?
- Un account e una chiave API: accedi a CometAPI e genera una chiave nella console delle chiavi API. Controlla l’accesso al modello e che il tuo account sia pronto per la fatturazione a consumo prima di inviare chiamate di test.
- Un runtime locale: usa un terminale con curl per il primo esempio HTTP. Per gli esempi Python, prepara Python e pip in un ambiente isolato, poi installa l’SDK usato dall’esempio scelto.
- Un route selezionato: la Claude Fable 5.1 API in CometAPI offre i formati Messages e Chat Completions. Usa l’URL base e il formato di richiesta corrispondenti; non mescolare i payload.
- Configurazione sicura: imposta
COMETAPI_KEYfuori dai file sorgente versionati, usaclaude-fable-5-1come ID modello e assicurati che la tua rete possa raggiungerehttps://api.cometapi.com. - Un test sicuro e un controllo di accettazione: inizia con un prompt breve e non sensibile. Conferma che la risposta contenga contenuto utilizzabile, ispeziona usage e stato della completion e verifica i requisiti di gestione dei dati della tua organizzazione prima di inviare documenti o log reali.
Come accedere a Claude Fable 5.1 tramite CometAPI
CometAPI espone Claude Fable 5.1 tramite una route Messages compatibile con Anthropic e una route Chat Completions compatibile con OpenAI. Usa Messages quando ti servono effort, thinking, caching e semantica degli strumenti nativi di Claude; usa Chat Completions quando la tua applicazione è già standardizzata sull’SDK OpenAI.
Passaggio 1: archivia la chiave API
export COMETAPI_KEY="your-cometapi-key"
$env:COMETAPI_KEY="your-cometapi-key"
Passaggio 2: effettua la prima richiesta Messages
curl https://api.cometapi.com/v1/messages \
  --header "Authorization: Bearer $COMETAPI_KEY" \
  --header "content-type: application/json" \
  --data '{
    "model": "claude-fable-5-1",
    "max_tokens": 2048,
    "messages": [{
      "role": "user",
      "content": "Review this deployment architecture and list the three highest-risk failure modes."
    }]
  }'
Passaggio 3: usa l’SDK Python di Anthropic
pip install anthropic
import os
import anthropic

client = anthropic.Anthropic(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com",
)

response = client.messages.create(
    model="claude-fable-5-1",
    max_tokens=4096,
    messages=[{
        "role": "user",
        "content": "Find the root cause of this test failure and propose a verified patch.",
    }],
)

print(response.content[0].text)
Passaggio 4: usa l’SDK Python di OpenAI
pip install openai
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="claude-fable-5-1",
    messages=[{
        "role": "user",
        "content": "Design a migration plan for this service.",
    }],
)

print(response.choices[0].message.content)
Come funziona il ragionamento dell’API Claude Fable 5.1?
I modelli precedenti non possono leggere i thinking block di Claude Fable 5.1
I thinking block prodotti da Fable 5.1 non sono retrocompatibili con i modelli Claude precedenti. Se un workflow cambia modello a metà conversazione, rimuovi i thinking block incompatibili o inizia un nuovo ramo mantenendo solo i messaggi visibili all’utente e i risultati degli strumenti necessari alla successiva richiesta.
Modificare turn precedenti invalida il thinking preservato
Un thinking block preservato è crittograficamente vincolato allo stato della conversazione che lo precede. Modificare un precedente system prompt, una definizione di strumento, un messaggio dell’utente, una risposta dell’assistente o un risultato di uno strumento può rompere quel vincolo e generare un errore di thinking-history. Mantieni il prefisso riprodotto byte-per-byte stabile e aggiungi nuovi turn invece di riscrivere quelli vecchi.
Thinking preservato tra i turn
Quando il prefisso della conversazione resta invariato, il thinking preservato può portare uno stato di ragionamento utile nei turn successivi. Archivia i thinking block con il loro ordine di messaggi originale, riproducili solo verso un modello compatibile e tratta un edit dello storico come un nuovo ramo di conversazione invece di mutare la trascrizione esistente.
Controllare il ragionamento con l’effort
Inizia i lavori difficili in produzione con effort alto, poi prova impostazioni più basse per i turn di routine e più alte solo dove la qualità dei task accettati migliora abbastanza da giustificare latenza e token aggiuntivi. Poiché l’effort può cambiare tra i turn, una conversazione non ha più bisogno di un singolo livello di ragionamento per tutta la durata.
Fable 5.1 usa il ragionamento adattivo come unico modo di thinking. Inizia con effort high, poi misura impostazioni più basse per il lavoro di routine e xhigh o max solo quando capacità aggiuntive giustificano costo e latenza.
| Effort | Ruolo consigliato | Compromesso |
|---|---|---|
| low | Lavoro di routine, ben specificato | Più veloce ed economico |
| medium | Traffico di produzione bilanciato | Profondità moderata |
| high | Lavoro difficile predefinito | Miglior punto di partenza |
| xhigh | Coding e agenti di lunga durata | Più latenza e token |
| max | Task più difficili ad altissimo valore | Costo e latenza secondari |
response = client.messages.create(
    model="claude-fable-5-1",
    max_tokens=8192,
    output_config={"effort": "high"},
    messages=[{
        "role": "user",
        "content": "Audit this repository migration plan.",
    }],
)
Claude Fable 5.1 API: erogare risposte lunghe in streaming, usare strumenti e cache del prompt
Configura congiuntamente i seguenti controlli: effort di ragionamento, streaming, esecuzione degli strumenti, prompt caching e gestione di salvaguardie e dati conservati. Ognuno influisce su come una richiesta di lunga durata viene osservata, validata e operata.
Erogare risposte lunghe in streaming
Lo streaming è la scelta più sicura per task lunghi e ad alto effort perché evita di aspettare il completamento di una grande risposta prima che l’applicazione riceva output.
with client.messages.stream(
    model="claude-fable-5-1",
    max_tokens=8192,
    output_config={"effort": "high"},
    messages=[{
        "role": "user",
        "content": "Analyze these logs and produce a remediation plan.",
    }],
) as stream:
    for text in stream.text_stream:
        print(text, end="", flush=True)
Usare strumenti senza forzare la scelta dello strumento
Fable 5.1 rifiuta la selezione forzata degli strumenti usando tool_choice di tipo any o uno strumento nominato. Usa la selezione automatica, schemi rigorosi, valida gli argomenti degli strumenti nel codice dell’applicazione e controlla la sequenza obbligatoria del workflow fuori dal modello. Se un workflow richiede l’esecuzione di uno strumento specifico, non fare affidamento su tool_choice per imporre la sequenza. Fai invocare quello strumento dall’applicazione o implementa lo step richiesto nel codice di orchestrazione.
tools = [{
    "name": "search_incidents",
    "description": "Search recent production incidents",
    "input_schema": {
        "type": "object",
        "properties": {
            "service": {"type": "string"},
            "days": {"type": "integer"},
        },
        "required": ["service", "days"],
    },
}]

response = client.messages.create(
    model="claude-fable-5-1",
    max_tokens=4096,
    tools=tools,
    tool_choice={"type": "auto"},
    messages=[{
        "role": "user",
        "content": "Review checkout incidents from the last 30 days.",
    }],
)
Usare la cache del prompt per contesti lunghi
Anthropic indica letture della cache a $0,25 per milione di token, un quarto della tariffa Fable 5. Inserisci istruzioni di sistema stabili, schemi degli strumenti e materiale di riferimento ampio prima del contenuto dinamico dell’utente, poi verifica gli hit della cache nei metadata di usage.
messages = [{
    "role": "user",
    "content": [
        {
            "type": "text",
            "text": large_reference_document,
            "cache_control": {"type": "ephemeral"},
        },
        {
            "type": "text",
            "text": "Identify obligations that changed in this revision.",
        },
    ],
}]
Gestire salvaguardie e conservazione dei dati
Anthropic afferma che molte richieste segnalate in ambito cybersecurity e biologia vengono instradate verso modelli meno capaci. Tratta un rifiuto o un fallback come stato dell’applicazione: registra la stop reason, mostra un messaggio utente appropriato e instrada verso un’alternativa approvata dove la policy lo consente.
Fable inoltre richiede conservazione dei dati di 30 giorni per impostazione predefinita per il monitoraggio della sicurezza. Conferma l’idoneità organizzativa e le impostazioni di retention prima di fare debug di una richiesta sintatticamente valida come se fosse solo un problema di formato API.
Fable 5.1 vs Opus 5 vs Sonnet 5
| Dimensione decisionale | Claude Fable 5.1 | Claude Opus 5 | Claude Sonnet 5 |
|---|---|---|---|
| Contesto / max output | 1M / 128K | 1M / 128K | 1M / 128K |
| Prezzo ufficiale input/output | $10 / $50 | $5 / $25 | $2 / $10 |
| Latenza relativa | Più lenta | Moderata | Veloce |
| Effort predefinito | high | high | high |
| Punti di forza | Massima capacità a lungo orizzonte | Ragionamento generale premium | Equilibrio velocità/costo |
| Miglior ruolo in prod | Escalation di capacità | Lavoro complesso predefinito | Baseline ad alto volume |
Risultato della selezione: avvia il traffico di routine su Sonnet 5, usa Opus 5 per lavoro generale complesso e scala solo i task più difficili o ripetutamente falliti a Fable 5.1. Questo segue la guida di Anthropic e previene che il ragionamento premium diventi il costo predefinito di ogni richiesta.
Prezzi tramite CometAPI
| Route | Input / MTok | Output / MTok | Lettura cache / MTok |
|---|---|---|---|
| Prezzo di listino Anthropic | $10 | $50 | $0,25 |
| Prezzo elencato CometAPI | $8 | $40 | Verifica route live |
| Differenza nominale input/output | 20% in meno | 20% in meno | Varia per route |
La pagina live del modello CometAPI è la fonte di verità per disponibilità e prezzi correnti delle route. Per una richiesta con 100.000 token di input non in cache e 10.000 token di output, la semplice stima CometAPI è $1,20; il costo effettivo può cambiare con caching, ragionamento, comportamento batch e instradamento. I prezzi possono cambiare; verifica la pagina live del modello prima del budgeting in produzione.
Lista di controllo per la migrazione da Fable 5
- Cambia l’ID del modello da claude-fable-5 a claude-fable-5-1.
- Rimuovi forzature di tool_choice any e di strumenti nominati; usa auto.
- Sostituisci vecchie assunzioni di thinking-budget con output_config.effort.
- Inizia la valutazione con effort high, poi ottimizza su task reali.
- Mantieni storici append-only quando contengono thinking block preservati.
- Aumenta max_tokens per esecuzioni lunghe ad alto effort.
- Verifica gli hit di cache dai metadata di usage.
- Gestisci rifiuti e fallback come stati espliciti.
- Riproduci tracce di produzione e confronta tasso di task accettati, latenza e costo.
Strategia di migrazione più sicura: mantieni storici append-only. Fable 5.1 può preservare thinking block tra i turn, ma i block riprodotti sono vincolati allo stato di conversazione precedente; cambiare system prompt, strumenti o messaggi precedenti può invalidare quel vincolo.
Errori API comuni
Errore 400 dopo aver cambiato chiamate di strumenti
Causa probabile: tool_choice forzato usando any o uno strumento nominato. Usa auto e imponi la sequenza richiesta nella logica dell’applicazione.
claude-fable-5.1 non funziona
L’ID canonico usa i trattini: claude-fable-5-1.
L’output termina prima del previsto
effort controlla quanto ragionamento il modello esegue, mentre max_tokens limita il budget di token della risposta. Un effort più alto può richiedere più budget di output, quindi le applicazioni in produzione dovrebbero regolare entrambi indipendentemente. Aumenta max_tokens dove giustificato ed eroga in streaming risposte lunghe.
La prompt cache non va mai in hit
Mantieni il prefisso in cache byte-per-byte stabile; timestamp, strumenti riordinati e system message variabili impediscono il riuso.
Una risposta HTTP di successo non contiene una risposta normale
Ispeziona stop_reason e metadata di fallback invece di trattare ogni rifiuto come un errore di trasporto.
La riproduzione dello storico produce un errore di thinking
Non modificare turn precedenti prima di thinking block preservati di Fable 5.1. Usa storico append-only o i controlli di migrazione attuali.
Come usare la Claude Fable 5.1 API in produzione?
Separa instradamento delle richieste, esecuzione del modello, esecuzione degli strumenti, validazione e valutazione. Registra ID modello, effort, latenza, uso dei token, uso della cache, stop reason, comportamento di fallback e successo finale del task.
Usa Fable 5.1 per migrazioni a livello di repository, debugging difficile, agenti di lunga durata, ricerca profonda, sintesi di grandi documenti e task ad alto valore dove modelli più economici falliscono ripetutamente. Evitalo come default per riassunti, classificazione, estrazione e brevi risposte di customer service.
Esempio: investigare un incidente di checkout
Un team può fornire errori di checkout sanitizzati, diff di deployment recenti e runbook rilevanti. L’applicazione recupera record di incidenti corrispondenti, poi chiede al modello di classificare le possibili cause e collegare ogni ipotesi alle evidenze. Un engineer rivede i passi diagnostici proposti e approva un test in sandbox usando transazioni sintetiche. La soglia di accettazione è comportamento riproducibile, evidenza tracciabile e check di regressione superati; ogni remediation in produzione richiede approvazione umana separata.
Esempio: analizzare cambi ai requisiti operativi
Un team può fornire un manuale operativo approvato, policy di supporto e una bozza revisionata. Mantieni il materiale di riferimento invariato come contesto stabile, poi chiedi al modello di confrontare obblighi cambiati, team responsabili, scadenze ed eccezioni. Ogni riscontro proposto dovrebbe citare i passaggi rilevanti in entrambe le versioni e distinguere cambi espliciti da interpretazioni incerte. La soglia di accettazione è un revisore che conferma ogni cambiamento riportato rispetto alle evidenze citate prima di aggiornare procedure o notificare i team interessati.
Conclusione
Claude Fable 5.1 non è un semplice aggiornamento della stringa del modello. Il comportamento sugli strumenti forzati, le regole dello storico del thinking, i controlli di effort, l’economia della cache e le funzionalità di avanzamento per esecuzioni lunghe richiedono una migrazione deliberata.
Il deployment più efficace usa Claude Sonnet 5 per volume di routine, Claude Opus 5 per traffico complesso predefinito e Claude Fable 5.1 come escalation misurata di capacità. Promuovilo solo quando il completamento dei task accettati migliora abbastanza da giustificare costo totale e latenza.