
Il modo più rapido per usare la GLM-5.3 Flash API è chiamare il modello tramite l’endpoint chat-completions compatibile con OpenAI di CometAPI. I dettagli di connessione sono consolidati nella tabella delle specifiche API qui sotto; conserva la chiave API sul server.
Risposta in breve: crea una chiave CometAPI, installa un SDK compatibile con OpenAI, invia una richiesta POST a /v1/chat/completions, quindi aggiungi streaming, visione, output JSON o tool solo dopo che la richiesta base ha avuto successo.
Che cos’è l’API GLM-5.3 Flash?
GLM-5.3 Flash è il modello multimodale nativo di Z.ai ottimizzato per l’efficienza nella famiglia GLM-5. Espone funzionalità di ragionamento, contesto lungo, comprensione visiva e orientamento agli agenti tramite una chat API. Il modello contiene 320B parametri totali ma ne attiva 18B per token; questa architettura è importante per i costi, ma gli sviluppatori la percepiscono soprattutto come un modello che può restare “attivo” su prompt lunghi e con ripetute chiamate a tool.
Questa guida mantiene volutamente breve la copertura di architettura e benchmark. L’articolo di panoramica del modello spiega già il design di attenzione ibrida, i pesi aperti, la matrice completa di benchmark di lancio, il contesto di prezzo e il confronto tra famiglie di modelli. Qui l’attenzione è sul comportamento d’integrazione e sulle decisioni di produzione.
Specifiche API che influenzano l’integrazione
| Specifica API | Valore | Significato pratico |
|---|---|---|
| Base URL | https://api.cometapi.com/v1 | Configurala una volta nel client lato server. |
| Endpoint | POST /v1/chat/completions | Usa la route chat-completions compatibile con OpenAI. |
| SDK compatibili | Client Python e JavaScript compatibili con OpenAI | Riutilizza pattern di client familiari con la base URL di CometAPI. |
| Autenticazione | Chiave API Bearer | Conserva la chiave in una variabile d’ambiente lato server o in un secret manager. |
| Codice modello | glm-5.3-flash | Usa esattamente questo valore nel body della richiesta. |
| Finestra di contesto | 1.048.576 token | Adatta a grandi repository, pacchetti di documenti e storici lunghi per agenti. |
| Output massimo | Fino a 131.072 token | Imposta un limite inferiore specifico all’app per controllare costi e latenza. |
| Input nativi | Testo, immagine, video, file | Il supporto lato hosting può variare; valida la route CometAPI esatta prima di usare ogni modalità. |
| Output | Testo | Il modello interpreta i media ma non genera direttamente immagini o video. |
| Ragionamento | low, high, max | Usa i livelli di sforzo per bilanciare latenza e token consumati con la profondità. |
| Thinking | Sempre attivo | Non inviare un parametro che cerchi di disabilitare il thinking. |
| Funzioni per dev | Streaming, function calling, caching, output strutturato | Utili per app interattive, agenti e pipeline leggibili dalle macchine. |
Le capacità del modello e quelle del gateway non sono identiche. Considera la pagina del modello live su CometAPI e lo schema dell’API come il contratto per la route che chiami effettivamente, soprattutto per video, file, JSON Schema rigoroso e campi di thinking specifici del provider.
Contesto prestazionale sintetico
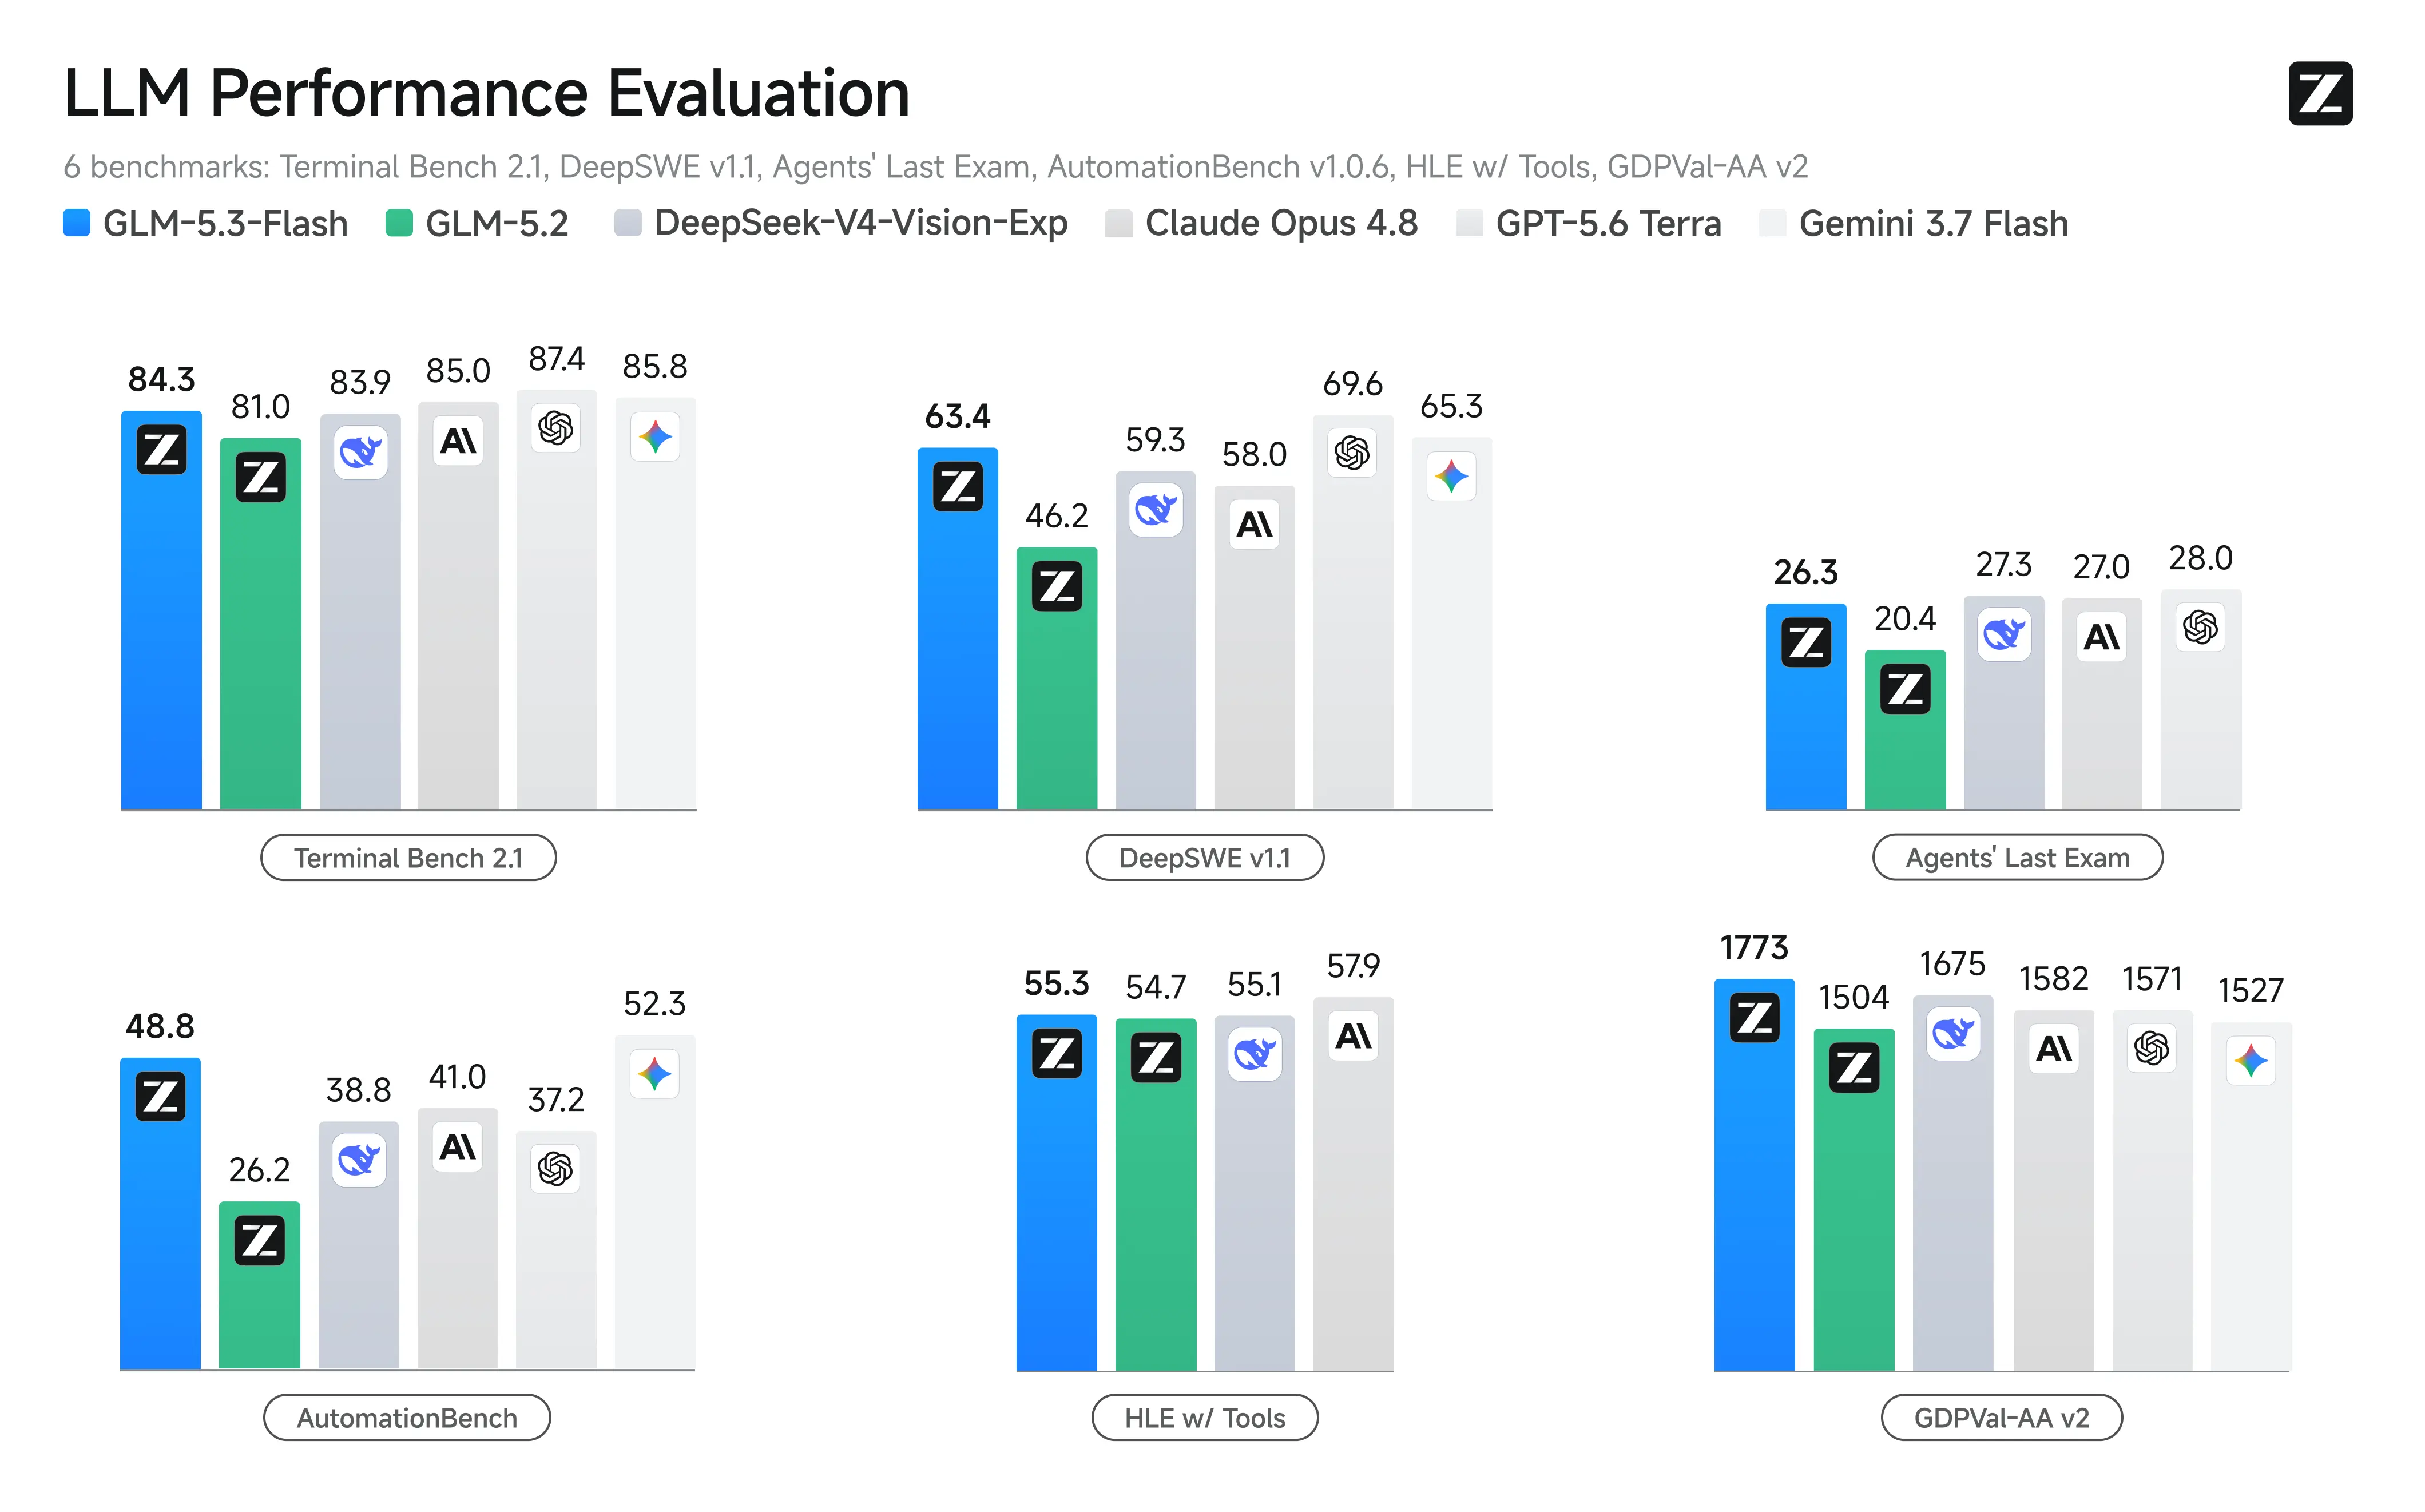
Z.ai riporta ottimi risultati di lancio su task rilevanti per chi costruisce con API: lavoro da terminale, ingegneria del software, uso di tool e automazione. Si tratta di punteggi dichiarati dal vendor, ottenuti con specifici harness e policy sugli strumenti; aiutano a identificare probabili punti di forza più che stabilire una classifica universale.
| Benchmark | GLM-5.3 Flash | Cosa suggerisce per i carichi di lavoro API |
|---|---|---|
| Terminal-Bench 2.1 | 84.3 | Ottimo per agenti di coding guidati da terminale. |
| DeepSWE v1.1 | 63.4 | Promettente per ingegneria su repository su larga scala. |
| Toolathlon Verified | 78.4 | Buon segnale di selezione e uso degli strumenti. |
| AutomationBench | 48.8 | Automazione multi-step migliorata rispetto al predecessore. |
L’implicazione pratica è più limitata della tabella: GLM-5.3 Flash è un candidato forte quando il workflow combina contesto lungo con tool o feedback visivo. Per un confronto completo dei modelli, usa la panoramica del modello esistente invece di duplicarla qui.
Fonte: Grafico ufficiale dei benchmark di Z.ai
Il grafico ufficiale dei benchmark confronta le prestazioni di GLM-5.3 Flash tra modello e impostazioni di sforzo. In questa guida API, offre un contesto conciso senza ripetere l’intera matrice di lancio. Le applicazioni dovrebbero comunque misurare successo del task, latenza end-to-end e uso totale di token sui propri prompt.
Perché usare GLM-5.3 Flash tramite CometAPI?
CometAPI espone GLM-5.3 Flash tramite un’interfaccia compatibile con OpenAI. Questo consente al team di riutilizzare pattern SDK familiari, centralizzare credenziali e fatturazione e cambiare modelli senza ricostruire l’intero layer di richieste.
• Un solo pattern di integrazione. Lo stesso client base può chiamare modelli diversi supportati cambiando l’ID del modello.
• Visibilità centralizzata dei consumi. I team possono rivedere uso e costi senza mantenere una dashboard separata per ogni provider.
• Valutazione più rapida. Un solo harness di richieste può confrontare qualità, latenza ed errori tra modelli candidati.
• Fallback più semplice. Le applicazioni possono mantenere logiche di retry e routing in un unico gateway.
• Prezzo di route più basso. La pagina modello corrente indica $0.06 per milione di token di input e $0.20 per milione di token di output; verifica la pagina live prima del budgeting.
Prima di iniziare
Ti serve un account CometAPI, una chiave API e uno dei seguenti ambienti locali:
• Python 3.9 o successivo con pip
• Node.js 18 o successivo con npm
• cURL per un test minimale da riga di comando
Non inserire mai una chiave CometAPI di produzione in JavaScript lato browser, un’app mobile, un repository pubblico, uno screenshot o i log lato client. Chiama CometAPI da un server fidato e conserva la chiave in una variabile d’ambiente o in un secret manager.
Come usare l’API GLM-5.3 Flash con CometAPI
Step 1: Crea una chiave API CometAPI
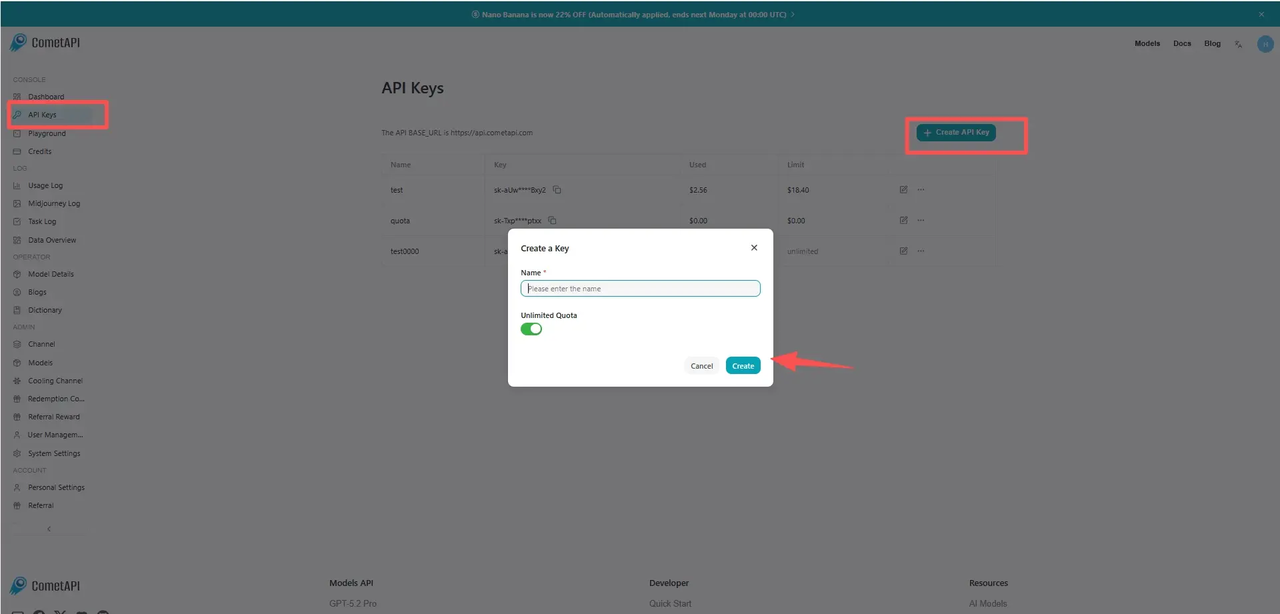
Accedi a CometAPI, apri la console delle chiavi API, crea una chiave e copiala una sola volta nel tuo workflow di gestione dei segreti. Usa chiavi separate per sviluppo e produzione così da poter ruotare o revocare un ambiente senza interrompere l’altro.
Fonte: Immagine guida ufficiale alle chiavi API di CometAPI
Step 2: Archivia la chiave come variabile d’ambiente
$env:COMETAPI_KEY = "your_cometapi_key_here"
export COMETAPI_KEY="your_cometapi_key_here"
In produzione, sostituisci la cronologia della shell con un secret di deployment, un secret del container o un vault gestito.

### Step 3: Installa un SDK compatibile con OpenAI
python -m pip install --upgrade openai
npm install openai
```

### Step 4: Effettua la prima richiesta con cURL

```
curl https://api.cometapi.com/v1/chat/completions \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.3-flash",
    "messages": [
      {
        "role": "system",
        "content": "You are a precise technical assistant."
      },
      {
        "role": "user",
        "content": "Explain three practical uses of a one-million-token context window."
      }
    ],
    "max_completion_tokens": 800
  }'
```

Una risposta positiva contiene un messaggio assistant in choices[0].message.content più i metadati di utilizzo quando la route li restituisce. Inizia con questa piccola richiesta prima di aggiungere parametri opzionali.

### Step 5: Chiama l’API da Python

```
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
    timeout=60.0,
    max_retries=2,
)

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "You are a precise technical assistant.",
        },
        {
            "role": "user",
            "content": "Review this migration plan and list the top five risks.",
        },
    ],
    max_completion_tokens=1200,
)

print(completion.choices[0].message.content)
print(completion.usage)
```

### Step 6: Chiama l’API da JavaScript

```
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: "https://api.cometapi.com/v1",
  timeout: 60_000,
  maxRetries: 2,
});

const completion = await client.chat.completions.create({
  model: "glm-5.3-flash",
  messages: [
    { role: "system", content: "You are a precise technical assistant." },
    { role: "user", content: "Draft a safe rollout checklist for this API." },
  ],
  max_completion_tokens: 1200,
});

console.log(completion.choices[0].message.content);
console.log(completion.usage);
```

## Come controllare lo sforzo di ragionamento

La [documentazione ufficiale del modello](https://docs.z.ai/guides/vlm/glm-5.3-flash) supporta [sforzo di ragionamento low, high e max](https://docs.z.ai/guides/vlm/glm-5.3-flash). Il [thinking resta abilitato](https://docs.z.ai/guides/vlm/glm-5.3-flash); l’impostazione di sforzo cambia quanto budget di ragionamento il modello può usare.

| Sforzo | Carichi di lavoro iniziali consigliati          | Compromesso                                           |
| ------ | ----------------------------------------------- | ----------------------------------------------------- |
| low    | Classificazione, rewriting, estrazione breve    | Latenza e token di output più bassi; meno profondità. |
| high   | Code review, pianificazione, analisi documenti  | Default bilanciato per molti task di produzione.      |
| max    | Debug complesso, agenti con tool, ragionamento difficile | Profondità massima; potenzialmente più latenza e costi. |

```
completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": "Find hidden failure modes in this distributed rollout plan.",
        }
    ],
    max_completion_tokens=1800,
    extra_body={"reasoning_effort": "high"},
)

print(completion.choices[0].message.content)
```

*Se l’SDK installato espone reasoning\_effort come argomento di primo livello, puoi passarlo direttamente. Se la route CometAPI rifiuta un campo specifico del provider, rimuovilo e usa il default della route. Non cercare di disabilitare il thinking.*

## Come eseguire lo streaming delle risposte

Lo streaming è utile per chat, assistenti di coding e analisi lunghe perché consente all’interfaccia di mostrare l’output man mano che arriva. Non riduce il numero totale di token generati, quindi mantieni gli stessi limiti di output e controlli dei costi.

### Streaming in Python

**Python**

```
stream = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {"role": "user", "content": "Create a staged database migration plan."}
    ],
    max_completion_tokens: 1600,
    stream=True,
)

for chunk in stream:
    delta = chunk.choices[0].delta
    if delta.content:
        print(delta.content, end="", flush=True)
print()
```

### Streaming in JavaScript

**JavaScript**

```
const stream = await client.chat.completions.create({
  model: "glm-5.3-flash",
  messages: [
    { role: "user", content: "Create a staged database migration plan." },
  ],
  max_completion_tokens: 1600,
  stream: true,
});

for await (const chunk of stream) {
  const text = chunk.choices[0]?.delta?.content ?? "";
  process.stdout.write(text);
}
```

• **Gestisci la cancellazione.** Interrompi la lettura dello stream quando il client si disconnette e cancella il lavoro a monte quando supportato.

• **Buffer in modo sicuro.** Non assumere che ogni chunk contenga una parola completa, un token JSON o un oggetto di tool-call completo.

• **Registra l’uso finale.** L’uso può apparire solo nell’evento finale o in metadati specifici della route.

## Come inviare immagini

[GLM-5.3 Flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) accetta contenuti visivi tramite blocchi image_url in messages[].content[]. La documentazione ufficiale consiglia un URL dell’immagine raggiungibile o un Data URL Base64. La pagina del modello su CometAPI indica la capacità image-to-text, ma le applicazioni dovrebbero comunque testare formati, dimensioni file e comportamento della route prima della produzione.

### Analizzare un URL di immagine

**Python**

```
completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": "https://example.com/dashboard.png"
                    },
                },
                {
                    "type": "text",
                    "text": (
                        "Review this dashboard. Identify usability issues, "
                        "ambiguous metrics, and possible data-quality risks."
                    ),
                },
            ],
        }
    ],
    max_completion_tokens=1500,
)

print(completion.choices[0].message.content)
```

### Inviare un’immagine locale come Base64

**Python**

```
import base64
import mimetypes
from pathlib import Path

image_path = Path("dashboard.png")
mime_type = mimetypes.guess_type(image_path.name)[0] or "image/png"
encoded = base64.b64encode(image_path.read_bytes()).decode("utf-8")

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": f"data:{mime_type};base64,{encoded}"
                    },
                },
                {
                    "type": "text",
                    "text": "Extract the chart title, axes, and main trend.",
                },
            ],
        }
    ],
    max_completion_tokens=1000,
)

print(completion.choices[0].message.content)
```

• Ritaglia il whitespace irrilevante prima di codificare un’immagine.

• Ridimensiona verso il basso immagini molto più grandi dell’informazione da ispezionare.

• Fai una domanda visiva specifica invece di chiedere una descrizione generica.

• Non presumere che un URL di pagina web pubblico sia un URL diretto di immagine.

• Testa l’ordinamento di immagini multiple perché ogni immagine dovrebbe essere chiaramente referenziata nel prompt.

## Come richiedere JSON strutturato

L’output strutturato è prezioso quando il componente successivo è codice anziché un lettore umano. Usa uno schema stretto, valida il risultato e mantieni un fallback per le route che non espongono un JSON Schema rigoroso nella stessa forma.

**Python**

```
import json

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "Return valid JSON only.",
        },
        {
            "role": "user",
            "content": (
                "Extract equipment, severity, observed symptom, and next action "
                "from this report: Feeder 12 showed repeated zero-sequence current "
                "spikes after rain; inspect insulation and compare adjacent sections."
            ),
        },
    ],
    response_format={"type": "json_object"},
    max_completion_tokens=800,
)

data = json.loads(completion.choices[0].message.content)
required = {"equipment", "severity", "symptom", "next_action"}
missing = required.difference(data)
if missing:
    raise ValueError(f"Missing fields: {sorted(missing)}")

print(data)
```

*La modalità JSON non elimina la necessità di validazione. Verifica campi richiesti, tipi, valori consentiti e lunghezze massime prima di memorizzare il risultato o attivare un altro sistema.*

## Come utilizzare il function calling

Il function calling consente al modello di decidere quando ha bisogno di dati esterni, mentre il codice dell’applicazione resta responsabile di autorizzazione ed esecuzione. Il pattern sicuro è: il modello propone una chiamata a tool, il server la valida, il server esegue il tool e il modello riceve il risultato.

**Python**

```
import json

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "Return valid JSON only.",
        },
        {
            "role": "user",
            "content": (
                "Extract equipment, severity, observed symptom, and next action "
                "from this report: Feeder 12 showed repeated zero-sequence current "
                "spikes after rain; inspect insulation and compare adjacent sections."
            ),
        },
    ],
    response_format={"type": "json_object"},
    max_completion_tokens=800,
)

data = json.loads(completion.choices[0].message.content)
required = {"equipment", "severity", "symptom", "next_action"}
missing = required.difference(data)
if missing:
    raise ValueError(f"Missing fields: {sorted(missing)}")

print(data)
```

• **Valida gli argomenti.** Considera il JSON di tool-call come input non attendibile.

• **Applica l’autorizzazione.** Il modello non decide cosa l’utente corrente è autorizzato a fare.

• **Separa tool di lettura e scrittura.** Richiedi conferma per azioni distruttive o con visibilità esterna.

• **Limita l’inventario di tool.** Esponi solo gli strumenti rilevanti per il workflow corrente.

• **Metti un tetto al loop.** Imposta un massimo di round di tool, token totali, tempo trascorso e costi.

## Parametri API di [GLM-5.3 Flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/)

| Parametro              | Scopo                             | Indicazioni pratiche                                       |
| ---------------------- | --------------------------------- | ---------------------------------------------------------- |
| model                  | Seleziona la route del modello    | Usa glm-5.3-flash.                                         |
| messages               | Conversazione e input multimodale | Mantieni l’ordine dei ruoli; preserva i messaggi di tool richiesti. |
| max\_completion\_tokens| Limita l’output generato          | Imposta per workflow invece di affidarti al massimo del modello. |
| temperature            | Comportamento di campionamento    | La raccomandazione ufficiale è 1.                          |
| top\_p                 | Nucleus sampling                  | La raccomandazione ufficiale è 0,95.                       |
| reasoning\_effort      | Budget di ragionamento            | Usa low, high o max; verifica il supporto della route.     |
| stream                 | Output incrementale               | Usa true per risposte interattive.                         |
| tools                  | Definizioni di funzione           | Mantieni schemi stretti e valida ogni chiamata.            |
| tool\_choice           | Controlla la selezione dei tool   | Inizia con auto a meno che il workflow richieda un tool.   |
| response\_format       | Richiede output machine-readable  | Verifica il supporto e il JSON restituito.                 |

## API Z.ai diretta vs CometAPI

Entrambe le route possono essere appropriate. La decisione riguarda soprattutto la proprietà dell’integrazione, l’ampiezza dei modelli, la fatturazione e la rapidità con cui l’applicazione necessita di funzionalità native del provider.

| Dimensione       | API Z.ai diretta                              | CometAPI                                            | Risultato pratico                                               |
| ---------------- | --------------------------------------------- | --------------------------------------------------- | --------------------------------------------------------------- |
| Account e chiave | Account e chiave Z.ai                         | Account e chiave CometAPI                           | Le chiavi non sono intercambiabili.                             |
| Pattern SDK      | Compatibile con OpenAI                        | Compatibile con OpenAI                              | Gran parte del codice client è riutilizzabile.                  |
| Copertura modelli| Famiglia di modelli Z.ai                      | Più provider e famiglie di modelli                  | CometAPI è utile per routing e confronto.                       |
| Funzionalità native | Accesso precoce a comportamenti specifici del provider | Dipende dall’esposizione del gateway e dal pass-through | Testa i campi avanzati sulla route selezionata.             |
| Fatturazione     | Specifica del provider                        | Centralizzata tra i modelli supportati              | La fatturazione unificata semplifica operazioni multi-modello.  |
| Design di fallback | Richiede integrazione con un altro provider | Può rimanere nello stesso layer di gateway          | CometAPI può ridurre l’attrito nel cambio modello.              |
| Miglior scelta   | Forte impegno sulle capacità native Z.ai      | Accesso unificato, valutazione e routing di produzione | Scegli in base all’architettura del sistema, non a un vincitore generico. |

Usa l’API diretta quando il parametro o la feature native del provider più recenti sono essenziali. Usa CometAPI quando contano un solo client, fatturazione unificata e la possibilità di confrontare o sostituire modelli. In produzione, esegui la stessa suite di test rappresentativa sulla route esatta che intendi distribuire.

## Stima dei costi e budgeting dei token

La [pagina del modello CometAPI](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) attuale indica [$0.06 per milione di token di input](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) e [$0.20 per milione di token di output](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/). A tali tariffe, il costo stimato della richiesta è:

costo = input_tokens / 1,000,000 x 0.06 + output_tokens / 1,000,000 x 0.20

| Carico di lavoro         | Token input | Token output | Costo stimato |
| ------------------------ | ----------- | ------------ | ------------- |
| Domanda breve            | 2,000       | 400          | $0.00020      |
| Code review              | 50,000      | 4,000        | $0.00380      |
| Analisi di documenti ampia | 250,000   | 10,000       | $0.01700      |
| Esecuzione agente lunga  | 800,000     | 30,000       | $0.05400      |

*I prezzi variano nel tempo. Conferma le tariffe live per input, input in cache e output prima della pubblicazione o del budgeting di produzione. Ragionamento e loop di tool possono aumentare l’output fatturato e ripetere l’input; stima i workflow completi invece di una singola risposta visibile.*

## Best practice di produzione per l’API GLM-5.3 Flash

### Controlli di costo e latenza

#### **Limiti di output**

Le impostazioni di generazione nei benchmark e i limiti API in produzione sono differenti. La valutazione HLE citata ha usato una lunghezza massima di generazione di 163.840 token, mentre alcune valutazioni hanno usato output da 64K; nessuna delle due prove dimostra che ogni route ospitata possa restituire più di 100.000 token. Imposta il limite in base allo schema live della route e al budget del workflow. Usa limiti piccoli per classificazione ed estrazione, medi per analisi e più grandi solo per compiti di long-form o agenti.

**Controllo del contesto**

Una finestra da un milione di token è una capacità, non un obiettivo. Recupera i file pertinenti, rimuovi log duplicati, posiziona istruzioni stabili all’inizio e misura se ulteriore contesto migliora il successo del task.

### Stato e affidabilità

#### **Preservare lo stato**

Memorizza i messaggi assistant completi necessari al turno successivo, incluse le chiamate a tool e i campi specifici della route che la tua applicazione ha verificato. Omettere lo storico strutturato può interrompere un loop multi-step di tool anche quando il testo visibile sembra completo.

#### Ritentare in modo selettivo

• Ritenta errori transitori 429, 500, 502, 503 e timeout di rete con backoff esponenziale e jitter.

• Non ritentare alla cieca errori di autenticazione, parametri non validi o richieste oversize.

• Allega un ID di richiesta dell’applicazione per riconoscere lavori duplicati.

• Usa controlli di idempotenza attorno alle operazioni di scrittura esterne, anche se la richiesta al modello viene ritentata.

### Sicurezza e convalida

#### **Convalidare l’output leggibile dalla macchina**

La validazione dello schema, i controlli sui valori consentiti, i limiti di lunghezza e le regole di dominio devono stare tra il modello e ogni database, coda o API esterna. Un JSON sintatticamente valido può essere comunque incompleto o non sicuro.

#### **Autorizzare le chiamate agli strumenti**

Considera le chiamate a tool proposte dal modello come richieste non attendibili: valida gli argomenti, applica l’autorizzazione utente, separa operazioni di lettura e scrittura e richiedi conferma per azioni distruttive.

### Osservabilità e fallback

#### **Misurare il flusso di lavoro**

• Tasso di successo del task o tasso di accettazione umana

• Tempo al primo token e latenza totale

• Token di input, input in cache, ragionamento e output

• Numero di tool-call e tasso di fallimento dei tool

• Retry, rate limit ed errori del provider

• Costo per task completato, non solo costo per singola chiamata API

#### **Progettare il fallback**

Scegli un fallback in base al carico di lavoro, non alla reputazione. Un fallback solo testo può andare bene per l’estrazione da documenti ma fallire in un task basato su screenshot. Definisci quali input e schemi di tool sono portabili, quali parametri devono essere rimossi e quando l’utente dovrebbe vedere un errore recuperabile invece di uno switch automatico del modello.

## Errori comuni e risoluzione dei problemi

| Sintomo                | Causa probabile                                                    | Cosa verificare                                                                  |
| ---------------------- | ------------------------------------------------------------------ | -------------------------------------------------------------------------------- |
| 401 Unauthorized       | Chiave mancante, malformata o revocata                             | Conferma l’header Authorization e la variabile d’ambiente lato server.           |
| 404 o modello non trovato | ID modello errato o route non disponibile                      | Usa glm-5.3-flash e conferma la disponibilità sulla pagina del modello live.     |
| 429 Rate Limit         | Quota di richieste o token superata                                | Riduci il ritmo, diminuisci la concorrenza, controlla i limiti dell’account e ritenta con jitter. |
| Parametro non supportato | Campo nativo del provider non esposto dal gateway               | Rimuovi i campi opzionali, poi riaggiungili uno alla volta.                      |
| Limite di contesto superato | Prompt più output richiesto supera il limite della route     | Riduci, recupera in modo mirato, riassumi o abbassa max\_completion\_tokens.     |
| Immagine non valida    | URL inaccessibile, formato non supportato o Base64 errata          | Prova un URL diretto HTTPS dell’immagine e correggi il prefisso MIME.            |
| JSON in streaming rotto | I chunk sono stati analizzati come oggetti completi               | Effettua il buffering e analizza solo dopo aver ricevuto il payload JSON completo. |
| Loop di tool infinito  | Nessun budget di step o risultati dei tool ambigui                 | Limita i round, migliora le descrizioni dei tool e restituisci errori espliciti dei tool. |

## Quando dovresti usare l’API GLM-5.3 Flash?

### Casi d’uso adatti

• Comprensione del codice a livello di repository e review multi-file

• Coding visivo, analisi di screenshot e QA dell’interfaccia

• Pacchetti di documenti lunghi e sintesi con evidenze

• Agenti che usano tool con pianificazione e verifica ripetute

• Workflow ad alto volume in cui il costo dei token incide sull’economia unitaria

• Applicazioni che beneficiano del confronto o dello switch tra modelli tramite un solo gateway

### Usa un’altra route o un altro modello quando

• Il prodotto necessita di output immagine o video invece di output testuale.

• Il task è una classificazione piccola e a basso rischio che un modello più leggero gestisce in modo affidabile.

• Una feature nativa del provider è obbligatoria ma non esposta sulla route del gateway.

• Il workflow non può tollerare il thinking sempre attivo o la sua latenza associata.

• L’applicazione non è stata ancora testata con i propri tool, dati e casi di errore.

## FAQ

###

### Cosa dovrei verificare sulla route CometAPI esatta prima del lancio?

Verifica disponibilità del modello, formati multimodali accettati, output massimo, campi di ragionamento, comportamento dell’output strutturato, rate limit e prezzi correnti con richieste rappresentative.

### Quali metriche dovrebbe tracciare una valutazione di produzione?

Traccia successo del task, tempo al primo token, latenza totale, token di input e output, errori di tool-call, tasso di retry e costo per workflow completato, non solo il costo per chiamata API.

### Come dovrei scegliere tra Z.ai diretto e CometAPI?

Usa Z.ai diretto quando l’accesso immediato al comportamento nativo del provider è essenziale. Usa CometAPI quando sono più importanti autenticazione unificata, fatturazione, confronto tra modelli e fallback a livello di gateway.

### Cosa rende sicuro un fallback?

Un fallback sicuro accetta la stessa modalità di input, preserva gli schemi di tool richiesti, rimuove i parametri non supportati, resta entro i limiti di autorizzazione del task e fallisce in modo visibile quando il comportamento non può essere preservato.

## Conclusione

[GLM-5.3 Flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) è più utile tramite API quando contesto lungo, input visivo, ragionamento e uso di tool fanno parte dello stesso workflow. L’integrazione base con CometAPI è minima: una chiave lato server, un client compatibile con OpenAI, l’ID modello [glm-5.3-flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) e l’endpoint chat-completions. La qualità in produzione arriva da tutto ciò che circonda quella richiesta: prompt a portata, limiti di output, validazione dello schema, autorizzazione dei tool, retry, osservabilità e valutazione specifica per il carico di lavoro.

Inizia con una chiamata testuale breve, aggiungi una capacità avanzata per volta e testa l’intero percorso utente prima di scalare. Conferma la pagina modello live di [GLM-5.3 Flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) per disponibilità attuale, comportamento della route supportata e prezzi.

## Metadati SEO

**Meta title:** Come usare l’API GLM-5.3 Flash: guida per sviluppatori

**Meta description:** Scopri come usare l’API GLM-5.3 Flash con CometAPI, con esempi in Python e JavaScript, visione, streaming, tool, output JSON e best practice.

**Keywords:** GLM-5.3 Flash API, come usare GLM-5.3 Flash, GLM-5.3 Flash Python, GLM-5.3 Flash JavaScript, GLM-5.3 Flash CometAPI, tutorial API GLM, API multimodale, API di ragionamento, function calling

**URL slug:** how-to-use-glm-5-3-flash-api