Crea con CometAPITi serve una sola API per più modelli?Testa il flusso di lavoro in Playground, poi crea una chiave API quando modello e costo sono adatti al tuo caso d'uso.
Prezzi dell'API Kimi K2 2026: Costi di K2.7, Batch e WebSearch
I don’t have access to Kimi’s latest price sheets for K2.7/K2.6/K2.5, so to avoid guessing, here’s a precise comparison framework and cost formulas you can plug numbers into. If you paste the current pricing (or a link), I’ll fill this in side‑by‑side.
What to capture per model (K2.7, K2.6, K2.5)
- Base API
- Input price ($/M tokens)
- Output price ($/M tokens)
- Context window and rate limits (for capacity planning)
- Cache
- Cache write price ($/M cached tokens) or same as input
- Cache read price ($/M tokens) or discount vs base input (%)
- Whether cache applies to input only; cache retention rules
- Batch
- Eligible endpoints and max batch size
- Discount style: flat % off, tiered by batch size, or separate “batch” price
- WebSearch
- Per‑query fee (if any)
- Token billing for retrieved content (input) and model output
- Caps or included queries per request/job
- CometAPI (or aggregator layer)
- Surcharge: % markup on underlying usage and/or per‑request fee
- Minimums per call or monthly platform fees
- Coding‑agent reality check
- Typical step loop count per task
- Tool use per step (WebSearch calls, code runs)
- Average plan/reflect tokens per step
- External tool costs, if any
Cost formulas (drop in your numbers)
1) Core generation cost (no cache)
- Cost_core = (Tokens_in × Price_in) + (Tokens_out × Price_out)
2) With cache (assumes cache applies to input only)
- Let h = cache hit rate on input (0–1)
- If cache read has its own price: Cost_input = (1−h)×Tokens_in×Price_in + h×Tokens_in×Price_cache_read
- If cache read is a discount d on input: Cost_input = Tokens_in×Price_in×(1 − d×h)
- Total with cache: Cost_core_cached = Cost_input + (Tokens_out × Price_out)
3) Batch discount
- If a flat discount d_batch applies: Cost_batch = Cost_core_cached × (1 − d_batch)
- If batch uses a separate “batch price,” replace Price_in/Price_out in (2) with batch rates
4) WebSearch fees
- Let w = number of WebSearch queries; Fee_search = per‑query fee
- Cost_websearch = (w × Fee_search) + (WS_tokens_in × Price_in) + (WS_tokens_out × Price_out)
- Total with WebSearch: Cost_total_ws = Cost_batch + Cost_websearch
5) CometAPI surcharge
- If markup m (e.g., 10%) plus per‑request fee f_comet:
- Cost_comet = (Cost_total_ws × (1 + m)) + (n_requests × f_comet)
6) “Real” coding‑agent cost (multi‑step tool‑using loop)
- Let m_steps = number of agent iterations
- Per step:
- Plan tokens: T_plan_in, T_plan_out
- Tool calls: k_tool per step; each with fees (e.g., WebSearch or code‑run)
- Agent token cost:
- Cost_agent_tokens = Σ over steps [ (T_plan_in × Price_in) + (T_plan_out × Price_out) ]
- Tool costs:
- Cost_tools = Σ over all tool calls [ per‑call fee + token costs of tool I/O (if billed) ]
- Plus any cache/batch effects applied to the above
- Total agent cost per task:
- Cost_agent_total = (Cost_agent_tokens with cache/batch) + (Cost_tools with cache/batch) ± CometAPI surcharge
Comparison checklist (fill for K2.7/K2.6/K2.5)
- Base input/output $/M tokens:
- Cache read/write $/M and rules; expected hit rate h for your workload:
- Batch discount or batch‑specific prices; effective savings at your batch size:
- WebSearch per‑query fee and token adds:
- CometAPI surcharge/fees:
- Estimated agent loop profile (steps, WebSearch per step, tokens per plan/reflect):
- Resulting blended $/1k requests or $/task under your traffic mix:
If you share the current Kimi/K2.x price points (input/output, cache, batch, WebSearch, CometAPI), your typical token volumes, cache hit rate, batch sizes, and agent loop profile, I’ll compute:
- Effective $/M tokens for each model with cache and batch
- All‑in per‑request and per‑task costs (with WebSearch and CometAPI)
- Side‑by‑side totals and % deltas between K2.7, K2.6, and K2.5 under your workload assumptions
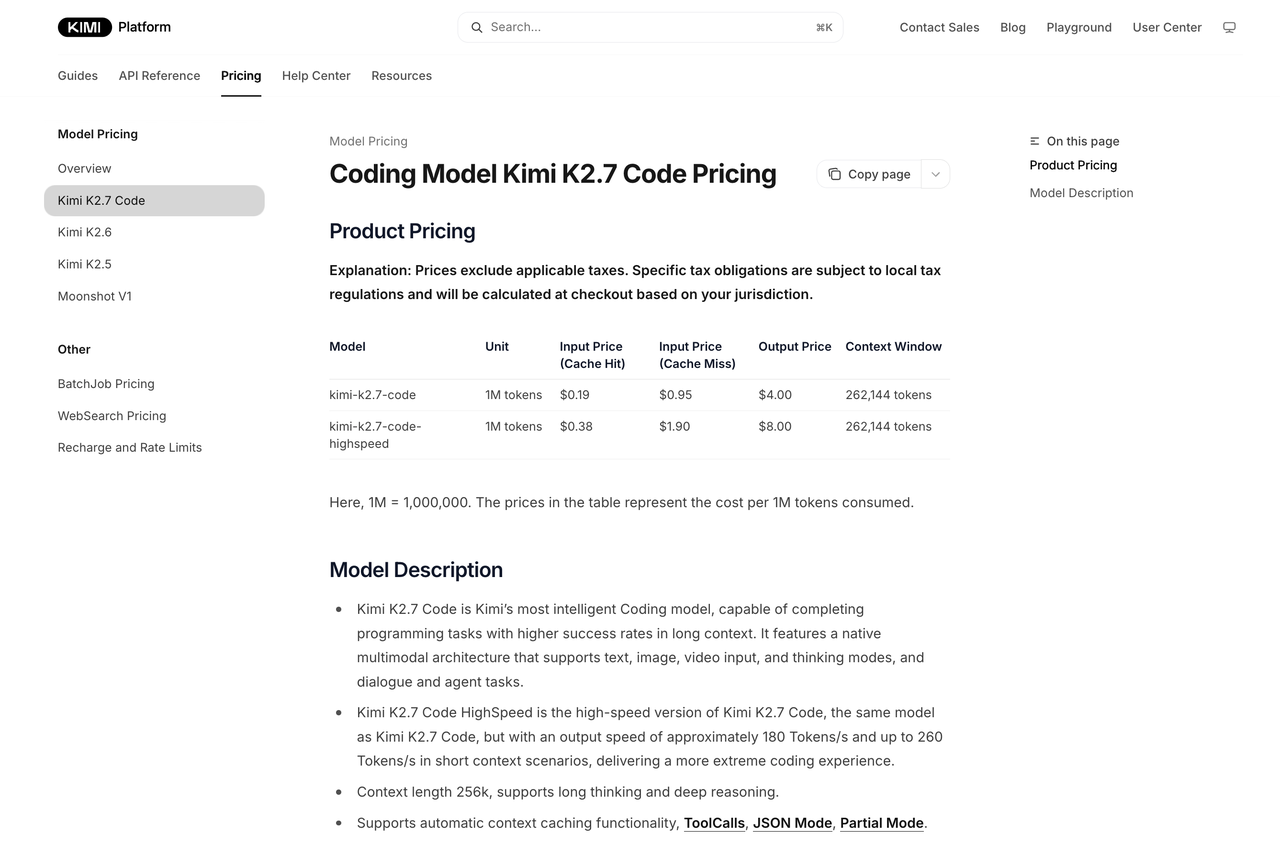
TLDR Moonshot AI attualmente prezza Kimi K2.7 Code a $0.19 per 1M token di input cache-hit, $0.95 per 1M token di input cache-miss e $4.00 per 1M token di output. Kimi K2.7 Code HighSpeed raddoppia tali tariffe a $0.38 / $1.90 / $8.00.
Le principali considerazioni sui costi sono:
Caching: l’input cache-hit di K2.7 di Moonshot costa l’80% in meno rispetto all’input cache-miss.
HighSpeed: il percorso più veloce costa il doppio a livello di token.
i modelli supportati costano il 60% delle tariffe in tempo reale, pari a un risparmio del 40%.
Revisionato per chiarezza, attribuzione delle fonti e terminologia API aggiornata.
Usa questo riepilogo per una risposta rapida, poi leggi la guida per contesto, esempi e dettagli di implementazione.
Batch API:
WebSearch: Moonshot addebita $0.005 per ogni chiamata di ricerca integrata andata a buon fine, oltre ai token usati per elaborare i risultati della ricerca.
Compatibility: K2.7 Code richiede la modalità Thinking, mentre la WebSearch integrata di Moonshot richiede che Thinking sia disattivata.
Per gli agenti di coding, la metrica più utile non è il prezzo per milione di token. È il costo per attività completata, includendo ragionamento, cache, retry, chiamate agli strumenti, latenza e correzioni umane.
I prezzi di K2.7 di Moonshot sono attualmente promozionali. Moonshot e CometAPI utilizzano inoltre strutture di fatturazione dell’input diverse, pertanto le tariffe riportate non sono direttamente interscambiabili.
Moonshot Kimi K2 Pricing Explained
K2.7 Code e K2.6 condividono gli stessi prezzi per l’input cache-miss e per l’output. Le principali differenze a livello di token sono che K2.7 Code addebita leggermente di più per l’input in cache, mentre HighSpeed raddoppia tutte le tariffe di K2.7.
Model
Best suited to
kimi-k2.7-code
Agenti di coding, modifiche a repository e attività ingegneristiche di lungo periodo
kimi-k2.7-code-highspeed
Coding interattivo in cui una latenza inferiore ha un valore misurabile
kimi-k2.6
Ragionamento multimodale generale, agenti e WebSearch integrata
kimi-k2.5
Carichi generali e multimodali a costo inferiore
Moonshot descrive HighSpeed come lo stesso modello K2.7 Code sottostante servito tramite un percorso più veloce. La velocità di output documentata è di circa 180 token al secondo, fino a 260 token al secondo in scenari con contesto più corto. La capacità può fluttuare mentre Moonshot espande le risorse.
HighSpeed è quindi principalmente una scelta di latenza e non un diverso livello di qualità del modello.
A Moonshot Direct API Alternative: CometAPI
Gli sviluppatori possono accedere a Kimi K2.7 Code direttamente tramite Moonshot AI oppure tramite l’API compatibile con OpenAI di CometAPI.
Access route
Standard input
Cached input
Output
Moonshot direct API
$0.95 / 1M cache miss
$0.19 / 1M
$4.00 / 1M
CometAPI
$0.76 / 1M
Non indicato separatamente
Circa $3.20 / 1M
Le tariffe di input standard e di output riportate da CometAPI sono circa più basse del 20%, mentre Moonshot può essere più conveniente per carichi con un’elevata percentuale di cache-hit.
Scegli CometAPI se vuoi un’unica API per Kimi e altri provider di modelli. Scegli l’accesso diretto a Moonshot se il tuo workflow riutilizza spesso gli stessi prompt o il contesto del repository.
Alle tariffe attualmente indicate, CometAPI è circa più economico del 20% rispetto ai prezzi di Moonshot per input cache-miss e output.
Tuttavia, CometAPI non mostra un prezzo separato per i cache-hit sulla pagina del modello K2.7. Il prezzo di input standard di $0.76 non deve essere confrontato direttamente con la tariffa di $0.19 per l’input in cache di Moonshot.
I team che riutilizzano ripetutamente lunghi system prompt, definizioni di tool o contesto di repository dovrebbero testare entrambi i percorsi utilizzando il traffico reale. Un carico con un altissimo tasso di cache-hit può produrre un risultato diverso rispetto a uno che invia per lo più nuovo contesto.
Kimi fattura i token di input come cache hit o cache miss.
I cache miss includono generalmente contenuti nuovi o modificati, come:
nuovi file del repository
istruzioni aggiornate
risultati di tool recenti
cronologia della conversazione variata
I cache hit possono includere contenuti ripetuti, come system prompt stabili, schemi dei tool, convenzioni di coding e contesto del repository invariato.
Per K2.7 Code, l’input in cache costa $0.19 per 1M token rispetto a $0.95 per l’input non in cache. Ciò rende un token cache-hit più economico dell’80%.
Calcolare gli stessi 1M token interamente alla tariffa cache-miss costerebbe $0.95. In questo esempio, il profilo di cache misto riduce il costo di input di $0.608.
Ecco perché le dashboard di produzione dovrebbero registrare separatamente i token cache-hit e cache-miss invece di riportare solo il totale dell’input.
Kimi Batch API Pricing
La Batch API di Moonshot addebita il 60% del prezzo del modello in tempo reale, offrendo ai team un risparmio del 40% per i carichi asincroni supportati. La documentazione attuale elenca K2.7 Code, K2.6 e K2.5 come modelli Batch supportati.
Batch model
Cache-hit input
Cache-miss input
Output
kimi-k2.7-code
$0.114 / 1M
$0.57 / 1M
$2.40 / 1M
kimi-k2.6
$0.096 / 1M
$0.57 / 1M
$2.40 / 1M
kimi-k2.5
$0.06 / 1M
$0.36 / 1M
$1.80 / 1M
La Batch API è adatta per:
analisi del codice a livello di repository
ampie esecuzioni di valutazione
classificazione offline
arricchimento notturno
generazione di test sintetici
analisi di migrazione
backlog di security review
È meno adatta per assistenti IDE, chat in tempo reale e altri workflow in cui l’utente attende una risposta immediata.
Per l’elaborazione in background, il risparmio del 40% può essere più prezioso che passare a un modello più economico con un tasso di completamento attività inferiore.
Kimi WebSearch Pricing and Compatibility
Moonshot addebita $0.005 per ogni chiamata$web_searchintegrata andata a buon fine. Non viene addebitata alcuna tariffa separata per lo strumento quando il modello termina senza attivare la ricerca.
Il contenuto dei risultati di ricerca può anche essere aggiunto alla successiva richiesta al modello e fatturato come token di input. Moonshot definisce così il calcolo dei token risultante:
Un workflow di ricerca completo può quindi includere:
Initial model request
+ WebSearch tool fee
+ search-result input tokens
+ follow-up model request
+ retries
C’è anche una limitazione importante del modello. La WebSearch integrata di Moonshot richiede che Thinking sia disattivata, mentre K2.7 Code non supporta la modalità senza Thinking. L’esempio ufficiale di WebSearch usa quindi K2.6 con Thinking disattivata.
Per la ricerca integrata di Moonshot, usa K2.6 o K2.5 con Thinking disattivata.
Un agente di coding K2.7 può comunque chiamare un servizio di ricerca implementato in modo indipendente tramite il normale function calling. In tal caso, il prezzo della ricerca è determinato dal provider esterno anziché dalla tariffa integrata di $0.005 di Moonshot.
Example 1: K2.7 Code Cost for a Coding Task
Supponiamo che un workflow di agente di coding utilizzi:
30,000 token di input cache-miss
8,000 token di output, incluso il ragionamento
nessuna chiamata a WebSearch integrata
K2.7 Code standard
Component
Calculation
Cost
Input
30,000 ÷ 1M × $0.95
$0.03
Output
8,000 ÷ 1M × $4.00
$0.03
Total
$0.06
K2.7 Code HighSpeed
Component
Calculation
Cost
Input
30,000 ÷ 1M × $1.90
$0.06
Output
8,000 ÷ 1M × $8.00
$0.06
Total
$0.12
A parità di utilizzo di token, HighSpeed costa esattamente il doppio.
CometAPI K2.7 Code
Usando le tariffe correnti di CometAPI:
Component
Calculation
Cost
Input
30,000 ÷ 1M × $0.76
$0.02
Output
8,000 ÷ 1M × $3.19998
Circa $0.0256
Total
Circa $0.0484
Ciò è approssimativamente inferiore del 20% rispetto al costo di $0.0605 dei token cache-miss di Moonshot in questo esempio. Il calcolo esclude tasse, strumenti esterni e altri servizi di piattaforma.
Example 2: K2.6 With Built-In WebSearch
Supponiamo che un workflow K2.6 con Thinking disattivata utilizzi:
30,000 token di input cache-miss nell’intero workflow
8,000 token di output
una chiamata a WebSearch integrata andata a buon fine
I 30,000 token di input includono il contenuto dei risultati di ricerca incluso nella richiesta di follow-up.
Component
Calculation
Cost
Input
30,000 ÷ 1M × $0.95
0.0285
Output
8,000 ÷ 1M × $4.00
0.0320
WebSearch
1 × $0.005
0.0050
Total
0.0655
In questo esempio, la tariffa diretta di WebSearch rappresenta circa il 7.6% del totale. In workflow di ricerca più lunghi, i token aggiunti dai risultati di ricerca possono costare più della chiamata allo strumento stessa.
Engineering Details That Can Change the Final Bill
K2.7 Code restituisce un errore se Thinking è disattivata. Il ragionamento viene restituito tramite reasoning_content e sia il ragionamento sia la risposta visibile contribuiscono al consumo di token.
Durante chiamate a tool multi-step, le applicazioni devono preservare il reasoning_content dell’assistente nel contesto della conversazione. Loop di agenti più lunghi possono quindi aumentare sia l’uso di output attuale sia l’uso di input successivo.
max_tokens è un limite, non un addebito fisso
Il parametro max_tokens definisce la quantità massima che il modello può generare. Un’impostazione più alta dà al modello spazio sufficiente per completare il ragionamento e la risposta, ma l’intera franchigia non viene addebitata automaticamente.
I costi si basano sui token effettivamente elaborati e generati.
Diversi parametri di richiesta sono fissi
K2.7 Code richiede valori fissi per diversi parametri:
Parameter
Required value
temperature
1
top_p
0.95
n
1
presence_penalty
0
frequency_penalty
0
Passare un altro valore può restituire un errore. Le applicazioni che utilizzano lo stesso wrapper compatibile con OpenAI su più provider dovrebbero verificare i default hardcoded prima di cambiare modello.
La documentazione ufficiale dei prezzi spiega come il modello viene fatturato. L’adozione esterna fornisce ulteriore contesto su dove viene utilizzato e come gli sviluppatori lo stanno valutando.
GitHub Copilot
GitHub ha reso Kimi K2.7 Code generalmente disponibile in Copilot il 1° luglio 2026, descrivendolo come il primo modello open-weight offerto nel selettore di modelli di Copilot. La disponibilità copriva inizialmente i piani individuali ed è stata estesa ai piani Business ed Enterprise il 7 luglio.
L’adozione da parte di GitHub è un utile segnale di distribuzione, ma non dimostra che K2.7 supererà altri modelli in ogni carico di lavoro di coding.
Moonshot pubblica Kimi K2.7 Code su Hugging Face con una licenza MIT modificata. La scheda del modello descrive un’architettura mixture-of-experts con 1 trilione di parametri e 32 miliardi di parametri attivati e una finestra di contesto da 256K. Include anche istruzioni di deployment per framework come Transformers, vLLM e SGLang.
Moonshot riporta circa il 30% in meno di utilizzo di thinking-token rispetto a K2.6 e un miglioramento del 10% nella capacità agentica. Si tratta di risultati riportati dal vendor e dovrebbero essere convalidati con carichi indipendenti.
Le discussioni su Hacker News sono più variegate rispetto ai materiali di lancio. Alcuni sviluppatori si concentrano sulla disponibilità open-weight di Kimi, sull’efficienza dei token e sull’integrazione con strumenti per agenti di coding. Altri sostengono che un prezzo per token più basso non garantisce un costo di progetto inferiore se il modello richiede più retry, supervisione o contesto.
Questo dibattito supporta la raccomandazione centrale di questa guida: confronta i modelli usando repository reali e misura completamento del compito, retry e modifiche umane—non solo le tariffe pubblicizzate per i token.
DeepSeek V4 Pro attualmente elenca una finestra di contesto da 1M con input cache-hit a $0.003625, input cache-miss a $0.435 e output a $0.87 per milione di token.
La tariffa introduttiva di Claude Sonnet 5 è $2 per milione di token di input, $0.20 per milione di token letti da cache e $10 per milione di token di output fino al 31 agosto 2026. Le scritture in cache hanno un prezzo separato, e Anthropic nota che il tokenizer più recente del modello può produrre più token per lo stesso testo rispetto ai modelli Claude precedenti.
La tariffa standard a contesto corto di GPT-5.6 Sol è $5 per milione di token di input, $0.50 per milione di token di input in cache e $30 per milione di token di output. OpenAI elenca anche tariffe separate per scritture in cache, contesto lungo, Batch, Flex e Priority.
Alle tariffe indicate, Kimi K2.7 Code è meno costoso di Claude Sonnet 5 e GPT-5.6 Sol, mentre DeepSeek V4 Pro è più economico. Ciò non stabilisce quale modello offra il costo più basso per uno specifico workflow di coding.
Which Kimi Model Should You Use?
Workload
Recommended starting point
Modifiche al repository e lunghe attività di coding
kimi-k2.7-code
Coding interattivo in cui la latenza conta
kimi-k2.7-code-highspeed
Ragionamento multimodale generale e agenti
kimi-k2.6
WebSearch integrata di Moonshot
kimi-k2.6 o kimi-k2.5 con Thinking disattivata
Carichi generali a costo più basso
kimi-k2.5
Valutazioni offline ed elaborazione in bulk
Batch API
K2.7 Code è il punto di partenza naturale per lavori di coding sensibili alla qualità. HighSpeed vale un test quando risposte più rapide migliorano l’esperienza degli sviluppatori, la conversione o la produttività.
K2.6 è più flessibile per workflow multimodali generali e basati su ricerca, mentre K2.5 ha le tariffe standard per token più basse di Kimi.
How to Evaluate the Real Cost
Costruisci un set di valutazione a partire da task di produzione invece di fare affidamento solo su benchmark pubblici.
Casi di test utili includono:
implementazione di feature a livello di repository
revisione di pull request
debugging e generazione di test
analisi del codice a lungo contesto
chiamate a tool multi-step
supporto sviluppatori basato su ricerca
Traccia:
completamento con successo delle attività
rapporto di cache-hit
token di input e output
volume di token di ragionamento
successo delle chiamate a tool
numero di retry
latenza p50 e p95
correzioni umane
costo totale del workflow
Calcola:
Cost per completed task =
total workflow cost ÷ successfully completed tasks
Ad esempio, se un team spende $10 e completa con successo 80 attività:
Cost per completed task = $10 ÷ 80 = $0.125
Un modello con token più economici può comunque costare di più se richiede tentativi ripetuti, ragionamenti più lunghi o ampie correzioni manuali.
Per esempi di routing, fallback e valutazione, esplora il CometAPI Cookbook.
Frequently Asked Questions
Quanto costa Kimi K2.7 Code?
Moonshot attualmente indica K2.7 Code a:
$0.19 per 1M token di input cache-hit
$0.95 per 1M token di input cache-miss
$4.00 per 1M token di output
Le tariffe sono contrassegnate come prezzi promozionali a tempo limitato.
Quanto costa K2.7 Code tramite CometAPI?
CometAPI attualmente indica K2.7 Code a $0.76 per 1M token di input e $3.19998 per 1M token di output.
Non è mostrata una tariffa separata per i cache-hit.
La Kimi Batch API riduce i costi e supporta K2.7 Code?
Sì. L’inferenza Batch costa il 60% del prezzo in tempo reale, pari a un risparmio del 40%.
La documentazione Batch attuale di Moonshot elenca K2.7 Code, K2.6 e K2.5 come modelli supportati.
Quanto costa Kimi WebSearch?
La $web_search integrata di Moonshot costa $0.005 per ogni chiamata andata a buon fine.
Il contenuto dei risultati di ricerca può anche essere fatturato come token di input quando incluso nella richiesta successiva al modello.
È possibile disattivare Thinking su K2.7 Code?
No. Le richieste che disattivano Thinking restituiscono un errore.
Kimi è compatibile con OpenAI?
Sì. Moonshot documenta la compatibilità con il formato API di OpenAI, sebbene restrizioni specifiche del modello si applichino comunque a Thinking, parametri e chiamate a tool multi-step.
Test Kimi K2.7 Code With CometAPI
Kimi K2.7 Code offre prezzi competitivi per i carichi di lavoro degli agenti di coding, ma la scelta migliore dipende da più fattori rispetto alla sola tariffa per token.
Prima di scegliere un provider, confronta:
Total workflow cost =
tokens + retries + tools + latency + human correction
CometAPI consente agli sviluppatori di testare Kimi insieme a GPT, Claude, Gemini, DeepSeek, Grok e altre famiglie di modelli tramite un workflow API unificato.