

TL;DR
MiMo-V2.5 è la scelta predefinita più robusta per lavori multimodali, agent di routine e produzione sensibile ai costi. MiMo-V2.5-Pro è l’opzione specialistica per ragionamento difficile, coding a livello di repository e uso prolungato di strumenti. Entrambi offrono una finestra di contesto da 1M token e fino a 128K token di output, ma Pro utilizza un backbone linguistico molto più grande e costa circa 3.1× in più per i token di input e output ordinari.
MiMo-V2.5 vs. Pro: decisione rapida
| Specifica — release ufficiale | MiMo-V2.5 | MiMo-V2.5-Pro | Modello consigliato | Motivo |
|---|---|---|---|---|
| Posizionamento principale | Modello onnimodale e agent efficienti | Flagship agent e coding complesso | Scegli in base al carico di lavoro | Gli input onnimodali favoriscono V2.5; lavori testuali difficili favoriscono Pro. |
| Architettura | MoE sparso | MoE sparso | Scegli in base al carico di lavoro | La dimensione del modello da sola non determina la scelta migliore per ogni task. |
| Parametri totali | 310B | 1.02T | Scegli in base al carico di lavoro | Il modello più grande punta al ragionamento difficile, ma la dimensione non è un esito. |
| Parametri attivati | 15B | 42B | Scegli in base al carico di lavoro | Decidi in base al completamento del task e al costo. |
| Livelli LLM | 48 | 70 | Scegli in base al carico di lavoro | Il numero di livelli descrive l’architettura, non un vantaggio universale. |
| Esperti instradati | 256 | 384 | Scegli in base al carico di lavoro | La differenza conta solo se migliora il carico di lavoro target. |
| Esperti attivati per token | 8 | 8 | Entrambi | Entrambi attivano otto esperti per token. |
| Finestra di contesto | 1M token | 1M token | Entrambi | Entrambi dichiarano una finestra da 1M token; testare il recupero effettivo. |
| Output massimo | 128K token | 128K token | Entrambi | Entrambi dichiarano fino a 128K token di output. |
| Modalità di input | Testo, immagini, video e audio | Testo | MiMo-V2.5 | Accetta input di immagini, video e audio; Pro è focalizzato sul solo testo. |
| Invocazione di strumenti | Sì | Sì | Scegli in base al carico di lavoro | Entrambi chiamano strumenti; testare il tasso di successo sulla traiettoria reale. |
| Pesi aperti e licenza | Sì; MIT | Sì; MIT | Entrambi | Entrambi offrono pesi open sotto MIT; i costi di serving differiscono. |
La differenza decisiva: multimodale vs agent-first
V2.5 accetta nativamente testo, immagini, video e audio. Xiaomi abbina il backbone linguistico a un encoder visivo da 729M di parametri e a un encoder audio da 261M di parametri, consentendo alle informazioni multimodali di partecipare direttamente allo stesso flusso di ragionamento.
- Analizzare screenshot prima di chiamare strumenti.
- Comprendere insieme un video e la sua traccia audio.
- Estrarre informazioni da diagrammi e immagini di documenti.
- Operare agent con interfaccia visiva e supporto multimodale.
- Ragionare su lunghe sequenze video.
V2.5-Pro segue un design diverso. Xiaomi al momento specifica il testo come modalità di input e pone l’accento su ragionamento profondo, sviluppo di codice e orchestrazione di strumenti a lunga durata.
Se il flusso di lavoro include immagini, video o audio come input, inizia con V2.5. Testa Pro quando la parte difficile è il ragionamento su testo, codice sorgente, strumenti o una lunga traiettoria di agent.

Confronto ufficiale dei benchmark multimodali Xiaomi.
Perché V2.5-Pro può essere migliore nei task difficili
Scala del modello: 310B/15B vs. 1.02T/42B
I due modelli utilizzano backbone a Mixture-of-Experts sparsi, attenzione ibrida finestra scorrevole + globale e tre moduli di Predizione Multi-Token. La scheda modello V2.5 di Xiaomi documenta un backbone da 310B totali e 15B attivi; la scheda modello Pro scala a 1.02T parametri totali con 42B attivati per token.
| Architettura — scheda modello ufficiale | V2.5 | Pro | Differenza |
|---|---|---|---|
| Parametri totali | 310B | 1.02T | Circa 3.3× |
| Parametri attivi | 15B | 42B | 2.8× |
| Dimensione nascosta | 4,096 | 6,144 | 1.5× |
| Livelli LLM | 48 | 70 | 22 in più |
| Teste di attenzione | 64 | 128 | 2× |
| Esperti instradati | 256 | 384 | 1.5× |
| Esperti per token | 8 | 8 | Uguali |
| Livelli MTP | 3 | 3 | Uguali |
V2.5 utilizza uno schema di attenzione 5:1, mentre Pro passa a uno schema locale-globale 6:1. Xiaomi afferma che questi design riducono i requisiti della cache KV di quasi 6× e 7× rispettivamente rispetto all’attenzione completa in tutta la rete.
I parametri totali non si traducono linearmente in qualità delle risposte. Il backbone più grande di Pro conta soprattutto quando la difficoltà del ragionamento o la lunghezza della traiettoria fanno sì che piccoli guadagni di affidabilità per step si compongano.
Perché i piccoli guadagni di affidabilità si compongono
Un task di agent lungo ha molti step dipendenti. Un errore in una chiamata di strumento iniziale può forzare retry o invalidare il lavoro successivo, quindi un modesto guadagno nell’affidabilità per step può avere un effetto maggiore sul completamento end-to-end. Valuta tale effetto su task rappresentativi invece di assumere che la dimensione del modello lo garantisca.
Dove Pro migliora effettivamente?
Il confronto numerico più pulito è la valutazione del modello base di Xiaomi, in cui entrambi i modelli compaiono nelle stesse impostazioni. Questo evita di combinare risultati prodotti da harness non correlati o configurazioni di post-training diverse.
Conoscenza generale: guadagni piccoli o moderati
Nella valutazione del modello base di Xiaomi, Pro guadagna 1.2 punti su BBH, 3.1 su MMLU e 2.7 su MMLU-Pro. Sono incrementi misurabili ma più piccoli rispetto ai suoi guadagni nei task di ragionamento più difficili.
Matematica e scienze: guadagni maggiori
Pro guadagna 8.6 punti su GPQA-Diamond, 16.3 su GSM8K e 18.5 su MATH nella stessa valutazione del modello base. Questa è l’evidenza più chiara per scegliere Pro quando il ragionamento difficile determina il successo del task.
Coding: migliore, ma non uniformemente
I guadagni riportati sono 4.3 punti su HumanEval+, 3.2 su MBPP+, 4.1 su LiveCodeBench v6 e 4.9 su SWE-Bench AgentLess. Testa separatamente i task a livello di repository e l’uso di strumenti: questi punteggi del modello base non misurano ogni workflow di agent in produzione.
Risultato benchmark: Pro non è tre volte migliore perché costa circa tre volte di più. Diventa progressivamente più prezioso all’aumentare della difficoltà del ragionamento e della durata del task.
Queste righe sono valutazioni del modello base, non una promessa che un’API di produzione riprodurrà gli stessi punteggi. I risultati degli agent dipendono da strumenti, prompt, retry, ambiente di esecuzione e budget di token.
Post-training e agent di lungo orizzonte
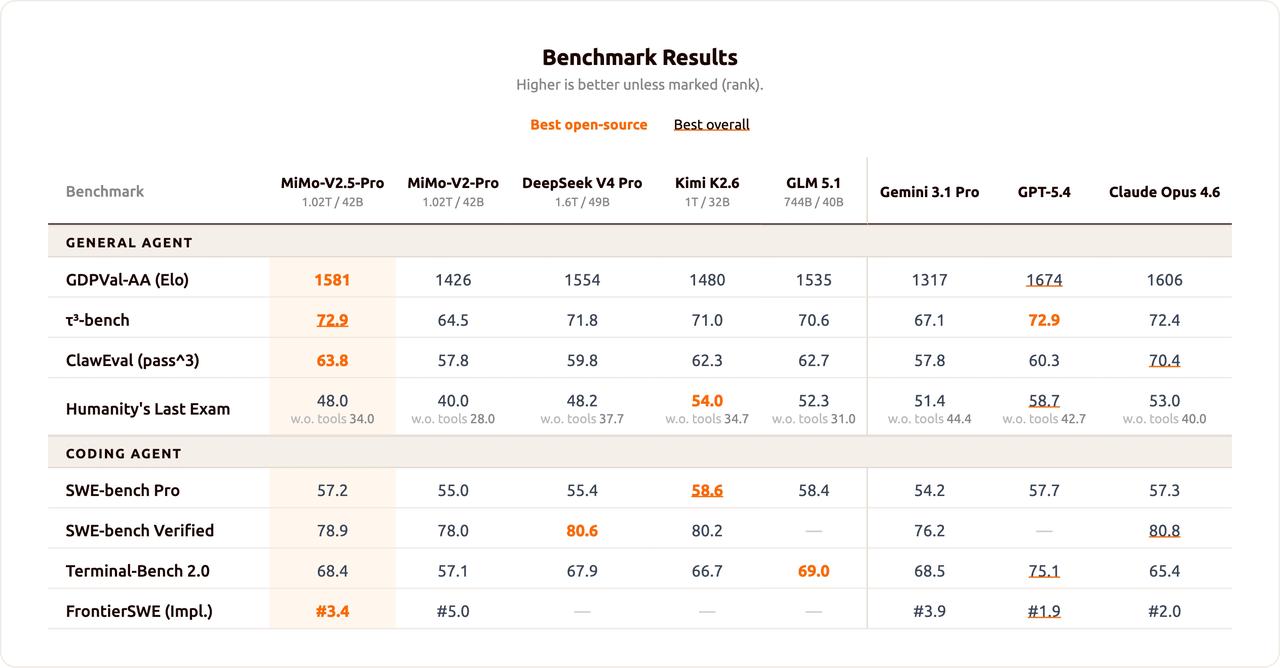
I modelli di produzione aggiungono fine-tuning supervisionato, reinforcement learning orientato agli agent e distillazione on-policy multi-insegnante. Xiaomi riporta punteggi post-training di 56.1 su SWE-bench Pro, 65.8 su Terminal-Bench 2.0 e 62.1 Pass³ sulla porzione generale di Claw-Eval per V2.5.
Pro è più esplicitamente ottimizzato per l’ingegneria del software a lungo orizzonte. Xiaomi descrive centinaia di chiamate di strumenti in traiettorie sostenute e pubblica un risultato del 78.9% su SWE-bench Verified.
Un case study ufficiale mostra Pro completare un compilatore SysY in 4.3 ore con 672 chiamate di strumenti e tutti i 233 test superati. La lezione non è che ogni richiesta di coding richieda Pro; è che piccole differenze di affidabilità possono determinare se un workflow con centinaia di azioni dipendenti si completa.

Figura ufficiale Xiaomi su coding e benchmark degli agent.
Contesto lungo: stessa capacità, carichi diversi
Entrambi i modelli offrono una finestra di contesto da 1M token e fino a 128K token di output tramite l’attuale API di Xiaomi. La dimensione grezza del contesto quindi non li separa.
V2.5 è interessante quando il contesto lungo include materiale multimodale come video, immagini di documenti o tracce visive di agent. Pro è il modello da testare quando il contesto stesso diventa il problema di ragionamento: un grande repository, un contratto lungo, un corpus di ricerca o una traiettoria di agent contenente molte azioni sequenziali.
Una grande finestra di contesto descrive la capacità, non una fedeltà di ragionamento garantita. Valuta recupero, ritenzione delle istruzioni e uso dell’evidenza alle lunghezze che contano per l’applicazione.
Prezzo ed efficienza dei costi
I prezzi pay-as-you-go overseas di Xiaomi rendono chiaro il compromesso.
| Prezzi — listino ufficiale | V2.5 | Pro | Rapporto |
|---|---|---|---|
| Input non in cache per 1M token | $0.14 | $0.435 | 3.11× |
| Input in cache per 1M token | $0.0028 | $0.0036 | 1.29× |
| Output per 1M token | $0.28 | $0.87 | 3.11× |
| Finestra di contesto | 1M | 1M | Uguale |
| Output massimo | 128K | 128K | Uguale |
Una richiesta con 1M token di input non in cache e 200K token di output costa circa $0.196 su V2.5 e $0.609 su Pro prima di hit di cache, addebiti per web-search o fatturazioni specifiche del provider.
La differenza di prezzo in cache è più piccola: Pro è circa il 29% più costoso per input con hit di cache piuttosto che il 211% più costoso. Gli agent di lunga durata con prompt di sistema stabili, definizioni di strumenti o prefissi di repository dovrebbero quindi misurare il proprio tasso effettivo di hit della cache.
Stima il costo per task riuscito. Un agent Pro che completa un workflow difficile una volta può costare meno di tentativi ripetuti falliti su un modello più economico.
Quale modello dovresti usare?
| Carico di lavoro — guida ufficiale | Scelta migliore | Perché |
|---|---|---|
| Chat testuale di routine | V2.5 | Costo inferiore; Pro spesso non necessario |
| Generazione ad alto volume | V2.5 | Prezzo dei token standard ~3.1× più basso |
| Comprensione di immagini, video o audio | V2.5 | Input multimodale nativo |
| Invocazione di strumenti di routine | V2.5 | Forti capacità di agent a costo inferiore |
| Matematica e scienze difficili | Pro | Maggiori guadagni nei benchmark |
| Coding a livello di repository | Pro | Progettato per ingegneria software complessa |
| Centinaia di chiamate di strumenti dipendenti | Pro | Migliore per esecuzioni sostenute |
| Contesto 1M sensibile ai costi | V2.5 | Stesso contesto nominale a costo molto minore |
Risultato della selezione: V2.5 è la scelta predefinita per applicazioni multimodali, agent di routine e carichi sensibili ai costi. Pro è l’upgrade per ragionamento difficile, ingegneria software complessa e lunghe traiettorie autonome.
Una strategia di produzione migliore: instradare tra entrambi
Spesso una singola scelta globale del modello non è necessaria. Instrada le richieste multimodali e di routine a V2.5, quindi esegui l’escalation solo di ragionamento testuale difficile, coding complesso o esecuzioni di lungo orizzonte verso Pro.
| Dimensione di valutazione | Misura | Perché conta | Segnale di instradamento |
|---|---|---|---|
| Completamento | Task riusciti / tentativi | Cattura l’affidabilità end-to-end | Escala le classi a basso completamento |
| Qualità | Valutazione umana o rubric | Evita che il costo dei token domini | Escala i task ad alta posta in gioco |
| Affidabilità degli strumenti | Errori e retry | Piccoli errori si compongono negli agent | Escala le traiettorie lunghe |
| Latenza | Tempo al risultato accettato | Include l’overhead dei retry | Mantieni leggeri i task interattivi |
| Costo | Spesa per task accettato | Riflette fallimenti e rerun | Usa il modello più economico che riesce |
Testare entrambe le API in CometAPI
API MiMo-V2.5 in CometAPI e API MiMo-V2.5-Pro in CometAPI supportano la valutazione side-by-side tramite un unico layer di aggregazione. Invia gli stessi prompt, istruzioni di sistema, strumenti e limiti di output a entrambi i modelli, quindi confronta successo del task e costo.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

models = ["mimo-v2.5", "mimo-v2.5-pro"]
prompt = """
Rivedi questo piano di implementazione.
Identifica i rischi tecnici nascosti e proponi le tre correzioni con la massima priorità.
"""

for model in models:
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=2000,
    )
    print(f"\n--- {model} ---")
    print(response.choices[0].message.content)
Esegui un batch rappresentativo contenente richieste semplici, ragionamento difficile, editing di codice, task con contesto lungo e chiamate di strumenti da parte di agent. Registra tasso di completamento, token, latenza, errori degli strumenti, retry, qualità della risposta e costo per task riuscito.
Limitazioni
Limitazioni di V2.5
Il backbone linguistico più piccolo lascia prestazioni sul tavolo man mano che la difficoltà del ragionamento aumenta. Il divario è modesto su BBH ma diventa molto più grande su GPQA-Diamond e MATH. Una finestra di contesto da 1M token non va inoltre confusa con una fedeltà di ragionamento garantita a 1M token.
Limitazioni di Pro
I prezzi ordinari di input e output sono circa 3.1× quelli di V2.5, e l’input solo testuale lo rende inadatto come sostituto drop-in per applicazioni multimodali. Il modello open-weight da 1.02T parametri è anche un progetto impegnativo per l’auto-hosting, sebbene 42B parametri siano attivati per token.
VerdettO finale
Scegli V2.5 per applicazioni multimodali, agent di routine e produzione sensibile ai costi. Scegli Pro per ragionamento difficile, ingegneria software complessa e agent autonomi di lunga durata. Per carichi misti, instrada la maggior parte del traffico su V2.5 ed esegui l’escalation solo delle richieste la cui difficoltà o lunghezza della traiettoria giustifichi il costo aggiuntivo.
FAQ
Pro è sempre migliore di V2.5?
No. Pro è più forte su ragionamento testuale difficile e coding, ma V2.5 supporta input di immagini, video e audio ed è sostanzialmente più economico.
Entrambi i modelli supportano una finestra di contesto da 1M token?
Sì. Entrambi dichiarano 1M token di contesto e fino a 128K token di output. Le applicazioni dovrebbero comunque testare recupero e ragionamento alle lunghezze operative reali.
Quale modello dovrebbe usare un agent multimodale?
Inizia con V2.5 perché accetta nativamente input visivi e audio. Pro attualmente è orientato a workflow con input testuale.
Quando Pro vale il prezzo più alto?
È più difendibile quando una migliore affidabilità del ragionamento incide sul completamento di matematica difficile, coding a livello di repository o lunghe traiettorie contenenti molte chiamate di strumenti dipendenti.
I sistemi di produzione dovrebbero usare un solo modello?
Non necessariamente. Un layer di instradamento può mantenere lavoro di routine e multimodale su V2.5 ed eseguire l’escalation di ragionamento testuale difficile e task di agent verso Pro.