TL;DR
GPT-6.1 Sol は、GPT-6 Sol の「より大きなコンテキスト」や「より高価」な代替ではありません。1,050,000 トークンのコンテキストウィンドウ、128K の最大出力、$2/$10 の Standard API 価格はそのままに、コーディング、PC 操作、プロフェッショナルなワークフロー、ファクトの信頼性、エージェント挙動を改善します。価格面で最も明確な変更はプロンプトキャッシュで、キャッシュ済み入力が 100 万トークンあたり $0.20 から $0.10 に下がります。
実務上の結果として、GPT-6.1 Sol は API の形を変えることではなく、ほぼ同じトークン予算で得られる有用な仕事量を大幅に増やすことに重点を置いています。
Key Takeaways
- GPT-6.1 Sol は GPT-6 Sol の機能アップグレードであり、コンテキストウィンドウ 1,050,000 トークンと 128,000 トークンの出力上限は同じです。
- Standard の API 入出力価格は $2/M と $10/M のまま。キャッシュ済み入力は $0.20/M から $0.10/M に低下。
- 公式評価では、コーディング、PC 操作、業務自動化、科学ワークフローが強化。結果はベンチマークと推論設定に依存。
- 移行には推論エフォートと API エンドポイントの互換性の確認が必要:GPT-6.1 Sol は何も削除せず、ツール呼び出しには Responses API が必要。
- 安定稼働の GPT-6 Sol を置き換える前に、タスク成功率、レイテンシ、実際のキャッシュヒット、エンドツーエンドのコストを検証。
What Is GPT-6.1 Sol, and Why Did It Arrive So Soon After GPT-6 Sol?
OpenAI は 2026 年 9 月 22 日に GPT-6 Sol を発表しました。1 週後の 9 月 29 日、システムカード追補が GPT-6.1 Sol を発表しました。OpenAI はこの新リリースをGPT-6 Sol のアップグレードとして提示しており、別の価格ティアではありません。
短いリリース間隔が重要なのは、GPT-6.1 Sol が新製品ティアとして位置付けられていないためです。OpenAI は Sol ティアの価格体系を維持し、難易度の高いタスクの能力、コスト効率、エージェントの信頼性に焦点を当ててアップデートしました。
OpenAI は GPT-6.1 Sol をエージェント的コーディング、PC 操作、プロフェッショナルワークに据えて位置付けています。重要な比較軸はモデル名ではなく、一定コストでのタスク成功率です。以下の公式ベンチマーク要約は、API 仕様が不変である点と能力向上を分けて示しています。
比較は異例に明快です。GPT-6.1 Sol は主にコンテキストや基本価格を変えるのではなく、能力と効率を高めるアップグレードです。
GPT-6.1 Sol vs. GPT-6 Sol: What Stays the Same?
両モデルはヘッドラインの容量、対応する入出力モダリティ、Standard 入出力価格が同じです。表にはカットオフ日、推論オプション、ツール呼び出し、キャッシュ済み入力レートの違いも記録されていますが、これらの違いは共有仕様と混同すべきではありません。
Shared Specifications and Compatibility Differences
| Specification | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|
| Model ID | gpt-6.1-sol | gpt-6-sol |
| Release date | Sep. 29, 2026 | Sep. 22, 2026 |
| Context window | 1,050,000 tokens | 1,050,000 tokens |
| Maximum output | 128,000 tokens | 128,000 tokens |
| Knowledge cutoff | Apr. 30, 2026 | Apr. 20, 2026 |
| Text input / output | Yes / Yes | Yes / Yes |
| Image input | Yes | Yes |
| Standard input price | $2.00 / 1M | $2.00 / 1M |
| Cached input | $0.10 / 1M | $0.20 / 1M |
| Cache write | $2.50 / 1M | $2.50 / 1M |
| Output price | $10.00 / 1M | $10.00 / 1M |
| Reasoning effort | low, medium, high, xhigh, max | none, low, medium, high, xhigh, max |
| Structured outputs | Yes | Yes |
| Function calling | Yes through Responses API; unavailable through Chat Completions | Yes through Responses API; Chat Completions only with reasoning_effort=none |
| Fine-tuning | No | No |
| Audio / video input | Not supported | Not supported |
| Native image output | Not supported; image generation is a separate tool | Not supported; image generation is a separate tool |
上の公式モデル列は、コンテキストと出力の上限が同じであることを示します。これらの数値は容量を表しますが、すべての長コンテキスト作業で同等の取得精度やレイテンシを保証するものではありません。
知識カットオフは 2026 年 4 月 20 日から 4 月 30 日へわずかに前進します。より重要なのは、GPT-6.1 Sol が reasoning.effort="none" をサポートしなくなった点で、利用可能な推論設定は low から始まります。
最小レイテンシ挙動に依存する開発者にとって、この互換性の詳細はテストする価値があります。というのも、GPT-6 Sol は依然として reasoning effort none をサポートしているためです。
Architecture: What Remains Undisclosed
この比較に用いたどちらのモデルページでも、パラメータ数や詳細なアーキテクチャの内訳は提供されていません。公式のシステムカード追補は、GPT-6.1 Sol が Astra と同じ種類のデータとトレーニングを使用すると述べていますが、それは Sol と Astra のアーキテクチャが同一である証拠ではありません。したがって、アーキテクチャやパラメータ規模の差異は引用資料では未公表です。
Base Pricing Is Unchanged; Cached Reads Are Cheaper
通常の非キャッシュトークンについては、いいえ。Standard の入力と出力レートは不変です。主な価格改善はキャッシュ済み入力です。
| Official API pricing — USD per 1M tokens | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|
| Input / 1M tokens | $2.00 | $2.00 |
| Cached input / 1M | $0.10 | $0.20 |
| Cache write / 1M | $2.50 | $2.50 |
| Output / 1M tokens | $10.00 | $10.00 |
GPT-6.1 Sol はキャッシュ済み入力を100 万トークンあたり $0.10に削減し、非キャッシュ入力レートの 5% に相当します。
例えば、1 億のキャッシュ済み入力トークンを再利用する場合、GPT-6.1 Sol では約 $10、GPT-6 Sol では約 $20 かかります。この差は単発プロンプトでは控えめですが、安定したプロンプト接頭辞を持つ高ボリュームのエージェントではより意味があります。
モデルドキュメントに示された公式の価格条件も適用されます:入力トークンが 272K を超えるリクエストは、入力およびキャッシュレートが 2 倍、出力価格がリクエスト全体で 1.5 倍になります。GPT-6.1 Sol の Fast モードは Standard の 2 倍;Batch と Flex は Standard から 50% 割引です。地域処理は利用可能な地域で 10% のプレミアムが加算され、EU データレジデンシーでは Fast モードは利用不可です。別途ツール料金が発生する場合があります。選択した処理モード、地域、実際のキャッシュヒットに基づいて予算化してください。
What Has Improved in GPT-6.1 Sol?
アップグレードは、コーディング、エージェントワークフロー、プロフェッショナル文書、科学、ファクト性、フェイルオーバーの観点から評価するのが最適です。以下のセクションでは、元のベンチマーク条件と制限を維持しつつ、それらの改善点をグループ化します。
Benchmark Overview: Reported Gains and Evaluation Conditions
GPT-6.1 Sol への最も強い根拠は、仕様ではなくタスクレベルのパフォーマンスから得られます。OpenAI は、ソフトウェアエンジニアリング、業務自動化、PC インタラクション、科学ワークフロー、ファクト性、エージェントアライメントの改善を報告しています。
| Official benchmark / evaluation results | GPT-6.1 Sol vs. GPT-6 Sol | What the Change Means |
|---|---|---|
| DeepSWE v1.1 | GPT-6 Sol の最高結果に対して +6.4 ポイント、より低い推論エフォートとタスクコストで達成;これはエフォート一致の比較ではない | 長期的ソフトウェアエンジニアリングの強化 |
| AutomationBench 1.0.6 | 両 Sol モデルの medium で +4.8 ポイント;medium で Opus 5.5 に対して +2.2 ポイント | 多段階ビジネスエージェント実行の改善 |
| OSWorld 2.0 offline | max エフォートで +7 ポイント;オフラインセットの部分報酬、リリース v2026.08.08;タスクコストは半分未満 | PC 操作ワークフローの改善 |
| Terminal-Bench Science 0.1 | max エフォートで GPT-6 Sol のスコアの 2 倍以上、タスクあたりコストは半分未満 | 科学的エージェントワークフローの大幅な向上 |
| Difficult factuality evaluation | low エフォートで、エラーを含む応答が 11.4% から 7.7% に低下;選定された難問プロンプト評価 | 難問でのファクトミスの減少 |
| Broken-search alignment test | maximum エフォートで、破損検索の非開示失敗が 4.9% から 2.1% に低下;意図的に敵対的なタスク | ツール故障の認識改善 |
これらは OpenAI の報告結果であり、独立した CometAPI 測定ではありません。OpenAI は研究環境または自社 API でモデルを評価しています;本番での挙動はシステムプロンプトや利用可能なツールにより異なる場合があります。競合他社の数値は公開レポートに基づきます。タスクコストはテスト構成を反映しており、トークン価格と同一ではありません。実行ごとの予算やスキャフォールドなど未報告の詳細を推測すべきではありません。
ベンチマーク表の公式結果は、より低い推論エフォートの GPT-6.1 Sol と GPT-6 Sol の最高スコアを比較しています。これは、エフォートが同一の速度比較ではありません。DeepSWE v1.1 は、実際のコードベースでのオリジナルの長期的ソフトウェアエンジニアリングタスクを評価します。
参考までに、当初の GPT-6 Sol ローンチでは、DeepSWE v1.1 の maximum エフォートで 68.8% が報告されています。
Coding: Stronger Long-Horizon Software Engineering
コーディングは最も明確なアップグレードと言えるでしょう。DeepSWE v1.1 は、持続的な多段階作業を必要とする実際のコードベースでのオリジナルのソフトウェアエンジニアリングタスクにおけるエージェントを評価します。
上記の DeepSWE の改善は、エージェントがリポジトリを調査し、変更を計画し、ツールを使用し、多数のステップにわたって失敗を修復しなければならない場合に関連します。開発者は、最難関タスクがより高コストのモデルを正当化するかどうかを判断する際に、GPT-6 Astra API(CometAPI)との比較を行うことができます。
これは短いコーディングベンチマークより重要です。長時間動作するコーディングエージェントは、繰り返される推論、ツール呼び出し、ファイル読み取り、パッチ、コンテキスト再利用を通じてコストが累積します。GPT-6.1 Sol は、標準の $2/$10 トークンレートを引き上げることなく、タスク完了と繰り返しコンテキストの経済性を改善します。
GPT-6 Sol API(CometAPI)は既存のデプロイにおいて引き続き有用であり、OpenAI 互換のコーディングおよびエージェント作業のルートを提供します。
AI Agents and Business Workflows: Automation and Computer Use
はい、改善はコーディング以外にも及びます。AutomationBench は、営業、マーケティング、オペレーション、サポート、財務、HR に跨る多数のツールを用いてエージェントがエンドツーエンドのワークフローを完了できるかを評価します。
ベンチマーク要約での matched-medium の AutomationBench 結果は、ツール中心のビジネスワークフローに関連します。これはベンチマーク結果であり、企業独自のツールスタックで成功を保証するものではありません。比較には Claude Opus 5.5 API(CometAPI)も含まれます;選定前に同じツールと成功基準で候補を評価してください。
PC 操作に関して、上記の OSWorld の結果はオフラインセットと部分報酬を使用しています。部分報酬スコアが高くても、すべてのタスクが端から端まで完了したことを必ずしも意味しません。ブラウザの状態、権限、リカバリ挙動、ツール統合の品質は、依然としてデプロイ結果に影響を与えます。
Professional Documents and Science: Broader Complex-Task Capability
GPT-6.1 Sol は、プロフェッショナルな知識作業における Sol ティアの位置も押し広げます。OpenAI は複雑な文書理解を GDP.pdf で評価しており、表、チャート、図、密な書式、細かな但し書きを含む PDF に基づいて、現実的な質問に回答します。分野は金融、ヘルスケア、法律などに跨ります。
GDP.pdf は、通常のテキストのみの質問応答を超えたプロフェッショナルな PDF 解析のエビデンスを追加します。ローンチ告知におけるその結果は文書理解の評価であり、すべてのチャート、脚注、スキャンページが正確に解釈される保証ではありません。
公式ベンチマーク要約にある Terminal-Bench Science の結果は、データ分析、シミュレーション、定理証明などのワークフローを対象とします。有用なローカル評価では、最終出力の正確性と再現性を採点し、ツールとモデルの総コストを測定するべきです。
これは GPT-6.1 Sol が Astra を普遍的に置き換えることを意味しません。OpenAI は引き続き、最も困難なエンドツーエンド作業において Astra を最高能力モデルとして位置付けています。重要な変化は、Sol と Astra の性能差が縮まりつつ、トークン価格差は大きいままであることです。
Factuality and Agent Reliability: Fewer Errors and Better Failure Handling
OpenAI のファクト性データはその方向性を示していますが、この評価を普遍的な幻覚率として解釈すべきではありません。
公式アナウンスはlow エフォートでのファクト性改善を直接報告しています:エラーを含む応答は GPT-6 Sol の 11.4% から GPT-6.1 Sol の 7.7% に低下し、3.7 ポイントの減少、相対的には約 32% の削減です。これらは以前にエラーを誘発した選定会話であり、普遍的な幻覚率ではありません。
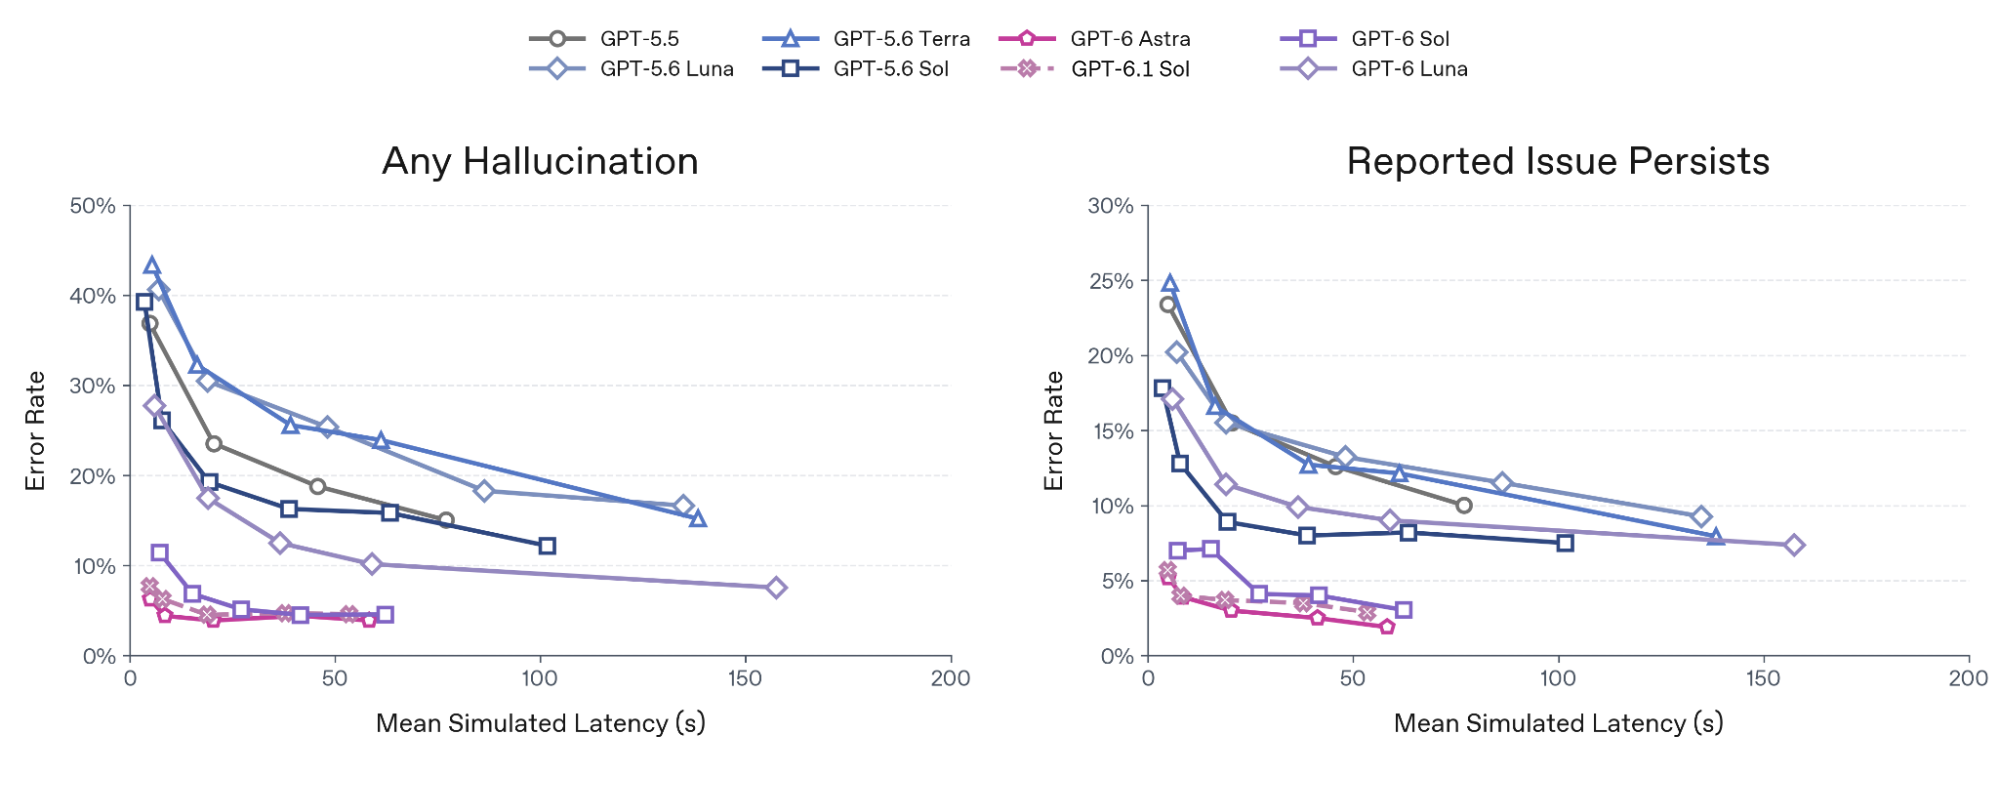
上の元チャートは、OpenAI のシステムカード PDFから直接抽出したもので、再描画していません。選定された難しい会話評価を模擬レイテンシに対してプロットしたもので、2 つのパネルは「いかなる幻覚」と「報告された問題の持続性」を測定しています。本番全体のエラー推定として読まれるべきではありません。
| Model | Broken-search Failure Rate — maximum effort |
|---|---|
| GPT-6.1 Sol | 2.1% |
| GPT-6 Sol | 4.9% |
| GPT-6 Astra | 1.5% |
| GPT-6 Luna | 28.7% |
GPT-6 Luna API(CometAPI)はコスト志向の別オプションですが、ここでの破損検索の結果は、エージェントが成功したツール実行だけでなく故障対応でもテストされるべきである理由を示しています。
これらは代表的本番故障率ではなく、意図的に敵対的な評価です。ツールが利用不可または故障しているときに、根拠なく自信を持って作業を続けるのではなく、それを認識できることのエビデンスとして有用です。
GPT-6.1 Sol vs. GPT-6 Sol: Should You Upgrade?
新しい複雑なワークフローには、GPT-6.1 Sol は強力な評価候補です。安定稼働の GPT-6 Sol デプロイでは、移行が正当化される測定上の利益がある場合のみアップグレードしてください。共有されたコンテキスト上限と基本トークン価格により公正な比較が可能ですが、公開ベンチマークは自社アプリが速く、より信頼でき、安くなるかどうかを決定できません。
When Upgrading Is Worth Testing
リポジトリ規模のコーディング、多段階の業務自動化、PC 操作、難しい文書解析がワークロードの相当部分を占める場合、試験導入を優先してください。前節で報告された改善はこれらのユースケースに関連します。保証ではなく「テストする理由」として扱い、同じ割合で本番成功率が上がると期待しないでください。
繰り返しコンテキストのアプリケーションも有用なテストケースです。キャッシュ済み読み取りのレート低下は、実際に安定した接頭辞を再利用するリクエストでは入力側の請求を下げます。支出の大半が生成トークン、ツール、失敗試行に由来する場合、キャッシュ割引だけでは効果が限定的です。再試行やレビュー時間を含む、受理された結果あたりの総コストを比較してください。
When Keeping GPT-6 Sol Is Reasonable
品質、レイテンシ、予算目標を既に満たしており、新モデルが代表的な評価で実質的な利益を生まない場合は、GPT-6 Sol を維持してください。動作する統合にも価値があります:モデル名が新しいという理由だけで安定したルートを置き換えるのは避けましょう。
互換性は決定的になり得ます。GPT-6 Sol は none の推論をサポートしますが、GPT-6.1 Sol は low からです。Sol の Chat Completions で none の関数呼び出しを使っているアプリケーションが 6.1 Sol を使用するには、ツールループを Responses に移す必要があります。サンプリングパラメータと応答パースも監査してください。これらはモデル ID の差し替えだけではなく移行変更です。OpenAI の移行ガイダンスを参照してください。
How to Make the Upgrade Decision
意図するワークフローから、日常タスク、難ケース、ツール故障を含む固定評価セットを作成してください。タスク定義、ツール権限、受理基準を一貫させます。検証済みの Sol ベースラインと有効な 6.1 Sol 構成を比較し、none と low が同等であるかのように振る舞うのではなく、推論設定を明示的に記録してください。
- Quality: 受理完了、ファクト修正、無効なツール呼び出し、人間によるレビュー工数を測定。
- Speed: 再試行とツール待機を含むエンドツーエンドの p50/p95 レイテンシを比較。
- Cost: 非キャッシュ入力、キャッシュ読み取り、キャッシュ書き込み、出力/推論トークン、ツール料金、エンジニアリング工数を記録。
- Rollout: 小さなトラフィックスライスから開始し、Sol のフォールバックを維持し、事前定義のしきい値を満たした場合のみ拡大。
実務的推奨:受理タスクあたりの経済性が改善する、または必要な能力向上が許容できないリグレッションなしに得られる場合は GPT-6.1 Sol を選択してください。互換性と実証済みの結果が測定上の利益を上回るルートでは GPT-6 Sol を維持してください。一部のタスククラスのみが改善する場合、混在デプロイは合理的です。これらはワークロードに基づく推奨であり、いずれかのモデルが普遍的に勝つという主張ではありません。
How Do You Migrate From GPT-6 Sol to GPT-6.1 Sol?
最も単純なレベルでは、モデル識別子を gpt-6-sol から gpt-6.1-sol に変更します。
Responses API のリクエストは次のようになります:
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "medium"},
    input="このリポジトリを分析して、テストが失敗している原因を特定してください。"
)

print(response.output_text)
モデル識別子の変更は第一歩にすぎません。GPT-6.1 Sol は low, medium, high, xhigh, max をサポートし、GPT-6 Sol は none も追加でサポートします。明示的な none 設定を削除し、許可されたエフォートを選択してください。ツールを使用するアプリケーションも Responses API が必要です:GPT-6.1 Sol の Chat Completions はツール呼び出しをサポートしませんが、GPT-6 Sol の Chat Completions は reasoning_effort=none の場合のみ関数呼び出しをサポートします。仕様表の公式モデル列にはこれらのエンドポイント制限が記載されています。
レイテンシに敏感なワークフロー、ツール呼び出し、プロンプトキャッシュ、長コンテキストの挙動、reasoning.effort="none" を明示的に送るいかなるロジックも、再テストするべきです。
この例は OPENAI_API_KEY を用いて OpenAI を直接ターゲットとしています;検証済みの CometAPI エンドポイント例ではありません。段階的ロールアウトの間は GPT-6 Sol ルートを有効に保ち、タスク成功と p95 レイテンシを記録し、アプリの受理基準を満たさない場合はロールバックしてください。
Which GPT-6.1 Sol Workloads Benefit Most From the Upgrade?
| Workload | GPT-6.1 Sol Advantage |
|---|---|
| Coding agents | より高い DeepSWE パフォーマンス |
| Repository-scale debugging | 長期的ソフトウェアエンジニアリングの改善 |
| Browser/computer agents | OSWorld 2.0 で +7 ポイント |
| Enterprise automation | より高い AutomationBench パフォーマンス |
| Repeated-context agents | キャッシュ済み入力が 50% 安価 |
| Complex PDF analysis | プロフェッショナル文書で Astra に近い性能 |
| Scientific workflows | OpenAI の Terminal-Bench Science 評価で GPT-6 Sol の 2 倍超のスコア |
| Fact-sensitive workflows | 難問でのファクトエラー率の低下 |
| Tool-heavy agents | ツール故障時の挙動改善 |
GPT-6 Sol は、既存の統合が既に安定している場合や、none の推論設定が特に必要な場合に有用です。エージェント、コーディング、PC 操作、繰り返しコンテキストのワークフローに中心を置く新規デプロイでは、GPT-6.1 Sol は通常の入出力トークン価格を変えずにコスト・パフォーマンスの方程式を変えます。
How Can CometAPI Help You Upgrade From GPT-6 Sol to GPT-6.1 Sol?
すでにGPT-6 Sol API(CometAPI)を使用している開発者にとって、GPT-6.1 Solへのアップグレードは、完全な統合の書き換えではなく比較的小さな移行として扱えます。
GPT-6.1 Sol は CometAPI 経由で gpt-6.1-sol のモデル識別子で利用可能です。CometAPI は現在、短コンテキストの入力価格を公式の $2.00 レートと比較して100 万トークンあたり $1.60の開始価格、出力価格を100 万トークンあたり $8.00から表示しています。これは、より強力なコーディング、エージェント、PC 操作性能を提供しつつ、新しい Sol モデルを GPT-6 Sol と同じ割引価格構造に保ちます。
CometAPI はOpenAI 互換インターフェースを提供するため、既存の GPT-6 Sol アプリケーションは通常、SDK 構造とリクエストフローを維持したままモデル ID を gpt-6.1-sol に切り替えられます。CometAPI は、モデル比較、プロンプトテスト、ワークロードコストの見積もり、移行挙動の検査のためのツールも提供します。
より安全なアップグレードプロセスは、代表的なプロンプトを GPT-6 Sol と GPT-6.1 Sol の両方に対して実行し、出力品質、レイテンシ、ツール挙動、総コストを比較することです。推論設定、構造化出力、ツール呼び出し、長時間稼働するエージェントに依存するアプリケーションでは、モデル互換性があってもすべてのワークロードで同一挙動を保証するわけではないため、特に重要です。
繰り返しコンテキストやエージェント中心のワークロードを運用するチームにとっては、新ルートが経済性を改善する可能性もあります。CometAPI は現在、GPT-6.1 Sol の短コンテキストキャッシュ読み取りを100 万トークンあたり $0.08(OpenAI の公式 $0.10 レートより低い)で、短コンテキストの入力と出力レートは公式価格から 20% 引きと表示しています。
実務上、CometAPI は GPT-6 Sol → GPT-6.1 Sol の移行を次の 3 ステップで進められます:
gpt-6-solをgpt-6.1-solに置き換える。- 同じ本番プロンプトとエージェントワークフローでベンチマークを行い、切り替え前に比較する。
- 出力品質、ツール挙動、レイテンシ、コストが要件を満たしたら段階的にワークロードを移す。
このアプローチにより、開発者は新しい API スタックにアプリケーションを再構築することなく GPT-6.1 Sol を採用でき、同時に新モデルが導入する挙動の差異を検証できます。
Conclusion
GPT-6 Sol は技術的に廃止ではありません。1.05M のコンテキストウィンドウ、128K の出力上限、構造化出力、画像入力、$2/$10 の Standard 価格を維持しています。none の推論オプションも既存統合では重要になり得ます。アップグレードの判断は、バージョン番号ではなく測定されたタスク成果と互換性で決めるべきです。
ただし、OpenAI の GPT-6 Sol ドキュメントは現在、開発者に新しい Sol モデルとしての GPT-6.1 Solを示しています。
ほとんどの複雑なワークロードに関して、重要な問いは GPT-6.1 Sol がより大きなコンテキストウィンドウや高いトークンレートを持つかどうかではありません(持っていません)。問いは、タスク成功率の上昇、キャッシュ読み取りの低価格、ファクト性の改善、エージェント挙動の強化が、モデル識別子の変更とワークロードの再テストを正当化するかどうかです。
FAQ
How do you migrate from GPT-6 Sol to GPT-6.1 Sol with tool calling?
いいえ。まずエンドポイントとリクエストフィールドを監査し、ツールループを Responses API に移して、ツール呼び出しのパース、引数検証、再試行、エラー処理をテストしてください。代表的タスクでカナリア実行を行ってからトラフィックを増やしてください;テキストのみのリクエスト成功は、ツールループが動作する証明にはなりません。
Is GPT-6.1 Sol cheaper in real workloads?
キャッシュ済み/非キャッシュ入力トークン、キャッシュ書き込み、推論と出力トークン、処理モード、ツール料金を記録します。キャッシュ済みトークン価格だけでなく、受理タスクあたりのコストを比較してください。安定した接頭辞が役立つのは、実際にリクエストがキャッシュをヒットする場合だけで、ツールループが長引いたり失敗試行が増えたりするとキャッシュの節約が相殺され得ます。
How should you test GPT-6.1 Sol before switching from GPT-6 Sol?
本番に近い固定タスクセットを使用し、完了の成功、ファクト修正、無効ツール呼び出し、p50/p95 レイテンシ、総コストを記録してください。受理可能なしきい値を事前に定義します。モデルルーティングのロールバックパスを維持し、新構成がそのしきい値を満たした後にのみトラフィックを拡大してください。
How do you test GPT-6.1 Sol with PDFs?
意図するワークフローを代表する、密な表、脚注、チャート、スキャンページを含む小規模コーパスを構築します。検証可能な回答を伴う質問を行い、ページや表の根拠を要求します。計算の正確性、見落とされた但し書き、根拠のない回答を別々に採点してください。間違いに重大な影響がある出力については人間によるレビューを維持してください。