

TL;DR
MiMo-V2.5 は、マルチモーダル作業、日常的なエージェント、コスト重視の本番運用に適した、より強力なデフォルトです。MiMo-V2.5-Pro は、困難な推論、リポジトリ規模のコーディング、長時間のツール使用に特化した選択肢です。どちらも 1M-token のコンテキストウィンドウと最大 128K の出力トークンを提供しますが、Pro ははるかに大きい言語バックボーンを使用し、通常の入出力トークンで約 3.1×のコストがかかります。
MiMo-V2.5 vs. Pro: Quick Decision
| Specification — official release | MiMo-V2.5 | MiMo-V2.5-Pro | Recommended model | Reason |
|---|---|---|---|---|
| Primary positioning | オムニモーダルモデルと高効率エージェント | フラッグシップエージェントと複雑なコーディング | 作業内容で選択 | オムニモーダル入力は V2.5 に有利。持続的で難度の高いテキスト作業は Pro に有利。 |
| Architecture | Sparse MoE | Sparse MoE | 作業内容で選択 | モデルサイズだけでは、すべてのタスクで優位が決まるわけではありません。 |
| Total parameters | 310B | 1.02T | 作業内容で選択 | 大型モデルは難しい推論を狙うが、総サイズ自体はタスク結果を保証しません。 |
| Activated parameters | 15B | 42B | 作業内容で選択 | タスク完了率とコストで判断してください。 |
| LLM layers | 48 | 70 | 作業内容で選択 | レイヤー数はアーキテクチャの説明であり、万能な勝利条件ではありません。 |
| Routed experts | 256 | 384 | 作業内容で選択 | 差分は、対象ワークロードで効果がある場合にのみ意味があります。 |
| Experts activated per token | 8 | 8 | いずれも可 | どちらもトークンごとに 8 エキスパートを活性化します。 |
| Context window | 1M tokens | 1M tokens | いずれも可 | どちらも 1M-token ウィンドウを掲示。実効的なリトリーバルを検証してください。 |
| Maximum output | 128K tokens | 128K tokens | いずれも可 | どちらも最大 128K 出力トークンを掲示。 |
| Input modalities | Text, image, video, and audio | Text | MiMo-V2.5 | 画像・動画・音声入力を受け付ける。Pro はテキスト入力に焦点。 |
| Tool calling | Yes | Yes | 作業内容で選択 | どちらもツール呼び出し可能。実際のトラジェクトリで成功率を検証。 |
| Open weights and license | Yes; MIT | Yes; MIT | いずれも可 | どちらも MIT でオープンウェイト提供。提供コストは異なります。 |
The Decisive Difference: Multimodal vs Agent-First
V2.5 はネイティブに text, images, video, and audio を受け付けます。Xiaomi は言語バックボーンに 729M-parameter のビジョンエンコーダと 261M-parameter のオーディオエンコーダを組み合わせ、マルチモーダル情報が同一の推論ワークフローに直接参加できるようにしています。
- ツール呼び出し前にスクリーンショットを解析。
- 動画とその音声トラックを一体として理解。
- 図表やドキュメント画像から情報抽出。
- ビジュアルインターフェースとマルチモーダル対応エージェントを運用。
- 長い動画シーケンスに対して推論。
V2.5-Pro は異なる設計です。Xiaomi は現在、テキストを入力モダリティ として指定し、深い推論、コード開発、長時間のツールオーケストレーションを強調しています。
ワークフロー自体に画像・動画・音声入力が含まれる場合は、V2.5 から始めてください。困難な部分がテキスト・ソースコード・ツール・長いエージェントトラジェクトリ上の推論である場合は、Pro をテストしてください。

Xiaomi 公式のマルチモーダルベンチマーク比較。
Why V2.5-Pro Can Be Better on Hard Tasks
Model Scale: 310B/15B vs. 1.02T/42B
両モデルは、Sparse Mixture-of-Experts バックボーン、ハイブリッドなスライディングウィンドウとグローバルアテンション、そして 3 つの Multi-Token Prediction モジュールを使用しています。Xiaomi の V2.5 モデルカード は総計 310B・アクティブ 15B のバックボーンを記載し、Pro モデルカード はこれを総計 1.02T・トークンごとに 42B 活性化へスケールしています。
| Architecture — official model card | V2.5 | Pro | Difference |
|---|---|---|---|
| Total parameters | 310B | 1.02T | 約 3.3× |
| Active parameters | 15B | 42B | 2.8× |
| Hidden size | 4,096 | 6,144 | 1.5× |
| LLM layers | 48 | 70 | 22 多い |
| Attention heads | 64 | 128 | 2× |
| Routed experts | 256 | 384 | 1.5× |
| Experts per token | 8 | 8 | 同じ |
| MTP layers | 3 | 3 | 同じ |
V2.5 は 5:1 のアテンションパターン を使用し、Pro はローカル対グローバルを 6:1 のパターンへ移行しています。Xiaomi は、これらの設計がネットワーク全体でのフルアテンションと比較して KV-cache 要件をそれぞれ約 6×、7× に削減すると述べています。
総パラメータは回答品質に線形には反映されません。Pro の大きいバックボーンが最も効くのは、推論の難易度やトラジェクトリ長が、ステップごとの小さな信頼性向上を累積させる場合です。
Why Small Reliability Gains Compound
長いエージェントタスクは多くの依存ステップを持ちます。初期のツール呼び出しでのエラーはリトライを招いたり、後続の作業を無効にしかねません。ステップごとの信頼性がわずかに向上するだけでも、エンドツーエンドの完了に大きく影響する可能性があります。モデルサイズがそれを保証すると仮定するのではなく、代表的なタスクでその効果を評価してください。
Where Does V2.5-Pro Actually Improve?
最もクリーンな数値比較は、両モデルが同一設定下で登場する Xiaomi のベースモデル評価です。無関係なハーネスやポストトレーニング構成の結果を混在させるのを避けられます。
General Knowledge: Small to Moderate Gains
Xiaomi のベースモデル比較では、Pro は BBH で 1.2 ポイント、MMLU で 3.1、MMLU-Pro で 2.7 の向上です。これらは測定可能ですが、より難しい推論タスクでの向上ほど大きくはありません。
Mathematics and Science: Larger Gains
同じベースモデル評価で、Pro は GPQA-Diamond で 8.6、GSM8K で 16.3、MATH で 18.5 の向上です。難しい推論がタスク成功を左右する場合に Pro を選ぶべきだと示す最も明確な証拠です。
Coding: Better, but Not Uniformly Better
報告された向上は、HumanEval+ で 4.3、MBPP+ で 3.2、LiveCodeBench v6 で 4.1、SWE-Bench AgentLess で 4.9 です。リポジトリレベルのタスクとツール使用は別途テストしてください。これらのベースモデルスコアは、すべての本番エージェントワークフローを測定するものではありません。
ベンチマーク結果: Pro は約 3 倍のコストだからといって、3 倍優れているわけではありません。推論の難しさとタスクの長さが増すにつれて、その価値が段階的に高まります。
これらの行はベースモデル評価であり、本番 API が同じスコアを再現することを約束するものではありません。エージェントの結果は、ツール、プロンプト、リトライ、実行環境、トークン予算に依存します。
Post-Training and Long-Horizon Agents
本番モデルには、監督あり微調整、エージェント強化学習、Multi-Teacher On-Policy Distillation が追加されています。Xiaomi は V2.5 について、ポストトレーニングスコア として SWE-bench Pro で 56.1、Terminal-Bench 2.0 で 65.8、一般領域の Claw-Eval の Pass³ で 62.1 を報告しています。
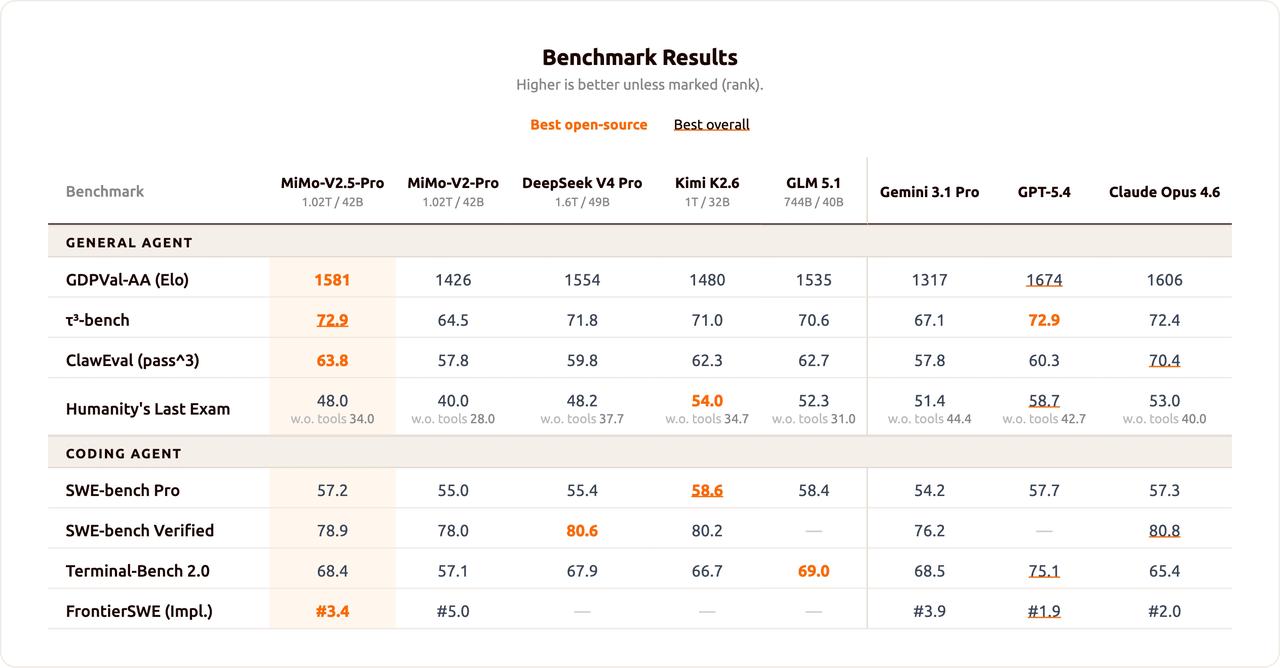
Pro は長期的なソフトウェア工学により明示的に最適化されています。Xiaomi は、持続的なトラジェクトリでの 数百回のツール呼び出し を説明し、78.9% の SWE-bench Verified 結果を公開しています。
ある公式ケーススタディでは、Pro が 4.3 時間で 672 回のツール呼び出しを伴い、233 個すべてのテストをパスして SysY コンパイラを完成させています。教訓は、すべてのコーディング要求に Pro が必要ということではなく、数百の依存アクションを含むワークフローの成否が、小さな信頼性の差で決まることがある、という点です。

Xiaomi 公式のコーディングおよびエージェントベンチマーク図。
Long Context: Same Capacity, Different Workloads
どちらのモデルも、Xiaomi の現行 API によって 1M-token のコンテキストウィンドウ と最大 128K の出力トークンを提供します。生のコンテキストサイズは両者を分ける要因ではありません。
長いコンテキストに動画、ドキュメント画像、ビジュアルエージェントのトレースなどのマルチモーダル素材が含まれる場合、V2.5 は魅力的です。コンテキスト自体が推論課題になる場合、つまり大きなリポジトリ、長い契約書、研究コーパス、または多数の連続アクションを含むエージェントトラジェクトリでは、Pro をテストすべきモデルです。
大きなコンテキストウィンドウは容量を表すものであり、推論の忠実度を保証するものではありません。アプリケーションにとって重要な長さで、リトリーバル、指示保持、証拠利用を評価してください。
Price and Cost Efficiency
Xiaomi の海外向け 従量課金価格 はトレードオフを明確に示します。
| Pricing — official price sheet | V2.5 | Pro | Ratio |
|---|---|---|---|
| Uncached input per 1M tokens | $0.14 | $0.435 | 3.11× |
| Cached input per 1M tokens | $0.0028 | $0.0036 | 1.29× |
| Output per 1M tokens | $0.28 | $0.87 | 3.11× |
| Context window | 1M | 1M | 同じ |
| Maximum output | 128K | 128K | 同じ |
1M のキャッシュされていない入力トークンと 200K の出力トークンを含むリクエストは、キャッシュヒット、ウェブ検索料金、プロバイダ特有の課金を考慮する前で、V2.5 では概算 $0.196、Pro では $0.609 の費用です。
キャッシュ価格の差は小さく、キャッシュヒット入力では Pro は約 29% 高いだけで、標準トークン価格の 211% 高よりも小さくなります。安定したシステムプロンプト、ツール定義、リポジトリのプレフィックスを持つ長時間稼働エージェントは、実際のキャッシュヒット率を測定すべきです。
成功したタスクあたりのコストを見積もってください。難しいワークフローを 1 回で完了する Pro のエージェントは、安価なモデルでの失敗の繰り返しよりも結果的に安くなる場合があります。
Which Model Should You Use?
| Workload — official guidance | Better choice | Why |
|---|---|---|
| Routine text chat | V2.5 | 低コスト。Pro は不要な場合が多い |
| High-volume generation | V2.5 | 標準トークン価格が約 3.1× 低い |
| Image, video, or audio understanding | V2.5 | ネイティブなマルチモーダル入力 |
| Routine tool calling | V2.5 | 低コストで強力なエージェント機能 |
| Difficult mathematics and science | Pro | 大きいベンチマーク上の向上 |
| Repository-scale coding | Pro | 複雑なソフトウェア工学向けに設計 |
| Hundreds of dependent tool calls | Pro | 持続的な実行により適合 |
| Cost-sensitive 1M context | V2.5 | 同じ公称コンテキストで大幅に低コスト |
選択結果: V2.5 はマルチモーダルアプリケーション、日常的なエージェント、コスト重視のワークロードにおけるデフォルトです。Pro は、困難な推論、複雑なソフトウェア工学、長時間の自律トラジェクトリに向けたアップグレードです。
A Better Production Strategy: Route Between Both
単一のグローバルなモデル選択は必須ではありません。マルチモーダルと日常的なリクエストは V2.5 にルーティングし、難しいテキスト推論、複雑なコーディング、長期の実行のみを Pro にエスカレーションしましょう。
| Evaluation dimension | Measure | Why it matters | Routing signal |
|---|---|---|---|
| Completion | Successful tasks / attempts | エンドツーエンドの信頼性を捉える | 完了率の低いクラスをエスカレーション |
| Quality | Human or rubric score | トークンコストが支配的になるのを防ぐ | 高リスクタスクをエスカレーション |
| Tool reliability | Errors and retries | 小さなエラーがエージェントで累積する | 長いトラジェクトリをエスカレーション |
| Latency | Time to accepted result | リトライのオーバーヘッドを含む | 対話的タスクは軽量に維持 |
| Cost | Spend per accepted task | 失敗と再実行を反映 | 成功する中で最も安価なモデルを使用 |
Test Both APIs in CometAPI
MiMo-V2.5 API in CometAPI と MiMo-V2.5-Pro API in CometAPI は、1 つの集約レイヤーを通じて並列評価をサポートします。同じプロンプト、システム指示、ツール、出力上限を両モデルへ送信し、タスク成功とコストを比較してください。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

models = ["mimo-v2.5", "mimo-v2.5-pro"]
prompt = """
Review this implementation plan.
Identify hidden technical risks and propose the three highest-priority fixes.
"""

for model in models:
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=2000,
    )
    print(f"\n--- {model} ---")
    print(response.choices[0].message.content)
代表的なバッチを実行し、平易なリクエスト、難しい推論、コード編集、長コンテキスト、エージェントのツール呼び出しを含めてください。完了率、トークン、レイテンシ、ツールエラー、リトライ、回答品質、成功タスクあたりのコストを記録します。
Limitations
V2.5 limitations
より小さい言語バックボーンは、推論の難易度が上がるほど性能差を生みます。差は BBH では控えめですが、GPQA-Diamond や MATH でははるかに大きくなります。1M-token のコンテキストウィンドウも、1M-token の推論忠実度を保証するものと混同すべきではありません。
Pro limitations
Pro の通常の入出力価格は V2.5 の約 3.1× であり、テキストのみの入力はマルチモーダルアプリケーションのドロップイン置換として不適です。また、1.02T-parameter のオープンウェイトモデルは、トークンごとに 42B のパラメータが活性化されるとはいえ、自前ホスティングでは要求が高いプロジェクトです。
Final Verdict
マルチモーダルアプリケーション、日常的なエージェント、コスト重視の本番運用には V2.5 を選びましょう。困難な推論、複雑なソフトウェア工学、長時間の自律エージェントには Pro を選びましょう。混在ワークロードでは、トラフィックの大半を V2.5 にルーティングし、難易度やトラジェクトリの長さが追加コストを正当化するリクエストのみを Pro にエスカレーションしてください。
FAQ
Is Pro always better than V2.5?
いいえ。Pro は難しいテキスト推論とコーディングでより強力ですが、V2.5 は画像・動画・音声入力をサポートし、コストも大幅に低いです。
Do both models support a 1M-token context window?
はい。どちらも 1M-token のコンテキストと最大 128K の出力トークンを掲示しています。実際の運用長でのリトリーバルと推論をテストしてください。
Which model should a multimodal agent use?
V2.5 から始めてください。これはネイティブにビジュアルと音声入力を受け付けます。Pro は現時点ではテキスト入力ワークフローを対象としています。
When is Pro worth its higher price?
より良い推論の信頼性が、難しい数学、リポジトリ規模のコーディング、または多くの依存ツール呼び出しを含む長いトラジェクトリの完了に影響する場合に、最も防御可能です。
Should production systems use only one model?
必ずしもそうではありません。ルーティングレイヤーにより、日常的・マルチモーダルの作業は V2.5 に維持し、難しいテキストやエージェントタスクのみを Pro にエスカレーションできます。