Choose your path
Qwen ブログ
Qwen 3.8 Max をローカルにデプロイする方法:ハードウェア、vLLM、SGLang、量子化に関するガイド
以下は、Qwen 3.8 Max(開源重み Qwen3.8-2.4T-A95B)をローカルデプロイするための実践ガイドです。vLLM/SGLang、FP8/FP4、最大 1M コンテキスト、そして本番最適化の観点を網羅します。 前提 - モデルは 1M コンテキスト用に事前対応済み(訓練/微調整+RoPE/NTK/YaRN 等の長文設定が含まれる)であることが望ましい。未対応チェックポイントに単純なスケーリングを適用すると品質・安定性が大きく劣化します。 - Hopper 世代(H100/H200/B100 など)の GPU を推奨(FP8、FlashAttention 世代最適化の恩恵が大きい)。 モデル取得 - 例(Hugging Face/ModelScope から LFS で取得・ローカル配置): $ git lfs install $ git clone /models/Qwen3.8-2.4T-A95B - trust_remote_code が必要な場合は読み込み側で有効化(セキュリティポリシーに注意)。 GPU要件の見積もり(目安) - 重み(推論のみ): - FP16/BF16: 約 2.0 GB × 1B パラメータ → 95B なら約 190 GB - FP8(weight-only + scale/metadata 含む): 約 1.1–1.2 GB × 1B → 95B なら約 105–115 GB - 4-bit(AWQ/GPTQ 等 weight-only): 約 0.55–0.6 GB × 1B → 95B なら約 52–57 GB - KV キャッシュ(非常に支配的。概算・GQA 前提の目安): - FP16 相当で約 320 KB/トークン(GQA により MHA 比で圧縮済みと仮定) - FP8 で約 160 KB/トークン、FP4 で約 80 KB/トークン - 例: 128k トークンなら FP8 KV ≈ 160 KB × 128k ≈ 約 20 GB、1M トークンなら ≈ 約 160 GB - 実運用では 1M を常時保持するのは現実的でないことが多く、スライディングウィンドウ/KV オフロード/分割プリフィル等と併用するのが一般的。 量子化(FP8/FP4)の選択肢 - FP8 - Hopper 世代推奨。weight-only の FP8 チェックポイントを利用するのが安定。KV キャッシュも FP8 化できるランタイムなら併用でメモリ削減。 - FP4(4-bit) - AWQ/GPTQ/HQQ 等の weight-only 量子化チェックポイント推奨。自前量子化する場合は AutoAWQ/GPTQ ツールチェーンで生成し、vLLM/SGLang が読み込める形式で保存。 - 品質の要点 - 4-bit は大幅に省メモリだが長文・推論安定性への影響が大きい。Max クラスの長文前提なら FP8 を基準に、必要に応じて 4-bit を評価。 vLLM での起動(例) - インストール(CUDA/torch は環境に合わせる): $ pip install "vllm>=0.5.4" - OpenAI 互換 API サーバ: $ python -m vllm.entrypoints.openai.api_server \ --model /models/Qwen3.8-2.4T-A95B \ --tensor-parallel-size 8 \ --dtype auto \ --max-model-len 1048576 \ --gpu-memory-utilization 0.90 \ --served-model-name qwen38-max \ --host 0.0.0.0 --port 8000 - 量子化・長文向けの追加例(環境・モデル対応に依存): - KV キャッシュ圧縮: --kv-cache-dtype fp8(対応環境)または fp16/bf16 から選択 - チャンク化プリフィル: --enable-chunked-prefill True(大規模一括投入時の帯域効率改善) - CPU オフロード(足りない場合): --swap-space (NVMe と組み合わせ) - シャーディング: --tensor-parallel-size N を GPU 台数に合わせる - 量子化重み: --quantization awq/gptq(該当フォーマットのモデルに一致させる) - クライアント呼び出し(OpenAI 互換): - base_url=http://:8000/v1 model=qwen38-max を指定して chat/completions 等を利用。 SGLang での起動(例) - インストール: $ pip install "sglang>=0.3.2" - サーバ起動(例): $ python -m sglang.launch_server \ --model /models/Qwen3.8-2.4T-A95B \ --tp 8 \ --host 0.0.0.0 --port 8000 - 量子化・長文向けの追加例(実装バージョンに依存): - --quantization awq/gptq - --kv-cache-dtype fp8(対応時) - --max-context-len 1048576(モデル対応が前提) - RadixAttention/Chunked prefill/Prefill–decode 並列化などの最適化フラグを有効化 1M コンテキスト運用のポイント - モデル側前提 - 1M に対応したチェックポイントを利用(config.json の rope_scaling/positional 設定が既に含まれていることが望ましい)。 - ランタイム側 - KV キャッシュ圧縮(fp8/fp4)やオフロード(CPU/NVMe)、チャンク化プリフィル、スライディングウィンドウを併用。 - 実際は 1M を常時保持せず、重要ブロックを残しつつ古いブロックを捨てる/圧縮する戦略が現実的。 - アプリ設計 - 検索拡張(RAG)や要約・圧縮、階層化メモリを併用して実効コンテキストを制御。 本番最適化チェックリスト - 性能 - FlashAttention 2/3、Tensor Cores を活かす CUDA/ドライバを整備。 - バッチング/スケジューラ(vLLM/SGLang のデフォルト)を活用。max_num_seqs、max_tokens_per_batch をワークロードに合わせ調整。 - Speculative decoding/Chunked prefill/Continuous batching を有効化(サポート時)。 - Tensor parallel の分割数を GPU 台数・NVLink 括りに合わせ最適化。 - メモリ - FP8/FP4 の weight-only+KV 圧縮、KV の CPU/NVMe オフロードを組み合わせて「重み+KV」の合計が収まるよう設計。 - 長文要求が少ないトラフィックは短い max_model_len のプールへ分流(SLO を層分け)。 - 安定性/運用 - ウォームアップ(典型長で事前実行)、固定長プロンプトのキャッシュ、分散障害時のヘルスチェックと自動復旧。 - プロメテウス/ログ集約でトークンレイテンシ、KV ブロック使用率、OOM 直前指標を可視化。 - ノード間は NCCL/TCP チューニング(NVLink 推奨、跨りはレイテンシ増に注意)。 - 品質 - 量子化(特に 4-bit)は長文・推論安定性を A/B 測定。重要ジョブは FP8 を基準、必要なら混在デプロイ(ルーティング)で最適化。 - セキュリティ/再現性 - trust_remote_code の管理、モデル/依存の固定(hash/pin)、容器化(Docker/OCI)と CUDA 互換層の固定。 代表的な構成例(目安) - 構成A(高品質・長文重視): 8×H100 80GB, FP8 weight-only, KV=FP8, max_model_len 128k(ピーク時のみ 512k〜1M をスイッチ)、CPU/NVMe オフロード有。 - 構成B(省メモリ・高密度): 4×H100 80GB, 4-bit weight-only(AWQ/GPTQ), KV=FP8, max_model_len 64k〜128k、長文要求は別プールへ転送。 - 構成C(大規模 1M 実験): 8–16×H100 80GB 以上, FP8 weight-only, KV=FP4/FP8 併用、強オフロード+チャンク化プリフィル+スライディングウィンドウ、長文は分割投入。 トラブル対処の要点 - OOM: max_model_len/並列度/バッチサイズを下げる、KV 圧縮/オフロードを強化、TP を増やして再配置。 - 性能伸び悩み: スループット系フラグ(chunked prefill/continuous batching/speculative)とバッチ閾値を再調整、PCIe/ネットワーク帯域を確認。 - 品質低下: 量子化ビット幅/グループサイズを緩和、FP8 に戻す、長文時のみ高精度プールを使用。 補足 - 実際の起動フラグ名やサポート状況は vLLM/SGLang のバージョンで変わります。該当バージョンの --help とリリースノートを確認し、モデルの量子化形式・長文設定と揃えてください。
Qwen4 はまもなく 登場: Qwen3.8-Flash-Next が明らかにすること
Qwen3.8-Flash-Next から見えてくる Qwen4 のアーキテクチャ、期待される機能、ベンチマークの方向性、リリース見通しを探る
Qwen3.8-Flashとは? スペック、ベンチマーク、アーキテクチャ、料金、APIガイド
Qwen3.8-Flash とは何かを、6B-active の MoE アーキテクチャ、1M コンテキスト、ベンチマーク、価格、比較、CometAPI の使用方法を含めて学ぶ。
Qwen3.8 Max とは何ですか?
Qwen3.8-Max 解説:機能、ベンチマーク、Kimi K3 と DeepSeek V4 Flash の比較
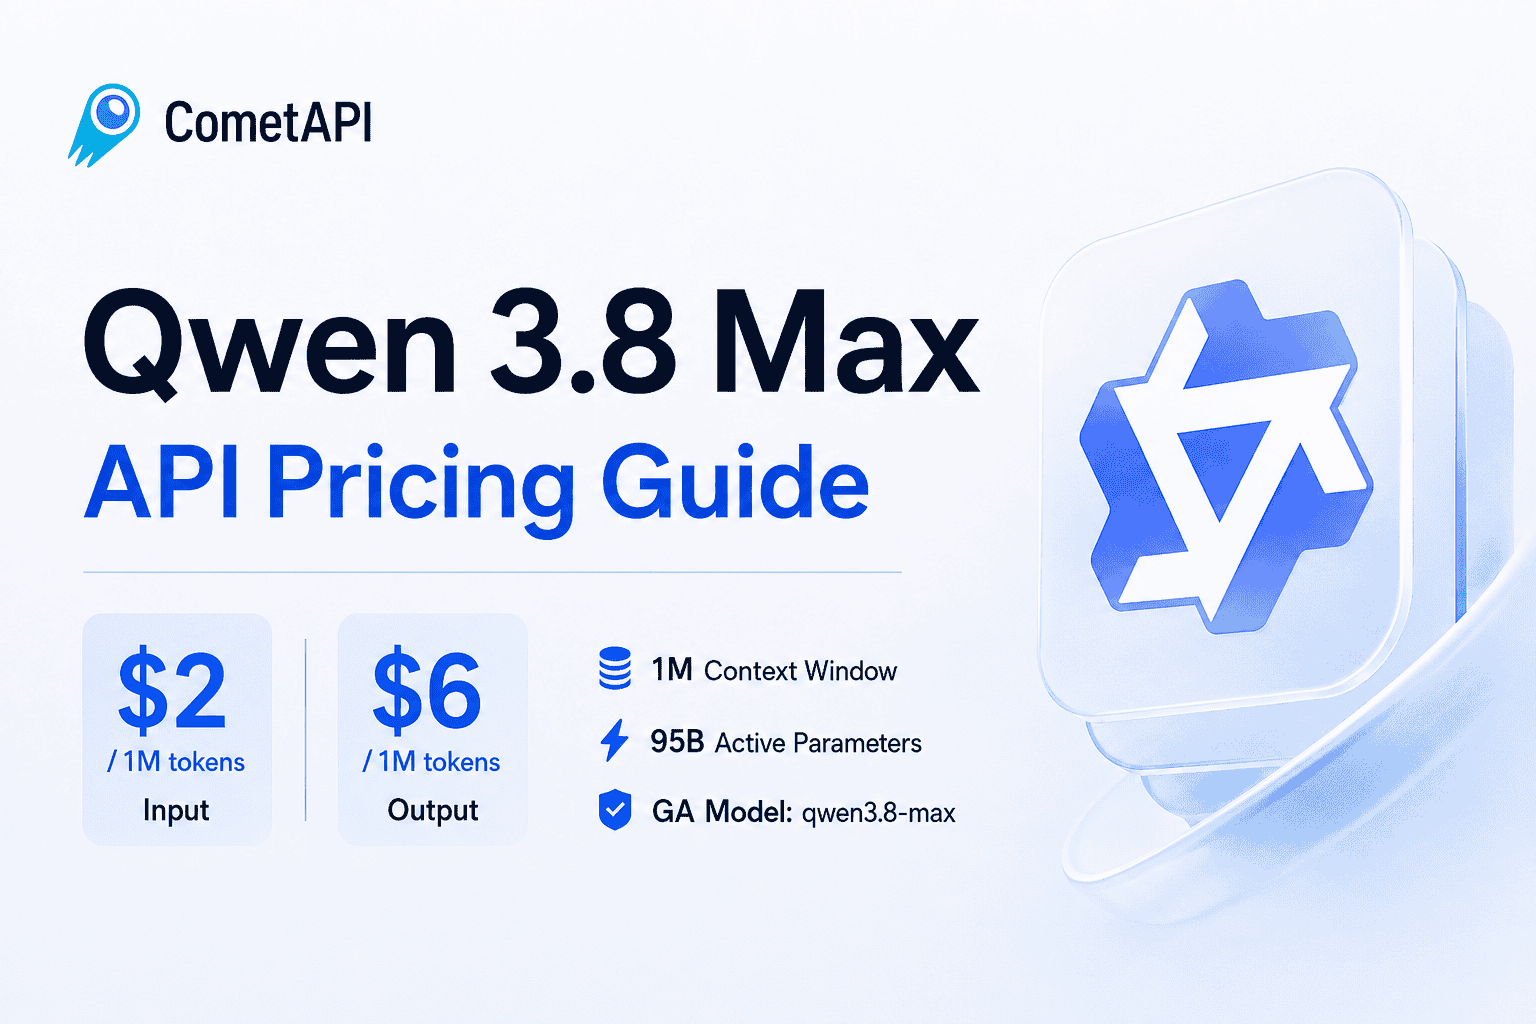
Qwen 3.8 Max API の料金: $2 入力、$6 出力、1M コンテキスト
Qwen 3.8 Max の料金は、入力$2/M、出力$6/Mです。キャッシュ料金、ツールコスト、実例、制限、および Qwen 3.7 からの移行アドバイスを比較してください。
Qwen3.8 Max Preview API:アクセス、提供状況、および移行ガイド
结论(基于截至 2024-10 的信息):我无法确认“Qwen3.8 Max”API 当前是否已正式上线。建议按下列步骤即时核实其可用性、定价与规格,并据此评估是否从“Qwen3.7 Max”迁移。 一、如何快速核实可用性 - 在 DashScope/百炼控制台查看模型列表:登录控制台,进入模型目录或调用区,搜索“Qwen3.8 Max/3.8-Max/3.8”同名或近似名条目。 - 官方文档与公告:查看 DashScope 产品文档与更新公告、定价页面、OpenAI 兼容模式说明。 - 用 API 枚举模型(OpenAI 兼容模式): - curl -s https://dashscope.aliyuncs.com/compatible-mode/v1/models -H "Authorization: Bearer $DASHSCOPE_API_KEY" - 若返回列表中包含目标模型(如 qwen3.8-max 等),则可用;否则待发布或需开通白名单。 - 用一次最小请求验证: - curl https://dashscope.aliyuncs.com/compatible-mode/v1/chat/completions -H "Authorization: Bearer $DASHSCOPE_API_KEY" -H "Content-Type: application/json" -d '{"model":"qwen3.8-max","messages":[{"role":"user","content":"hello"}]}' - 若返回 model_not_found/permission 错误,说明未开放或未授权。 二、当前定价与获取方式(以官方页面为准) - 定价查询路径: - DashScope 定价页(含输入/输出按千 token 计费、免费额度、包年包月/预付费等)。 - 控制台计费与用量明细(可核对实际扣费口径与限额)。 - 典型接入方式: - DashScope 原生 REST API(chat/completions 类接口)。 - OpenAI 兼容模式(/v1/models、/v1/chat/completions 等)。 - SDK:官方 Python/JavaScript 等。 - 控制台在线调试与可视化工作台。 - 注意项: - 新型号可能采用与“Qwen-Max/Qwen-Plus/Qwen-Turbo”不同的单价与限流档位,务必以定价页与控制台限额为准。 - 企业/私有化场景可能需开通特定实例或白名单。 三、关键规格核对清单(上线后请对照官方规格表) - 上下文窗口与最大输出:总上下文 token、max_output_tokens。 - 模态能力:纯文本/含图像/多模态、图像输入尺寸与数量限制。 - 工具调用/函数调用:schema 支持、并行调用、JSON 模式稳定性。 - 结构化输出:JSON/严格模式、格式约束与容错。 - 检索/长文本:内置检索或需外部 RAG;长上下文性能。 - 安全与合规:内置安全策略、敏感内容处理差异。 - 性能指标:平均/尾延迟、吞吐、并发与速率上限(TPS/TPM/RPM)。 - 兼容性:OpenAI 兼容参数支持情况、系统/开发者消息权重、temperature/top_p 等采样参数行为。 - 版本与可用区:区域可用性、稳定版/实验版标识。 四、是否从 Qwen3.7 Max 迁移:决策与实践建议 - 适宜迁移的信号: - 官方给出更长上下文、更强推理/工具调用稳定度,且单位成本可接受。 - 关键任务评测(你方私有评测集)通过率与一致性优于 3.7。 - 兼容 OpenAI 模式且仅需更换 model 名即可平滑切换。 - 保守观望的信号: - 成本大幅上升但质量收益有限;或速率/并发更严格。 - 对结构化输出/安全策略有明显变更,可能影响业务解析或通过率。 - 迁移步骤(建议 A/B 与灰度): - 接口兼容性:在测试环境仅替换模型名,保持相同请求参数与超时策略。 - 质量对比:用你方评测集对比事实性、格式稳定性、工具调用正确率、代码/函数生成可执行率。 - 成本与配额:按你方真实平均 prompt/输出长度重估 1k token 成本与日配额。 - 参数回归:temperature/top_p、max_output_tokens、工具 schema/JSON 模式逐项回归。 - 提示词与安全:视可能的风格/冗长度变化对系统提示做微调;核验安全拦截差异。 - 回退与版本钉扎:保留 3.7 回退通道;在路由层按业务风险分流与权重逐步提升。 - 观测与报警:覆盖成功率、延迟、超时、格式错误率与异常费用报警。 五、如需我协助 - 你可提供:当前调用方式(REST/兼容模式/SDK)、所在区域、现行费用与限额、核心用例与评测指标。我可据此给出更具体的核查命令、迁移清单与 A/B 设计。 提示:请以 DashScope/百炼控制台与官方定价与文档为准,一旦确认“Qwen3.8 Max”条目与定价公布,即可按上面的自检与灰度流程推进。
Qwen3.7 Plus APIの2026年料金: コスト、キャッシュ & バッチ
Alibaba ルート、コンテキスト長、キャッシュ利用、バッチジョブ別の Qwen3.7 Plus API コストの違いを、比較用の CometAPI 料金も含めてご確認ください。
CometAPI を使用して Open WebUI を AI モデルに接続する方法
CometAPI を使用して Open WebUI を 500+ の AI モデルに接続する方法を学びましょう。OpenAI 互換ゲートウェイを設定して、本番 API コストを 20-40% 節約しましょう。