Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
無料で始める 無料で始める
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
Home Blog Openclaw における GPT-5.4 ガイド: メリット、設定 & ベストプラクティス
guide / CometAPIリサーチ
Openclaw における GPT-5.4 ガイド: メリット、設定 & ベストプラクティス OpenClaw の最新リリースでは、OpenAI の GPT-5.4 へのファーストクラスかつ将来互換のサポートが追加され、さらに「メモリのホットスワップ可能」アーキテクチャを導入しました。これにより、OpenClaw エージェントは実行時に、アクティブなモデルとメモリストアを最小限の影響で切り替えられます。これが、大規模コンテキストのワークフロー(GPT-5.4 の拡張されたコンテキストウィンドウ)、オンザフライでのモデル特化、本番環境のエージェントにおけるコスト/レイテンシの最適化を実現します。アップグレードは OpenClaw のリリースおよび付随ドキュメントで利用可能です。以下の例では、実用的な設定、コードスニペット、ベンチマークのコンテキスト、および推奨ベストプラクティスを示します。
OpenClaw の最新リリースでは、OpenAI の GPT-5.4 へのファーストクラスかつ将来互換のサポートが追加され、さらに「メモリのホットスワップ可能」アーキテクチャを導入しました。これにより、OpenClaw エージェントは実行時に、アクティブなモデルとメモリストアを最小限の影響で切り替えられます。これが、大規模コンテキストのワークフロー(GPT-5.4 の拡張されたコンテキストウィンドウ)、オンザフライでのモデル特化、本番環境のエージェントにおけるコスト/レイテンシの最適化を実現します。アップグレードは OpenClaw のリリースおよび付随ドキュメントで利用可能です。以下の例では、実用的な設定、コードスニペット、ベンチマークのコンテキスト、および推奨ベストプラクティスを示します。
この要約で素早く答えを把握し、ガイドで背景、例、実装詳細を確認してください。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)TL;DR: OpenClaw の最新リリースは、OpenAI の GPT-5.4 に対するファーストクラスかつ将来互換のサポートを追加し、OpenClaw エージェントが実行時にアクティブなモデルとメモリストアを最小限の中断で切り替えられる「メモリのホットスワップ可能」アーキテクチャを導入しました。これにより、大規模コンテキストのワークフロー(GPT-5.4 の拡張コンテキストウィンドウ)、オンザフライのモデル特化、そして本番エージェントにおけるコスト/レイテンシ最適化が可能になります。アップグレードは OpenClaw のリリースと付随ドキュメントで提供され、以下の例では実践的な設定、コードスニペット、ベンチマークの文脈、推奨ベストプラクティスを示します。
OpenClaw のアップデートで実際に出荷されたもの(簡潔なまとめ)
2026年3月9日 、オープンソースのエージェントフレームワークである OpenAI 隣接プロジェクトの OpenClaw は、コアのメジャーリリース(2026.3.7)を出荷し、GPT-5.4 へのファーストクラスのサポートと、コンテキストエンジンにおける新しい「メモリのホットスワップ可能」メカニズムを追加しました。このリリースにより、広く使われてきた実験的エージェントフレームワークが、メンテナが「エージェント用 OS」と表現するものへと変貌し、開発者とチームが本番グレードのエージェントワークフローやモデル切り替えをシームレスに行えることを目指しています。
明確性、出典の帰属、最新のAPI用語について確認済みです。
エージェント構築者にとって重要な実用的ポイント 3 点:
GPT-5.4 のファーストクラスサポート — モデルエイリアスとプロバイダーマッピングにより、エージェントが GPT-5.4 を主要な実行モデルとして選択可能(チャネルごとの上書きやエージェント単位でのモデルピン留めを含む)。コンテキストエンジンと分散チャネルバインディング — OpenClaw がメモリ、ツール出力、チャネル履歴から長大なコンテキストを組み立てる方法を改善し、高容量モデルに構造化された入力を提供。メモリのホットスワップ可能アーキテクチャ — メモリプラグインのインターフェースとワークフローを明確化し、メモリバックエンドの置換やエージェントのアップグレード時に「アイデンティティ」を失ったり、永続状態を破損したりしないように(メモリ自体が単一の信頼できる情報源であり続ける)。OpenClaw のメモリ設計(プレーンな Markdown ファイル、インデックス化検索、プラグイン化されたリトリーバル)が安全なホットスワップを可能にしています。
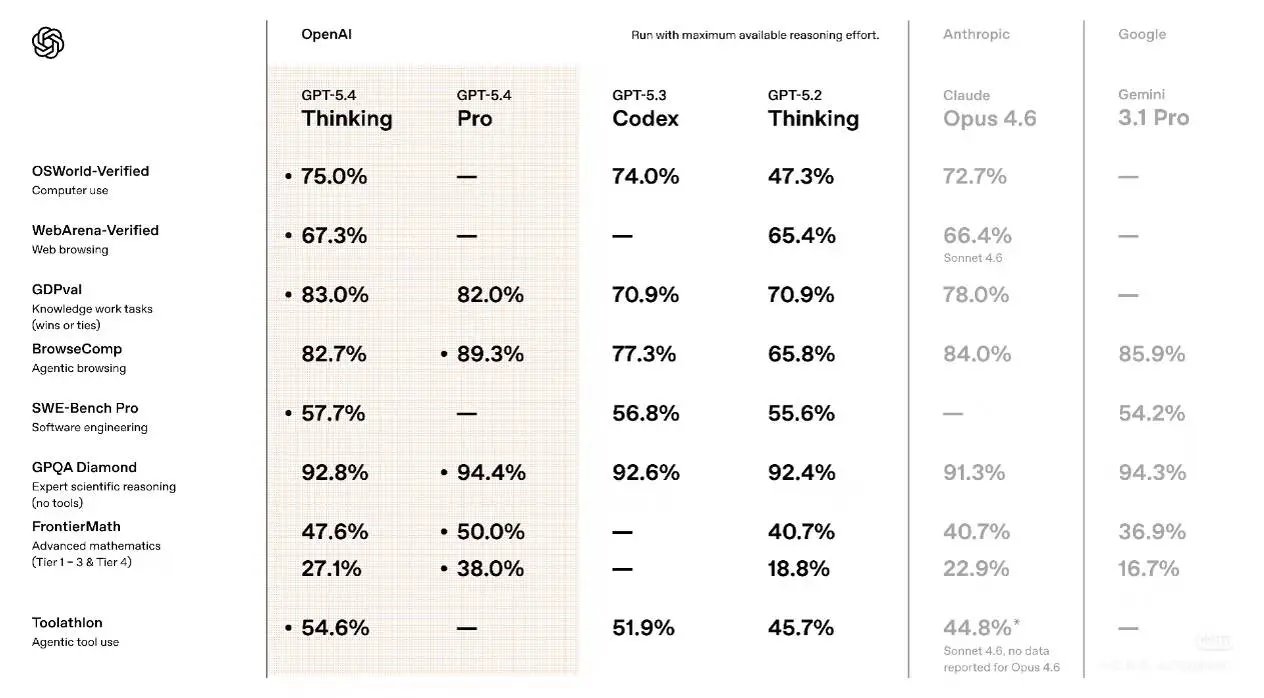
GPT-5.4 — GPT-5.4 の概要とブレークスルーベンチマーク GPT-5.4 は、最新の OpenAI フロンティアモデルで、特に「プロフェッショナルな生産性」(スプレッドシート、ドキュメントやプレゼン編集、多段推論とツール駆動)に重点を置いています。OpenAI と独立系メディアの報道によれば、このリリースは以下を強調しています:
拡張コンテキスト : GPT-5.4 は次のレベルのコンテキストウィンドウを導入し、実験的な 100万トークンと改良された長文コンテキスト処理を Codex/Codex 互換エンドポイント経由で提供します。model_context_window や model_auto_compact_token_limit といった設定ノブが開発者向けに公開されており、より大きな会話状態、ドキュメント、コードベースをアクティブなコンテキストに保持できます。スプレッドシートと推論の精度向上 — OpenAI は、銀行/アナリスト向けスプレッドシートベンチマークでの平均スコアが GPT-5.2 の約 68% に対し GPT-5.4 では約 87% に大幅改善したと報告しています。正確性とファクト性の改善 : 初期レビューと QA によれば、GPT-5.2 と比べて「幻覚」の発生が約 33% 減少し、特定の生産性タスクにおける誤りを伴う出力が約 18% 減少。ドキュメント作成やスプレッドシート作業で顕著な改善が見られます。コンピュータ操作の統合と Codex 系譜の改良 — GPT-5.4 は Codex 系譜から継承された機能により、コード生成、対話的デバッグ、運用ツールの駆動(マウス/キーボード/スクリーンショット自動化のデモもあり)を改善。これはエージェントループに典型的な write-run-inspect-patch サイクルをより得意にします。
ベンチマークと比較文脈(数値の意味)
スプレッドシート・モデリング : OpenAI の内部スプレッドシート・ベンチマークにて、GPT-5.4 の平均スコアは約 87.3% 、GPT-5.2 は 68.4% 。これは特定タスクの性能向上を示すベンダーの目玉数値です。コンピュータ操作(OSWorld / エージェント型テスト) : 独立テスターやコミュニティの実行では、デスクトップやシミュレートされた UI 操作を伴うエージェント相互作用タスクで GPT-5.4 が改善を示し、タスクスイートによっては最近の Anthropic 系モデルに対し僅差で上回るケースも(エージェントには意味のある差ですが、全ワークロードで決定的とは限りません)。
解釈: GPT-5.4 は「すべてに勝つ魔法の弾丸」ではありません。統合ツール利用、コード実行パターン、スプレッドシート推論に明確な強みがあります—まさに OpenClaw エージェントが頻繁に実行するワークロードです。エージェント構築者にとって、実行器の信頼性向上(Codex 系譜)+プランナー能力+長文コンテキスト処理の改善という組み合わせは非常に重要です。
OpenClaw が GPT-5.4 をサポート:何が変わり、なぜ重要か OpenClaw のリリース(プロジェクトのリリースページ参照)は、モデルリゾルバとランタイムを更新して、GPT-5.4 の拡張コンテキストとトークン上限に将来互換で対応し、「メモリのホットスワップ可能」を追加して、エージェントが実行時にメモリバックエンドやモデルを切り替えられるようにしました。これは具体的に 3 つの方法で実装されています:1) より大きなコンテキストとトークン上限を受け付けるモデルメタデータとリゾルバの更新;2) モデルのスムーズな切り替えとキャッシュのウォームアップをオーケストレーションするエージェントランタイムの変更;3) 複数メモリチャネルとホットスイッチトリガーを許可するメモリ API。
バージョン 2026.3.7 における GPT-5.4 サポートと「メモリのホットスワップ可能」設計は、実用的で相補的な 2 つの利点を提供します:
単純明快なモデルアップグレード経路。 OpenClaw は GPT-5.4 をエージェントの選択可能な「ランタイム」として提示でき、従来の GPT-5.x モデルや他ベンダーからエージェントロジックを作り直すことなく切り替え可能。OpenClaw のアップデートはコアにおける安定した GPT-5.4 統合を明示しています。メモリのホットスワップ。 単一の線形メモリスナップショットを永続化する代わりに、OpenClaw のコンテキストエンジンはメモリパーティションを実行時に切り離し、スワップし、移行できるようにします—例:デバッグのために高リコールのベクタ DB シャードへスワップ、外部監査のために GDPR サニタイズ済みメモリへスワップ—エージェントを停止せずに。これにより本番での中断リスクが下がり、ユースケース特化のメモリ構成(デバッグ vs プライバシー vs パフォーマンス)が可能になります。
実践的な性能ブレークスルーと利点 OpenClaw の統合は、GPT-5.4 が強みを持つ 3 つの実践領域に焦点を当てています:
ツールオーケストレーションの精度。 GPT-5.4 の内部ツール探索と推論の改善によりツールコールの無駄打ちが減少(冗長なツール呼び出しやリトライが減る)。結果、複雑なフローでの API コール削減や高速化につながります。初期報告では、旧 GPT-5.x モデルと比べてトークンおよびツールコールの効率性が改善。より長く、より豊かなコンテキスト処理。 OpenClaw エージェントは、(スワップインされたメモリシャードを含む)はるかに大きなアクティブコンテキストを保持でき、長い会話、複数ファイルのプロジェクト、反復デバッグを状態を失わずに扱えます。より決定的なコード出力。 自動コード生成(CI フック、関数スタブ、インフラテンプレート)を行うワークフローで、GPT-5.4 はより一貫性があり実行可能な出力を生成する傾向が強く、人手レビューの負担を軽減。独立テストでも、従来の GPT-5 モデルに比べコード品質指標の明確な改善が示されています。メモリの継続性 — 「メモリのホットスワップ可能」により、エージェントの状態やコンテキストを失うことなくメモリストア(ローカルキャッシュ、ベクタ DB、LLM メモリ)を交換・拡張でき、A/B テスト、ローリングアップグレード、フェイルオーバーが可能になります。 OOLONG ベンチマークテスト において、lossless-claw プラグインと組み合わせた新バージョンの OpenClaw は 74.8 の高スコアを達成し、Claude Code(70.3 点)を大きく引き離しました。特に、コンテキスト長が増えるにつれて OpenClaw は安定性と精度を示し、現場でテストを行っていたエンジニアからは「よく動く、と言うのは控えめすぎる」との声が上がりました。
OpenClaw で GPT-5.4 を設定・利用する方法(ステップバイステップ) GPT 5.4 を用いたシンプルな OpenClaw ワークフロー:
代表的な構成は以下のとおりです。
ユーザーは Discord や Telegram などのプラットフォーム経由でメッセージを送信。
OpenClaw はゲートウェイサーバーを通じてメッセージを受信。
ゲートウェイは AI API プロバイダー経由で GPT 5.4 にプロンプトを転送。
GPT 5.4 は応答を生成するか、ツールアクションをトリガー。
OpenClaw は最終結果をユーザーに返送。
以下は、OpenClaw で GPT-5.4 を安全かつ再現性高く動かすための、実践的でコピペ可能な設定例とワークフローです。意図的に保守的な設定とし、まずはテストエージェントでモデルを有効化し、メトリクスとエラーの計測を仕込みます。
Prerequisites - GPT-5.4 マッピングを含むリリースに OpenClaw をアップグレード済み(上記リリースノートを参照)。
GPT-5.4 にアクセス可能な有効な OpenAI API キー(私はより安価な CometAPI エンドポイントを選びます)。
1) モデル選択とリゾルバ設定(Json/ YAML / CLI) ~/.openclaw/openclaw.json に以下を記載(または既存設定にマージ)。環境に応じてプロバイダー名とトークン参照を調整してください。
</>JSON
{
  "agents": {
    "defaults": {
      "model": {
        "primary": "openai/gpt-5.4",
        "fallbacks": ["openai/gpt-5.3", "claude/opus-4.6"]
      },
      "workspace": "~/.openclaw/workspace"
    }
  },
  "models": {
    "providers": {
      "openai": {
        "api_key_env": "ComtAPI_API_KEY",
        "base_url": "https://api.cometapi.com/v1"
      }
    }
  },
  "plugins": {
    "slots": {
      "memory": "memory-core"
    }
  },
  "channels": {
    "modelByChannel": {
      "support-team": "gpt-5.4",
      "low-cost-batch": "gpt-5.3"
    }
  }
}
OpenClaw はモデルリゾルバを使用して、論理モデル名(例:openai/gpt-5.4)をエンドポイントとランタイム設定にマッピングします。リゾルバファイルを追加または更新してください(例 models.yml):
</> YAML
# models.yml - OpenClaw model resolvers
models:
  openai/gpt-5.4:
    provider: openai
    model_id: gpt-5.4
    context_window: 1050000   # forward-compatible 1,050,000 tokens
    max_output_tokens: 128000
    api_base: "https://api.openai.com/v1"
    timeout_seconds: 120
    rate_limit_factor: 1.0
</> Bash
# Switch OpenClaw to use GPT-5.4 for the current agent session
openclaw model set openai/gpt-5.4
Note: The context_window and max
agents.defaults.model.primary はデフォルトモデルを指定します。channels.modelByChannel を使ってチャネル単位の上書きを行い、重要度の高いチャネルを GPT-5.4 に、要求の軽いチャネルを安価なモデルに振り分けられます。順序の意味付けは OpenClaw のモデル選択ドキュメントを参照。具体的なモデル名は CometAPI のモデルページを参照してください。OpenAI を使用したい場合は、URL と API キーを OpenAI のものに置き換えてください。
context_window と max_output_tokens キーは、OpenClaw のリゾルバにおける将来互換の変更を反映しており、エージェントが古い Codex の上限を前提に動作しないようにします。
2) 「メモリのホットスワップ」を有効化してテストする方法 OpenClaw のメモリサブシステムはファイルベース(Markdown ファイル)で、インデクサ/検索プラグインを組み合わせる設計のため、生のメモリファイルを失わずにバックエンドプラグイン(例:SQLite ベクタ、Milvus、外部メモリサービス)を安全に切り替えられます。
メモリの場所を標準化 : git バックアップされたワークスペース ~/.openclaw/workspace/ を使用し、MEMORY.md と memory/YYYY-MM-DD.md を権威情報源にする。メモリプラグイン(例:sqlite-vec)をインストール・設定 し、設定内の plugins.slots.memory をそのプラグインに向ける。移行テスト : 新しいプラグインを追加し、シャドウインデクシングを実行、検索結果を比較し、満足できたら plugins.slots.memory のエイリアスを新プラグインに切り替える。 プラグインエイリアスのスワップ例(bash 擬似コマンド):
# install new plugin (example package)pip install openclaw-memory-sqlite-vec# update config safely (backup first)cp ~/.openclaw/openclaw.json ~/.openclaw/openclaw.json.bak# then edit JSON: plugins.slots.memory = "memory-sqlite-vec"# reload gateway (safe restart)systemctl restart openclaw || openclaw gateway restart# run a retrieval consistency check using the test harnessage openclaw test memory_consistency --samples 100
なぜ「ホットスワップ可能」なのか: メモリファイルが「単一の信頼できる情報源」であり続けるためです。プラグインはインデクシングとリトリーバル層を実装し、プラグインの交換は再インデックスを行いますが、基になる .md ファイルは変更しません。これにより、モデルの切り替えを行っても深刻なアイデンティティのドリフトが起きにくく—エージェントは同じ MEMORIES を読み続けます。
3) 個別エージェントを GPT-5.4 にピン留めする(エージェント単位の上書き) エージェント単位でモデルを上書きできます。以下のようにエージェントエントリを追加:
{
  "agents": {
    "my-analyst-agent": {
      "model": {
        "primary": "gpt-5.4"
      },
      "workspace": "~/.openclaw/workspace/analyst"
    }
  }
}
コミュニティリリースやあなたの OpenClaw バージョンが CLI を必要とする場合、実行時のセッションでモデルを設定することも可能です:
# Start a session and switch model for the live session
openclaw session start my-analyst-agent
openclaw session command /model gpt-5.4
運用上のヒント: ピン留めにより、そのエージェントの挙動を決定的に保ちつつ、他のエージェントで A/B テストを実施できます。
OpenAI を使用したい場合は、URL と API キーを OpenAI のものに置き換えてください。
4) Codex の 100万トークン・コンテキストオプションを使う(API ノブ) OpenClaw デプロイが OpenAI Codex エンドポイントに直接アクセスしている場合、以下のようにコンテキストオプションを渡します:
{ "model": "openai-codex/gpt-5.4", "input": "...", "model_context_window": 1050000, "model_auto_compact_token_limit": 200000}
標準コンテキストウィンドウを超えるリクエストは、異なる課金率で計上される場合があります(Codex プレビューでは標準ウィンドウ超過時の二重計上について OpenAI ドキュメントに記載あり)。
ベストプラクティス:OpenClaw で GPT-5.4 の強みを最大化する
コスト、レイテンシ、モデルミックス
ハイブリッドモデル戦略 : 短いクエリやストリーム処理にはより小さく安価なモデルを使い、重い分析・要約・長文コンテキストを要するコード生成には GPT-5.4 にホットスワップします。これにより全体のトークンコストを抑えつつ品質を維持できます(上記メモリ設定のトリガーで実装)。トークン圧縮と検索拡張(RAG) : モデルに送るトークンを制限するため、長文ドキュメントはベクタ DB に格納し、関連セグメントのみを取得して、最も関連性の高いチャンクとコンパクトな計画だけを含めます。GPT-5.4 のツール探索は、役立つツールや文書の自動特定に寄与します。ウォームアップとコールドスタート : モデル切り替え後、短いコンテキストの初期化ランでウォームアップし、初回リクエストのレイテンシスパイクを避けます。プロンプトテンプレートをプリコンパイルし、重要なメモリチャネルを再水和します。OpenClaw のローリング戦略(設定参照)はプレウォーミングをサポートします。
信頼性と安全性
優雅なフォールバック : タイムアウトとフォールバック計画(例:過去セッションのキャッシュ回答へ段階的に切り替え)を実装して、API のレート制限やクォータエラーに備えます。安全レイヤー : 出力が意思決定に影響する場合はポリシーフィルターと検証ステップを維持します。GPT-5.4 は統計的に幻覚が減っていますが、高リスクタスクでは検証が依然として重要です。
評価とモニタリング
自前のベンチマークを再現 : あなたのワークロード(コード補完、多ファイルのリファクタ、スプレッドシート分析)でヘッドトゥヘッドテストを標準ルーブリックで実施。公開レポートはスプレッドシートや生産性タスクの強みを示していますが、あなたのデータで検証しましょう。テレメトリー : トークン消費、モデルレイテンシ、メモリスワップ頻度、回答品質(人手評価/自動テスト)を監視。テレメトリーを用いてスワップ閾値を洗練します。
例:ホットスワップするコードレビューエージェント Goal: プッシュ時の定例 lint + ユニットテスト要約は安価なモデルで実行し、テスト失敗または差分が 10 ファイルを超える場合は GPT-5.4 にエスカレーションして多ファイルのリファクタ提案を行う。
プリコミットトリガーで local/fast-small-coder が lint サマリを生成。
test_failures > 0 または diff_files > 10 のとき hot_swap を openai/gpt-5.4 にトリガー。リポジトリ履歴を含む longterm_vector を昇格。失敗したスタックトレース全体+関連コードファイルをコンテキストに取り込んだ GPT-5.4 プロンプトを実行。リファクタパッチとユニットテスト変更を生成。
人間のレビュアーが出力を評価し、フィードバックがメモリを更新。
プロンプト骨子(取得&圧縮後に GPT-5.4 へ送信):
You are a senior reviewer. The repository has 12 changed files. Tests failed with stack traces below. Relevant files (retrieved): <file snippets>. Provide:1) concise summary of root cause (3 bullets),2) a minimal patch (diff) to fix,3) test changes needed,4) risk assessment and roll-back plan.
このユースケースは、長大なコンテキスト+メモリホットスワップが有用である理由を示しています:失敗トレース全体と複数ファイルを一度にモデルへ持ち込めます。コスト制御のため、スワップトリガーは保守的に実装しましょう。
最後に:誰が(いつ)OpenClaw で GPT-5.4 を採用すべきか
今すぐ採用 : エージェントが多段のコード/ツールタスク、重いスプレッドシート自動化、複雑なドキュメント編集を行い、反復的な write-run-inspect サイクルが開発時間を支配している場合。ここで生産性と信頼性の向上が最も顕著です。慎重に採用 : コストに敏感な大規模チャットチャネルを運用し、簡易な推論で十分な場合;ルーティングを用いてコスト効率を維持しましょう。単一モデルの覇権を前提にしない : あなたのデータでベンチマークしてください。GPT-5.4 はエージェントワークロードに強力な候補ですが、モデル選択はエビデンスに基づくべきです。 開発者は CometAPI 経由で GPT-5.4 にアクセスできます(CometAPI は GPT API、Nano Banana API など大規模モデル API のワンストップ集約プラットフォーム)。始めるには Playground でモデルの機能を試し、詳細は Openclaw のインテグレーションガイド を参照してください。アクセス前に、CometAPI にログインし API キーを取得していることを確認してください。CometAPI は公式価格よりはるかに低価格で統合を支援します。