
要約
AI 動画モデルは、従来のテキストから動画への単一路線を超え、テキスト、画像、リファレンス映像、モーション、音声、音楽、効果音を含む完全なクリエイティブブリーフを理解し、首尾一貫した視聴覚シーンへと変換できるシステムへと進化している。MiniMax は 2026 年 7 月 31 日に、テキスト、画像、動画、音声を統合的に理解し、ネイティブのステレオ音声付きで最長 15 秒のクリップを生成する汎用オムニモーダル生成モデル H3 を正式リリースした(https://www.minimax.io/blog/minimax-h3)。最大の変化は、テキストから動画、画像から動画、最初/最後のフレーム生成、リファレンスベース生成、モーション転送、視聴覚編集、音声条件付き生成を、個別のパイプラインではなく、単一のマルチモーダル生成問題のバリエーションとして扱う統一アーキテクチャである。ホスト提供の製品は既定で 2K 出力を提供し、ワークフローとして H3-Base がまず短辺 768p で生成し、その後 H3-Regenerate-2K が元のコンテキストを用いてシーンを再構成する。この競争力のある視聴覚品質、柔軟なマルチモーダル制御、ダウンロード可能な H3-Base 重み、コンテキスト認識の 2K 仕上げの組み合わせにより、H3 は 2026 年の動画リリースの中でも技術的に際立つ存在となっている。
重要ポイント
- 新アーキテクチャ: Contextual Omni Representation、H3-VAE、H3-Omni Transformer、In-Context Regeneration により、モダリティを横断した理解と生成を統合。
- パフォーマンス向上: 4〜15 秒のクリップを 24 FPS 動画、32 kHz ステレオ音声で生成し、ホスト環境では元のマルチモーダル文脈を用いた 2K 再構成を提供。
- API とオープンウェイトの提供状況: MiniMax は H3-2K、H3-Context-IR、H3-Regenerate-2K のホスト API を提供し、H3-Base-FL2VA と H3-Base-Ref2VA をダウンロード可能なチェックポイントとして公開。
- 主なユースケース: 広告、ブランディング、EC、プロダクトデザイン、UI/UX、ゲーム、映画、リファレンス駆動生成、モーション転送、視聴覚編集。
- 価格とデプロイ境界: 正式な従量課金は 768P で $0.08/秒、2K で $0.13/秒。ダウンロード可能なのは H3-Base のみで、H3-Context-IR と H3-Regenerate-2K はホスト提供。
MiniMax H3 とは?
MiniMax H3 は、MiniMax が開発した汎用オムニモーダルの音声・映像生成システムである。単一のプロンプトや 1 枚のリファレンス画像だけでなく、テキスト、画像、動画、音声を含むコンテキストを推論し、同期した動画とステレオ音声を生成できる。
ホスト提供の H3 システムは、4〜15 秒の出力(https://www.minimax.io/news/minimax-h3-open-source)、24 FPS 動画、32 kHz ステレオ音声に対応する。MiniMax はホストシステムを既定で 2K 提供として訴求している。技術的には、H3-Base が短辺 768p の結果を生成し、H3-Regenerate-2K がその結果と元のコンテキストを再入力して 2K に再構成する。MiniMax は、英語、中国語、日本語、韓国語、フランス語、ドイツ語、スペイン語、ポルトガル語、イタリア語、ロシア語、アラビア語を含む 11 言語で安定した対話生成を報告している(https://www.minimax.io/news/minimax-h3-open-source)。
この区別は重要だ。従来の多くの動画ワークフローは、実質的に以下のようなパイプラインである。
prompt -> 無音動画 -> セリフ -> 効果音 -> 音楽 -> 同期
H3 は、音声と映像を 1 つの生成プロセスの一部としてモデル化する。H3-Omni-Transformer は動画と音声の潜在表現を同時に予測する(https://www.minimax.io/news/minimax-h3-open-source)ため、後段で独立した動画、吹替、音楽、同期の各工程を組み立てる必要性を低減する。
MiniMax H3 仕様(概要)
| 仕様 | MiniMax H3 |
|---|---|
| 開発元 | MiniMax |
| モデルカテゴリ | 汎用オムニモーダル動画生成 |
| 入力モダリティ | テキスト、画像、動画、音声 |
| 出力 | 動画 + ネイティブのステレオ音声 |
| 出力長 | 4〜15 秒 |
| ベース解像度 | H3-Base の短辺 768p |
| ホスト解像度 | H3-Regenerate-2K による最大 2K(既定で 2K 提供。768p ベース生成後に H3-Regenerate-2K で生成) |
| フレームレート | 24 FPS |
| 音声 | 32 kHz ステレオ |
| 安定した対話対応言語 | 11 |
| アスペクト比 | 21:9、16:9、4:3、1:1、3:4、9:16、および追加の寸法 |
| リファレンス上限 | 最大 9 画像、3 動画、3 音声クリップ、合計 12 ファイルまで |
| 中核生成モデル | 33B の密な H3-Omni-Transformer |
| 位置エンコーディング | 3D Multimodal RoPE |
| オープンウェイトのチェックポイント | H3-Base-FL2VA と H3-Base-Ref2VA |
| チェックポイント精度 | BF16 |
| ライセンス | MiniMax H3 Community License |
33B という数値は、完全なホストパイプライン全体で使用されるすべてのコンポーネントではなく、H3-Omni-Transformer を指す。
MiniMax H3 の特長は?
複数のビデオタスクに一つのモデルで対応
これまで多くの動画生成器は、テキストから動画、画像から動画、モーションリファレンス、動画編集、音声生成、被写体リファレンス機能を分離していた。
MiniMax は異なるアプローチをとる。H3 は、マルチモーダルなコンテキストと望まれる出力の一般化された関係に基づいて事前学習されており、指示は自然言語でそうした関係を記述できる。
例えばクリエイターは、ある動画のカメラワークに従い、別の画像のキャラクターを保持し、さらに別の音声クリップを声のリファレンスとして使うよう、概念的に H3 に依頼できる。MiniMax のローンチデモは、このようなクロスモーダルな指示を用いて、H3 の一般化されたリファレンスシステムを示している。
これにより H3 は、生成モードの集合というより、マルチモーダルなクリエイティブエンジンに近づく。
ネイティブな動画とステレオ音声の同時生成
MiniMax の技術説明によれば、H3-Omni-Transformer は動画と音声の潜在表現を同時に予測する(https://www.minimax.io/news/minimax-h3-open-source)。音声側は H3-AudioVAE を通じて動作し、32 kHz 音声を 40 Hz の潜在系列に圧縮し、生成結果をステレオ音声としてデコードする。
これにより、セリフ、環境音、音楽、効果音を含むシーンにおいて実用上の優位性が生まれる。音は完全に別のポストプロダクション工程ではなく、生成コンテキストの一部となるからだ。
オムニ・リファレンス入力
H3-Base-Ref2VA は最大 9 枚の画像、3 本の動画クリップ、3 本の音声クリップに対応し、混在入力ファイルは合計 12 件までという制限がある。リファレンス動画と音声クリップはそれぞれ 2〜15 秒で、各モダリティに総尺の制限がある。Ref2VA モードで音声のみを唯一のリファレンス入力として用いることはできない。
重要なのは量だけではない。H3 は、これらのアセット間の関係を推測するよう設計されている。
- 画像からキャラクターを保持する
- リファレンスクリップのモーションを再現する
- 視覚的・映画的なスタイルを転移する
- 音声を保持または置換する
- 声質のリファレンスとして 1 本の音声を用いる
- 既存の視聴覚シーンを自然言語の指示で編集する
コンテキストに基づく 2K 再生成
H3 の高解像度へのアプローチは特に重要だ。
単に 768p の出力を通常の超解像ネットワークに通すのではなく、H3-Regenerate-2K(https://www.minimax.io/news/minimax-h3-open-source)は、ベースの結果と元のマルチモーダルコンテキストを再投入し、より高い解像度でシーンを再生成する。
狙いはセマンティックな復元だ。一般的なアップスケーラはピクセル補間はできても、消失した情報(小さな文字、ブランド要素、微細な物体のディテール)を確実に再構築できるわけではない。H3 の再生成段は、2K 出力の構築中に元のプロンプトやリファレンスを再び参照できる。
MiniMax H3 のアーキテクチャはどう機能するのか?
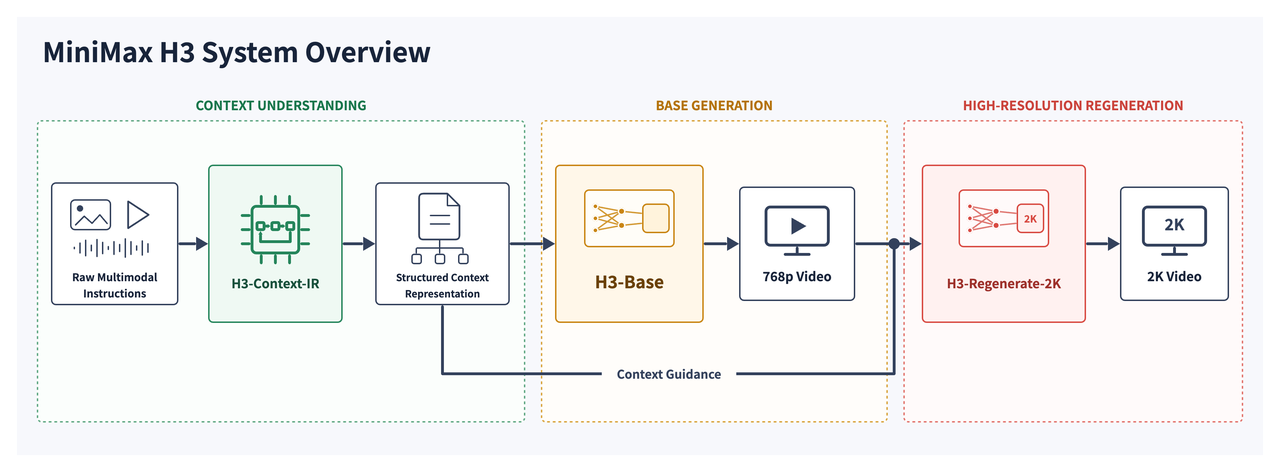
完全な H3 ワークフローには大きく 3 段階がある。
H3-Context-IR -> H3-Base -> H3-Regenerate-2K
H3-Context-IR は、潜在的に複雑なマルチモーダル指示を解釈し、構造化された Context Intermediate Representation に変換する。H3-Base はその表現を消費して 768p の動画と音声を生成する。H3-Regenerate-2K は生成済みの結果と元のコンテキストを組み合わせて、より高解像のバージョンを構築する。
H3-Contextual Omni Representation と H3-Context-IR
Contextual Omni Representation は MiniMax の広義の設計コンセプトであり、言語を、コンテキスト、ターゲット、複数のモダリティ間の関係を記述する橋渡しとして用いる。公開されたシステム記述では、H3-Context-IR は、指示をパースし、モダリティを関連付け、時間を推論し、H3-Base 用に結果をシリアライズするホスト側の前処理・オーケストレーション層である。
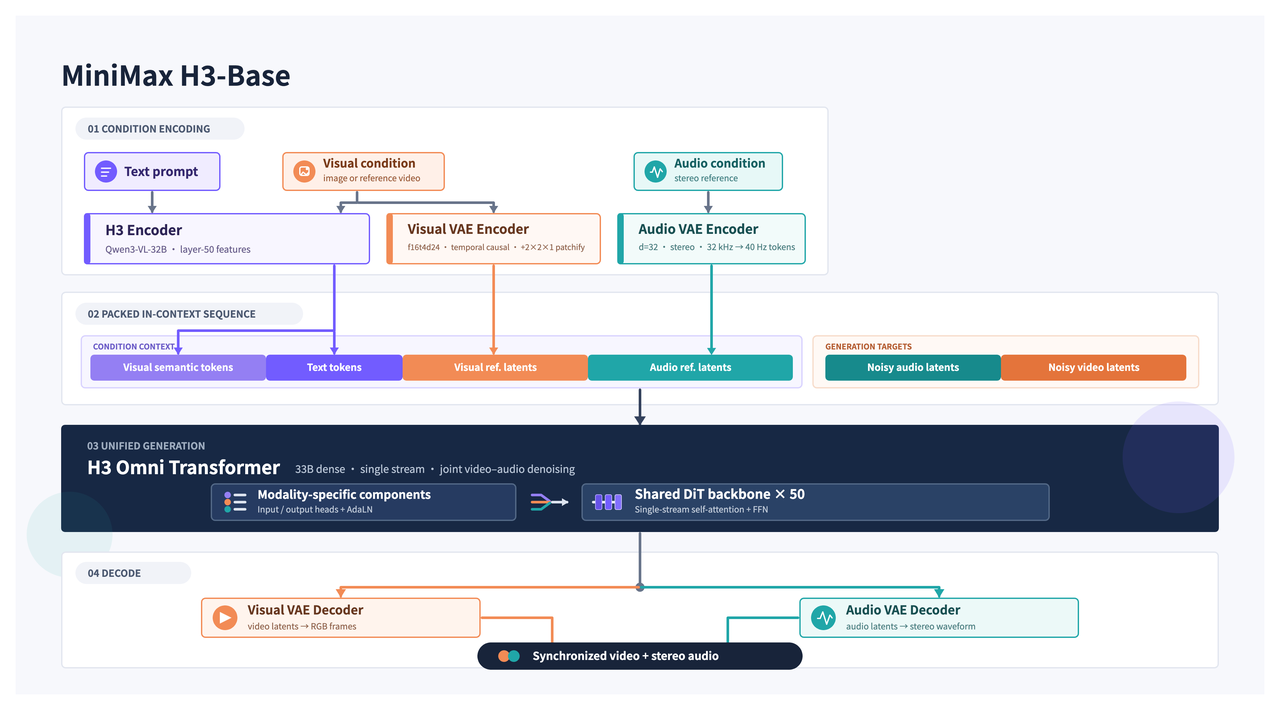
H3-Encoder は H3-Base 内の特定コンポーネントとして残る。Qwen3-VL-32B の事前学習済み重みを用い、50 層目の隠れ状態を H3-Omni-Transformer に渡す。
H3-VAE
ローンチ時の用語「H3-VAE」は、モデルファミリの視覚および音声の潜在表現を包含する。オープンウェイトのドキュメントでは、H3-VisualVAE と H3-AudioVAE を区別している。H3-VisualVAE は時間方向に因果なエンコーディングを採用し、空間 16×、時間 4×の圧縮と 24 潜在チャンネルを用いた後、1 × 2 × 2 のパッチ化を行う。H3-AudioVAE は 32 kHz のステレオ音声を、40 Hz の時間レートで潜在トークンへ圧縮する。
H3-Omni-Transformer
ローンチブログでは「H3-Omni Transformer」と表記され、オープンウェイトの技術ドキュメントでは「H3-Omni-Transformer」と表記するが、どちらも同じ中核生成コンポーネントを指す。これは 330 億パラメータの密な単一ストリーム Transformer である。およそ 130 億パラメータが AdaLN 関連の分岐に属し、その変調出力は事前計算・キャッシュ可能なため、推論専用のデプロイ時に常駐させておく必要はない。
モダリティ固有のコンポーネントは入出力層と AdaLN 分岐に集中し、中核の Transformer は統一されたパックシーケンス上で動作する。3 次元のマルチモーダル RoPE が、時間・空間の位置を (t, h, w) にわたって表現する。
H3-In-Context Regeneration
MiniMax のローンチブログではこの技法を H3-In-Context Regeneration と呼び、プロダクションモジュールは H3-Regenerate-2K という名称である。768p の結果と元のコンテキストを再入力し、2K 出力を再構築することで、単なる補間ではなくセマンティックなディテールの再生成を可能にする。
MiniMax H3 は本当にオープンソースなのか?
(比較セクション後から移動。オープンウェイトの境界は中核的なアーキテクチャ上の相違点であるため。)
「完全なオープンソース」より「オープンウェイト」の方が正確だ。MiniMax は、必要なプロセッサ、トークナイザ、テキストエンコーダ、Transformer、Visual VAE、Audio VAE を含む H3-Base-FL2VA と H3-Base-Ref2VA のチェックポイントをローカル利用向けに提供している。
ただし、完全なプロダクションパイプラインを端から端までダウンロードできるわけではない。H3-Context-IR はホスト提供のままで、H3-Regenerate-2K は初期のオープンウェイトには含まれない。ローカルの H3-Base 生成は短辺 768p をターゲットにしており、公式の完全な 2K ワークフローを再現するには、コンテキスト処理と再生成のためのホストサービスが必要となる。
また H3 は Apache 2.0 や MIT といった標準的な寛容ライセンスではなく、MiniMax H3 Community License を採用している。組織は、地域、帰属、安全性、商用利用に関する条件を導入前に確認すべきである。
MiniMax H3 のベンチマークパフォーマンス
MiniMax のローンチ資料は、従来型の大規模 VBench 風のベンチマーク行列の公開よりも、デモ、アーキテクチャ、ユースケースに重点を置いている。より中立的なスナップショットとして有用なのは Artificial Analysis の Video Arena であり、同一プロンプトに対する生成物をユーザーがブラインド比較する。
| Artificial Analysis のタスク | H3 順位 | H3 Elo | 首位 | 首位 Elo |
|---|---|---|---|---|
| Text-to-Video with Audio | #4 | ≈1,228 | Wan 3.0 | 1,242 |
| Image-to-Video with Audio | #3 | 1,185 | H3 Max, post-trained by fal | 1,202 |
| Video Editing with Audio | #2 | 1,129 | Wan 3.0 | 1,190 |
これらの順位は 2026 年 9 月 2 日時点のスナップショットであり、恒久的なスコアではない。H3 は主要なプロプライエタリシステムと競合可能であり、とりわけオープンウェイトの中では注目に値する。その価値は、競争力のある品質、ネイティブな視聴覚生成、マルチモーダル・リファレンス、ダウンロード可能なベース重みの組み合わせにあり、単に最高のベンチマークスコアの主張ではない。
MiniMax H3 の料金
以下の従量課金価格は、2026 年 9 月 24 日時点で MiniMax の公式料金ページに照らして再確認した。価格は変動し得るため、プロダクションでの予算策定前に再確認すべきである。
| 用途 | 公式定価 |
|---|---|
| 768P での H3 生成 | $0.08/秒 |
| 2K での H3 生成 | $0.13/秒 |
| 768P → 2K の再生成出力 | $0.05/秒 |
| 標準生成におけるリファレンス音声 | 無料 |
| 標準生成におけるリファレンス画像 | 最初の 5 枚無料、その後 $0.04/枚 |
| 再生成におけるリファレンス画像 | 最初の 5 枚無料、その後 $0.025/枚 |
| 再生成におけるリファレンス動画 | 元の 768P 入力の秒あたり $0.05 |
| H3-Context-IR 入力 | $0.90/M tokens |
| H3-Context-IR 出力 | $3.60/M tokens |
定価ベースでは、10 秒のダイレクト生成は 768P で約 $0.80、2K で約 $1.30、15 秒の生成は約 $1.20 または $1.95 となる。これらの例には、課金対象となるリファレンス、Context-IR トークン、その他のワークフロー固有の料金は含まれていない。
MiniMax H3 は CometAPI からも利用可能で、モデル ID minimax-h3 のページでは $0.064/秒からと謳っている。サードパーティのヘッドライン価格は経路、解像度、課金ルールによって異なり得るため、普遍的な単価として扱うべきではない。
MiniMax H3 vs Wan3.0 vs Seedance 2.5 vs Vidu Q3
最も有用な競合は、必ずしも紙の上で同一に見えるモデルとは限らない。MiniMax H3、Wan3.0、Seedance 2.5、Vidu Q3 は、プロフェッショナルな動画制作ワークフローの異なる部分を重視している。
| 次元 | MiniMax H3 | Wan3.0 | Seedance 2.5 | Vidu Q3 |
|---|---|---|---|---|
| 単一生成の最大長 | 15s | 30s | 30s | 16s |
| 動画解像度 | ホストは 2K、オープンウェイトのベースは 768p | 最大 1080P | 経路依存 | 最大 1080P |
| ネイティブな音声・動画 | あり | あり | あり | あり |
| リファレンス入力 | テキスト、画像、動画、音声 | 画像、動画、音声、ドキュメント、Web ページ | 画像、動画、音声 | 画像/リファレンス系ワークフロー |
| リファレンス容量 | 混在 12 ファイル | 最大 20 マテリアル | 最大 50 マテリアル | メインページでは未記載 |
| 主な差別化要因 | オープンウェイトの H3-Base + 2K 再生成 | 30 秒と幅広い入力 | 30 秒のストーリーテリング + 大規模リファレンス | 短編の物語性と対話コントロール |
| 最適な適合 | カスタマイズ可能なマルチモーダル・パイプライン | 長尺の一体型プロダクション | リファレンス重視の商用ストーリーテリング | 短いドラマや対話主導の制作 |
| 最適な適合 | カスタマイズ可能なクリエイティブ・パイプライン | 長尺の一体型プロダクション | リファレンス重視の商用ストーリーテリング | 短いドラマや対話主導の制作 |
どのモデルが優れている?
普遍的な勝者は存在しない。オープンウェイト、マルチモーダル条件付け、ネイティブのステレオ音声、視聴覚編集、2K 仕上げを重視するなら MiniMax H3 を選ぶべきだ。30 秒の出力、1080P、広範なドキュメント/ウェブ参照、強力なアリーナ性能を重視するなら Wan 3.0 を選ぶ。非常に大きなリファレンスセット、30 秒の物語構成、アイデンティティの一貫性、精密な編集を求めるなら Seedance 2.5 を。短編の物語シーン、複数人の対話、タイミング、監督的なカメラ制御を重視するなら Vidu Q3 が適する。
責任ある評価では、同一の社内プロンプトセットを候補 API すべてに対して実行すべきだ。公開リーダーボードは直接比較可能なバージョンを必ずしも提示せず、古いまたはターボ変種を代用すると結果が歪む可能性がある。
MiniMax H3 の主な制約は?
- 期間: H3 は最大 15 秒で、30 秒生成に対応する競合もある。
- オープンウェイトの範囲: ダウンロード可能なのは H3-Base のみ。Context-IR と 2K 再生成はホスト提供のまま。
- ハードウェア要件: 33B の密な動画モデルは、推論最適化があってもローカルデプロイにコストがかかる。
- 価格の複雑さ: 生成、再生成、リファレンス動画・画像、Context-IR が別個に課金され得る。
- ライセンス条件: Community License は標準的な寛容ライセンスよりも入念な法的確認が必要。
- ベンチマークの変動性: アリーナ順位は変動し、ワークロード固有のテストに代わるものではない。
MiniMax H3 は誰に向いている?
H3 は、被写体の一貫性、モーションや声のリファレンス、ネイティブなステレオ音声、編集、高解像度仕上げが必要なマルチモーダル動画ワークフローを構築する開発者やクリエイティブチームに適している。また、ベースモデルをカスタマイズまたは自前ホスティングしつつ、必要なときだけホスト段を利用したいチームにも有用だ。
一方で、最長の単一生成、最も軽量なローカルデプロイ、完全に寛容なエンドツーエンドのスタックが主眼であれば、別のモデルの方が適している可能性がある。MiniMax は商用の制作シナリオとして、広告、ブランディング、EC、プロダクトデザイン、UI/UX、ゲーム、映画を挙げている。
開発者は MiniMax H3 にどうアクセスできる?
- Hailuo や MiniMax Design を含む MiniMax のホスト製品を利用する。
- MiniMax の公式 Open Platform で H3-2K、H3-Context-IR、H3-Regenerate-2K API を利用する。
- 公式リポジトリと対応する推論フレームワークを通じて H3-Base のチェックポイントをダウンロードし、ローカルにデプロイする。
実装の詳細はソース一覧にリンクされた公式 API とデプロイのドキュメントを参照。本稿は製品評価に焦点を当てる。
結論
MiniMax H3 の価値は、個別の指標で首位であることよりも、分断された制作工程を 1 つのプログラマブルなマルチモーダルシステムに圧縮する点にある。ダウンロード可能な H3-Base の重みにより、開発者はローカルでのプロトタイピング、カスタマイズ、反復を行いつつ、プロダクションに必要な高度な指示処理と高解像度仕上げはホストの H3-Context-IR と H3-Regenerate-2K で補える。このハイブリッドは同時にトレードオフも生む。15 秒の制限、ローカルのインフラ要件、ホストサービスへの依存、ワークフロー単位のコスト、Community License の条件などを、実際のプロンプトと納品制約に照らして評価する必要がある。マルチモーダル・リファレンス制御、同期したネイティブ音声、視聴覚編集、2K マスターを優先するチームにとって H3 は有力なプラットフォームだが、より長尺や完全自足の寛容スタックを主に必要とするチームは、コミット前に代替案のベンチマークを行うべきである。
FAQ
プロダクションチームはローカルの H3-Base と MiniMax のホストサービスの分担をどう決めるべきか?
実務的なハイブリッドとしては、ローカルの H3-Base を迅速な探索、プロンプト反復、リファレンステスト、インフラ制御やデータ局所性が重要な段階に用い、有望な出力をホストの H3-Context-IR に渡してより豊かな指示処理を行い、最終解像度の納品を H3-Regenerate-2K で行う分担が現実的である。適切な分担は、GPU キャパシティ、ターンアラウンド、ガバナンス要件、ホスト段で得られる品質向上が追加の転送・遅延・課金に見合うかによって決まる。
H3 導入前に社内評価セットは何を測るべきか?
見栄えの良いプロンプトだけで評価してはならない。実際の制作ブリーフからなる再現可能なセットを使い、指示遵守、被写体・ブランドの一貫性、時間的安定性、テキスト描画、カメラモーション精度、音声・映像同期、対話品質、再生成の忠実度、レイテンシ、失敗率、承認クリップあたりの総コストを採点する。競合モデルにも同一のアセットと受け入れ基準を適用し、アリーナの順位をチームの実作業から得られる証拠の代替としないこと。
制御性を高めるためにマルチモーダルなリファレンスアセットはどう準備すべきか?
リファレンスアセットには明確で矛盾しない役割を与える。例えば 1 枚の画像でアイデンティティ、1 本のクリップでモーション、1 本の音声で声質や雰囲気を定義する。低品質や矛盾のあるリファレンスは除外し、クリップは関連アクションにトリミングし、各アセットとターゲット出力の関係を指示で明示する。最小限で十分なリファレンスセットから始めると、どのアセットが結果を改善し、どれが曖昧さを招くかを診断しやすい。
他 API と比較する際に見落としがちなプロダクションコストは?
秒単価は見える基準に過ぎない。現実的なコストモデルには、課金対象のリファレンス動画や追加画像、Context-IR トークン、2K 再生成、リトライ、却下生成、ローカル GPU キャパシティ、メディア保管・転送、モデレーション対応、統合エンジニアリング、人によるレビューを含めるべきだ。有用な比較は、所要解像度で承認された成果物あたりのコストであり、生の生成あたりのコストではない。
H3-Base 自体は 768p 生成なのに「既定で 2K」とはどう解釈すべきか?
これは製品の層を指す表現だ。「既定で 2K」はホストの商用体験を指し、768p はダウンロード可能な H3-Base 段の短辺出力を指す。その後、H3-Regenerate-2K がベース結果と元のコンテキストを用いて最終出力を再構築する。したがって、品質評価ではローカルの 768p 出力と、ホストの最終 2K 出力を別のワークフロー段として比較し、再生成が単なる画素数の拡大ではなく、テキスト、ブランディング、顔、微細なディテールを実際に復元しているかに注意を払うべきである。
どのような場合に MiniMax H3 は第一選択になりにくいか?
大幅に長い単一パスのクリップ、完全ローカルでの 2K 仕上げ、標準的で寛容なライセンス、最小限の GPU 投資、マルチモーダル・リファレンスから得る利点が小さい単純なテキストから動画のワークフローが要件である場合、H3 は適合しない可能性がある。代表的なプロンプトを用いた短期の PoC により、その制御性と音声・映像統合が最終成果物の品質を実質的に向上させるかを見極めるのが安全である。