
TL;DR
Google 2026 жылғы 30 қыркүйекте күрделі, ұзаққа созылатын жұмыс процестері үшін фронтир-модель ретінде Gemini 4 Argon-ды жариялады. Жарияланған нәтижелер айқын үлгіні көрсетеді: кәсіби білім еңбегінде, ұзақ контексті тапсырмаларда және кейбір бағдарламалық инженерия бағалауларында жоғары нәтиже, ал терминал мен компьютерді пайдалану бойынша кейбір бенчмарктерде әлсіздеу көрсеткіштер. Google модельді кезең-кезеңімен енгізуде. Бұдан бөлек, CometAPI 1 қазаннан бастап каталогта бар деп хабарлайды; ендіру алдында аккаунт жарамдылығын және сынамалық сұраудың сәттілігін тексеру керек. Ең пайдалы өнімділік әңгімесі — қай жерде өсім бар екені.
Argon Vals Index-те 68.9%, Vals Finance Agent v2-де 65.4%, DeepSWE v1.1-де 77.9%, LVBench-те 91.7% және GraphWalks-та 256K–1M контексте 84.2% жинайды. Сонымен қатар ол FrontierSWE v2, Terminal-Bench 4.0, Terminal-Bench Science және OSWorld-2.0 бойынша кейбір фронтир-модельдерден қалып қояды.
Нәтижелер Argon-ды жұмыс жүктемесіне қарай қарастыруды құптайды. Ең мықты ұпайлар кәсіби білім еңбегі, өте ұзақ контекст, сондай-ақ таңдалған мультимодалды және бағдарламалық-инженерлік бағалаулар төңірегінде топтасқан. Басқа модельдер терминал және компьютерді пайдалану сынақтарының бірқатары бойынша басымдықты сақтайды.
Негізгі тұжырымдар
- Gemini 4 Argon кәсіптік білім еңбегі, ұзақ контекстік пайымдау, мультимодалды түсіну және бірнеше ұзақ көкжиекті код жазу бағалауларында ең мықты.
- Оның 1,000,000 токенге дейінгі максималды шығыс шегі ұзақ пайымдау траекторияларына көбірек генерация қорын береді; жария кіріс-контекст спецификациясы бекітілмеген.
- Argon бірқатар білім еңбегі және ұзақ контексттік нәтижелерде алда, бірақ GPT-6 Astra және Claude Opus 5.5 кейбір кодтау және компьютерді пайдалану бағалауларында алда қалуда.
- Бенчмарк ұпайлары — нақты модель мен агент конфигурацияларының нәтижесі. Метрикалар, кіріс шарттары және бағалау баптаулары бас тақырыптағы пайыздармен бірдей маңызды.
- Google-дың енгізуі мен CometAPI арқылы қолжетімділік — бөлек қолжетімділік мәлімдемелері. Трафикті көшіру алдында белсенді маршрутты, модель идентификаторын және аккаунт жарамдылығын растаңыз.
Gemini 4 Argon деген не?
Gemini 4 Argon — қысқа бір сұраққа жауап беруден гөрі көптеген қадамдармен пайымдауды талап ететін күрделі жұмыс процестері төңірегінде жасалған Google DeepMind-тың жаңа фронтир Gemini моделі.
Google-дың ресми ұстанымы нақты әлемдегі бағдарламалық инженерияны, құқық пен қаржы сияқты кәсіптік білім еңбегін, қорғаныстық киберқауіпсіздікті, мультимодалды түсінуді және ұзаққа созылатын агенттік тапсырмаларды ерекшелейді.
Бұл жуырдағы Flash релиздерінен маңызды айырма. Gemini 3.8 Flash API in CometAPI ауқымды агенттік жүктемелер үшін төмен құнды жұмыс аты ретінде жобаланған. Ал Argon Google стегінің фронтир шетін білдіреді, тереңдік пен үздіксіз орындалуға басымдық береді.
Модель сипаттамалары
| Сипаттама | Gemini 4 Argon |
|---|---|
| Әзірлеуші | Google DeepMind |
| Жарияланған күні | September 30, 2026 |
| Модель отбасы | Gemini 4 |
| Позициялануы | Фронтир пайымдау және ұзақ көкжиекті модель |
| Максималды шығыс | 1,000,000 tokens |
| Ұзақ контекст бағалауы | GraphWalks бойынша 256K–1M ауқымында сыналған |
| Жария кіріс контекст шегі | Іске қосу кезінде стандартты жария API спека кестесінде ресми көрсетілмеген |
| Мультимодалды түсіну | Иә; диаграммалар, құжаттар және ұзақ видео бағалауы бар |
| Агенттік кодтау | Иә |
| Компьютерді пайдалану | Бағаланған |
| Киберқауіпсіздік | Арнайы қорғаныстық қабілеттер |
| Google public API model ID | Google-дың алғашқы жария құжаттамасында жарияланбаған; CometAPI каталог идентификаторы ретінде gemini-4-argon қолданады. |
Шығыс бюджеті және трейд-оффтар
Google Argon үшін 1 миллион токенге дейін максималды шығыс шегін жариялайды, бұл іске қосу хабарландыруында айтылған алдыңғы 64K шектен жоғары. Бұл ұзақ пайымдау траекториялары үшін қосымша кеңістік береді. Мұны көпқоңыраулы агент сессиясының толық бюджеті ретінде немесе кез келген тапсырма жақсарады деген дәлел ретінде түсіндірмеу керек.
Максималды шығыс интеллектпен тең емес. Модельге көбірек шығыс токендерін беру оны автоматты түрде қабілетті етпейді; тек әлеуетті тар бутылочканы алып тастайды. Модель сол бюджетті өнімді пайдалана алуы керек.
Құн мен кідіріс бойынша да трейд-офф бар. Шын мәнінде жүз мыңдаған токен генерациялайтын модель, номиналды токен бағасы тартымды көрінсе де, қымбат әрі баяу болуы мүмкін.
Мақаладағы таңдамалы бенчмарк нәтижелері. Әр қатар ішінде модельдерді салыстырыңыз; метрикалар мен бағалау шарттары әртүрлі. Бұл диаграмма сәндік градиент суретін алмастырады және тәуелсіз тестілеуді білдірмейді.
Максималды шығыс шегі мен кіріс контекст терезесі әртүрлі мүмкіндіктерді сипаттайды. GraphWalks бағалау ауқымы — сынақталған кірістер туралы дәлел, бірақ жария API спецификациясының орны баса алмайды.
Gemini 4 Argon бенчмарктерде қалай өнер көрсетеді?
Google DeepMind-тың өнімділік кестесі агент жұмыс процестерін, кәсіптік білім еңбегін және мультимодалды тапсырмаларды қамтиды. Төмендегі мәндер сол жарияланған салыстыруды қайта келтіреді. Олар тапсырма өнімділігін өлшейді, токен өткізу қабілеті немесе жауап кідірісін емес; “—” бұл салыстыруда нәтиженің есептелмегенін білдіреді.
| Бенчмарк | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 | Бағалау шарттары |
|---|---|---|---|---|---|
| Vals Index | 68.9% | 63.1% | 65.8% | 67.0% | Vals AI |
| AutomationBench | 51.3% | 41.4% | 31.4% | 42.5% | Private set; Zapier leaderboard |
| Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% | 58.6% | Vals AI |
| Harvey's Legal Agent | 19.6% | 5.4% | 6.7% | 3.8% | Vals AI |
| DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% | mini-swe harness; mixed sources |
| FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% | Proximal leaderboard |
| Vibe Code Bench | 91.9% | 89.6% | 90.3% | 90.3% | Vals AI leaderboard |
| Terminal-Bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% | Self-test / leaderboard |
| PostTrainBench | 45.3% | 44.3% | 40.2% | 49.3% | v1.1; OpenCode; 10h; one H100 |
| Terminal-Bench Science 0.1 | 57.6% | 68.1% | 52.6% | 63.3% | Verifier timeout ×6 |
| LABBench 2 | 88.8% | 85.4% | 68.6% | 73.1% | Linux tools; internet |
| RiemannBench | 76.0% | 72.0% | 65.6% | 69.6% | Surge leaderboard |
| GraphWalks up to 128K | 99.7% | 98.7% | 91.4% | 90.6% | BFS F1; 650 items |
| GraphWalks 256K–1M | 84.2% | 71.8% | 65.0% | 66.8% | BFS F1; 200 items |
| Agent's Last Exam | 39.5% | 34.2% | — | 38.2% | Binary pass; ALE-Claw; 5h |
| OSWorld-2.0 | 69.2% | 72.6% | — | — | Offline partial score; best of 3 runs |
| Chartography | 71.6% | 71.0% | 46.2% | 66.3% | No tools; Surge leaderboard |
| LVBench | 91.7% | 87.5% | 79.7% | 83.7% | No tools; model-specific frame sampling |
| CWE-bench v1 | 68.0% | 68.0% | 58.0% | 67.0% | pass@1; pass@4 breaks ties |
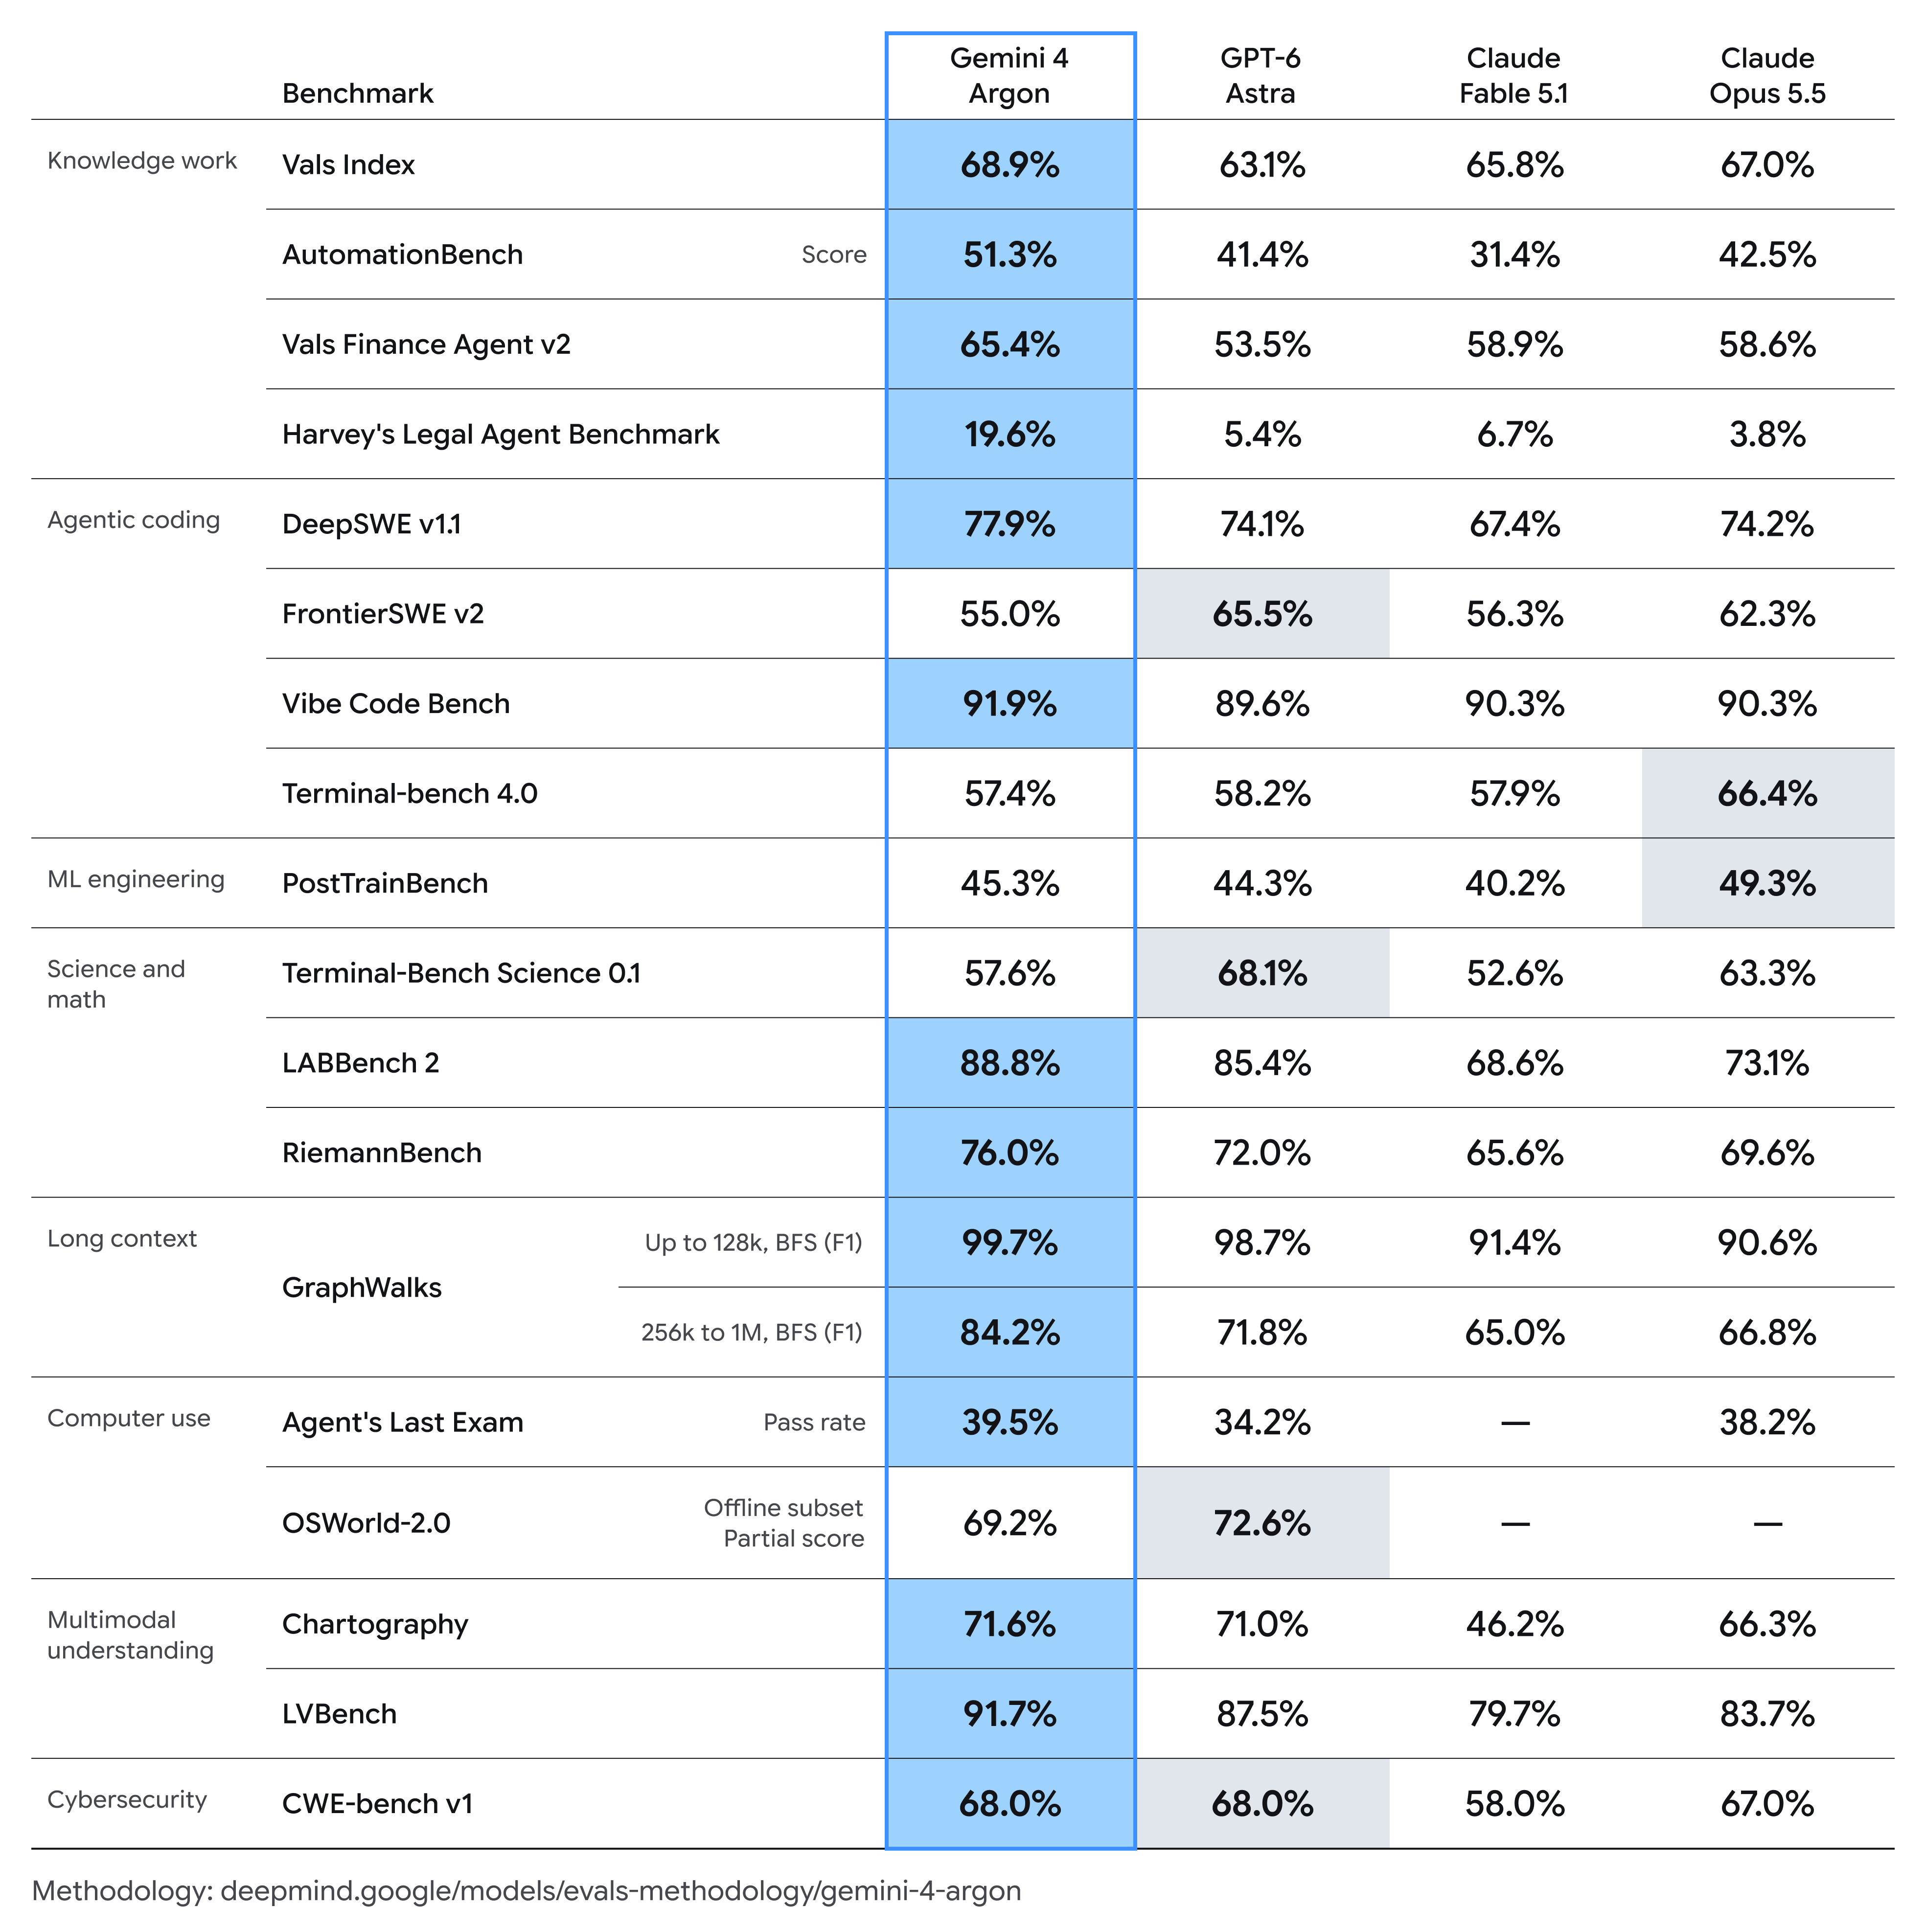
Google-дың ресми Gemini 4 Argon бенчмарк салыстыруы
Ерекше көрсетілмесе, Argon нәтижелері бір әрекетпен және ең жоғары ойлау параметрімен алынған. Басқа модель нәтижелері, жалпы алғанда, провайдер есептерінен алынған, бенчмаркке тән ерекшеліктермен. LVBench үшін Gemini-де 1 FPS, GPT-6 Astra-да 800 кадр, Fable 5.1-де 300, Opus 5.5-те 600 қолданылады. Бұл кірістер бірдей емес, сондықтан әр қатарды бақылаулы қайта іске қосу ретінде емес, есептелген конфигурацияларды салыстырыңыз.
Бағалау шарттары мен шектеулері
Кесте пайдалы, бірақ оны тәуелсіз универсал лидерборд ретінде түсіндіруге болмайды.
- Бенчмарк таңдауы — Google таңдауы.
- Бенчмаркке тән бағалау баптаулары қатарлар бойынша өзгереді, соның ішінде агент фреймворктары, уақыт бюджеттері, құралдар және кіріс іріктеуі.
- Ресми методология әдетте бәсекелес нәтижелерді провайдер есептері ретінде алады, бенчмаркке тән лидерборд және өздігінен есептелген ерекшеліктермен.
- Ең жоғары бенчмарк баптауы өндірістік әдепкі инференс конфигурациясын көрсете бермейді.
- Бас тақырыптағы бенчмарк ұпайы токен қолдануын, құрал шақыруларын, қайта әрекеттерді, өткен уақытты немесе адам араласуын ашпайды.
Өндірістік жүйелер үшін жиі жақсы метрика — бір тапсырманы сәтті аяқтаудың құны, токен бағасы немесе бір пайыздан гөрі.
Қай жұмыс жүктемесіне Gemini 4 Argon ең лайық?
Білім еңбегіндегі өнімділік
Argon нәтижелеріндегі ең айқын үлгі кәсіби, көпқадамды білім еңбегінде көрінеді.
Vals Index-те Argon 68.9%-ке жетеді, Claude Opus 5.5 үшін 67.0%-пен салыстырғанда. Сандық алшақтық шағын, бірақ мамандандырылған жұмыс процестерінде үлгі айқынырақ болады.
- Vals Finance Agent v2: 65.4%, Google кестесінде көрсетілген ең мықты бәсекелестен 6.5 ұпайға жоғары.
- AutomationBench: 51.3%, Claude Opus 5.5-тен 8.8 ұпайға жоғары.
- Harvey's Legal Agent Benchmark: 19.6%, келесі жоғары модель үшін 6.7%-бен салыстырғанда.
Өнімділік профилі Argon ең көп пайда әкелетін жағдай — модель ақпарат жинап, күйді сақтап, бірнеше кезеңде пайымдап, жабық сұраққа жауаптан гөрі кәсіби артефакт шығаратын кезде екенін аңғартады.
Абсолюттік құқықтық агент ұпайының төмендігі де маңызды. 19.6% ұпайы қанша критерий немесе толық жұмыс процестері сәтсіз болғанын ашпайды. Пайдалы қорытынды — Argon бұл бағалауда салыстырмалы түрде үлкен жақсаруды көрсетеді, бірақ нәтиже құқықтық жұмысты сенімді автоматтандыруды орнатпайды.
Ұзақ контекстті пайымдау
Argon-ның ең әсерлі артықшылығы GraphWalks-тың 256K–1M нұсқасында болуы мүмкін.
- Gemini 4 Argon: 84.2%
- GPT-6 Astra: 71.8%
- Claude Opus 5.5: 66.8%
- Claude Fable 5.1: 65.0%
Бұл жарияланған салыстырудағы ең жақын модельден 12.4 ұпай артық.
Қысқа контекст ұзындықтарында алшақтық әлдеқайда кіші: GraphWalks up to 128K бойынша Argon 99.7%, GPT-6 Astra 98.7% жинайды. Бұл Argon осы өте ұзақ контекст бағалауында салыстырылған модельдерден баяуырақ деградацияланатынын көрсетеді.
Google бұл айырмашылықты нақты бір назар механизміне, іздеу жүйесіне, оқыту рецептіне немесе инференс уақытындағы стратегияға телуге жеткілікті архитектуралық ақпарат ашқан жоқ. “Gemini 4 жаңа назар архитектурасын енгізді” сияқты мәлімдемелер, сол себепті, жария дәлелдерден асып түсер еді.
Кодтау өнімділігі
Ресми бенчмарк кестесі қарапайым “иә” жауабын қолдамайды.
Argon кейбір кодтау түрлерінде өте жақсы, басқаларында айқын ұтылуда. DeepSWE v1.1-де ол 77.9%-ке жетеді, Claude Opus 5.5 үшін 74.2% және GPT-6 Astra үшін 74.1%-пен салыстырғанда. Оның Vibe Code Bench ұпайы да 91.9% болып жоғары.
- FrontierSWE v2: Argon 55.0% vs. GPT-6 Astra 65.5%.
- Terminal-Bench 4.0: Argon 57.4% vs. Claude Opus 5.5 66.4%.
- Terminal-Bench Science 0.1: Argon 57.6% vs. GPT-6 Astra 68.1%.
Бұл бөлініс әзірлеушілер үшін маңызды. Кодтау ұзақ инженерлік жұмыс ағынына айналып, мол контекст пен жоспарлау қажет болғанда Argon ерекше мықты көрінеді, ал терминалға ауыр орындалу бәсекелі күйде қалады. Репозиторий көшіру бенчмаркі мен интерактивті терминал бенчмаркін “кодтау қабілетінің” өзара алмастырылатын өлшемдері ретінде қарастыруға болмайды.
Қорғаныстық киберқауіпсіздік
Киберқауіпсіздік — негізгі ендіру саласы. Google-дың қорғаныстық киберқауіпсіздік ұстанымы автономды осалдық табу, валидация және патчтау мүмкіндіктерін қамтиды. Бұл — провайдер қабілеті туралы мәлімдеме; төмендегі CWE-bench нәтижесі өз бағалауында осалдықты жоюды өлшейді.
CWE-bench v1-де Argon 68% жинайды, GPT-6 Astra-мен тең және Claude Opus 5.5-тен сәл жоғары — 67%.
Google сондай-ақ теріс пайдалануға, жанама промпт-инъекцияға, тәуекелді агент мінез-құлқына және орындалу ортасының бұзылуына қарсы күшейтілген қорғаныстарды атап өтеді. Осылайша, Argon дәстүрлі модель жаңартуынан гөрі агент қауіпсіздігі релизі де болып табылады.
Мультимодалды түсіну
Argon Chartography-де 71.6% және ұзақ видеоны түсінуге арналған LVBench-де 91.7% жинайды. LVBench нәтижесі Google кестесінде GPT-6 Astra-дан 4.2 пайыздық тармаққа жоғары. Модельдер әртүрлі кадр-іріктеу конфигурацияларын алатындықтан, бұл — таза модель артықшылығы емес, есептелген баптауларды салыстыру.
Бұл маңызды, өйткені көптеген кәсіби жұмыс процестері тек мәтіннен тұрмайды. Қаржылық зерттеу агентіне диаграмманы қарау қажет болуы мүмкін; кәсіптік көмекші есептерді, PDF-терді және скриншоттарды біріктіруі мүмкін; видео-анализ жүйесі жеке кадрларды тәуелсіз өңдеуден гөрі ұзын тізбектегі оқиғаларды сақтау керек болуы мүмкін.
Сондықтан Argon-ның мультимодалды қабылдау мен үздіксіз пайымдауды үйлестіруі жай мультимодалды қолдаудан да өзекті.
Ғылым және математика өнімділігі
Нәтижелер аралас, бірақ жалпы алғанда күшті. Argon LABBench 2-де 88.8% және RiemannBench-те 76.0%-ке жетеді, Google кестесіндегі салыстырылған модельдерден озық. Алайда Terminal-Bench Science 0.1-де GPT-6 Astra 68.1%-ке жетіп, Argon-ның 57.6%-ін басып озды.
Бұл айырмашылық кеңірек үлгіге нұсқайды: Argon ғылыми ақпарат бойынша пайымдауда мықтырақ, бірақ құралға сүйенген ғылыми орындалудың барлық түрінде емес.
Компьютерді пайдалану өнімділігі
Agent's Last Exam-да Argon екілік өтім бойынша 39.5% жинайды, GPT-6 Astra-ның 34.2%-інен және Claude Opus 5.5-тің 38.2%-інен жоғары. OSWorld-2.0-ның оффлайн ішкі жиынында оның ішінара ұпайы 69.2%, GPT-6 Astra-ның 72.6%-інен төмен. OSWorld мәні толық тапсырма табыстылығы емес, ал жоқ Claude жолдары нөлдік қабілетті білдірмейді.
Сондықтан ағымдағы деректер компьютерді пайдалану бойынша жаппай артықшылықты көрсетпейді. Өндірісте бенчмарк ұпайларын навигация дәлдігі, сәтсіз басулар, қайта әрекет жиілігі, қасақана емес әрекеттер, аяқтау уақыты және адам түзету жиілігі сияқты тапсырма деңгейіндегі сынақтармен толықтыру керек.
Gemini 4 Argon vs GPT-6 Astra және Claude
| Өлшем | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|---|---|
| Білім еңбегі | Өте күшті | Күшті | Өте күшті | Күшті |
| Ұзақ контекст бенчмаркі | Жарияланған ең мықты нәтиже | Күшті | Орташа–күшті | Орташа |
| Ұзақ көкжиекті кодтау | Өте күшті | Өте күшті | Өте күшті | Күшті |
| Терминалдық кодтау | Бәсекеге қабілетті | Күшті | Таңдалған тестте ең жоғары | Бәсекеге қабілетті |
| Ғылыми терминал агенттері | Бәсекеге қабілетті | Таңдалған тестте ең жоғары | Күшті | Бәсекеге қабілетті |
| Мультимодалды түсіну | Өте күшті | Өте күшті | Күшті | Бәсекеге қабілетті |
| Компьютерді пайдалану | Бәсекеге қабілетті | Күшті | Аралас / шектеулі салыстыру | Шектеулі салыстыру |
| Киберқауіпсіздік | Топтағы үздікпен тең | Топтағы үздікпен тең | Өте жақын | Төмен |
Бұл салыстыруда Argon ұзақ контексті, құжатқа бай және кәсіби агент жұмысында ерекшеленеді. Әзірлеушілер оны GPT-6 Astra, Claude Opus 5.5 және Claude Fable 5.1 модельдерімен CometAPI арқылы салыстыра алады.
Өнімділікке негізделген таңдау
Жоғарыдағы сапалық белгілер — таңдалған бенчмарк кестесінің түйіндемесі, универсал рейтинг емес. Жұмыс Argon-ның жетекші бағалауларына ұқсаса, пилотта Argon-ды таңдаңыз; әдепкі ретінде таңдаудан бұрын терминалға ауыр жүктемелерде Astra мен Opus-ты сынаңыз.
Сипаттамалар және ендіру шектеулері
Бұл өнімділік салыстыруы архитектуралық артықшылықты немесе жалпы баға–өнімділік жеңімпазын орнатпайды. Argon-ның параметр саны мен архитектурасы Google-дың қаралған іске қосу материалдарында көрсетілмеген. Оның жария кіріс-контекст шегі ресми API құжаттамасын талап етеді. CometAPI gemini-4-argon маршрутын хабарлайды; Google-дың кеңірек енгізуінен бөлек, оның қолдайтын параметрлерін және аккаунт қолжетімділігін дербес растаңыз. Ендірмес бұрын әр маршруттың шектерін және нақты тапсырма құнын салыстырыңыз.
Әзірлеушілер Gemini 4 Argon-ға CometAPI арқылы қалай қол жеткізе алады?
CometAPI модельді gemini-4-argon ретінде қолжетімді деп хабарлайды. Аккаунт дашбордында API кілтін жасаңыз, сол идентификаторды playground-та таңдаңыз және интеграциядан бұрын сынамалық сұрауды іске қосыңыз. OpenAI-мен үйлесімді мысалда base URL https://api.cometapi.com/v1 қолданылады. Ендірер алдында модельдің қолдайтын endpoint-ін және параметрлерін аккаунт құжаттамасынан растаңыз; каталогтағы белгіше жалғыз өзі сәтті қоңырауды растамайды.
- CometAPI аккаунтын жасаңыз және дашбордта API кілтін генерациялаңыз.
- gemini-4-argon-ды таңдаңыз және playground-та өкілдік сұрауды валидациялаңыз.
- Үйлесімді клиентті CometAPI base URL-імен, кілтіңізбен және модель идентификаторымен баптаңыз; ендірмес бұрын қолдайтын сұрау схемасын және биллингті растаңыз.
CometAPI және ресми баға
Google миллион кіріс токеніне $2 және миллион шығыс токеніне $10 кіріспе бағасын, ал кэштелген кіріс үшін кіріс тарифінен 95% жеңілдікті жариялады. Кіріспе кезеңнен кейін жарияланған тарифтер — миллион кіріс токеніне $4 және миллион шығыс токеніне $20. Бұлар — Google жариялаған бағалар, CometAPI бағалары немесе дереу жалпы API қолжетімділігінің растауы емес.
| Есеп айырысу негізі | CometAPI-дегі Gemini 4 Argon API | Google ресми хабарламасы | Салыстыру |
|---|---|---|---|
| Кіріс / 1M tokens | $3.20 | $4.00 кіріспе кезеңінен кейін | Жарияланған пост-интро тарифтен 20% төмен |
| Шығыс / 1M tokens | $16.00 | $20.00 кіріспе кезеңінен кейін | Жарияланған пост-интро тарифтен 20% төмен |
Қорытынды
Gemini 4 Argon-ның бенчмарк профилі жай лидерборд мәлімдемесінен гөрі қызығырақ.
Көрсетілген салыстырудағы ең мықты нәтижелер кәсіби білім еңбегі, ұзақ контекст және үздіксіз агент орындалуы төңірегінде шоғырланған. Бұл үлгі жұмыс жүктемесін таңдауда пайдалы, бірақ оның астарындағы архитектураны анықтамайды немесе өсімнің себебін дәлелдемейді.
Қаржы, құқық, ұзақ видео және бағдарламалық инженерия нәтижелері осы жүктемелер үшін нысаналы пилотты қолдайды. Сол артықшылық өндірісте сақтала ма, ол кіріс қоспасына, агент фреймворкке, инференс баптауларына және верификация талаптарына байланысты.
Сонымен бірге нәтижелер фронтир-модель өнімділігінің барған сайын маманданатынын көрсетеді. Argon DeepSWE-де алда болып, FrontierSWE-де артта қалуы мүмкін; Agent's Last Exam-де алда болып, OSWorld-де артта қалуы мүмкін; LABBench-де алда болып, Terminal-Bench Science-де артта қалуы мүмкін. Бұл бенчмарктер агент жүйесінің әртүрлі бөліктерін стресстейді.
Әзірлеушілер үшін ең маңызды сабақ — модельді таңдау барған сайын бренд немесе отбасы деңгейінде емес, жұмыс жүктемесі деңгейінде жүруі қажет.
Жиі қойылатын сұрақтар
Әзірлеушілер Gemini 4 Argon-ды өз жүктемелерінде қалай валидтеу керек?
Қабылдау критерийлері анық көрсетілген өкілді тапсырма жиынтығын құрыңыз. Құралдар, уақыт шектері, кірісті дайындау және қайта әрекет саясатын модельдер арасында салыстырмалы ұстаңыз. Аяқталған тапсырмаларды, жалпы токендерді, өткен уақытты және адам түзетулерін жазып отырыңыз. Кіші пилоттан бастап, өндірістік трафикті бағыттамас бұрын сәтсіздік жағдайларын талдаңыз.
Gemini 4 Argon-ның бенчмарк пайыздарын бір ұпайға орташа етуге бола ма?
Жоқ. Кесте әртүрлі метрикаларды біріктіреді, соның ішінде F1, өту ставкалары және ішінара ұпайлар. Барлығын орташа етудің орнына тапсырмаға тән критерийлерді қолданыңыз.
Gemini 4 Argon агенті әрқашан толық шығыс бюджетін пайдалану керек пе?
Жоқ. Сапа мен сенімділік талаптарыңызды қанағаттандыратын ең кіші сынақталған бюджетті таңдаңыз. Максималды шығыс шегі — мақсат емес, төбе.
Топтар Gemini 4 Argon-ға CometAPI арқылы қолжетімділікті қалай бағалау керек?
Алдымен аккаунт деңгейіндегі қолжетімділікті тексеріп, құжатталған CometAPI маршрутын пайдаланып шағын сұрау жіберіңіз. Жауап сапасын, кідірісті, шектерді және есептелген токендерді өлшеңіз, содан кейін балама модельдерге қолданатын қабылдау сынақтарын енгізіңіз. CometAPI қолжетімділік мәлімдемесін Google-дың кеңірек енгізуінен бөлек қарастырыңыз және маршрут талаптарыңызға сай болғанша бағыттауды конфигурацияланатын күйде ұстаңыз.